

A Prometheus 2 időszakos adatbázisa (TSDB, time series database) kiváló példa mérnöki megoldásra, amely a v2 tárolóhoz képest jelentős javulásokat kínál az adatok gyűjtésének és lekérdezésének sebességében, valamint az erőforrások hatékony felhasználásában. A Prometheus 2-t a Percona Monitoring and Management (PMM) keretében vezettük be, és lehetőségem volt megismerni a Prometheus 2 TSDB teljesítményét. Ebben a cikkben megosztom ezeknek a megfigyeléseknek az eredményeit.
A Prometheus átlagos terhelése
Azok számára, akik megszokták az általános célú adatbázisokkal való munkát, a Prometheus szokásos terhelése meglehetősen érdekes. Az adatgyűjtés sebessége általában stabil értékre törekszik: általában az Ön által figyelt szolgáltatások hasonló mennyiségű metrikát küldenek, és az infrastruktúra viszonylag lassan változik.
Az információk lekérdezése különböző forrásokból érkezhet. Néhány, például az értesítések, szintén a stabil és kiszámítható értékekre törekszik. Mások, mint a felhasználói lekérdezések, csúcsokat okozhatnak, bár ez nem jellemző a terhelés nagy részére.
Terhelés tesztelés
A tesztelés során az adatok gyűjtésének képességére összpontosítottam. A Prometheus 2.3.2 verzióját állítottam be, amelyet a Go 1.10.1 segítségével fordítottam (a PMM 1.14 részeként) egy Linode szolgáltatáskeretén, a következő szkript segítségével: . A lehető legegyszerűbb terhelésgenerálás érdekében ezzel elindítottam néhány MySQL-nódot valós terheléssel (Sysbench TPC-C Teszt), mindegyik 10 Linux/MySQL nodot szimulált.
Az alábbi teszteket Linode szerveren hajtották végre, ahol nyolc virtuális mag és 32 GB memória állt rendelkezésre, 20 terhelés szimulációval két száz MySQL példány monitorozására. Vagy ahogy a Prometheus nevez, 800 célpont (targets), 440 lekérdezés (scrapes) másodpercenként, 380 ezer minta (samples) másodpercenként és 1,7 millió aktív időszakos sor.
Tervezés
A hagyományos adatbázisok szokásos megközelítése, beleértve a Prometheus 1.x által használtat is, a . Ha ez nem elegendő a terhelés fenntartásához, nagy késlekedésekkel találkozhat, és előfordulhat, hogy bizonyos lekérdezések nem teljesülnek. A Prometheus 2 memóriahasználata a storage.tsdb.min-block-duration, amely meghatározza, hogy meddig tárolódnak az adatok a memóriában, mielőtt a lemezre íródnak (alapértelmezés szerint ez 2 óra). A szükséges memória mennyisége a lezárások (labels), az időbeli sorok száma és az adatok gyűjtésének intenzitása (scrapes) összegétől függ, junto a bejövő forgalomtól. A Prometheus disk space terve az, hogy 3 bájtot használ minden egyes felvételre (sample). Ezzel szemben a memóriaigény sokkal magasabb.
Bár van lehetőség a blokk méretének konfigurálására, nem ajánlott manuálisan beállítani, így szükséges Prometheust annyi memóriával ellátni, amennyire szüksége van a terheléshez.
Ha nem lesz elegendő memória a bejövő metrikák kezelésére, a Prometheus out of memory-val fog összeomlani, vagy az OOM killer fogja elérni.
A swap hozzáadása a memória lemerülésének pillanatának elhalasztására nem segít sokat, mivel ez a funkció fájdalmas memóriafogyasztást vált ki. Azt hiszem, ez a Go nyelven, a garbage collector működésében és abban rejlik, ahogyan a swap-t kezelik.
Egy másik érdekes megközelítés a head block lemezre írásának ütemezése egy adott időpontban, ahelyett, hogy a folyamat indításától számítanánk.
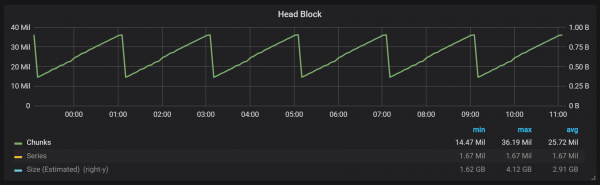
Ahogyan a grafikonból látható, a lemezes mentések minden két órában történnek. Ha megváltoztatja a min-block-duration paramétert egy órára, ezek a mentések óránként fognak megtörténni, fél órával azután.
Ha szeretné használni ezt és más grafikonokat a Prometheus telepítésében, használhatja ezt a . Ez a PMM-hez lett tervezve, de néhány kisebb módosítással bármely Prometheus telepítéshez alkalmas.
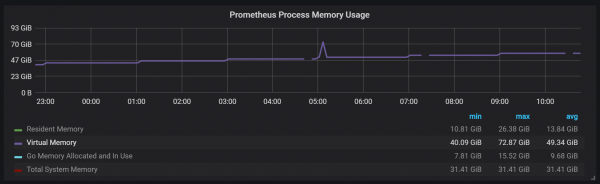
Van egy aktív blokk, amelyet head block-nak hívunk, és amely a memóriában tárolódik; a régebbi adatokkal rendelkező blokkok elérhetők a mmap()-n keresztül. Ez megszünteti a cache külön konfigurálásának szükségességét, de azt is jelenti, hogy elegendő helyet kell hagynia az operációs rendszer cache-ének, ha adatokat szeretne lekérdezni, amelyek idősebbek, mint amit a head block elfér.
Ez azt is jelenti, hogy a Prometheus virtuális memóriafogyasztása elég magasnak tűnik, ami miatt nem kell aggódni.
Egy másik érdekes tervezési szempont a WAL (write ahead log) használata. Ahogy a tároló dokumentációjából is látható, a Prometheus a WAL-t arra használja, hogy elkerülje az adatvesztést leállások esetén. A konkrét adatélmény fenntartásának mechanizmusai sajnos nem eléggé dokumentáltak. A Prometheus 2.3.2-es verziója 10 másodpercenként írja a WAL-t a lemezre, és ezt a beállítást a felhasználók nem konfigurálhatják.
Sűrítések (Compactions)
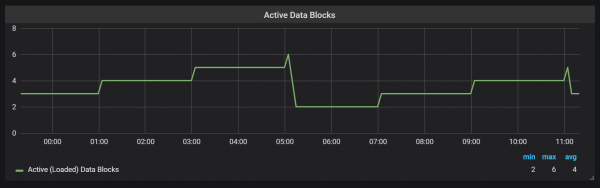
A Prometheus TSDB a LSM-tároló (Log Structured merge — naplózott strukturált összefonódás) mintájára készült: a head block időről időre a lemezre kerül, míg a sűrítési mechanizmus több blokk egyesítését végzi, hogy elkerülje a túl nagy számú blokk átvizsgálását a lekérdezések során. Itt látható a blokkok száma, amelyeket a teszt rendszeremben figyeltem meg egy napos terhelés után.
Ha többet szeretne megtudni a tárolóról, megtekintheti a meta.json fájlt, amely információkat tartalmaz a meglévő blokkokról és arról, hogyan keletkeztek.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
A Prometheusban a sűrítések a head block lemezre írásának idejéhez kötődnek. Ilyenkor több ilyen művelet is végrehajtható.
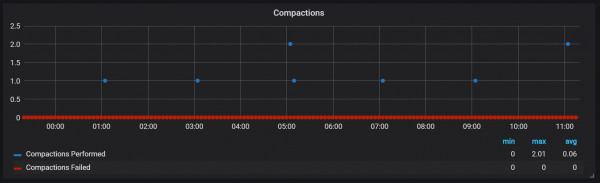
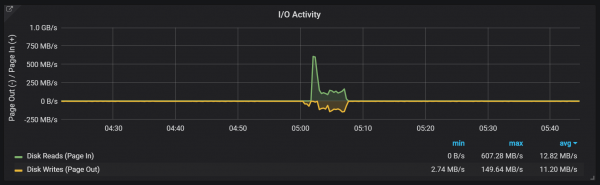
Úgy tűnik, hogy a tömörítések nincsenek korlátozva, és nagy disk I/O ugrásokat okozhatnak a végrehajtás során.
CPU terhelési ugrások
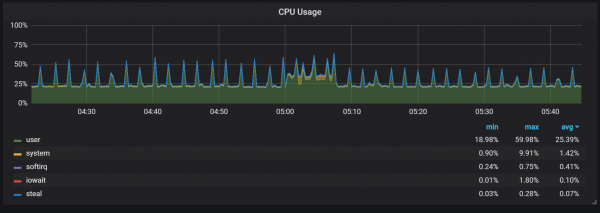
Nyilvánvalóan ez negatívan hat a rendszer sebességére, és komoly kihívás elé állítja az LSM tárolókat: hogyan végezzünk tömörítéseket a magas kéréssebesség fenntartása mellett, anélkül, hogy túl nagy overheadet okoznánk?
A memória használata a tömörítési folyamat során szintén meglehetősen érdekesnek tűnik.
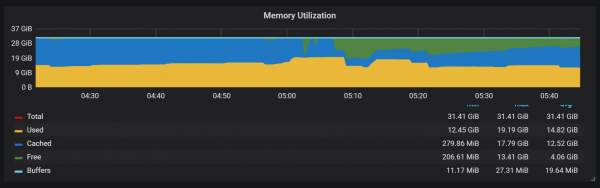
Láthatjuk, hogy a tömörítés után a memória nagy része állapotot vált Cached-ről Free-re: ez azt jelenti, hogy potenciálisan értékes információk kerültek eltávolításra. Érdekes, hogy itt használják-e fadvice() vagy valamilyen más minimalizáló technikát, vagy ez azért van, mert a cache-t felszabadították az eltávolított blokkok miatt a tömörítés során?
Hiba utáni helyreállítás
A hiba utáni helyreállítás időigényes, és ez indokolt. Az egy másodperc alatt érkező egy millió bejegyzés esetén körülbelül 25 percet kellett várnom, míg a helyreállítás zajlott az SSD merevlemez figyelembevételével.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Prometheus elindítása" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Kapcsolatokra való hallgatás elindítása" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="TSDB indítása..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="egészséges blokk találva" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="router prefix" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="egészséges blokk találva" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="egészséges blokk találva" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="egészséges blokk találva" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="egészséges blokk találva" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="WAL sérülés észlelve; levágás" err="váratlan CRC32 ellenőrző összeg d0465484, akar 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB elindult"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Konfigurációs fájl betöltése" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="A konfigurációs fájl betöltése befejeződött" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="A szerver készen áll a webes kérések fogadására."
A helyreállítási folyamat fő problémája a magas memóriafogyasztás. Bár normális körülmények között a szerver képes stabilan működni ezzel a mennyiségű memóriával, leállás esetén előfordulhat, hogy nem tud újraindulni az OOM miatt. Az egyetlen megoldás, amit találtam, hogy le kell állítani az adatok gyűjtését, újra kell indítani a szervert, meg kell várni, amíg helyreáll, majd újra be kell kapcsolni az adatok gyűjtését.
Bemelegítés
Egy másik viselkedés, amire érdemes figyelni a bemelegítés során, az alacsony teljesítmény és a magas erőforrás-fogyasztás aránya közvetlenül a start után. Néhány, de nem minden indításnál tapasztaltam jelentős CPU- és memória-terhelést.
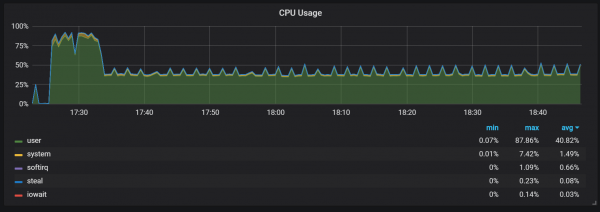
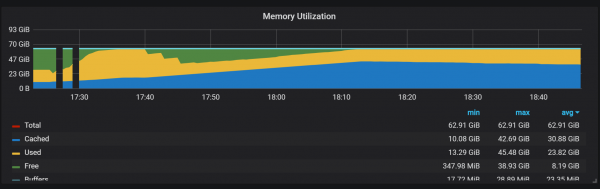
A memóriahasználatban jelentkező hiányosságok arra utalnak, hogy a Prometheus nem tudja az összes gyűjtést a start során konfigurálni, amitől egyes információk elveszhetnek.
Nem tudtam pontosan kideríteni a magas CPU- és memóriahasználat okait. Gyanítom, hogy ez új időszakok gyakori létrehozásával függ össze a head blockban.
CPU terhelés ingadozások
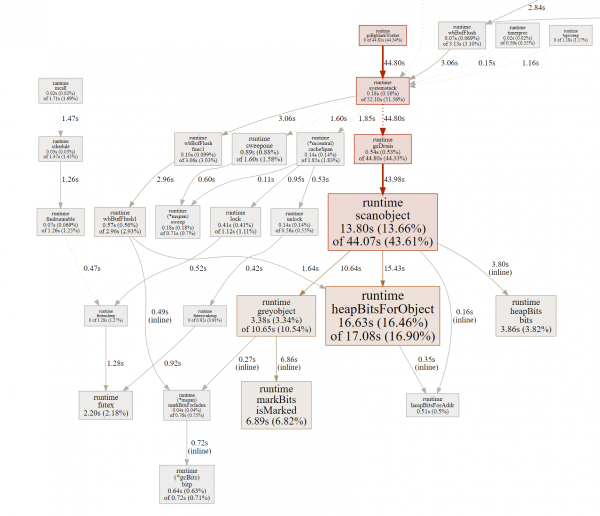
A tömítések mellett, amelyek meglehetősen magas I/O terhelést generálnak, észleltem, hogy a CPU terhelése komoly ingadozásokkal jár kétpercenként. A csúcsok hosszabbak, amikor magas a belépő forgalom, és úgy tűnik, hogy ez a Go szemétgyűjtő által okozott, legalábbis néhány mag teljesen le van terhelve.
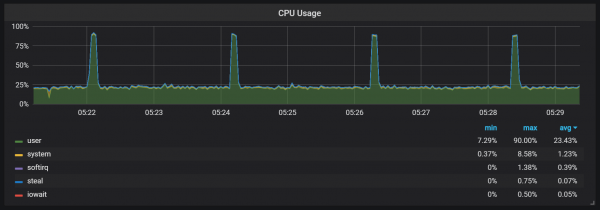
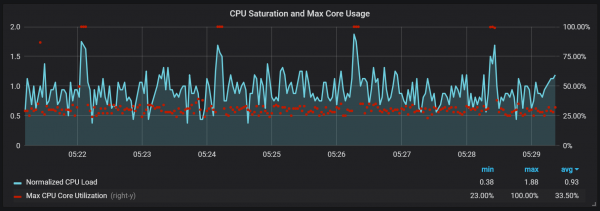
Ezek az ingadozások nem elhanyagolhatóak. Úgy tűnik, hogy amikor bekövetkeznek, a belső belépési pont és a Prometheus metrikák elérhetetlenné válnak, ami adatkihagyásokat okoz ezekben az időszakokban.
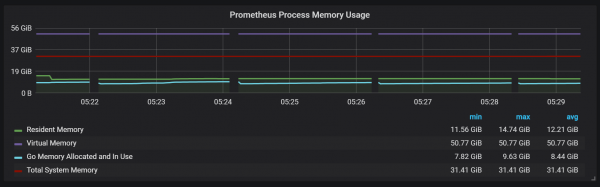
Azt is észlelhetjük, hogy a Prometheus exportáló egy másodpercre leáll.
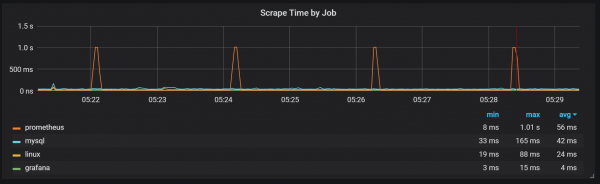
Megfigyelhetjük a hulladékgyűjtéssel (GC) való korrelációkat.
Zárás
A Prometheus 2 TSDB gyorsan működik, képes milliók időszakait kezelni, miközben másodpercenként ezrek írását végzi, viszonylag szerény hardver használatával. A CPU- és lemez-I/O igénybevétel is lenyűgöző. Az általam mért példa akár 200 000 metrikát mutatott másodpercenként egy használt maggal.
A bővítés tervezésénél figyelembe kell venni a megfelelő memória mennyiséget, és ennek valódi memóriának kell lennie. A használt memória mennyisége, amit megfigyeltem, körülbelül 5 GB volt másodpercenként 100 000 bejövő írásnál, ami körülbelül 8 GB foglalt memória az operációs rendszer cache-jével együtt.
Természetesen még sok munka vár ránk a CPU és lemez-I/O csúcsok megfékezéséhez, és ez nem meglepő, figyelembe véve, hogy a Prometheus 2 TSDB mennyire fiatal még az InnoDB, TokuDB, RocksDB, WiredTiger mellett, de mindegyiknek hasonló problémái voltak élete kezdetén.
Forrás: habr.com
