

Helló, Dmitrij Logvinenko vagyok, a „Vezet” cégcsoport analitikai osztályának adatmérnöke.
Beszélni fogok egy csodálatos eszközről az ETL folyamatok fejlesztéséhez — Apache Airflow. Az Airflow azonban annyira sokoldalú és összetett, hogy érdemes megismerkedni vele, akkor is, ha nem adatfolyamokkal foglalkozik, hanem időnként el kell indítania bizonyos folyamatokat, és nyomon kell követnie azok végrehajtását.
Igen, nemcsak beszélni fogok, hanem meg is mutatom: a program rengeteg kódot, képernyőképet és ajánlást tartalmaz.
Mit látsz általában, amikor rákeresel az Airflow szóra / Wikimedia Commons
Tartalomjegyzék
Bevezetés
Apache Airflow — olyan, mint a Django:
- Python nyelven íródott,
- nagyszerű adminisztrációs felülete van,
- korlátlanul bővíthető,
— csak jobb, és egészen más célokra készült, mint (ahogy a kata előtt írták):
- feladatok indítása és figyelése korlátlan számú gépen (amennyit a Celery/Kubernetes és a lelkiismerete lehetővé tesz)
- dinamikus workflow generálás nagyon könnyen írható és érthető Python kódból
- és bármilyen adatbázis és API összekapcsolása kész elemek segítségével, valamint saját készítésű pluginek alkalmazásával (ami rendkívül egyszerű).
Így használjuk az Apache Airflow-t:
- adatokat gyűjtünk különböző forrásokból (számos SQL Server és PostgreSQL példány, különböző API-k alkalmazásmetricákkal, még 1C is) DWH-be és ODS-be (ez nálunk Vertica és Clickhouse).
- mint egy fejlett
cron, amely ODS-en adatok konszolidálásának folyamatát indítja, és figyelemmel kíséri azok karbantartását.
Nemrégig egy 32 magos és 50 GB RAM-mal rendelkező kis kiszolgáló biztosította igényeinket. Az Airflow-ban eközben üzemel:
- több mint 200 dag (állítólagos workflows, amelyekbe betettük a feladatokat),
- mindegyikben átlagosan 70 feladat,
- ez pedig (szintén átlagosan) óránként fut.
A bővülésünkről alább írok, de most határozzuk meg azt a über-zadatot, amelyet meg fogunk oldani:
Három kiindulási SQL Server van, mindegyiken 50 adatbázissal — egy projekt példányai, tehát a struktúrájuk majdnem azonos (majdnem mindenhol, muahaha), így mindegyikben van egy Orders tábla (köszönet, hogy egy ilyen nevű táblát bármilyen üzletbe be lehet sűríteni). Az adatokat úgy nyerjük ki, hogy szolgáltatási mezőket adunk hozzá (forrás-szerver, forrás-adatbázis, ETL-feladat azonosító) és naivan bedobjuk őket, mondjuk, a Vertica-ba.
Kezdjük!
Fő rész, gyakorlati (és egy kicsit elméleti)
Miért van szükségünk erre (és Önnek)
Amikor a fák nagyok voltak, és én egy egyszerű SQL-szerelő voltam egy orosz kiskereskedelmi láncnál, az ETL-folyamatokat aka adatfolyamokat a két rendelkezésre álló eszközünkkel hajtottuk végre:
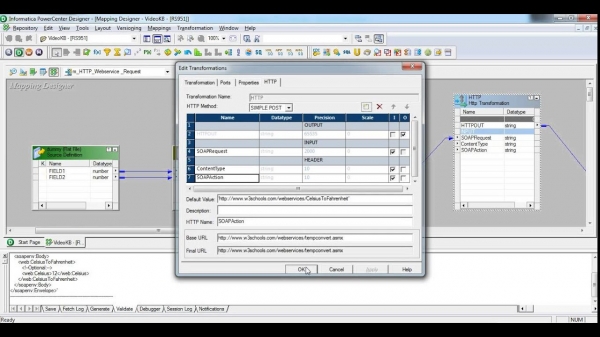
- Informatica Power Center — egy rendkívül komplex rendszer, hihetetlenül teljesítményes, saját hardverrel és verziókezeléssel. Csak a lehetőségeinek 1%-át használtam. Miért? Nos, először is, ez a felület valahol a nullákból mentálisan nyomott minket. Másodszor, ez a dolog rendkívül bonyolult folyamatokra, a komponensek heves újrahasználására és egyéb, nagyon fontos vállalati trükkökre készült. Arról, hogy annyiba kerül, mint egy Airbus A380 szárnya/év, hallgassunk.
Óvatosan, a képernyőkép fájhat a 30 év alatti embereknek.

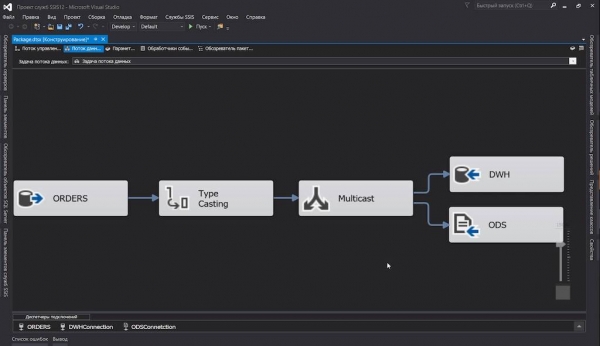
- SQL Server Integration Server — ezzel a társsal dolgoztunk a belső projekten belüli folyamainkban. Nos, igazából: SQL Servert már használunk, és nem használni az ETL-eszközeit nem lenne ésszerű. Minden benne jó: a felület szép, és a végrehajtási jelentések… De nem ezért szeretjük a szoftvertermékeket, ó, nem ezért. Verziókezelni tudjuk
dtsx(ami egy XML, amelynek a nódjai mentéskor összekeverednek), de mi haszna van? De csinálni egy feladatcsomagot, ami egy száz táblát áthoz egy szerverről a másikra? De az mégiscsak egy száz, a huszonkettőtől a mutatóujjunk letörik, miközben a billentyűzeten kattintgatunk. De kétségtelenül modernebbnek tűnik:
Mindenképpen kerestük a megoldásokat. A dolog odáig jutott, hogy saját SSIS-packet generátorunk lett... majdnem ...aztán engem megtalált az új munka. Ez a munka folytatásaként találkoztam az Apache Airflow-val.
Amikor megtudtam, hogy az ETL-folyamatok leírásai csak egyszerű Python-kód, majdnem táncoltam az örömtől. Így a adatfolyamok verziókezelése és diff-ezése megtörtént, és a táblák egyetlen struktúrából száz adatbázisból egy célzónába való összegyűjtése Python-kód ügyévé vált másfél-két 13” képernyőn.
Amikor megtudtam, hogy az ETL-folyamatok leírása csupán egyszerű Python-kód, majdnem táncra perdültem örömömben. Így vált a data stream verziószámozása és diffje könnyebbé, és a száz adatbázisból származó, egységes struktúrájú táblák egyetlen célba való összeállítása mindössze Python-kód kérdése lett másfél-két 13” képernyőn.
Klónozzuk a klasztert
Ne rendezjünk itt gyerekes vitákat, és ne beszéljünk egyértelmű dolgokról, mint például az Airflow telepítése, az Ön által választott adatbázis, Celery és egyéb ügyek, amelyeket a dokumentációban leírtak.
Ahhoz, hogy azonnal elkezdhessük a kísérleteket, összedobtam docker-compose.yml amelyben:
- Felállítjuk magát Airflow: Scheduler, Webserver. Ott fog futni a Flower a Celery-feladatok monitorozására (mivel azt már beletették az
apache/airflow:1.10.10-python3.7, és mi is örömmel fogadjuk); - PostgreSQL, ahová az Airflow fogja írni a szolgáltatási információit (a tervező adatai, a végrehajtás statisztikája stb.), míg a Celery a befejezett feladatokat fogja megjelölni;
- Redis, amely feladatküldőként fog működni a Celery számára;
- Celery worker, amely a feladatok tényleges végrehajtásával fog foglalkozni.
- A mappába
.\/dagstesszük a DAG-ok leíró fájljait. Ezek automatikusan fel fognak ismerésre kerülni, így nem szükséges az egész kupacot újraindítani minden apró változással.
Néhány példakód nincs teljes egészében bemutatva (hogy ne terhelje túl a szöveget), és néhány helyen a folyamat során módosul. A teljesen működő példák megtekinthetők a repóban. .
docker-compose.yml
verzió: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: \/dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2:\/\/airflow:airflow@airflow-db:5432\/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis:\/\/broker:6379\/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql:\/\/airflow:airflow@airflow-db\/airflow

x-airflow-base: &airflow-base
  image: apache\/airflow:1.10.10-python3.7
  entrypoint: \/bin\/bash
  restart: always
  volumes:
    - .\/dags:\/dags
    - .\/requirements.txt:\/requirements.txt

services:
  # Redis mint a Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB az Airflow metadatához
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - .\/db:\/var\/lib\/postgresql\/data

  # Fő konténer az Airflow Webserver, Scheduler, Celery Flower számára
  airflow:
    <<: *airflow-base

    environment:
      <<: *airflow-config

      AIRFLOW__SCHEDULER__DAG_DIR_LIST_INTERVAL: 30
      AIRFLOW__SCHEDULER__CATCHUP_BY_DEFAULT: 'False'
      AIRFLOW__SCHEDULER__MAX_THREADS: 8

      AIRFLOW__WEBSERVER__LOG_FETCH_TIMEOUT_SEC: 10

    depends_on:
      - airflow-db
      - broker

    command: >
      -c " sleep 10 &&
           pip install --user -r \/requirements.txt &&
           \/entrypoint initdb &&
          (\/entrypoint webserver &) &&
          (\/entrypoint flower &) &&
           \/entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, amelyet a `--scale=n` segítségével méretezünk
  worker:
    <<: *airflow-base

    environment:
      <<: *airflow-config

    command: >
      -c " sleep 10 &&
           pip install --user -r \/requirements.txt &&
           \/entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Megjegyzések:
- A kompozíció összeállításánál sokáig támaszkodtam a neves képre – mindenképpen nézd meg. Lehet, hogy az életedben másra nem is lesz szükséged.
- Minden Airflow-beállítás elérhető nemcsak a
airflow.cfg, hanem a környezeti változókon keresztül is (köszönet a fejlesztőknek), amivel kegyetlenül éltem. - Természetesen nem production-ready: szándékosan nem állítottam be heartbeats a konténerekhez, és nem foglalkoztam a biztonsággal. De a minimumot, ami alkalmas a kísérleteinkhez, megteremtettem.
- Figyeljetek, hogy:
- A DAG mappának elérhetőnek kell lennie mind a tervező, mind a munkások számára.
- Ugyanez vonatkozik minden harmadik féltől származó könyvtárra — ezeknek is telepítve kell lenniük a tervező és a munkások gépein.
Most jöjjön a legegyszerűbb:
$ docker-compose up --scale worker=3Miután minden felfutott, nézd meg a webes felületeket:
- Airflow:
- Flower:
Alapfogalmak
Ha semmit sem értettél az összes "dag" kapcsolatban, itt van egy rövid szótár:
- Scheduler — a legfontosabb figura az Airflow-ban, aki figyeli, hogy a robotok dolgozzanak, ne az emberek: követi az ütemtervet, frissíti a dag-okat, elindítja a feladatokat.
Régebbi verziókban memória problémái voltak (nem, nem amnézia, hanem szivárgások) és a konfigurációkban még hátrahagyott egy örökölt paramétert
run_duration— az újraindításának intervalluma. De most minden rendben van. - DAG (más néven "dag") — "irányított aciklikus graf", de ez a meghatározás kevés embernek mond valamit, és lényegében ez a feladatok (lásd alább) kölcsönhatására szolgáló tároló, vagy hasonló a SSIS csomagokhoz és az Informatica munkafolyamatához.
A dag-ok mellett lehetnek aldag-ok is, de valószínűleg nem jutunk el hozzájuk.
- DAG Run — egy inicializált dag, amelynek saját
execution_date. A egy dag-hoz tartozó dag-runs párhuzamosan is működhetnek (ha persze idempotenssá tetted a feladataidat). - Operator — ezek a kód darabok felelősek valamilyen konkrét művelet végrehajtásáért. Három típusa létezik:
- action, mint például a kedvencünk
PythonOperator, amely képes bármilyen (érvényes) Python kódot végrehajtani; - átutalás, amelyek adatokat szállítanak egyik helyről a másikra, mondjuk,
MsSqlToHiveTransfer; - sensor pedig lehetővé teszi, hogy reagáljon, vagy lelassítsa a dag további végrehajtását egy esemény bekövetkeztéig.
HttpSensormeg tudja hívni a megadott végpontot, és amikor megkapja a szükséges választ, elindítja a transzfertGoogleCloudStorageToS3Operator. A kíváncsi elme megkérdezheti: "miért? Hiszen az operátorban is lehet ismétléseket végezni!" Azért, hogy ne töltsük meg a feladatok medencéjét futó operátorokkal. A szenzor elindul, ellenőriz, majd alszik a következő próbálkozásig.
- action, mint például a kedvencünk
- Task — a megadott operátorok, függetlenül a típustól, és amelyek a dag-hoz vannak csatlakoztatva, feljebb emelkednek a feladat szintjére.
- Task instance — amikor a fő tervező úgy döntött, hogy a feladatokat harcba kell küldeni a végrehajtó munkásokat (helyben, ha használunk
LocalExecutorvagy egy távoli node esetén aCeleryExecutor), hozzárendel egy kontextust (azaz egy változó-parameter készletet), kibővíti a parancsok vagy lekérdezések sablonjait és elhelyezi őket a medencében.
Feladatokat generálunk
Először jelöljük meg a dagunk általános sémaét, majd egyre mélyebben belemerülünk a részletekbe, mert néhány nem triviális megoldást alkalmazunk.
Tehát, a legegyszerűbb formában egy ilyen dag így néz ki:
datetime importálása timedelta, datetime

from airflow import DAG
from airflow.operators.python_operator import PythonOperator

from commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Nézzük meg:
- Először importáljuk a szükséges könyvtárakat és még valamit;
sql_server_ds— ezList[namedtuple[str, str]]Airflow-összekötők neveivel és a kapcsolódó adatbázisok nevével, ahonnan a táblázatunkat származtatni fogjuk;dag— a DAGunk deklarációja, amelynek a globális kódban kell szerepelnieglobals(), különben az Airflow nem talál rá. A DAG-nak azt is meg kell mondanunk:- hogy hívják
orders— ez a név majd fel fog tűnni a webes felületen, - hogy éjfélkor, július nyolcadikától fog dolgozni,
- és körülbelül 6 óránként kell elindulnia (a nagyszerű srácok számára itt a
timedelta()helyett megengedettcron-string0 0 0/6 ? * * *, a kevésbé nagyszerűeknek pedig olyan kifejezés, mint@daily);
- hogy hívják
workflow()fogja végezni a fő munkát, de nem most. Most csak kiírjuk a kontextusunkat a naplóba.- Most egy egyszerű varázslat a feladatok létrehozásához:
- végigmegyünk a forrásainkon;
- kezdeményezzük
PythonOperator, amely végrehajtja a „hülye” feladatunkat.workflow()Ne feledjétek, hogy egyedi (a DAG keretein belül) feladatnevet kell megadni, és kötni kell magát a DAG-ot. Aprovide_contextcsoportosítja a funkcióhoz mellékelt további argumentumokat, amelyeket gondosan összegyűjtünk a**context.
Egyelőre ennyit. Mit nyertünk:
- új DAG a webes felületen,
- másfél száz feladat, amelyek párhuzamosan futnak (ha ezt engedik az Airflow, Celery beállításai és a szerverek teljesítménye).
Nos, majdnem megkaptuk.
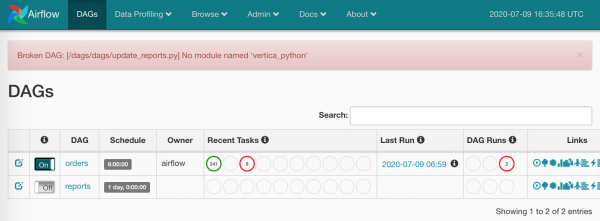
Ki fogja beállítani a függőségeket?
Hogy mindezt egyszerűbbé tegyem, beépítettem a docker-compose.yml feldolgozást requirements.txt minden csomóponton.
Most már jöhet:
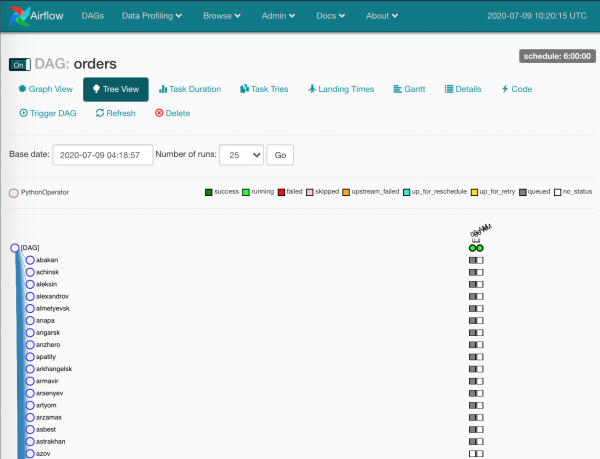
A szürke négyzetek — feladat példányok, amelyeket a ütemező feldolgozott.
Egy kicsit várunk, a feladatokat elkapják a munkások:
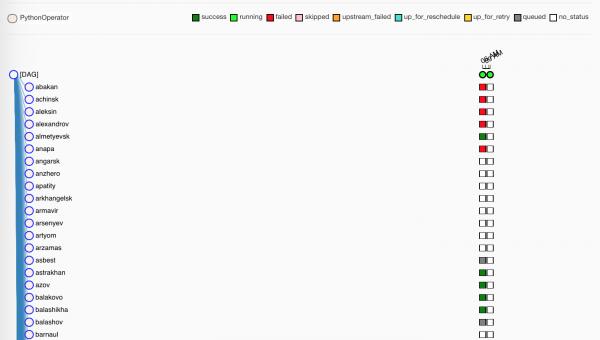
A zöldek, nyilvánvalóan, — sikeresen végrehajtották. A pirosak — nem annyira sikeresen.
Érdemes megjegyezni, hogy a termelési környezetben nincs olyan mappa,
.\/dagsamely szinkronizálódik a gépek között — minden DAG agitGitlabunkon található, a Gitlab CI pedig a frissítéseket a gépekre telepíti a merge után amaster.
Egy kis Flower-ről
Míg a munkások végzik a „hülye” feladatainkat, emlékezzünk egy másik eszközre, amely bemutathat nekünk néhány dolgot — Flower.
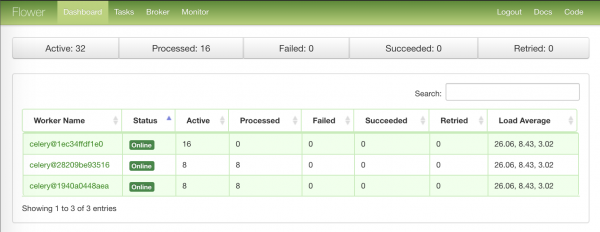
Az első oldal összesített információval a csomópont-munkásokról:
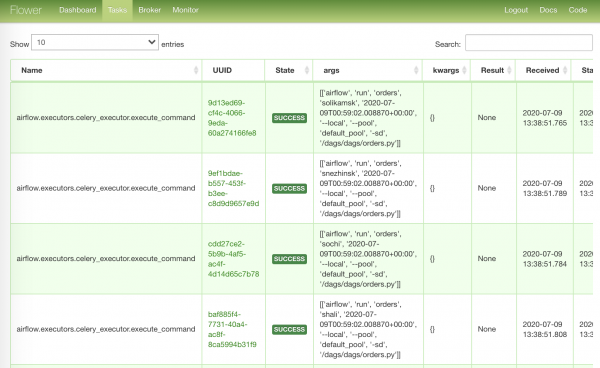
A leggyümölcsözőbb oldal a feladatokat küldve a munkára:
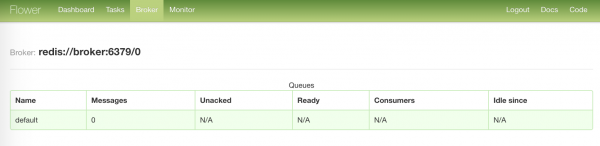
A legunalmasabb oldal a brókerünk állapotával:
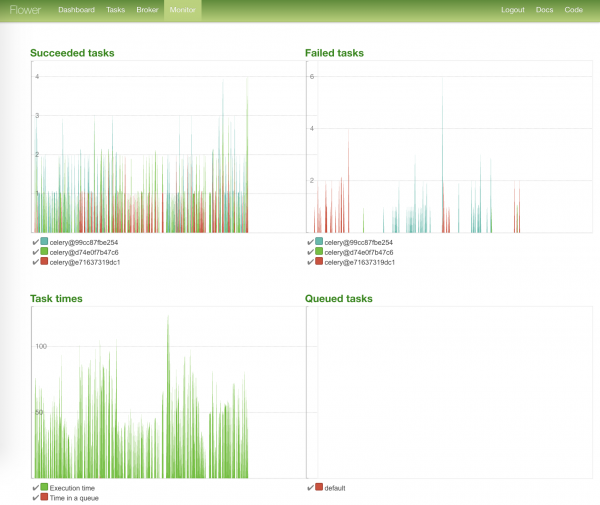
A legszínesebb oldal - a feladatok állapotának grafikonjaival és azok végrehajtási idejével:
Elérjük a szükséges adatokat
Tehát, minden feladat befejeződött, lehet menteni a sérülteket.
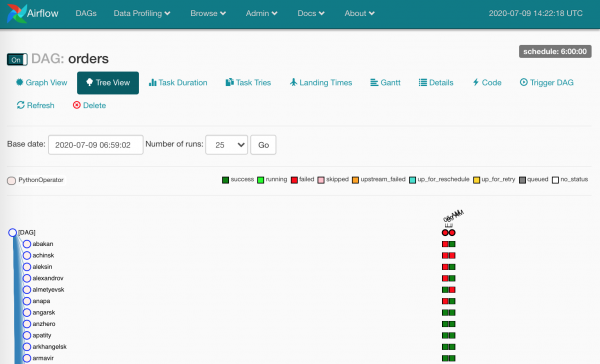
Sok sérült akadt - különböző okokból. A Airflow helyes használata esetén ezek a négyzetek azt jelzik, hogy az adatok biztosan nem érkeztek meg.
Nézd meg a naplót, és indítsd újra a leállt feladatpéldányokat.
Bármelyik négyzetre kattintva láthatjuk a rendelkezésünkre álló műveleteket:
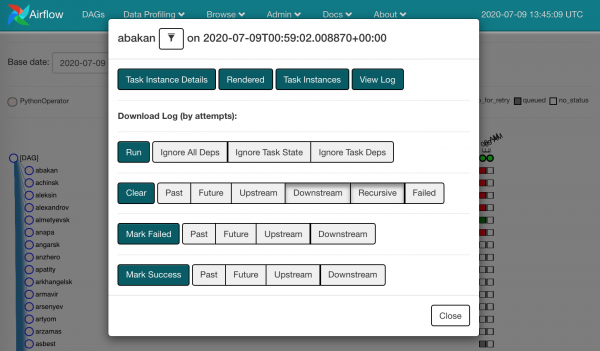
Törölhetjük a leállt feladatot. Tehát elfelejthetjük, hogy ott valami megakadt, és ugyanaz a feladatpéldány a tervezőhez fog menni.
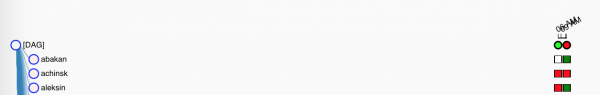
Nyilvánvaló, hogy minden piros négyzettel egeret használni nem éppen humánus - nem ezt várjuk az Airflow-tól. Természetesen van tömegpusztító fegyverünk: Böngészés/Feladatpéldányok
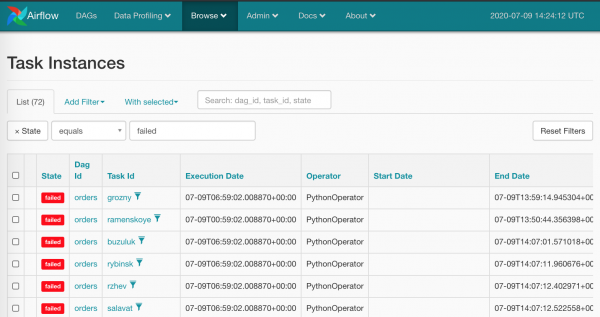
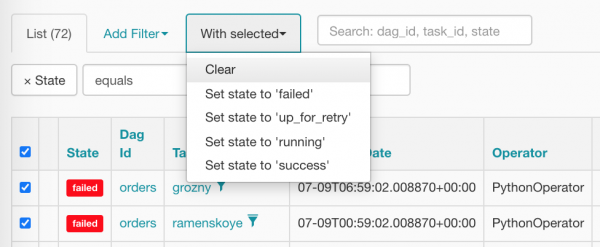
Válasszuk ki egyszerre mindet, és állítsuk nullára a helyes pont megnyomásával:
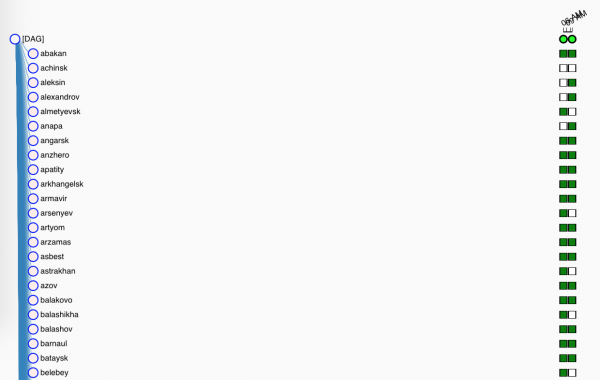
A törlés után a taxis láthatóan így néz ki (már alig várják, hogy a tervező az ütemezésbe állítsa őket):
Csatlakozások, hookok és egyéb változók
Itt az ideje megnézni a következő DAG-ot, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Tisztelt Hölgyeim és Uraim, az jelentések frissültek"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natasa, ébredj, a {{ dag.dag_id }} leomlott
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Mindenki csinált már jelentésfrissítőt? Ez ismét az: van egy lista forrásokról, ahonnan az adatokat be kell gyűjteni; van egy lista, ahová le kell helyezni; ne felejtsük el jelezni, amikor minden megtörtént vagy elromlott (nos, ez nem ránk vonatkozik, nem).
Nézzük át újra a fájlt, és nézzük meg az új, érthetetlen dolgokat:
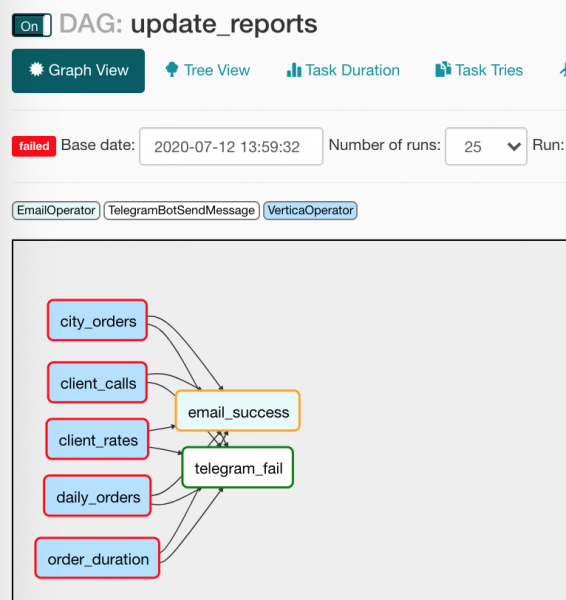
from commons.operators import TelegramBotSendMessage— semmi sem akadályoz meg minket abban, hogy saját operátorokat készítsünk, amivel élni is fogunk, készítve egy kis csomagoló réteget az üzenetek elküldésére a Felszabadítottra. (Erről az operátorról később még beszélünk);default_args={}— a DAG megoszthatja ugyanazokat az argumentumokat minden operátorával;to='{{ var.value.all_the_kings_men }}'— mezőtonem lesz hardkódolva, hanem dinamikusan jön létre a Jinja segítségével és az emilek listáját tartalmazó változóval, amit gondosan helyeztem el aAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— az operátor indítási feltétele. A mi esetünkben, a levél a főnököknek csak akkor fog eljutni, ha minden függőség sikeresen futott le sikeresen;tg_bot_conn_id='tg_main'— argumentumokconn_idelfogadja a létrehozott kapcsolatok azonosítóit aAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— az üzenetek a Telegramra csak akkor fognak menni, ha vannak megbukott feladatok;task_concurrency=1— megakadályozzuk, hogy egy feladat több példánya egyidejűleg fusson. Ellenkező esetben, többVerticaOperator(ugyanarra a táblára nézve) fog elindulni;report_update >> [email, tg]— mindegyikVerticaOperatorszét fog válni az e-mail és az üzenet küldésében, így:

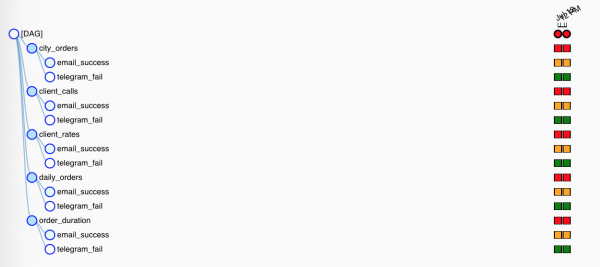
De mivel a notificáló operátoroknak különböző indítási feltételeik vannak, csak egy fog működni. A Tree View-ban ez valamivel átláthatatlanabbul néz ki:

Mondanék pár szót a makrókról és azok barátairól — és az alapértelmezett értékeket. Tehát az alábbiakat megteheted:.
A makrók Jinja-helyettesítők, amelyek különböző hasznos információkat helyettesíthetnek az operátorok argumentumaiban. Például így:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} kibővül a kontextus változó tartalmával execution_date formátumban YYYY-MM-DD: 2020-07-14. A legszebb dolog, hogy a kontextus változók rögzítve vannak egy adott feladat példányhoz (négyzet a Tree View-ban), és amikor újraindítják őket, a helyettesítők ugyanazokra az értékekre fognak kibővülni.
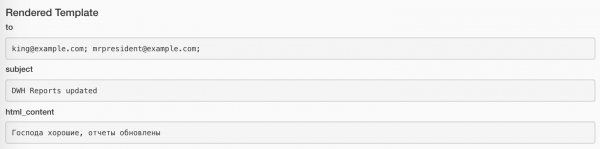
A hozzárendelt értékeket a Rendered gomb segítségével nézhetjük meg minden feladat példányán. Így néz ki a levélküldés feladat:
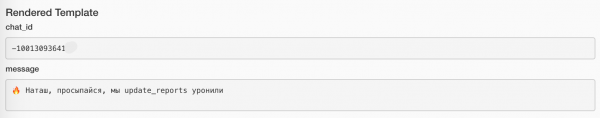
Így néz ki az üzenet küldése feladat:
A beépített makrók teljes listája az utolsó elérhető verzióhoz itt érhető el:
Ráadásul bővítmények segítségével saját makrókat is bejelenthetünk, de ez már egy teljesen más történet.
A meghatározott dolgok mellett átadhatjuk a saját változóink értékeit is (ezt már használtam a kódban). Létrehozunk egy Admin/Variables pár dolgot:
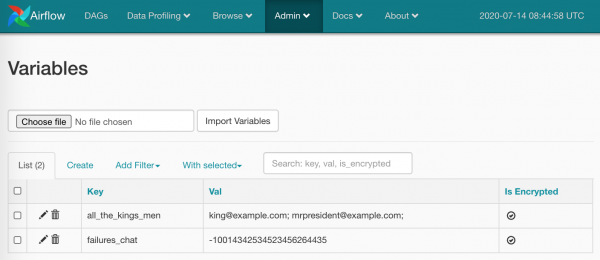
Kész, használható:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Az érték lehet skáláris vagy JSON is. Ha JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
csak használjuk a szükséges kulcs útvonalát: {{ var.json.bot_config.bot.token }}.
A lényeg, hogy mondok egy szót és mutatok egy képernyőképet a kapcsolatokról.Itt minden egyszerű: a lapon Admin/Connections létrehozunk egy kapcsolatot, és beletesszük a bejelentkezési/ jelszó kombinációnkat és az egyéb specifikus paramétereket. Így néz ki:
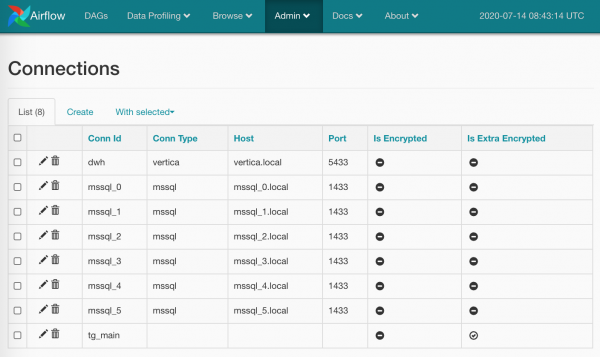
A jelszavakat titkosíthatjuk (alapértelmezetten precízebben, mint ami van), vagy elhagyhatjuk a kapcsolat típusát (ahogy azt tettem a tg_main) — az a helyzet, hogy a kapcsolati típusok listája be van építve az Airflow modellekbe, és kódba való beavatkozás nélkül nem változtatható (ha valamit elfelejtettem kikeresni, kérem, javítsanak ki), de a hitelesítő adatok elérése név alapján semmi akadálya.
Ráadásul lehetőség van több kapcsolat létrehozására ugyanazzal a névvel: ebben az esetben a BaseHook.get_connection(), amely a nevük alapján hozza elő a kapcsolatokat, esetleg véletlenszerű kapcsolatot ad vissza a több hasonló név közül (logikusabb lenne, ha körbe-körbe választana, de ezt hagyjuk az Airflow fejlesztőire).
A Változók és Kapcsolatok kétségtelenül nagyszerű eszközök, de fontos, hogy megtartsuk az egyensúlyt: mely részeit a folyamatainknak tároljuk kódban, és melyeket adunk át az Airflow-nak. Egyrészt kényelmesen gyorsan változtathatunk értékeket, például a levelezési fiókot a UI-n keresztül. Másrészt azonban ez mégis visszaállít minket a kattintásos megoldásokra, amiket (én) szerettünk volna elkerülni.
A kapcsolatkezelés az egyik feladatunk. hookokAz Airflow hookok valójában azok a csatlakozási pontok, amelyek lehetővé teszik a harmadik féltől származó szolgáltatásokkal és könyvtárakkal való interakciót. Például, JiraHook segítségével interakciót létesíthetünk a Jira-val (feladatokat mozgathatunk oda-vissza), míg a SambaHook segítségével helyi fájlokat tölthetünk fel egy smb-pontra.
Egy egyedi operátor elemzése
És éppen most jutottunk el oda, hogy megnézhetjük, hogyan készült a TelegramBotSendMessage
Kód commons/operators.py a maga operátorával:
from typing import Union

from airflow.operators import BaseOperator

from commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Üzenet küldése a chat_id-nak a TelegramBotHook használatával

    Példa:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} nem sikerült :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Üzenet küldése: "{self.message}" a következő chathez: {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Itt, akárcsak a többi dologban az Airflow-ban, minden nagyon egyszerű:
- Örököltünk
BaseOperator, ami sok Airflow-specifikus dolgot valósít meg (nézd meg, amikor ráérsz) - Deklaráltuk a mezőket
template_fields, ahol a Jinja a makrókat fogja keresni a feldolgozáshoz. - Megszerveztük a helyes argumentumokat a
__init__(), ahol szükséges, megadtuk az alapértelmezetteket. - Ne feledkezzünk meg az előd inicializálásáról sem.
- Megnyitottuk a megfelelő hook-ot
TelegramBotHook, és megkaptuk tőle a kliens objektumot. - Felülírtuk a
BaseOperator.execute(), amelyet az Airflow akkor fog hívni, amikor eljön az idő operátort futtatni — itt valósítjuk meg a fő műveletet, ne feledjük el a naplózást. (A naplózást egyébként közvetlenül astdoutésstderr— az Airflow mindent elkap, szépen becsomagolja, és a megfelelő helyre helyezi.)
Nézzük meg, mi található a commons/hooks.py. A fájl első része, magáról a hook-ról:
from typing import Union

from airflow.hooks.base_hook import BaseHook
from requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API hook

    Megjegyzés: adj meg egy kapcsolatot üres Conn Type-nal, és ne felejtsd el
    kitölteni az Extra-t:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Nem is tudom, mit lehetne itt magyarázni, csak kiemelek néhány fontos dolgot:
- Öröklünk, gondolkodunk az argumentumokon — a legtöbb esetben csak egy lesz:
conn_id; - Felülírjuk a szabványos módszereket: én a
get_conn(), ahol a név alapján a csatlakozási paramétereket kapom, és mindössze csak kinyerem a szekciótextra(ez a mező JSON-hoz), amibe én (a saját instrukcióm szerint!) tettem a Telegram-bot tokenjét:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Létrehozom a példányt a
TelegramBot, már adott konkrét tokennel.
Ennyi. Az ügyfelet a hook-ból meg lehet kapni a TelegramBotHook().clent vagy TelegramBotHook().get_conn().
És a második rész a fájlban, amiben létrehozok egy mikró burkolót a Telegram REST API-hoz, hogy ne kelljen a miatt egyetlen metódust sendMessage.
class TelegramBot:
    """Telegram Bot API burkoló

    Példák:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Szia, drágám')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Szia, drágám', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
A helyes út — mindezt összeállítani:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— egy pluginbe, elhelyezni egy nyilvános tárolóban, és átadni Open Source-nak.
Míg mindezt tanulmányoztuk, a jelentésfrissítéseink sikeresen belefulladtak és küldtek nekem egy hibajelzést a csatornába. Megyek, nézem, mi nem stimmel megint...
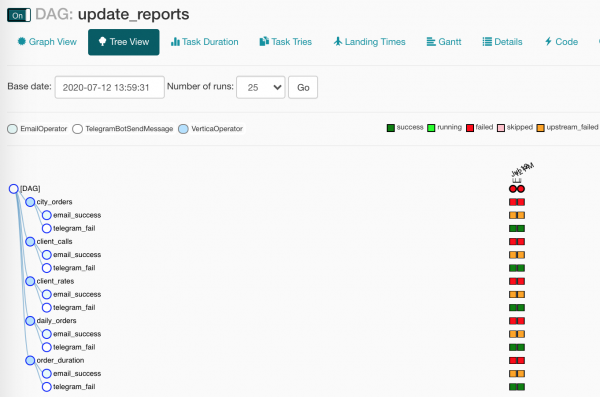
Valami elromlott a dagünkben! És nem erre vártunk? Pontosan!
Készítesz valamit?
Érzem, hogy valamit kihagytam? Úgy tűnik, ígértem, hogy adatokat áttöltök SQL Serverből Verticába, és itt elmentem a témáról, gazember!
Ez a rosszaság szándékos volt, csak ki kellett fejtenem nektek néhány terminológiát. Most már lehet tovább haladni.
A tervünk a következő volt:
- Készítsünk egy dag-ot
- Generáljunk feladatokat
- Nézzük meg, milyen szépen minden
- A feltöltésekhez hozzárendelni a session számokat
- Adatokat vinni az SQL Serverből
- Az adatokat elhelyezni Verticában
- Statisztikát gyűjteni
Tehát, hogy mindezt elindítsam, készítettem egy kis kiegészítést a docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Itt indítjuk el:
- Vertica mint gazda
dwha legnagyobb alapértelmezett beállításokkal, - három SQL Server példány,
- feltöltjük az adatbázisokat legutóbb néhány adatokkal (soha ne nézz bele a
mssql_init.py!)
Mindennel egy kicsit bonyolultabb parancs segítségével indítjuk el, mint legutóbb:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Amit a csodálatos random generátorunk előállított, abból a Adatprofilozás/Ad Hoc Kérdés:
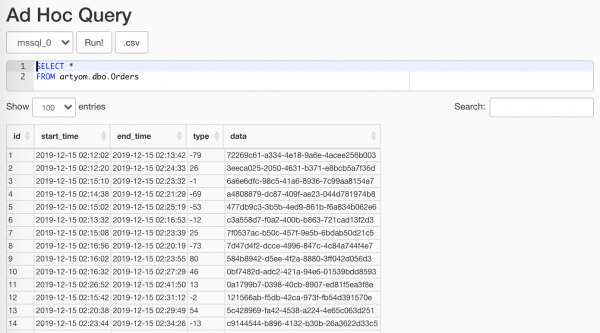
A legfontosabb, hogy ezt ne mutassuk az elemzőknek
Részletezni itt nem fogok ETL-ülések nem fogok, ott minden triviális: létrehozunk egy adatbázist, benne egy táblával, mindent egy kontextus kezelővel csomagolunk, és most így csináljuk:
with Session(task_name) as session:
    print('Betöltés', session.id, 'elkezdődött')

    # Betöltési munkafolyamat
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
a sys import stderr

class Session:
    """ETL munkafolyamat munkamenete

    Példa:
        with Session(task_name) as session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Jól végezted'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'megnyitva')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('A munkamenet nincs megnyitva')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'lezárva',
              ', sikeres: ', self.successful,
              ', Betöltött: ', self.loaded_rows,
              ', megjegyzés:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Itt az idő az adataink átvételére a másfél száz táblánkból. Ezt nagyon egyszerű kódokkal fogjuk megtenni:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- A horgon keresztül kivesszük Airflow-ból
pymssql-kapcsolat - A lekérdezésbe beillesztjük a dátumra vonatkozó korlátozást — ezt a sablonkezelő adja át a funkció számára.
- Küldjük el a lekérdezésünket
pandas, amely kinyeri számunkraDataFrame— ez később hasznos lesz számunkra.
A {dt} helyettesítést használom
a lekérdezés paramétere helyett%snem azért, mert gonosz Burahtino vagyok, hanem mertnem azért, mert gonosz BuraTino vagyok, hanem azért, mertpandasnem tud megbirkózni apymssqlés megpróbálja átpasszolni az utolsónakparams: Lista, bár ő nagyon szeretnéhasználhatjuk a tuple-t:.
Ne feledd, hogy a fejlesztőpymssqleldöntötte, hogy már nem támogatja, és ideje eltávozni apyodbc.
Nézzük, mivel látta el az Airflow a funkcióink érveit:
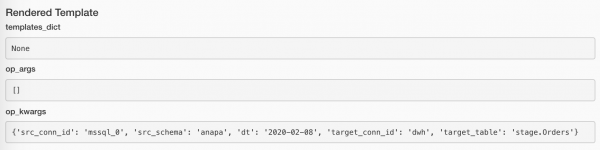
Ha nem voltak adatok, akkor nincs értelme folytatni. De azt is furcsa lenne mondani, hogy a feltöltés sikeres volt. Viszont ez nem hiba. A-a-a, mit tegyünk?! Íme:
if df.empty:
    raise AirflowSkipException('Nincsenek sorok a betöltéshez')
AirflowSkipException az Airflow azt mondja, hogy hiba valójában nincs, a feladatot kihagyjuk. A felületen nem zöld és nem piros négyzet lesz, hanem rózsaszín.
Adjuk meg az adatainknak néhány oszlopot:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Nevezetesen:
- Az adatbázisból, ahonnan a rendeléseket átvettük,
- A feltöltési session-unk azonosítója (ez változó lesz minden feladathoz),
- A forrás és a rendelés azonosító hash-e - hogy a végső adatbázisban (ahol minden egy táblába kerül) egyedi rendelésazonosítónk legyen.
Már csak egy lépés van hátra: mindent feltölteni a Verticába. Furcsán, de az egyik leghatékonyabb módszer ezt CSV-n keresztül csinálni!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Készítünk egy speciális vevőt
StringIO. pandasnagylelkűen beletölti aDataFramekiegészítő formájábanCSV-sorok.- Megnyitunk egy kapcsolatot a kedvenc Vertica hookunkkal.
- Most pedig a
copy()segítségével közvetlenül a Verticába küldjük az adatainkat!
Az illesztőprogramból elkérjük, hány sor sikerült betölteni, és értesítjük a session menedzserét, hogy minden rendben:
session.loaded_rows = cursor.rowcount
session.successful = True
Ennyi.
A termelési környezetben kézzel hozunk létre egy céltáblát. Itt egy kis automatizálásra tettem szert:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
A VerticaOperator() segítségével
létrehozom az adatbázis sémáját és a táblát (ha még nincsenek, természetesen). A lényeg, hogy helyesen állítsuk be a függőségeket:for conn_id, schema in sql_server_ds: load = PythonOperator( task_id=schema, python_callable=workflow, op_kwargs={ 'src_conn_id': conn_id, 'src_schema': schema, 'dt': '{{ ds }}', 'target_conn_id': target_conn_id, 'target_table': f'{target_schema}.{target_table}'}, dag=dag)create_table >> load
— Nos, — mondta a kis egér, — nem igaz, hogy mostÖsszegzés
– Na, látod, – mondta az egér, – nem igaz, hogy most már
Meggyőződtél arról, hogy az erdőben én vagyok a legfélelmetesebb vadállat?
Julia Donaldson, „Gruffalo”
Azt hiszem, ha a kollégáimmal versenyt rendeznék, hogy ki tudja gyorsabban létrehozni és elindítani az ETL-folyamatot a nulláról: ők az SSIS-sel és az egérrel, én pedig az Airflow-val... Aztán még össze is hasonlíthatnánk a karbantartás kényelmét... Hú, azt gondolom, egyetértesz, hogy minden fronton legyőzném őket!
Ha azonban komolyabban vesszük, az Apache Airflow - a folyamatok programkód formájában való leírása által - megkönnyítette és élvezetesebbé tette a munkámat. többre képes, mint amit ebben a cikkben elmondtunk. Remélem, hogy ez jó bevezetésként szolgál. A határtalan bővíthetősége: akár a bővítmények terén, akár a skálázhatóság irányában - lehetővé teszi, hogy az Airflow-t gyakorlatilag bármilyen területen alkalmazd: akár az adatok teljes gyűjtési, előkészítési és feldolgozási ciklusában, akár rakéták indításakor (persze, Marsra).
start_date
Záró rész, információs és tájékoztató jelleggel
Hibák, amiket összegyűjtöttünk Önnek
. Igen, ez már egy helyi mém. A DAG fő argumentumamindenhol ott van. Röviden, ha megadod a. Igen, ez már egy helyi mém. A DAG fő argumentumaaktuális dátumot, és a. Igen, ez már egy helyi mém. A DAG fő argumentumaschedule_interval-t– egy napot, a DAG holnap nem korábban fog elindulni.start_date = datetime(2020, 7, 7, 0, 1, 2)És többé semmi probléma.Egy másik hiba is kapcsolódik hozzá:
A feladat hiányzik a start_date paraméterrel
, ami legtöbbször azt jelenti, hogy elfelejtetted csatolni a DAG-hoz a műveletet.Minden egy gépen.- Igen, és az adatbázisok (maga az Airflow és a mi rétegünk), a webkiszolgáló, a ütemező és a munkások. És még működött is. De idővel a szolgáltatások feladatai nőttek, és amikor a PostgreSQL válaszideje 20 ms lett 5 helyett, elvittük. LocalExecutor.
- Igen, még mindig rajta ülünk, és már a szakadék szélén állunk. A LocalExecutor eddig elég volt, de most eljött az ideje, hogy minimum egy munkásra bővüljünk, és meg kell feszítenünk magunkat, hogy átálljunk a CeleryExecutor-ra. Tekintettel arra, hogy ezzel egy gépen is lehet dolgozni, semmi sem akadályoz meg abban, hogy a Celery-t még nem éles szerveren használjuk, ami „természetesen sosem fog productionbe menni, esküszöm!” A beépített eszközök
- Connections nem használata a szolgáltatások hitelesítő adatai tárolására,:
- SLA hiányok a feladatokkal kapcsolatos, amelyek nem futottak időben,
- XCom a metadadatok (mondtam
- meta adatok!) cseréjére a DAG feladatai között. metaadatok!) a dag feladatai között.
- E-mail visszaélés. Mit is mondhatnék? Be voltak állítva az értesítések az összes esésre vonatkozó feladatokról. Most a munkámhoz tartozó Gmail fiókomban >90k levél érkezett az Airflow-tól, és a webes levelezés nem hajlandó törölni többet egyszerre 100-nál.
További buktatók:
Még nagyobb automatizálási eszközök
Annak érdekében, hogy még inkább gondolkodjunk, ne pedig kézzel dolgozzunk, az Airflow a következőket kínálja számunkra:
- — még mindig kísérleti státuszú, de ez nem akadályozza meg a működését. Ezzel nemcsak információt kaphatunk a DAG-okról és feladatokról, hanem le is állíthatjuk/indíthatjuk a DAG-ot, létrehozhatunk DAG futtatást vagy pool-t.
- — a parancssorból sok eszköz érhető el, amelyek nemcsak kényelmetlenek a WebUI-n keresztül való használatban, hanem egyáltalán nem is elérhetők. Például:
backfillszükséges a feladatok példányainak újraindításához.
Például, ha az elemzők azt mondják: „De veled, barátom, hibák vannak az adatokban január 1. és 13. között! Javítsd! Javítsd! Javítsd!”. Akkor te így csinálsz:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Adatbázis karbantartás:
initdb,resetdb,upgradedb,checkdb. a "run" opcióval indul el., amely lehetővé teszi, hogy egyetlen feladat példányt indítsunk, figyelmen kívül hagyva az összes függőséget. Sőt, elindíthatjuk aLocalExecutor, még akkor is, ha Celery klasztered van.- Körülbelül ugyanezt teszi a
teszt, csak éppen nem ír be az adatbázisba. connectionstömeges kapcsolatok létrehozását teszi lehetővé a shell-ből.
- — elég hardcore módszer a kölcsönhatásra, amely pluginok számára készült, nem pedig a kézikönyvvel való babrálásra. De ki akadályoz meg minket abban, hogy eljárjunk a
/home/airflow/dags, elindítsuk aipythonés elkezdjünk uralkodni? Például, exportálhatjuk az összes kapcsolatot ilyen kóddal:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Kapcsolódás az Airflow metadatbázishoz. A beírást nem ajánlom, de a feladatok állapotainak kiolvasása különböző sajátos metrikákhoz jelentősen gyorsabb és egyszerűbb, mint bármely API-n keresztül.
Mondjuk, hogy nem minden feladatunk idempotens, és néha meghiúsulnak, ami normális. De ha több hiba is előfordul, az már gyanús, és érdemes ellenőrizni.
Vigyázat, SQL!
WITH last_executions AS (
SELECT
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
FROM public.task_instance
WHERE
    execution_date > now() - INTERVAL '2' DAY
),
failed AS (
    SELECT
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    FROM last_executions
    WHERE
        state IN ('failed', 'up_for_retry')
)
SELECT
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
FROM failed
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Hivatkozások
Nos és természetesen az első tíz link tartalma a Google keresési eredményeiből az Airflow mappából a könyvjelzőimből.
- — természetesen azzal kell kezdeni az hivatalos dokumentációnál, de ki olvassa az utasításokat?
- — legalább a készítők ajánlásait olvasd el.
- — a legelső: a felhasználói felület képeken
- — jól ki van dolgozva az alapfogalmak leírása, ha (valahogyan!) valamit nem értesz, amit mondtam.
- — egy rövid útmutató az Airflow klaszter beállításához.
- — majdnem egy olyan érdekes cikk, csak kicsit több a formális rész, és kevesebb a példa.
- — a Celery-vel való együttműködésről.
- — a feladatok idempotenciájáról, az ID szerinti betöltésről dátum helyett, transzformációkról, fájlstruktúráról és egyéb érdekes dolgokról.
- — a feladatok függőségei és a Trigger Rule, amiről csak félmondatban beszéltem.
- — hogyan lépjünk át néhány „úgy működik, ahogy kellene” a tervezőn, betöltsük az elveszett adatokat és priorizáljuk a feladatokat.
- — hasznos SQL lekérdezések az Airflow metadatához.
- — van egy hasznos szakasz a testreszabott érzékelők létrehozásáról.
- — érdekes rövid megjegyzés az AWS-en történő Data Science infrastruktúra felépítéséről.
- — elterjedt hibák (amikor valaki egyáltalán nem olvassa az utasításokat).
- — mosolyogj, ahogy az emberek a jelszavak tárolását megoldják, holott egyszerűen használhatnák a Connections-t.
- — implicit DAG forwarding, passing context into functions, again about dependencies, and also about skipping task runs.
- — arról, hogy hogyan használjuk
alapértelmezett argumentumokésparamssablonokban, valamint a Variables és Connections-ről. - — arról, hogyan készítik fel az ütemezőt az Airflow 2.0-hoz.
- — egy kicsit elavult cikk a klaszterünk telepítéséről
docker-compose. - — dinamikus feladatok sablonok és kontextus átadásával.
- — alapértelmezett és egyedi értesítések e-mailben és Slack-en.
- — Feladat elágazások, makrók és XCom.
És a cikkben említett linkek:
- — a sablonokban használható helyettesítők.
- — Gyakori hibák a DAG-ok létrehozásakor.
- —
docker-composekísérletezéshez, hibakereséshez és nem csak. - — Python csomagoló a Telegram REST API-hoz.
Forrás: habr.com
