

Helló, Habr! Ma egy olyan rendszert építünk, amely a Spark Streaming segítségével kezeli az Apache Kafka üzenetfolyamokat, és elmenti az eredményeket az AWS RDS felhőbázisába.
Tegyük fel, hogy egy hitelintézet előtt áll ez a feladat, hogy valós időben dolgozza fel a bejövő tranzakciókat az összes fiókjában. Ezt a nyitott deviza pozíciók, limitek vagy a tranzakciók pénzügyi eredményének gyors kiszámítására lehet használni, stb.
Hogyan valósítsuk meg ezt az esetet varázslat és bűbájok alkalmazása nélkül — olvass tovább! Indulhatunk!
Bevezetés
Kétségtelen, hogy a nagyméretű adatmennyiség valós idejű feldolgozása széles lehetőségeket nyújt a modern rendszerek számára. Az egyik legnépszerűbb kombináció erre az Apache Kafka és a Spark Streaming párosa, ahol a Kafka hozza létre a bejövő üzenetek csomagjainak folyamatát, míg a Spark Streaming ezeket a csomagokat egy adott időintervallumban dolgozza fel.
Az alkalmazás megbízhatóságának növelése érdekében ellenőrző pontokat (checkpoints) fogunk használni. E mechanizmus segítségével, amikor a Spark Streaming modulnak vissza kell állítania az elveszett adatokat, csak annyit kell tennie, hogy visszatér az utolsó ellenőrző pontra, és folytatja a számításokat onnan.
A kidolgozott rendszer architektúrája
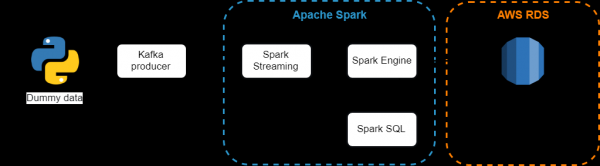
A használt összetevők:
- — ez egy elosztott üzenetküldő rendszer, amely támogatja a publikálást és előfizetést. Alkalmas mind offline, mind online üzenetek fogyasztására. Az adatok elvesztésének elkerülése érdekében a Kafka üzeneteket lemezre menti és replikálja a klaszterben. A Kafka rendszere a ZooKeeper szinkronizáló szolgáltatásra épül;
- — a Spark component for stream processing. The Spark Streaming module is built using a "micro-batch architecture," where a data stream is interpreted as a continuous sequence of small data batches. Spark Streaming receives data from various sources and combines them into small batches. New batches are created at regular time intervals. At the beginning of each time interval, a new batch is created, and any data that arrives during that interval is included in the batch. At the end of the interval, the batch size increase stops. The interval size is determined by a parameter called the batch interval;
- — combines relational processing with Spark's functional programming. Structured data refers to data that has a schema, meaning a common set of fields for all records. Spark SQL supports input from various sources of structured data and, due to the presence of schema information, it can efficiently extract only the necessary fields from records while also providing DataFrame API interfaces;
- — a relatively inexpensive cloud relational database web service that simplifies setup, operation, and scaling, managed directly by Amazon.
Installing and running the Kafka server
Before using Kafka directly, ensure that Java is available, as JVM is required for operation:
sudo apt-get update
sudo apt-get install default-jre
java -version
Let's create a new user to work with Kafka:
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
Next, download the distribution from the official Apache Kafka website:
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Extract the downloaded archive:
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
The next step is optional. The default settings do not allow for full use of all Apache Kafka features. For example, deleting topics, categories, or groups where messages can be published. To change this, let's edit the configuration file:
vim ~/kafka/config/server.propertiesAdd the following at the end of the file:
delete.topic.enable = trueA Kafka szerver elindítása előtt el kell indítani a ZooKeeper szervert, ehhez egy segédprogramot fogunk használni, amely a Kafka disztribúcióval érkezik:
Cd ~/kafka
bin/zookeeper-server-start.sh config/zookeeper.properties
Miután a ZooKeeper sikeresen elindult, egy külön terminálban elindítjuk a Kafka szervert:
bin/kafka-server-start.sh config/server.propertiesHozzunk létre egy új témát Transaction néven:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionGyőződjünk meg arról, hogy a téma a megfelelő számú partikcióval és replikációval létrejött:
bin/kafka-topics.sh --describe --zookeeper localhost:2181 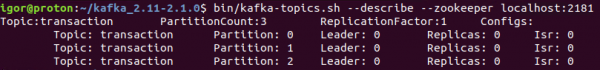
Hagyjuk ki a producer és consumer tesztelésének pillanatait az újonnan létrehozott témához. Részletesebben arról, hogyan lehet tesztelni az üzenetek küldését és fogadását, az hivatalos dokumentációban olvasható — . Viszont most áttérünk egy producer írására Pythonban a KafkaProducer API használatával.
A producer írása
A producer véletlenszerű adatokat fog generálni — másodpercenként 100 üzenetet. Véletlenszerű adatok alatt egy három mezőből álló szótárt értünk:
- Fiók — a hitelintézet értékesítési pontjának megnevezése;
- Currency — a tranzakció valutája;
- Amount — a tranzakció összege. Az összeg pozitív szám lesz, ha a Bank valutát vásárol, és negatív, ha eladja.
A producer kódja a következőképpen néz ki:
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
Ezután a send metódus használatával küldjük el az üzenetet a szerverre, a kívánt témába, JSON formátumban:
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Az üzenet a következő témába került küldésre:
            {}, partició: {}, offset: {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Úgy tűnik, hiba történt: {}'.format(e))

finally:
    producer.flush()
A skript futtatásakor a következő üzeneteket kapjuk a terminálban:
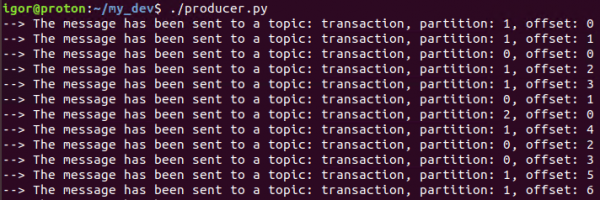
Ez azt jelenti, hogy minden úgy működik, ahogy akartuk — a producer véletlenszerűen generál és küld üzeneteket a kívánt témába.
A következő lépés a Spark telepítése és ennek a folyamatnak a feldolgozása lesz.
Apache Spark telepítése
Apache Spark — egy univerzális és nagy teljesítményű klaszter alapú számítási platform.
Teljesítmény szempontjából a Spark felülmúlja a népszerű MapReduce megvalósításokat, miközben szélesebb számítási típusok támogatását is biztosítja, beleértve az interaktív lekérdezéseket és a folyamatfeldolgozást. A sebesség kulcsszerepet játszik a nagy adatmennyiségek feldolgozásakor, mivel a gyorsaság lehetővé teszi az interaktív munkát, nem pazarolva perceket vagy órákat a várakozásra. A Spark egyik legfontosabb előnye, amely biztosítja ezt a magas sebességet, a memória alapú számítások végrehajtásának képessége.
Ez a keretrendszer Scala nyelven íródott, ezért először ezt kell telepíteni:
sudo apt-get install scalaTöltsük le a Spark disztribúcióját az hivatalos weboldalról:
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Csomagoljuk ki az archívumot:
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkAdjuk hozzá a Spark elérési útját a bash fájlhoz:
vim ~/.bashrcA szövegszerkesztőben adjuk hozzá a következő sorokat:
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Futtassuk az alábbi parancsot a bashrc módosítása után:
source ~/.bashrcAWS PostgreSQL telepítése
Most telepítenünk kell az adatbázist, ahová az áramlásokból feldolgozott információt feltöltjük. Ehhez az AWS RDS szolgáltatást fogjuk használni.
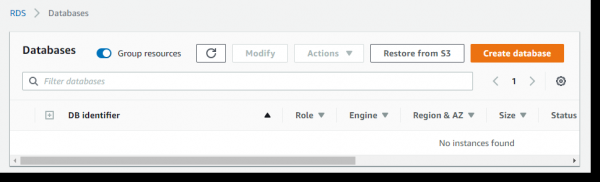
Lépjünk be az AWS konzolba —> AWS RDS —> Adatbázisok —> Adatbázis létrehozása:
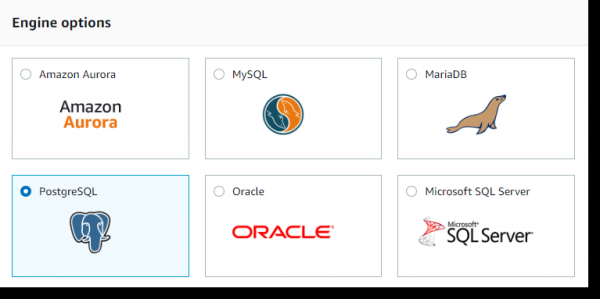
Válasszuk a PostgreSQL-t, majd kattintsunk a Tovább gombra:
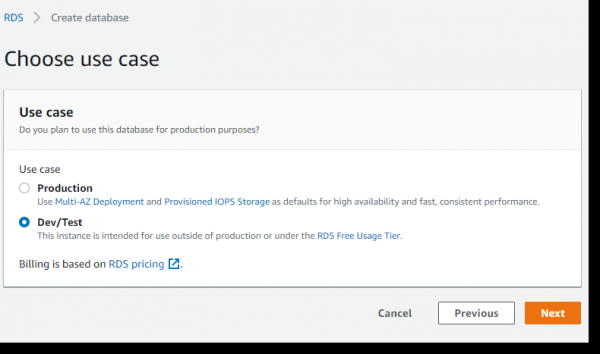
Mivel ez a példa kizárólag oktatási célokra készült, egy ingyenes "minimalista" szervert (Free Tier) fogunk használni:
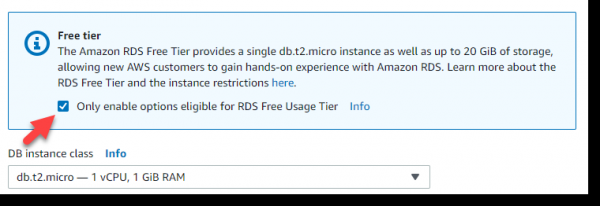
Ezután pipáljuk be a Free Tier blokkot, majd automatikusan egy t2.micro példányt fogunk kapni — bár gyenge, de ingyenes és teljesen megfelelő a feladatunkhoz:
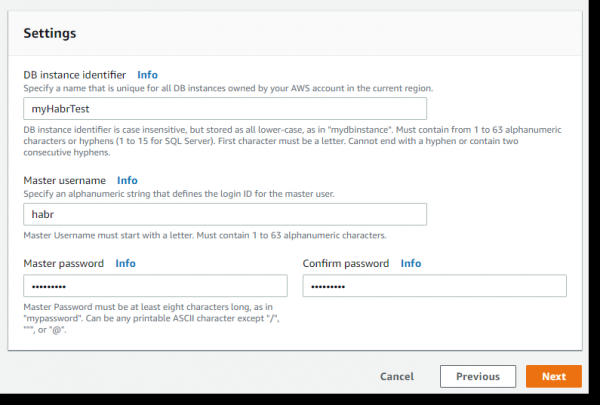
Ezután nagyon fontos adatokat kell megadnunk: az adatbázis példányának nevét, a mesterfelhasználó nevét és jelszavát. Elnevezhetjük az példányt: myHabrTest, mesterfelhasználó: habr, jelszó: habr12345 és kattintsunk a Tovább gombra:
A következő oldalon találhatók azok a paraméterek, amelyek a db szerverünk nyilvános elérhetőségét (Külső elérhetőség) és a portok elérhetőségét szabályozzák:
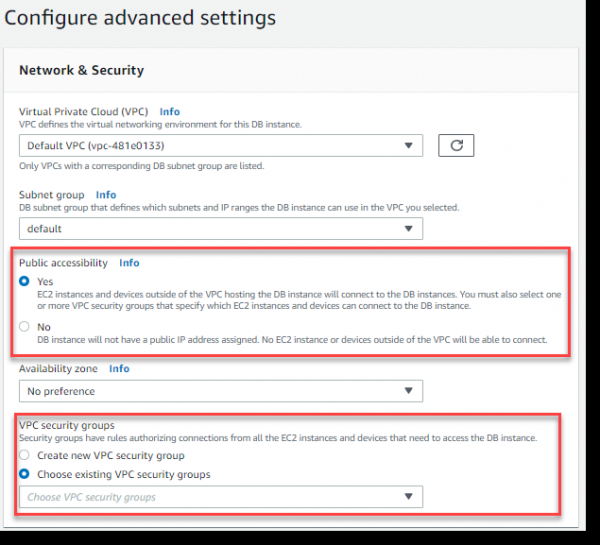
Hozzunk létre egy új beállítást a VPC biztonsági csoporthoz, amely lehetővé teszi, hogy kívülről a 5432-es porton (PostgreSQL) keresztül hozzáférhessünk az adatbázis szerverünkhöz.
Nyissunk meg egy új böngészőablakot, és lépjünk be az AWS konzolba a VPC Dashboard —> Biztonsági csoportok —> Biztonsági csoport létrehozása szakaszra:
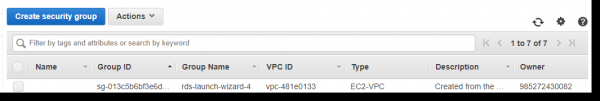
Megadjuk a nevet a Security group számára — PostgreSQL, leírás, megadjuk, hogy melyik VPC-hez kell társítani ezt a csoportot, és rákattintunk a Create gombra:

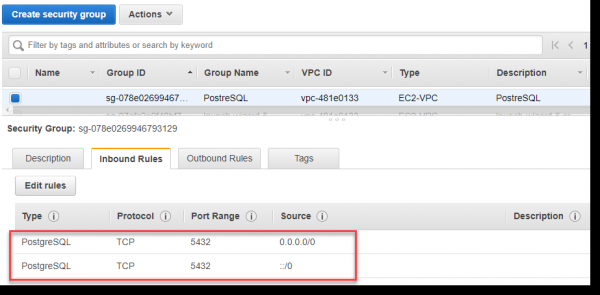
Kitöltjük a frissen létrehozott csoport Inbound rules részét az 5432-es porthoz, ahogy az alábbi képen látható. A portot manuálisan nem szükséges megadni, válasszuk inkább a PostgreSQL-t a Type legördülő listából.
Szigorúan véve, a ::/0 érték a bejövő forgalom elérhetőségét jelenti a szerver számára az egész világból, ami kanonikus értelemben nem teljesen helyes, de a példa elemzése érdekében megengedhetjük magunknak ezt a megközelítést:
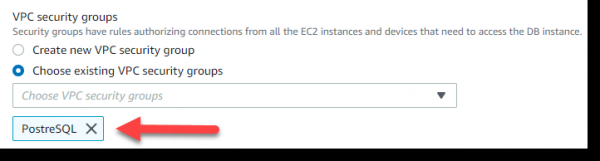
Visszatérünk a böngésző oldalához, ahol a 'Configure advanced settings' nyitva van, és a VPC security groups szekcióban választjuk a Choose existing VPC security groups lehetőséget —> PostgreSQL:
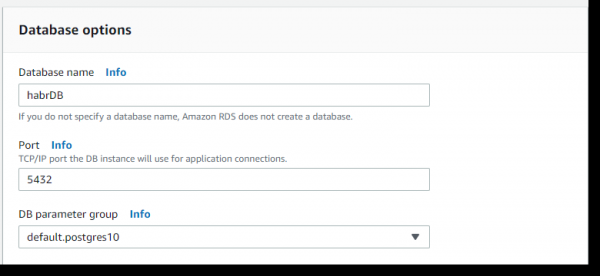
Ezután az Database options részben —> Database name —> megadjuk a nevet — habrDB.
A többi paramétert, kivéve talán a biztonsági mentések kikapcsolását (backup retention period — 0 days), a monitorozást és a Performance Insights-t, alapértelmezetten hagyhatjuk. Kattintsunk a gombra Create database:
Folyamatkezelő
A végső lépés a Spark-job kidolgozása lesz, amely minden két másodpercben új adatokat dolgoz fel, amelyeket a Kafka küldött, és az eredményt az adatbázisba írja.
Ahogy fentebb említettük, a checkpointok a Spark Streaming alapvető mechanizmusai, amelyeket be kell állítani a hibatűrőség biztosítása érdekében. Használni fogjuk a checkpointokat, és amennyiben a folyamat megszakad, a Spark Streaming moduljának az elveszett adatok helyreállításához egyszerűen vissza kell térnie az utolsó checkpointhoz, és folytatni a számítást onnan.
A checkpoint aktiválható, ha a megbízható, hibatűrő fájlrendszerben (például HDFS, S3 stb.), ahol a checkpoint információt tárolni fogják, beállítjuk a könyvtárat. Ezt például a következőképpen tesszük:
streamingContext.checkpoint(checkpointDirectory)A példánkban a következő megközelítést alkalmazzuk: ha a checkpointDirectory létezik, a kontextus a checkpoint adataiból lesz újra létrehozva. Ha a könyvtár nem létezik (azaz először fut), akkor a functionToCreateContext függvény hívódik meg az új kontextus létrehozása és a DStreams beállítása érdekében:
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Létrehozunk egy DirectStream objektumot, amely a 'transaction' témához való kapcsolódás céljából történik a KafkaUtils könyvtár createDirectStream metódusán keresztül:
a pyspark.streaming.kafka importáljuk a KafkaUtils-t

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaction'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
A bejövő adatokat JSON formátumban elemezzük:
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
Spark SQL használatával egyszerű csoportosítást végzünk, és a kimenetet a konzolon jelenítjük meg:
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
A lekérdezés szövegének megkapása és annak futtatása Spark SQL-ben:
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
Ezután az aggregált adatokat egy táblába mentjük az AWS RDS-en. Az aggregálás eredményeinek táblába mentéséhez a DataFrame write metódusát fogjuk használni:
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
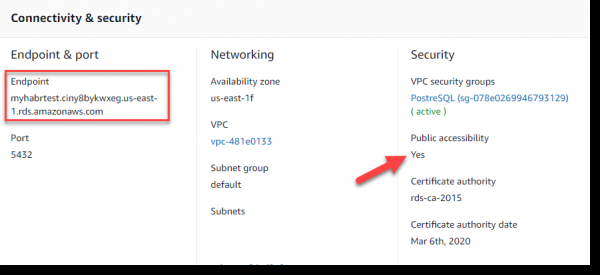
Néhány szó az AWS RDS-hez való csatlakozás beállításáról. A felhasználót és a jelszót a „AWS PostgreSQL telepítése” lépésben hoztuk létre. Az adatbázis szerver URL-jeként az Endpoint-ot kell használni, amely a Connectivity & security részben található:
A Spark és a Kafka helyes összekapcsolása érdekében a feladatot a spark-submit paranccsal kell futtatni az artefaktus használatával spark-streaming-kafka-0-8_2.11. Ezen kívül egy PostgreSQL adatbázissal való interakcióhoz is szükséges artefaktust fogunk alkalmazni, amelyeket az —packages kapcsolón keresztül fogunk megadni.
A szkript rugalmassága érdekében az üzenetküldő szerver nevét és a témát, ahonnan az adatokat szeretnénk kapni, bemeneti paraméterként is kiemeljük.
Így eljött az idő, hogy elindítsuk és ellenőrizzük a rendszer működését:
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaction
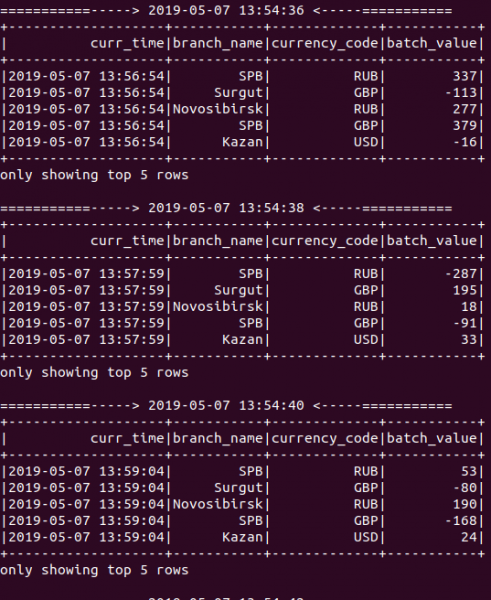
Minden rendben zajlott! Ahogy az alábbi képen látható — az alkalmazás működése során az új aggregálási eredmények 2 másodpercenként jelennek meg, mivel a StreamingContext objektum létrehozásakor 2 másodpercre állítottuk a csomagolási intervallumot:
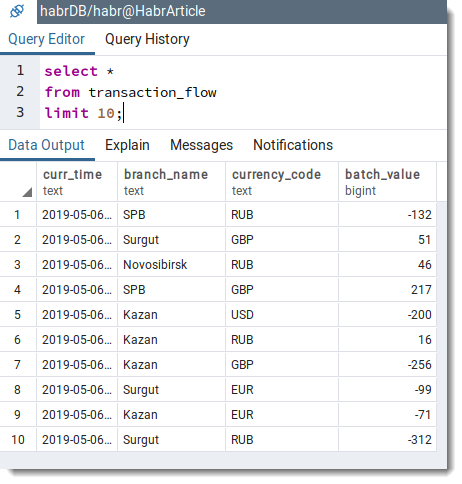
Ezután egy egyszerű lekérdezést végzünk az adatbázisban, hogy ellenőrizzük a táblában lévő bejegyzések meglétét transaction_flow:
Zárás
A cikkben a Spark Streaming információfeldolgozás példáját tárgyaltuk, az Apache Kafka és a PostgreSQL kombinációjával. Az adatok különböző forrásokból történő növekedésével nehéz túlbecsülni a Spark Streaming gyakorlati értékét streamelt alkalmazások és valós idejű működésű alkalmazások létrehozásához.
A teljes forráskódot megtalálhatja a tárolómban a .
Örömmel várom a cikk megbeszélését, várom a megjegyzéseit, és bízom a konstruktív kritikákban minden érdeklődő olvasótól.
Sok sikert kívánok!
Ps. Kezdetben egy helyi PostgreSQL adatbázist terveztem használni, de figyelembe véve az AWS iránti szeretetemet, úgy döntöttem, hogy az adatbázist a felhőbe helyezem. A következő cikkben bemutatom, hogyan lehet teljes egészében megvalósítani a fent leírt rendszert az AWS Kinesis és az AWS EMR segítségével. Figyelje a híreket!
Forrás: habr.com
