

2017-ben megnyertük az Alfa-Bank befektetési üzletágának tranzakciós magjának fejlesztésére kiírt pályázatot, és elkezdtük a munkát (a HighLoad++ 2018 konferencián előadást tartottunk a befektetési üzletág magjáról) Vladimir Drynkin, az Alfa-Bank befektetési üzletágának tranzakciós magjáért felelős vezetője). Ez a rendszer aggregálta volna a különböző forrásokból származó tranzakciós adatokat, különböző formátumokban, egységes megjelenésre alakította volna az adatokat, tárolta volna azokat és hozzáférést biztosított volna számukra.
A fejlesztés során a rendszer folyamatosan fejlődött és bővült új funkciókkal, és egy idő után rájöttünk, hogy valami sokkal nagyobb formálódik, mint csupán egy alkalmazás, amely meghatározott problémák megoldására készült: egy elosztott alkalmazások építésére szolgáló rendszer, tartós adattárral. A megszerzett tapasztalatunk megalapozta az új terméket — (TDG).
Szeretném bemutatni a TDG architektúráját és azokat a megoldásokat, amelyeket a fejlesztés során találtunk, megismertetni önöket a fő funkciókkal, és megmutatni, hogyan válhat a termékünk alapjává a komplex megoldások megvalósításához.
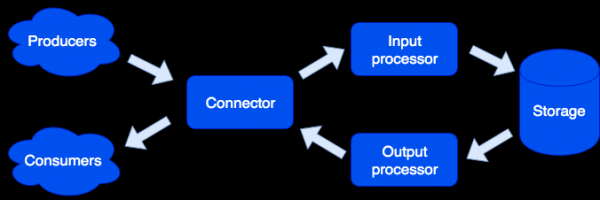
Architekturálisan a rendszert különálló részekre osztottuk szereket, amelyek mindegyike egy meghatározott feladatkör megoldásáért felelős. Egy futó alkalmazás példány egy vagy több szerepkört valósít meg. A klaszterben több azonos típusú szerepkör is lehet:
Connector
A connector is responsible for communication with the external world; its task is to receive a request, parse it, and if successful, send the data for processing to the input processor. We support HTTP, SOAP, Kafka, and FIX formats. The architecture allows for easy addition of support for new formats, with IBM MQ support expected soon. If the request parsing fails, the connector will return an error; otherwise, it will respond that the request was processed successfully, even if an error occurred during further processing. This is done intentionally to work with systems that cannot repeat requests—or, conversely, do so too insistently. To avoid data loss, a repair queue is used: an object first enters it and is only removed after successful processing. The administrator can receive notifications about objects left in the repair queue and can retry after fixing a software error or hardware failure.
Input processor
The input processor classifies the incoming data by characteristic features and invokes the appropriate handlers. The handlers are code written in Lua, executed in a sandbox, and therefore cannot affect system functionality. At this stage, the data can be brought into the required format, and if necessary, an arbitrary number of tasks can be launched that implement the needed logic. For example, in the MDM (Master Data Management) product built on the Tarantool Data Grid, when adding a new user, to avoid slowing down the request processing, the creation of the golden record is launched as a separate task. The sandbox supports read, modify, and add data requests, allows some function to be executed on all storage-type roles, and aggregates the results (map/reduce).
Handlers can be described in files:
sum.lua

local x, y = unpack(...)
return x + y
And then declared in the configuration:
functions:
  sum: { __file: sum.lua }
Why Lua? Lua is a very simple language. Based on our experience, a few hours after getting acquainted with it, people start writing code that solves their task. And this includes not only professional developers but also, for example, analysts. Moreover, thanks to the JIT compiler, Lua runs very quickly.
Tárolás
A tárolás tartós adatokat tárol. A mentés előtt az adatok validáláson mennek át az adatmodellnek való megfelelés érdekében. A séma leírásához kibővített formátumot használunk. . Példa:
{
    "name": "Felhasználó",
    "type": "record",
    "logicalType": "Összevonás",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "kereszt_név", "type": "string"},
        {"name": "vezeték_név", "type": "string"}
    ],
    "indexes": ["id"]
}
A fenti leírás alapján automatikusan generálódik a DDL (Data Definition Language) a Tarantool adatbázis-kezelőhöz és séma az adatok eléréséhez.
Támogatott az aszinkron adatreplicáció (a terveink között szerepel a szinkronizálás hozzáadása).
Output processor
Néha értesíteni kell a külső fogyasztókat az új adatokról, erre létezik az Output processor szerep. Az adatok mentése után átadhatók a megfelelő feldolgozónak (például hogy a fogyasztó által megkövetelt formátumban álljanak elő) — majd azt követően a connectorhoz elküldésre. Itt is használunk egy javító sort: ha senki nem fogadta el az objektumot, a rendszergazda megpróbálhatja később.
Skálázhatóság
A connector, input processor és output processor szerepei állapotmentesek, ami lehetővé teszi számunkra, hogy vízszintesen skálázzuk a rendszert, egyszerűen új példányokat hozzáadva a szükséges típusú szereppel rendelkező alkalmazásból. A tárolás vízszintes skálázásához a klaszter szervezése virtualizált tárolók használatával. Új szerver hozzáadásakor a régi szerverek tárolóinak egy részét háttérben átköltöztetjük az új szerverre; ez átlátható a felhasználók számára, és nem befolyásolja a rendszer működését.
Adatok tulajdonságai
Az objektumok nagyon nagyok lehetnek, és más objektumokat is tartalmazhatnak. Biztosítjuk az adatok hozzáadásának és frissítésének atomaritását, az objektumot minden függőségével együtt egy virtuális tárolóba mentve. Így elkerülhető az objektum „elmosódása” több fizikai szerver között.
Támogatott a verziózás: minden objektum frissítése új verziót hoz létre, így mindig készíthetünk időbeli metszeteket, hogy megnézzük, hogyan nézett ki a világ akkor. Azoknál az adatoknál, amelyeknek nincs szükségük hosszú történetre, korlátozhatjuk a verziók számát vagy akár csak az egyet — a legutolsót tárolva —, azaz gyakorlatilag letilthatjuk a verziózást egy adott típusról. Az idő alapi történet korlátozása is lehetséges: például törölhetünk minden olyan objektumot, amely egy évnél régebbi. Az archíválás is támogatott: az időkorlátot túllépő objektumokat ki lehet exportálni, így helyet szabadítva fel a klaszterben.
Feladatok
Érdekes funkcióként kiemelhető a feladatok időzített végrehajtásának lehetősége, felhasználói kérésre vagy programozottan a homokozóból:
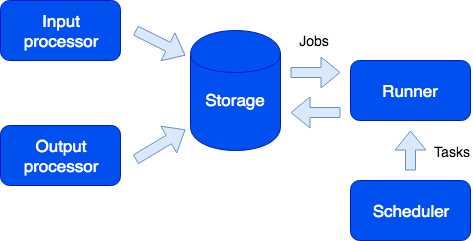
Itt egy újabb szerepet látunk — runner. Ez a szerep állapot nélküli, és szükség esetén további példányokat lehet hozzáadni a klaszterhez ezen szereppel. A runner feladata a feladatok végrehajtása. Mint említettem, a homokozóból új feladatok hozhatók létre; ezek a tárolóban várakoznak, majd a runner végrehajtja őket. Ezt a feladattípust Job-nak hívjuk. Van egy másik feladattípusunk is, ami Task néven ismert — ez a felhasználó által definiált és időzítéssel (cron szintaxis) vagy kérésre indított feladatok. Az ilyen feladatok indításához és nyomon követéséhez kényelmes feladatkezelőt kínálunk. Ennek a funkciónak a használatához szükséges aktiválni a scheduler szerepet; ez állapotot birtokol, így nem méretezhető, ami egyébként nem is szükséges; ez a szerep, mint a többi, rendelkezhet replikával, amely aktiválódik, ha a mester véletlenül meghibásodik.
Logger
Még egy szerep a logger. Ez gyűjti a naplókat a klaszter összes tagjától, és felületet biztosít azok kiemelésére és megtekintésére a webes felületen.
Szolgáltatások
Meg kell említeni, hogy a rendszer lehetővé teszi a szolgáltatások egyszerű létrehozását. A konfigurációs fájlban meg lehet adni, hogy mely kéréseket kell a felhasználó által írt kezelőre irányítani, amely a homokozóból fut. Ebben a kezelőben például végrehajthatunk egy analitikai lekérdezést, és visszaadhatjuk az eredményt.
A szolgáltatás a konfigurációs fájlban van leírva:
services:
   sum:
      doc: "két számot ad össze"
      function: sum
      return_type: int
      args:
         x: int
         y: int
A GraphQL API automatikusan generálódik, és a szolgáltatás elérhetővé válik a hívásra:
lekérdezés {
   összeg(x: 1, y: 2)
}
Ez a kezelőhívást eredményezi összeg, amely visszaadja az eredményt:
3
Lekérdezések profilozása és metrikák
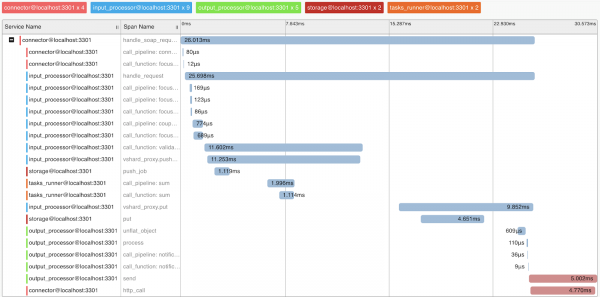
A rendszer működésének megértése és a lekérdezések profilozása érdekében megvalósítottuk az OpenTracing protokoll támogatását. A rendszer igény szerint küldheti az információkat a protokollt támogató eszközöknek, például a Zipkin-nak, ami lehetővé teszi, hogy átlássuk, hogyan történt a lekérdezés:
Természetesen a rendszer belső metrikákat is biztosít, amelyeket a Prometheus segítségével gyűjthetünk és a Grafana segítségével vizualizálhatunk.
Deploy
A Tarantool Data Grid telepíthető RPM csomagokból vagy archívumokból, az adott eszköz vagy Ansible segítségével, a Kubernetes is támogatott ().
Az üzleti logikát megvalósító alkalmazások (konfigurációk, kezelők) archívumként kerülnek betöltésre a telepített Tarantool Data Grid klaszterbe, legyen az a UI-n keresztül vagy egy általunk biztosított API segítségével.
Alkalmazásminták
Milyen alkalmazások készíthetők a Tarantool Data Grid segítségével? Valójában a legtöbb üzleti feladat így vagy úgy az adatok feldolgozásához, tárolásához és eléréséhez kapcsolódik. Ezért, ha nagy adatáramokat kell megbízhatóan tárolnia és hozzáférnie, termékünk sok időt spórolhat meg a fejlesztés során, lehetővé téve, hogy a saját üzleti logikájára összpontosítson.
Például, információt szeretnénk gyűjteni az ingatlanpiacról, hogy később, például a legjobban megtérülő ajánlatokkal kapcsolatban információnk legyen. Ebben az esetben a következő feladatokat jelöljük ki:
- A nyílt forrásokból információt gyűjtő robotok — ezek lesznek a mi adatforrásaink. Ezt a feladatot megoldhatja kész megoldások használatával vagy bármilyen nyelven kód megírásával.
- Ezután a Tarantool Data Grid fogadni és tárolni fogja az adatokat. Ha az adatformátumok különböznek a különböző forrásokból, írhat Lua nyelven egy kódot, amely egységes formátumra alakítja azokat. Az előfeldolgozás során például szűrheti a duplikált ajánlatokat vagy kiegészítheti az ingatlanpiacon dolgozó ügynökökről szóló információkat az adatbázisban.
- Most már van egy skálázható megoldása a klaszterben, amelyet adatainak feltöltésére és lekérdezések végrehajtására használhat. Ezen felül új funkciókat is megvalósíthat, például írhat egy szolgáltatást, amely lekérdezi az adatokat, és a nap során a legkedvezőbb ajánlatot adja – ez néhány sor konfigurációs fájlban és egy kis Lua kódban valósítható meg.
Mi következik?
Prioritásunk a fejlesztés kényelmének fokozása a . Például ez egy IDE, amely támogatja a profilozást és a homokozóban futó kezelők hibakeresését.
Emellett kiemelt figyelmet fordítunk a biztonsági kérdésekre. Jelenleg a Rosztechcert által végzett tanúsításon veszünk részt, hogy megerősítsük a magas biztonsági szintet és megfeleljünk a személyes adatok informatikai rendszereiben és a állami informatikai rendszerekben alkalmazott szoftverek tanúsítására vonatkozó követelményeknek.
Forrás: habr.com
