

Szentpétervárral
Mindenkinek jó napot! Mons Andersonek hívnak, a platform architektája vagyok , elmondom, hogyan építettük fel az S3 tárolónkat, hogyan működik, mik voltak a sikeres megoldások és min változtatnánk, ha most kezdenénk egy hasonló projektet a nulláról.
A cikk a Mail.ru Cloud Solutions & Tarantool konferencián tartott előadás alapján készült. A cikkben beszélünk: hogyan volt felépítve a Mail.ru tároló, amelyre az S3 tárolónkat építettük;
- mit adtunk hozzá, hogy létrehozzuk a Mail.ru Cloud Storage-t;
- hogyan működik az objektumtárolási modell és milyen lépéseket tettünk a produkcióba lépéshez;
- a harci rendszer fejlesztéseiről: failover és skálázás;
- hogyan valósítottuk meg a shardolást és a reshardo-t;
- valamint az SSL tanúsítványokkal való munkáról.
- Ha nem akarsz olvasni, akkor
Hogyan volt felépítve a Mail.ru tároló, amelyre az S3 tárolónkat építettük .
Az S3 fejlesztése a Mail.ru Cloud tárolón alapult, így először el kell mondani, hogyan van felépítve és mire képes.
A Mail.ru Cloud tároló merevlemezes szerverekből áll. Átlagosan egy modern storage-szerver 36 db 12–14 terabájtos lemezből áll. Korábban kisebbek voltak a lemezek, de három év alatt a tárolókapacitás megnőtt, és ma ez majdnem fél petabájt nyers adat.
A tároló szerverek lemezei úgynevezett „párokba” (pair) vannak egyesítve. A pár egyetlen fájlt tároló egység. Valójában ez az a lemez, amely egy meghatározott szakaszban, egy meghatározott úton van csatlakoztatva, ahol fájlok találhatók, amelyeket hash-ek azonosítanak.
A pár egy történelmi név, amely a mai napig megmaradt, bár ma már nem kötelező, hogy csak két lemez szerepeljen a párban. Lehet akár három lemez, és különböző hibrid tárolások is létezhetnek, például 3/2.
A párok (pair) az objektumok tárolásának egységei
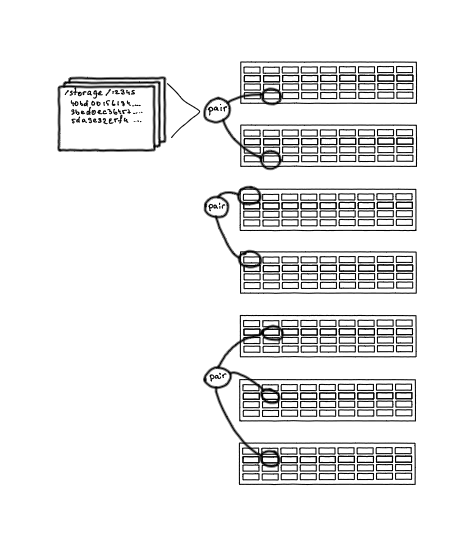
Minden pár a PairDB-ben tárolódik – ez egy Tarantool alapú alkalmazás. Minden adatbázis a tárolóban, az elsőktől kezdve, Tarantool, más adatbázisokat nem használunk.
A PairDB tárolja az összes párt, azok állapotát, a szabad helyet, a hibaelhárítási lehetőségeket és az utolsó hibákat. Emellett képes saját magát is frissíteni a párokon, aktualizálni azok állapotát, ellenőrizni, hogy működnek-e. Tehát a PairDB egyfajta általános képet ad a rendszerünk összes lemezének állapotáról.
Pair DB: az állapotokkal rendelkező pár adatbázis
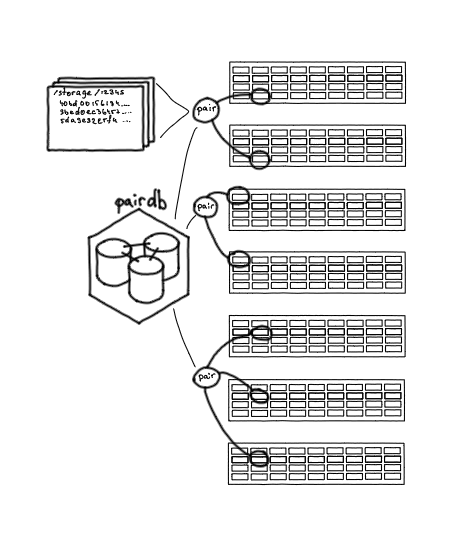
Pair DB: az állapotokkal rendelkező pár adatbázis
A párok adatokat tárolnak, és ahhoz, hogy tudjuk, melyik fájl hol található, szükség van egy másik adatbázisra - FileDB. Ez tárolja a fájlok és párok közötti megfeleltetést, például: ez a fájl itt található a másik párban, illetve néhány szükséges attribútumot.
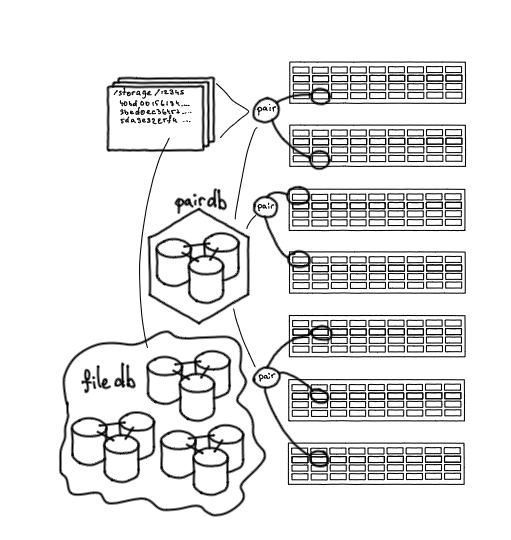 File DB: a fájlok tárolásának helye
Egy másik fontos elem a Nylon szolgáltatás, amely egy router az adatbázisok kezelésére. Ez az egyetlen belépési pont, lehetővé teszi, hogy egységes felületen dolgozzunk a PairDB-vel és a FileDB-vel is. Ez egy stateless szolgáltatás, amely kéri a lekérdezések terheléselosztását, tudja, hogy a FileDB mely shardjára kell menni, és ismeri, hogy mely párok aktívak és melyek nem.
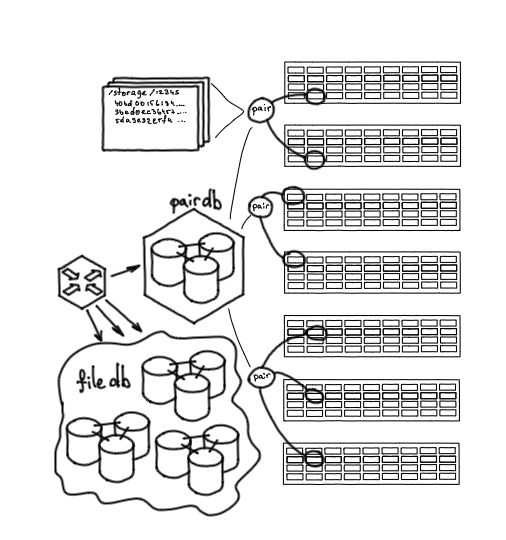
Nylon: router az adatbázisok kezelésére
A tárolóba valamilyen módon tartalmat is kell bevinni. Erre a Streamer szolgáltatás van. Ez két HTTP-módszert kínál: PUT módszert, hogy tartalmat töltsünk fel a tárolóba, és GET módszert, hogy onnan letölthessük. Az HTTP egy elég népszerű és kényelmes adatátviteli protokoll.
Amikor a Streamerhez fordulunk, az a Nylonon keresztül kapcsolatba lép a PairDB-vel, megállapítja, hogy melyik párra lehet a fájlt feltölteni, majd WebDAV-on keresztül átadja az adatokat erre a párra.
Lényegében bármilyen tárolószerver nginx plusz a megadott útvonalakon csatlakoztatott lemezek kombinációja. A Streamer segítségével fájlt tölthetünk fel a tárolóba, törölhetjük, átnevezhetjük vagy ellenőrizhetjük az integritását. Azaz ez egy kényelmes interfész az alacsony szintű tárolóval való kapcsolattartásra.
Streamer: a tárolóhoz való belépési pont
Mit adtunk hozzá az S3 tároló létrehozásához
Tehát áttekintettük a tároló alapvető felépítését, amikor elhatároztuk az S3 tároló bevezetését. A PUT módszer segítségével bármilyen tartalmat elhelyezhettünk ott, és ennek az adatnak a hash-ét kaptuk az azonosítójaként. Ezzel az azonosítóval később visszatérhettünk az eredeti fájlért. De ez nem elegendő az S3 megvalósításához. Az S3 protokollban, az objektumok tárolása mellett, van:
- metaadatok tárolása - az objektumok kiegészítő tulajdonságai;
- az objektumokhoz való hozzáférés szervezése HTTP-n keresztül;
- az objektumok gyűjtése gyűjteményekbe - tárolók;
- HTTP-S3 végpont. Az S3 adatokat meghatározott struktúrákba szervezi - tárolók, amelyek mindegyike tárolási belépési pontot biztosít a fájlok számára.
Ehhez a logikához külön szolgáltatásra volt szükség. Emellett már az elejétől fogva szerettük volna a szolgáltatás architektúráját úgy megtervezni, hogy az lineárisan skálázható legyen.
Első komponensek
S3 API-t megvalósító démon. Ez az Amazon standard S3 API-ja, amely támogatja az XML-t a metadaták kezelésére és közvetlenül lehetővé teszi a tartalom átvitelét. Nem kellett semmit feltalálnunk, minden le van írva és dokumentálva.
A szolgáltatás előtt Nginx-t is telepítettünk. Ezt használtuk az SSL terminálására, a terheléselosztásra, valamint némi logikára Lua nyelven (mérőszámok, naplózás és nyomkövetés).
A S3 metadaták tárolására a Tarantool-t választottuk. Az első verzióban a S3 démon a metadatákért ebbe az adatbázisba ment, a tartalmat pedig egy nagy tárolóban tároltuk a Streamer-en keresztül.
Nginx + S3 API + metadaták
Objektum tárolási modell
Nézzük meg, hogyan működik az S3. A felhasználó létrehozhat egy vödröt - objektumok gyűjteményét. A vödör egy hostnévvel van címezve, és a szolgáltatás aldomainje. A vödör keretein belül a felhasználó objektumokat hozhat létre. Az objektum azonosítója egy URL lesz. Az objektum tartalma egy blob, bináris adatok tömbje, amelyet a tárolóban fogunk tárolni. Az objektumnak emellett vannak attribútumai is: a név - az adott URL, ACL (hozzáférés-vezérlési lista), egyéb kiegészítő vagy önkényes attribútumok - mindezek a metadatákban kerülnek tárolásra.
Ezen adatok normalizált sémája a következőképpen nézhet ki: vannak projektek, amelyek vödröket birtokolnak, azok vödrök pedig objektumokat, és az objektumok összetetté válhatnak. Mivel az objektumokat egyesével is lehet feltölteni, a feltöltéshez két segédtáblázat áll rendelkezésre: uploads és chunks. A projektek emellett hozzáférési adatokat és számlázást is tartalmaznak.
Adat séma
Mivel b2b szolgáltatást készítettünk fizetős hozzáféréssel, ezért ebben a sémában szükség volt a számlázásra is.
A számlázó szolgáltatást szintén Tarantoolon valósítottuk meg.
S3 tároló fejlesztések: lépések a termeléshez
Már létrehoztunk egy működő modellt, amelyet fel lehet használni: az objektumok és metadaták már tárolva voltak, de a termeléshez való átálláshoz még néhány dolog hiányzott.
Először is, a ráta-limitek rendszere. Ha szolgáltatást indítunk nélküle, csúcsidőszakban előre nem látható módon túlterhelhetjük a rendszer egy részét. A ráta-limitnek úgy kell működnie: bármely S3 kérés egy adott hosztra érkezik, ez a hoszt a tároló azonosítója, és a tároló egy bizonyos ügyfélhez tartozik. Meg kell határoznunk egy olyan függvényt a tárolóra, amely lehetővé teszi a ráta-limit kiszámítását.
Ezenkívül a ráta-limitek rendszerének elég teljesítményűnek kell lennie ahhoz, hogy elviselje a S3-ra érkező terhelést.
Itt újra használtuk a Tarantool-t. A ráta-limitek egy 21 példányból álló klaszter, a példányokat csoportokba osztottuk, három fizikai csomópont között elosztva és egy nagy topológiai klaszterbe egyesítve. A konfigurációs változások automatikusan terjednek: beállítjuk a ráta-limiteket, az alapértelmezetteket és a konfigurációt. Minden tárolót szigorúan egy példány kezel. Amikor egy adott tárolóra érkezik kérés, kiszámítjuk, hogy melyik példány felelős az adott tárolóért. Ezen csomópont keretein belül a kérdések aktuális rátáját egy Token Bucket-hoz hasonló algoritmus alapján számítjuk. Ezután a ráta-limitek rendszere, a terhelés és a konkrét tárolóhoz beállított tulajdonságok alapján megmondja, hogy a kérés végrehajtható-e vagy sem. A limitek ellenőrzése a S3 kérés legkorábbi szakaszában történik, védve a rendszer többi elemét a túlzott terheléstől.
Továbbá, terhelés alatt nehéz meglenni a cache nélkül. Az S3-ban többszöri hozzáférést feltételezünk az azonos objektumokhoz, tehát ez egy forró tároló. Normál esetben egyetlen fájl elérése teljes láncot igényel: Streamer, FileDB, PairDB, Storage. De ha többször hívunk meg egy fájlt, akkor helyi cache segítségével optimalizáljuk az elérést.
A cache többrétegű és nginx, helyi, SSD és RAM lemezek segítségével van megvalósítva. Itt nem használtuk a Tarantool-t, mert a fájlrendszerből kényelmesebb a tárgyakat átadni, így lehetőségünk van a cache eltérítésére. Ezen kívül nagy tárgyaink vannak, maximális méretük 32 gigabájt, míg a Tarantool csak kis tárgyakat tud cache-elni.
Ez az első rendszer, amellyel elindultunk, rendelkezett egy kiszámított kapacitással, ami elegendő volt a termék felfedezésére és megértésére, valamint arra, hogy működni fog.
A harci rendszer fejlesztése: failover és skálázás
A rendszer már harcban volt, de a kezdetekkor kihagytunk néhány dolgot - szükség volt a failover és a skálázás hozzáadására.
A S3 démonunk a Tarantool protokollon keresztül gyűjtötte be a metadatákat. Az eredeti adatbázis helyébe Tarantool került, amely proxy routerként működött a metadaták lekérdezéséhez. Az alkalmazás szempontjából, amely az API-t megvalósítja, semmi nem változott - ugyanúgy a Tarantool protokollon keresztül hivatkozott az adatbázisra, de a router biztosítani tudta az aktív failover-t. Tehát ellenőrizhettük a csomópontok elérhetőségét, szüneteltethettük a váltásokat és hibákat, és így tovább. Az alkalmazást közben nem módosítottuk.
További részletek arról, hogyan valósítottuk meg a shardolást
A következő kérdés, amivel foglalkoznunk kellett, a shardolás volt. A rendszer nőtt, a objektek száma nőtt, és biztosítani kellett a további növekedés lehetőségét.
Térjünk vissza az adatmodellhez: vannak projektek, tárolók, kreditek és számlázás. Ezek olyan objektumok, amelyek nagy valószínűséggel a közeljövőben nem nőnek ki egy példány határain kívül sem térfogat, sem lekérdezések szerint. Ezért nem érdemes őket shardolni, és külön példányba helyeztük őket, amely nem shardolt marad. Ez lehetővé teszi a projektek és tárolók következetesebb kezelését, mivel van egy egységes, nem shardolt pont.
A modellben vannak olyan objektumok is, amelyek lineárisan növekednek - először számos százas nagyságrendben voltak, most pedig számuk milliárdokban mérhető. Ezeket az objektumokat és részeiket shardolt klaszterbe kellett helyezni.
A modellt felosztottuk, de az objektumoknak dolgozniuk kell a tárolókkal: az objektum mindig egy adott tárolóhoz tartozik, plusz a tárolón működik az ACL. Tehát minden shardhoz tartozó objektum esetén egy árnyékmásolatot tartunk minden tárolóról. Továbbá, amikor az objektumok módosulnak és lekérdezéseket végeznek, figyelembe kell venni a számlázási mértéket, ezért minden shardon vannak számlálóink a számlázáshoz.
Ezenkívül még néhány táblázatot és komponenst adtunk hozzá:
- kosár, a régi projektek törlésére, amelyek törlődnek vagy felfüggesztésre kerülnek;
- háttérfeladatok sorfa, tehát a fő tárolónak el kell látnia a háttérfeladatokat, amelyeket a klaszteren el kell végezni;
- lifecycle támogatás — egy mechanizmus, amely lehetővé teszi az objektumok kezelését és életciklusuk irányítását.
Mivel az adatok egy részét shardokra vittük, szükség volt egy sharding proxira. Használhattuk volna a routert erre a szerepre, de egy külön sharding proxi, amely kizárólag az adatok shardingjáért felel, lehetővé teszi a router számára, hogy az adatokat teljes egészében lekérdezze, anélkül hogy a shardingra kellene gondolnia.
Külön elmagyarázom, miért nem választottunk kész megoldást, hanem egy egyedi sharding funkciót szerettünk volna létrehozni.
Nézzük meg, hogyan van felépítve. 256 elérhető shardunk van. Minden egyes buckethez egy tartományt rendelünk egy konzisztens funkció segítségével. Ez egyszerű — ahogy a konzisztens funkció segítségével meghatározza, hogy melyik shardhoz tartozik, úgy meghatározza a kezdő shardot és kijelöli a tartományt:
f(bucket, shards) = subset
Tehát, ha az úgynevezett bucketet veszünk, akkor elmondható, hogy ő és adatai mindig egy adott shardok egy konkrét részhalmazán lesznek. Ez lehetővé teszi az egyes bucketek hatásának csökkentését a másikra, és egyszerűsíti a map-reduce lekérdezések működését, amikor például a bucket objektumainak listázására van szükség. Ehhez minden shardot fel kell kérdezni, ahol ezek az objektumok tárolva vannak. Ha az objektumok minden shardon lennének, bármely listázás az egész rendszert érintené, de itt csak egy adott részhalmazt érint.
Továbbá — minden objektum egy adott buckethez tartozik, ezért amikor egy objektumhoz fordulunk, akkor egy bizonyos bucketben kell az objektum nevét megadnunk. Tehát egy funkciót határozhatunk meg az objektum számára nem az összes elérhető shard tartományából, hanem csak az ő bucketének a részhalmazából:
f(object, subset) = shard
Egy adott objektumot veszünk, a funkció argumentumaként nem az összes shardot, hanem az ő bucketének a részhalmazát adjuk meg — és megkapjuk a megfelelő shardot.
Tehát a sharding megvalósult, van sharding proxy. Ezután már csak annyit kell tenni, hogy a routerből és a metadatabázisból a sharding proxyhoz forduljunk. Például árnyék másolatok létrehozásához — amikor egy buckettet hozunk létre, a fő tárolónak el kell készítenie ennek a buckettének a képviselőjét minden shardon, ahol jelen kell lennie.
Hogyan valósítottuk meg a resharding-ot
A legnagyobb probléma a shardelésnél a reshardenelés. Fontos volt számunkra, hogy a rendszer már gyártásban volt, így minimális leállással kellett megoldanunk. Bemutatom, hogyan oldottuk meg a problémát egy hasonló feladat példáján keresztül, adatokat migrálva egy projektből a másikba.
Alább látható a klaszterünk sémája, amely a shardelés bevezetése után készült. Van nginx, S3 API, router, projekt fő adatbázisa, sharding proxy és maguk a shardok.
Fent említettem, hogy a projekt egy bizonyos szakaszában volt egy termékfeladat: "Indítsunk el egy új adattárolót, Icebox-ot, mint a Hotbox, csak hideg adatokhoz". Valójában egy hasonló adattároló, de más URL-en és cache nélküli.
Az Icebox-ot kevesebbet használták, mint a Hotbox-ot, így viszonylag sokáig nem volt szükség arra, hogy shard-olják. Végül úgy döntöttünk, hogy lemondunk róla, és egyesítjük a Hotbox-ot és az Icebox-ot egy szolgáltatásba, úgy, hogy egyszerűen elválasztjuk a tárolási osztályokat.
A tárolókban lévő bucketek nem estek össze, könnyen összevonhatók és áthelyezhetők voltak, de a kliensek mindkét tárolót használták, ezért meg kellett oldani a leállás nélküli átállás problémáját. Nem lehetett egyszerűen lekapcsolni és lemásolni. Több lépésben végeztük el a migrálást.
Először a fő tárolókat szinkronizáltuk. Volt Tarantoolunk, és amikor egy objektumot létrehoztunk, ezt így tehettük:
- a kérés érkezik a bucket létrehozására, például a Hotbox-ban;
- a Tarantool ellenőrzi egy másik adatbázisban (ebben az esetben az Icebox-ban), hogy létezik-e ilyen bucket;
- ha a bucket létezik, az adatbázis azt mondja, hogy nem lehet létrehozni, és az létezőként van szinkronizálva.

Bucketek szinkronizálása
Abban a tárolóban, amelyik minden adatot fogadott, a projektek és a bucketek számára bevezettünk egy jelzőt, amely megmutatta, hol tárolódik az objektum. Ez helyben, tehát a Hotbox-ban, az Icebox-ban is tárolható volt — ekkor az új tárolóban nem léteznek adatok, vagy migrációs állapotban lehetett.
Ha a projekthez vagy buckethez a Migrating jelző volt beállítva, a migráció során a kérés először az új tárolóra irányult, amelyben az adatoknak lenniük kellett, és ha ott nem voltak, a kéréseket alternatív tárolóra irányították.
Ezután átkapcsoltuk a forgalmat. Mivel az API képes volt kezelni az Icebox és a Hotbox kéréseit is, leállás nélkül tudtuk átirányítani a forgalmat, egyszerűen áthelyezve a hosztokat és hozzáadva a megfelelő bejegyzéseket az Nginx-ben.
Miután a forgalmat átirányították, az Nginx és az Icebox API eltávolítható volt.
Ezután eltávolítottuk az Icebox nginx-t és az S3 API-t – és minden működött:
Ezt követően elindítottunk egy háttérsorozatot, amely a bázison belül működött – elemről elemre átfogta az összes projektet és azok tárolóit, beállította számukra a Migrating jelzőt, átvitte az adatokat, és az átvitel befejezése után a Local jelzőt állította be.
Az adatátvitel után már nincs szükségünk a régi tárolóra, így eltávolítjuk a régi rendszer fennmaradó részeit, és megszüntetjük a migrációs státuszkód támogatását a kódból.
Ugyanezekkel az elvekkel hajtottuk végre a régi tárolóból a shardolt tárolásra való átkonfigurálást:
- Minden tárolót megjelöltünk, mint
Nem shardolt. Minden hozzájuk irányuló kérés az eredeti, nem shardolt tárolóhoz ment. - Az új tárolók azonnal Sharded státuszban jöttek létre.
Egyesével átvettük a tárolókat, beállítottuk a Migrating státuszt. - és átvittük az adatokat.
Kérdéseket az alábbi elv szerint szolgáltunk ki:Olvasunk az újból, majd a régiből.
Csak az újból készítünk.
- Kétfázisúan frissítjük: ha az újból nincs, az öregből átvisszük az újból, majd frissítjük.
- SSL-tanúsítványok kezelése
- A frontendben Nginx-et használunk. Esetünkben ez nem a szokásos Nginx, hanem OpenResty, LuaJIT támogatású Nginx.
A rendszer egy másik része az SSL tanúsítványok kezelése. Az S3 tárolóban saját domént állíthat be a konkrét tárolóhoz való hozzáféréshez, egyszerűen segítségével
. De manapság HTTPS nélkül nem lehet: a saját domain saját SSL-tanúsítványt feltételez.
Mint már említettem, a terheléselosztásért és az SSL-terhelésesítésért az Nginx felel. Esetünkben ez nem a szokásos Nginx, hanem OpenResty, LuaJIT támogatású Nginx. CNAMEEz lehetővé tette számunkra, hogy viszonylag egyszerűen megtanítsuk az Nginx-et, hogy tetszőleges tanúsítványokat adjon át. Ráadásul a tanúsítványokat dinamikusan kellett biztosítanunk (anélkül, hogy a konfigurációs fájlba írnánk őket). Felhasználtuk a
ssl_certificate_by_lua
kiterjesztést, amely lehetővé teszi, hogy a tanúsítványt tetszőleges forrásból olvassuk be közvetlenül a TLS-hálnyék során. A tanúsítványok tárolására a Tarantool-t is használtuk: ez lehetővé teszi a tanúsítványok külső kezelését, és rendkívül gyors kiszolgálást biztosít. Egy külön démon is megvalósításra került, amelynek feladata a Let’s Encrypt által kibocsátott tanúsítványok rendszeres frissítése., amely lehetővé teszi a tanúsítvány olvasását egy tetszőleges forrásból közvetlenül a TLS-handsake során. Tanúsítványtárolóként a Tarantool-t is választottuk: ez lehetővé teszi a tanúsítványok külső kezelését és rendkívül gyors visszatérést biztosít.
Egy külön daemont is megvalósítottunk, amelynek feladata a Let’s Encrypt segítségével kiadott tanúsítványok rendszeres frissítése.
Mit mivel kezdeném az új tároló fejlesztését, és mit csinálnék másképp?
Mit kellett volna használni az elejétől fogva?
Shardelés azonnal. Elég sok problémát okozott a reshardo. Könnyű megvalósítani, de ha olyan projekteket kezdesz, amelyeket skálázni kell, jobb azonnal egy sharded klaszert választani, még ha minimális csomópontokkal is. A sharding bevezetése a kezdeti szakaszban szinte ingyenes a munkamenetbe való bevezetéshez képest.
Munka Tarantool-lal load balancerek révén. Most már minden új adatbázist közvetlenül load balanceren keresztül csatlakoztatunk. Ez lehetővé teszi a funkcionalitás bővítését és a magasabb hibatűrés elérését.
Auto failover. Minden olyan eszközt telepítettem volna, ami az auto failoverhez szükséges, mivel a kezdeti kudarcok a hiánya miatt következtek be. Az S3 tapasztalata után a következő termékeket ennek figyelembevételével indítottuk el.
S3 funkció «Verziózás». Eleinte nem tűnt a legkeresettebb funkciónak. Az ilyen lehetőség beépítése egy működő rendszer architektúrájába rendkívül nehéz.
Külön billing. Ahogyan beépítettük a billinget a rendszeren, az kezdetben jól működött, de később zavaróvá vált, jobb lett volna, ha teljesen külön szolgáltatásként üzemel.
Mi volt a jó döntés
Adatmodell. A történet azt mutatta, hogy a szolgáltatás fejlődésével meglehetősen pontosan egybeesünk az Amazon adatmodellel, ezért meg tudjuk valósítani azokat a funkciókat, amelyek ott megtalálhatók.
Shardolási séma. Támogatnám a hasonló tartomány alapú shardolásokat a buckettek között, mivel ez lehetővé teszi a kérések jó elosztását különböző buckettektől egy nagy klaszterben.
Tarantool használata. A Tarantool nagymértékben segített a szolgáltatás fejlesztésében és módosításában, könnyen dolgoztunk az adatokkal, átalakítottuk és shardoltuk a tárolót, anélkül, hogy az alkalmazás szintjére kellett volna lépnünk.
Ez a beszéd először hangzott el by Mail.ru Cloud Solutions&Tarantool. Tekintse meg más előadásokat, és iratkozz fel az események értesítéseire a Telegramon .
Ön is megnézheti a régi előadásomat az S3-ról, vagy olvashatja kollégám cikkét a blokktárolóról.
- .
- .
Forrás: habr.com
