

Helló, én vagyok Szergej Jelancev, és fejlesztést végzek a Yandex Felhőben. Korábban az Yandex portál L7-terheléselosztójának fejlesztését irányítottam — a kollégák viccelődnek, hogy bármit csinálok, az mindig terheléselosztó. Elmondom a Habr olvasóinak, hogyan kell kezelni a terhelést a felhőplatformon, milyen ideális eszközt látunk ennek elérésére, és hogyan haladunk ennek az eszköznek a kiépítése felé.
Először néhány kifejezést ismertetünk:
- VIP (Virtual IP) — a terheléselosztó IP-címe
- Szerver, backend, instance — virtuális gép, amelyen alkalmazás fut
- RIP (Real IP) — a szerver IP-címe
- Healthcheck — a szerver készenlétének ellenőrzése
- Szolgáltatási zóna, Availability Zone, AZ — izolált infrastruktúra az adatközpontban
- Régió — különböző AZ-k összessége
A terheléselosztók három fő feladatot látnak el: végzik magát a terheléselosztást, javítják a szolgáltatás megbízhatóságát, és leegyszerűsítik annak skálázását. A megbízhatóságot az automatikus forgalomkezelés biztosítja: a terheléselosztó figyelemmel kíséri az alkalmazás állapotát, és kizárja a terheléselosztásból azokat az instance-okat, amelyek nem teljesítették a élhetőségi tesztet. A skálázás biztosítása az instance-ok terhelésének egyenletes elosztásával és az instance-ok listájának élő frissítésével történik. Ha a terheléselosztás nem elég egyenletes, akkor egyes instance-ok olyan terhelést kapnak, ami meghaladja a működési határértéküket, így a szolgáltatás megbízhatósága csökken.
A terheléselosztókat gyakran az OSI modell protokoll szintje alapján osztályozzák, amelyen működik. A Felhő terheléselosztója a TCP szinten működik, ami a negyedik szintnek, az L4-nek felel meg.
Térjünk rá a Felhő terheléselosztó architektúrájának áttekintésére. Fokozatosan növeljük a részletesség szintjét. A terheléselosztó komponenseit három osztályra osztjuk. A config plane osztály felel a felhasználóval való interakcióért, és tartalmazza a rendszer célállapotát. A Control plane tartalmazza a rendszer aktuális állapotát, és irányítja a data plane osztályba tartozó rendszereket, amelyek közvetlenül felelősek a forgalom ügyfelektől a te instance-aidhoz való szállításáért.
Data plane
A forgalom drága eszközökre, úgynevezett border routerekre kerül. Az elérhetőség növelése érdekében egy adatközpontban egyszerre több ilyen eszköz is működik. Ezt követően a forgalom terheléselosztókra jut, amelyek az ügyfelek számára anyacím IP-címet hirdetnek meg minden AZ-n keresztül BGP-n.
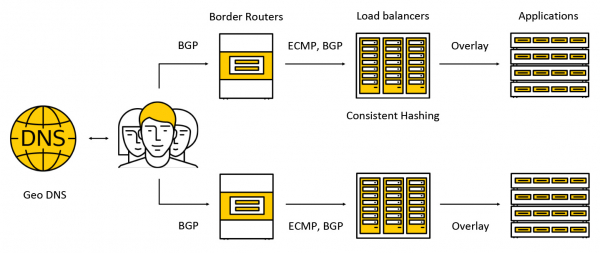
A forgalom ECMP-n keresztül halad - ez egy útvonalválasztási stratégia, amely szerint több azonos szintű jó útvonal létezhet a célhoz (a mi esetünkben a cél egy destination IP-cím), és a csomagok bármelyiken elküldhetők. Szintén támogatjuk a több elérési zónában való működést a következő séma szerint: megegyezett cím hirdetése minden zónában, a forgalom a legközelebbi zónába kerül, és azon már nem jut túl. A következő bejegyzésben részletesebben megvizsgáljuk, mi történik a forgalommal.
Config plane
A config plane kulcsfontosságú komponense az API, amelyen keresztül az alapvető műveletek végrehajtása zajlik a terheléselosztókkal: például instanciák létrehozása, törlése, összetételének módosítása, és az egészségügyi ellenőrzések eredményeinek lekérése stb. Egyrészt ez REST API, másrészt a felhőben gyakran használunk gRPC keretrendszert, ezért a REST-t gRPC-re "fordítjuk", majd kizárólag gRPC-t használunk. Bármely kérés egy aszinkron idempotens feladatok sorozatának létrehozását idézi elő, amelyek a Yandex.Cloud közös munkavégző csoportján futnak. A feladatokat úgy írják, hogy bármikor felfüggeszthetők, majd újraindíthatók legyenek. Ez méretezhetőséget, ismételhetőséget és az operációk naplózását biztosítja.
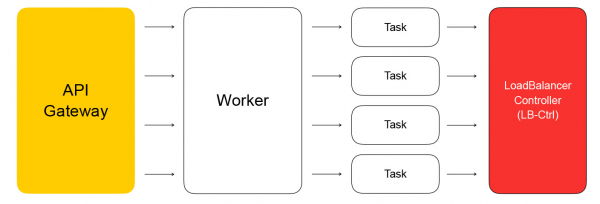
Ennek eredményeként az API-ból indított feladat hívást küld a terheléselosztók szolgáltatáskontrolleréhez, amely Go nyelven íródott. Ez képes terheléselosztókat hozzáadni és eltávolítani, a háttérszolgáltatások összetételét módosítani és beállításokat változtatni.
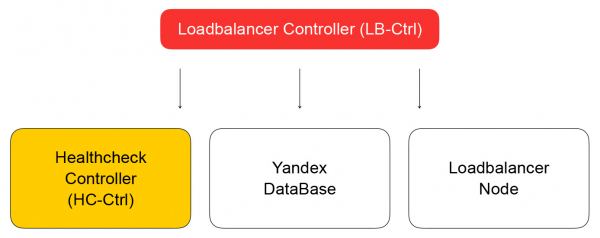
A szolgáltatás az állapotát Yandex Database-ben tárolja - egy elosztott, menedzselt adatbázisban, amelyet hamarosan Ön is használni fog. A Yandex.Cloudban, ahogy már említettük, , a dog food koncepció működik: ha mi magunk is használjuk a szolgáltatásainkat, akkor az ügyfeleink is örömmel fognak velük élni. A Yandex Database ennek a koncepciónak a példája. Mi az összes adatunkat YDB-ben tároljuk, és nem kell foglalkoznunk az adatbázis karbantartásával és méretezésével: ezeket a problémákat helyettünk oldják meg, mi az adatbázist szolgáltatásként használjuk.
Visszatérünk a terheléselosztó vezérlőhöz. Feladata, hogy megőrizze a terheléselosztóval kapcsolatos információkat, és átadja a virtuális gép ellenőrzési feladatát a healthcheck vezérlőnek.
Healthcheck vezérlő
Ez fogadja a szabályok módosítására vonatkozó kéréseket, elmenti azokat az YDB-ben, kiosztja a feladatokat a healthcheck node-ok között, és aggregálja az eredményeket, amelyeket aztán elment a adatbázisba, és elküldi a terheléselosztó vezérlőnek. Ez pedig kérdést küld a klaszter összetételének módosítására a data plane-be a loadbalancer-node felé, amelyről alább fogok beszélni.
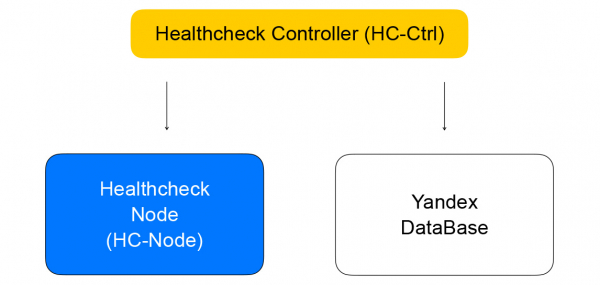
Beszéljünk részletesebben a healthcheckekről. Ezeket több osztályba lehet sorolni. Az ellenőrzéseknek különböző sikerességi kritériumaik vannak. A TCP-ellenőrzéseknek sikeresen kell létrehozniuk a kapcsolatot egy adott időn belül. A HTTP-ellenőrzések sikeres kapcsolatot és egy 200-as státuszkódú válasz megérkezését követelik meg.
Ezen kívül az ellenőrzések eltérnek a tevékenység osztálya szerint is – lehetnek aktívak és passzívak. A passzív ellenőrzések egyszerűen figyelik a forgalmat anélkül, hogy bármilyen speciális intézkedést tennének. Ez nem működik jól az L4 szintjén, mivel függ a magasabb szintű protokollok logikájától: az L4-en nincs információ arról, hogy mennyi időt vett igénybe a művelet, és hogy a kapcsolat lezárása jó vagy rossz volt-e. Az aktív ellenőrzések megkövetelik, hogy a terheléselosztó kéréseket küldjön a szerver minden példányához.
A terheléselosztók nagy része önállóan végzi a "közvetlenségi" ellenőrzéseket. Mi a Felhőben úgy döntöttünk, hogy a rendszer részeit szétválasztjuk a skálázhatóság javítása érdekében. Ez a megközelítés lehetővé teszi számunkra, hogy növeljük a terheléselosztók számát, miközben fenntartjuk a szolgáltatás felé irányuló healthcheck kérések mennyiségét. Az ellenőrzések külön egészségügyi node-okon történnek, amelyekre az ellenőrzési célok shardolva és replikálva vannak. Nem lehet ellenőrzéseket végezni egy hostról, mivel az meghibásodhat. Így nem kapjuk meg az általa ellenőrzött példányok állapotát. Legalább három healthcheck node-ról végezzük az ellenőrzéseket bármelyik példány esetén. Az ellenőrzési célokat a node-ok között a konzisztens hashelés algoritmusai segítségével osztjuk meg.
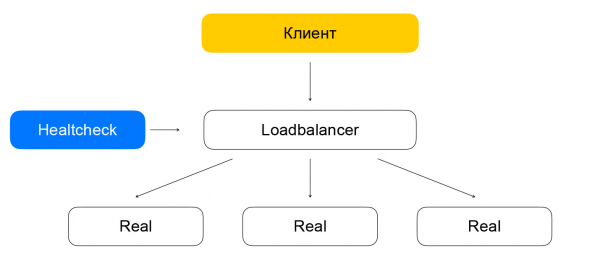
A terhelésmegosztás és a healthcheck elkülönítése problémákhoz vezethet. Ha a healthcheck node közvetlenül az instance-hoz küld kéréseket, megkerülve a jelenleg forgalmat nem kezelő terheléselosztót, furcsa helyzet áll elő: az erőforrás látszólag él, de a forgalom nem érkezik meg hozzá. Ezt a problémát úgy oldjuk meg, hogy a healthcheck forgalmat garantáltan az elosztókon keresztül irányítjuk. Más szavakkal, a kliensforgalom és a healthcheck-ek közötti csomagmozgatási séma minimálisan tér el: mindkét esetben a csomagok a terheléselosztókhoz jutnak, amelyek eljuttatják azokat a célzott erőforrásokhoz.
A különbség abban rejlik, hogy a kliensek a VIP-re irányítanak kéréseket, míg a healthcheck-ek minden egyes RIP-hez fordulnak. Itt érdekes probléma merül fel: felhasználóink számára lehetőséget biztosítunk, hogy szürke IP-hálózatokban hozzanak létre erőforrásokat. Tegyük fel, hogy két különböző felhőszolgáltató van, akik a terheléselosztóik mögé rejtették a szolgáltatásaikat. Mindkettőjüknek vannak erőforrásaik a 10.0.0.1/24 alhálózatban, azonos IP-címekkel. Valahogy meg kell tudnunk különböztetni őket, és ehhez el kell merülnünk a Yandex Cloud virtuális hálózatának működésében. A részleteket érdemes megnézni a , jelenleg számunkra fontos, hogy a hálózat többrétegű, és van benne olyan alagút, amelyeket az alhálózat azonosítója alapján lehet megkülönböztetni.
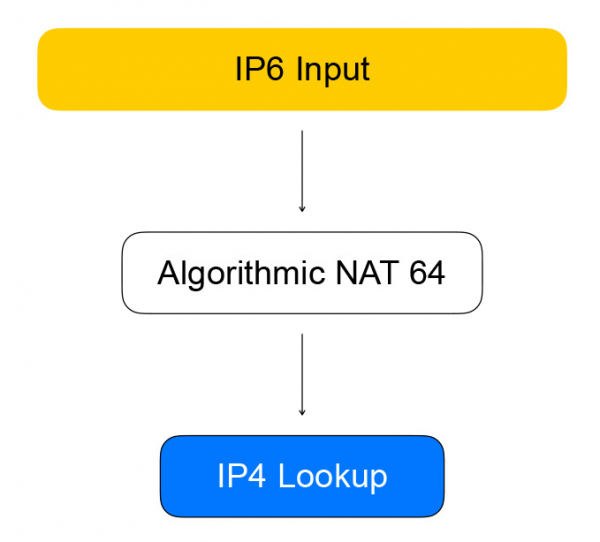
A healthcheck node-ok a terheléselosztókhoz úgynevezett kvázi-IPv6-címeken keresztül fordulnak. A kvázi-cím egy IPv6-cím, amelyben be van rejtve egy IPv4-cím és a felhasználó alhálózatának azonosítója. A forgalom a terheléselosztóra érkezik, amely kinyeri belőle az erőforrás IPv4-címét, lecseréli az IPv6-ot IPv4-re, majd a csomagot továbbítja a felhasználó hálózatába.
A visszafelé irányuló forgalom ugyanígy halad: a terheléselosztó észleli, hogy a célzás - egy szürke hálózat a healthcheck-ek számára - és átalakítja az IPv4-et IPv6-ra.
A VPP a data plane szíve.
A terheléselosztó a Vector Packet Processing (VPP) technológia alapján készült - a Cisco keretrendszere a hálózati forgalom csomagkezelésére. A mi esetünkben a keretrendszer a hálózati eszközök user-space-menedzsment könyvtára, a Data Plane Development Kit (DPDK) fölött működik. Ez magas csomagfeldolgozási teljesítményt biztosít: a kernelben sokkal kevesebb megszakítás történik, és nincs kontextusváltás kernel space és user space között.
A VPP még tovább megy, és még több teljesítményt hoz ki a rendszerből azáltal, hogy a csomagokat kötegekbe egyesíti. A teljesítménynövelés a modern processzorok agresszív cache-használatának köszönhető. Használják mind az adatok cache-ét (a csomagok "vektorokban" vannak feldolgozva, az adatok közel helyezkednek el egymáshoz), mind az utasítások cache-ét: a VPP-ben a csomagok feldolgozása gráf szerint történik, ahol a csomópontokban olyan funkciók találhatók, amelyek egy adott feladatot látnak el.
Például az IP-csomagok feldolgozása a VPP-ben a következő sorrendben zajlik: először a csomópontban történik a csomagok fejlécének elemzése, majd ezeket egy olyan csomópontba küldik, amely a csomagokat a routing táblák szerint továbbítja.
Egy kis hardcore. A VPP szerzői nem hajlandók kompromisszumot kötni a processzor cache-építésének használatában, ezért a tipikus feldolgozási kód kézi vektorizálást tartalmaz: van egy feldolgozási ciklus, amelyben a "négy csomag a sorban" helyzetet dolgozzák fel, majd ugyanaz a folyamat két, végül egy csomag esetén. Gyakran használnak prefetch utasításokat, amelyek az adatok cache-be töltésére szolgálnak, gyorsítva ezzel a következő iterációkhoz való hozzáférést.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // több csomag egyidejű feldolgozása
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Prefetch a következő iterációhoz. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // tényleges adatok feldolgozása
        /* ellenőrizze a spekulatív beillesztéseket, talán váltson ki a jelenlegi következő keretre */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // csomagok feldolgozása egyesével
    }

    // feldolgozott köteg
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Tehát a Healthchecks IPv6-on keresztül érkezik a VPP-hez, amelyekből IPv4-et generál. Ezt a gráf egy csomópontja végzi, amelyet algoritmikus NAT-nak nevezünk. A visszafelé irányuló forgalom (és az IPv6-ról IPv4-re való átalakítás) számára ugyanaz a csomópont felel az algoritmikus NAT-nál.
A terheléselosztó klienseitől érkező közvetlen forgalom a gráf csomópontjain keresztül halad, amelyek magát a terheléselosztást végzik.
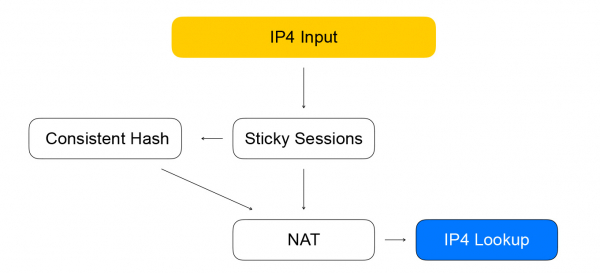
Az első csomópont — sticky sessions. Ebben tárolják a hash-t a telepített munkamenetekhez. Az 5-tuple magában foglalja a kliens címét és portját, ahonnan az információt továbbítják, a források címét és portját, amelyek elérhetők a forgalom fogadására, valamint a hálózati protokollt.
Az 5-tuple hash segít kevesebb számítást végezni a következő konzisztens hash-elési csomópontban, és jobban kezelni a források listájának változását a terheléselosztó mögött. Amikor a terheléselosztóhoz egy csomag érkezik, amelyhez nincs munkamenet, a konzisztens hashelési csomópontba küldik. Itt történik a terheléselosztás a konzisztens hashing segítségével: kiválasztunk egy forrást az elérhető „életképes” források listájából. Ezt követően a csomagok egy NAT csomópontba kerülnek, amely végrehajtja a célcím tényleges cseréjét és a checksumok újraszámítását. Mint láthatja, követjük a VPP szabályait — hasonlót a hasonlóhoz, csoportosítjuk a hasonló számításokat a processzor-cache-ek hatékonyságának növelése érdekében.
Konzisztens hashing
Miért választottuk ezt, és mi is ez pontosan? Kezdjük azzal a korábbi feladattal, hogy forrást választunk a listából.
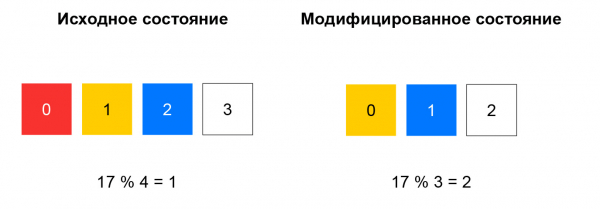
Inkonzisztens hashing esetén a bejövő csomagról számítják a hash-t, és a forrást a listából választják a hash osztásának maradéka szerint az erőforrások számával. Amíg a lista változatlan marad, ez a séma jól működik: mindig azonos 5-tuple-val rendelkező csomagokat küldünk ugyanarra az instanciára. Ha azonban például egy forrás nem válaszol a healthcheck-ekre, akkor a hash-ek jelentős része megváltozik. Az ügyfél TCP-kapcsolatai megszakadnak: a csomag, amely korábban az A instanciára érkezett, most a B instanciára kezd el érkezni, amely nem ismeri a munkamenetet az ilyen csomagok esetében.
A konzisztens hashing megoldja a fent említett problémát. A legegyszerűbben így magyarázható ez a koncepció: képzeljük el, hogy van egy gyűrű, amelyen a forrásokat a hash alapján (például IP:port szerint) osztjuk el. A forrás kiválasztása — ez a kerék elfordítása egy szög szerint, amelyet a csomagról számított hash határoz meg.
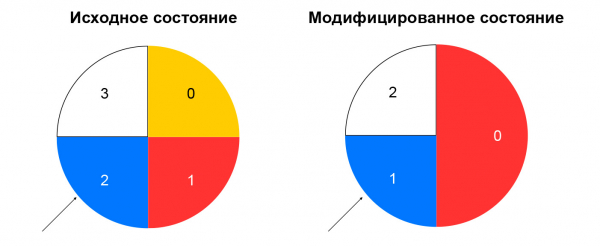
Ezzel minimalizáljuk a forgalom újraelosztását a források összetételének megváltozása esetén. Egy forrás eltávolítása csak azt a részt érinti a konzisztens hashing gyűrűből, ahol az adott forrás található. Egy forrás hozzáadása szintén megváltoztatja a felosztást, de van egy sticky sessions csomópontunk, amely lehetővé teszi, hogy a már létrejött munkamenetek ne változzanak új forrásokra.
Megvizsgáltuk, mi történik a közvetlen forgalommal a terheléselosztó és az erőforrások között. Most nézzük meg a visszafelé irányuló forgalmat. Ez ugyanazon a séma mentén halad, mint a healthcheck forgalom — algoritmikus NAT-on keresztül, tehát a kliensek forgalma az 44-es NAT-on, míg a healthcheck forgalom a 46-os NAT-on keresztül áramlik. Mi követjük a saját sémánkat: egységesítjük a healthcheck forgalmat és a felhasználói forgalmat.
Loadbalancer-node és elemek együttesen
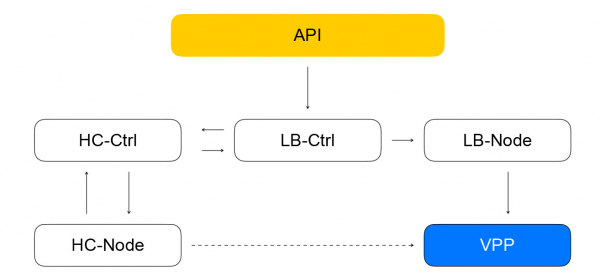
A loadbalancer-node tájékoztat a terheléselosztókról és erőforrásokról a VPP-ben. Ez feliratkozik a loadbalancer-controller eseményeire, képes felépíteni a VPP aktuális állapotának és a vezérlőtől kapott célt állapotának eltérését. Egy zárt rendszert kapunk: az API-ból érkező események eljutnak a terheléselosztó vezérlőhöz, amely feladatokat ad a healthcheck-vezérlőnek az erőforrások „életképességének” ellenőrzésére. Ez utóbbi a healthcheck-node-nak ad feladatokat és összesíti az eredményeket, majd visszaadja azokat a terheléselosztó vezérlőnek. A loadbalancer-node feliratkozik a vezérlő eseményeire és módosítja a VPP állapotát. Ebben a rendszerben minden szolgáltatás csak a szükséges információkat ismeri a szomszédos szolgáltatásokról. A kapcsolatok száma korlátozott, és lehetőségünk van függetlenül üzemeltetni és méretezni a különböző szegmenseket.
Milyen kérdéseket sikerült elkerülni
Minden szolgáltatásunk a control plane-ben Go nyelven készült, és jó méretezési és megbízhatósági jellemzőkkel bír. A Go-ban sok nyílt forráskódú könyvtár található a elosztott rendszerek létrehozásához. Aktívan használjuk a GRPC-t, minden komponens tartalmazza a nyílt forráskódú szolgáltatás-felfedezési megoldást — szolgáltatásaink figyelik egymás működőképességét, dinamikusan változtathatják a szerkezetüket, és ezt GRPC terheléselosztással egyesítettük. A metrikákhoz szintén nyílt forráskódú megoldást használunk. A data plane-ben megfelelő teljesítményeket értünk el és nagy erőforrástartalékunk van: nagyon nehéz volt összerakni egy olyan standot, amely képes volt elérni a VPP teljesítményét, nem pedig a hálózati kártyáét.
Problémák és megoldások
Mi nem működött túl jól? A Go memória kezelése automatikus, mégis előfordulnak memória szivárgások. A legjobb módja a kezelésüknek, ha gorutinákat indítunk és nem feledkezünk meg a lezárásukról. Következtetés: figyeljük meg a Go programok memóriahasználatát. Gyakran jó indikátor a gorutinák száma. Van egy előnye ennek a történetnek: a Go-ban könnyen megkaphatók az adatok a futási idő alapján — memóriakereslet, a futó gorutinák száma és sok más paraméter alapján.
Ezen kívül, a Go talán nem a legjobb választás funkcionális tesztekhez. Ezek meglehetősen terjengősek, és a szabványos 'futtassunk mindent CI-ben egy kötegben' megközelítés nem sokat ér. Az a helyzet, hogy a funkcionális tesztek sokkal nagyobb erőforrás-igényűek, tényleges időkorlátokat okoznak. Ennek következtében a tesztek sikertelenül záródhatnak, mert a CPU foglalt volt az egységtesztekkel. Következtetés: lehetőség szerint végezze a 'nehezen' futtatható teszteket külön az egységtesztektől.
A mikroservizes esemény-alapú architektúra bonyolultabb, mint a monolit: a naplókat több tucat különböző gépen átnézni nem túl kényelmes. Következtetés: ha mikroservizekkel dolgozik, előre gondoljon a nyomkövetésre.
A terveink
Belső terheléselosztót indítunk, IPv6 terheléselosztót állítunk üzembe, támogatni fogjuk a Kubernetes szkripteket, folytatni fogjuk szolgáltatásaink sharding-ját (jelenleg csak a healthcheck-node és a healthcheck-ctrl sharding), új healthcheck-eket adunk hozzá és megvalósítjuk az intelligens ellenőrzések agregálását. Fontolgatjuk, hogy még függetlenebbé tegyük szolgáltatásainkat — hogy ne közvetlenül kapcsolódjanak egymáshoz, hanem üzenetsoron keresztül. Nemrég megjelent az SQS-kompatibilis szolgáltatás a felhőben .
Nemrégiben nyilvános megjelenést tartott a Yandex Terheléselosztó. Ismerkedjen meg , kezelje a terheléselosztókat az ön számára kényelmes módon, és növelje projektjei hibamentességét!
Forrás: habr.com
