

A leírtam a hálózati automatizálás keretrendszerét. A visszajelzések alapján néhány embernél már ez az első megközelítés is tisztázta a kérdéseket. Ez nagyon örömmel tölt el, mert célunk a ciklusban nem az, hogy Python szkriptekkel ragadjuk meg az Ansible-t, hanem hogy rendszert építsünk.
Ez a keretrendszer határozza meg a sorrendet, ahogy a kérdéshez hozzáállunk.
A hálózatvirtualizáció, amelynek ez a szám szentelt, nem illeszkedik különösebben az ADSM tematikájába, ahol az automatizálást vizsgáljuk.
De nézzük meg egy másik szögből.
Már régóta egy hálózatot használnak sok szolgáltatás. A távközlési szolgáltatók esetében ez 2G, 3G, LTE, szélessávú internet és B2B például. Az adatközpontok esetében: kapcsolódás különböző ügyfelek számára, internet, blokk tárolás, objektum tárolás.
Minden szolgáltatás megköveteli, hogy elszigetelődjenek egymástól. Így alakultak ki az átfedési hálózatok.
Minden szolgáltatás nem akar várni arra, hogy az ember kézzel állítsa be őket. Így jöttek létre az orkestrátorok és az SDN.
A rendszeres hálózati automatizálás első megközelítése, pontosabban annak egy része, már régóta megtörtént, és sok helyen megvalósult: VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
Ma ezzel foglalkozunk.
Tartalom
- Okok
- Terminológia
- Underlay — fizikai hálózat
- Overlay — virtuális hálózat
- Overlay a ToR-on
- Overlay a gazdagépen
- A Tungsten Fabric példáján
- Kommunikáció egyetlen fizikai gépen belül
- Kommunikáció különböző fizikai gépeken elhelyezett VM-ek között
- Kimenet a külvilág felé
- GYIK
- Zárás
- Hasznos linkek
Okok
Mivel már szóba került, érdemes megemlíteni a hálózati virtualizálás előzményeit. Valójában ez a folyamat nem tegnap kezdődött.
Valószínűleg nem egyszer hallották, hogy a hálózat mindig is a leginertálóbb része volt bármely rendszernek. Ez minden értelemben igaz. A hálózat az alap, amire minden támaszkodik, és a rajta végzett változtatások meglehetősen nehezek — a szolgáltatások nem bírják el a hálózat leállását. Gyakran egy csomópont leállítása a legtöbb alkalmazást összeomlasztja, és sok ügyfélre hatással van. Részben ezért a hálózati csapat ellenállhat bármilyen változtatásnak — mert most valahogy működik (lehet, hogy még azt sem tudjuk, hogyan), és most valami újat kell beállítani, és nem tudni, hogyan hat ez a hálózatra.
Annak érdekében, hogy ne kelljen várni, amíg a hálózati szakemberek beállítják a VLAN-t, és hogy ne kelljen minden node-on külön-külön beállítani a szolgáltatásokat, az emberek kitalálták a túlhajtott hálózatok használatát — amelyből számos változat létezik: GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE stb.
Vonzalmuk két egyszerű dologban rejlik:
- Csak a végpontokat kell konfigurálni — a tranzit hálózatokat nem kell érinteni. Ez jelentősen felgyorsítja a folyamatot, sőt néha teljesen ki is zárja a hálózati infrastruktúra részlegét az új szolgáltatások bevezetéséből.
- A terhelés mélyen a fejlécben rejtőzik — a tranzit node-knak nem kell tudnia róla, a hosztokon lévő címzésről, a túlhajtott hálózat útvonalairól. Ez azt jelenti, hogy kevesebb információt kell tárolni a táblázatokban, így olcsóbb és egyszerűbb eszközök választhatók.
Ebben a nem teljesen átfogó kiadásban nem tervezem az összes lehetséges technológia részletes elemzését, inkább egy keretet írok le a túlhajtott hálózatok működéséről az adatközpontban.
Az egész sor azt az adatközpontot fogja leírni, amely azonos típusú állványok sorozatából áll, amelyekben azonos szerverhardver található.
Ezen a hardveren virtuális gépek/konténerek/serverless futnak, amelyek szolgáltatásokat valósítanak meg.
Terminológia
A ciklusban szerverrel azt a programot fogom nevezni, amely a kliens-szerver kommunikációs oldalát valósítja meg.
A fizikai gépeket az állványokban szervereknek fogjuk hívni. nem Így is hívni fogjuk.
A fizikai gép — x86 számítógép, amely az állványban található. A leggyakrabban használt kifejezés host. Így fogjuk hívni "gép" vagy host.
Hypervisor — egy alkalmazás, amelyet a fizikai gépen futtatnak, és amely a virtuális gépek futtatásához szükséges fizikai erőforrásokat modellez.
Virtuális gép — az operációs rendszer, amely a fizikai gépen a hypervisor fölött fut. Számunkra a ciklus keretein belül nem olyan fontos, hogy valóban virtuális gép vagy csak konténer-ről van szó. Ezt úgy fogjuk hívni, hogy "VM«
Bérlő — széles értelemben véve, amelyet ebben a cikkben egy külön szolgáltatásként vagy külön kliensként határozok meg.
Többbérletűség vagy többbérlet — ugyanannak az alkalmazásnak a különböző kliens/szolgáltatások általi használata. Ezen túl a kliensek egymás közötti izolációját az alkalmazás architektúrája biztosítja, nem különálló példányok révén.
ToR — Top of the Rack switch — a switch installed in the rack to which all physical machines are connected.
In addition to the ToR topology, different providers practice End of Row (EoR) or Middle of Row (although the latter is a rarely used derogatory term, and I have not encountered the abbreviation MoR).
Alap hálózat — vagy aláfekvő hálózat — fizikai hálózati infrastruktúra: switchek, routerek, kábelek.
Fölérendeltségi hálózat — vagy felsőbb rendű hálózat — egy virtuális alagúthálózat, amely a fizikai hálózat felett működik.
L3-gyár vagy IP-gyár — az emberi találmány lenyűgöző példája, amely lehetővé teszi, hogy a beszélgetések során ne ismételjük meg az STP-t és ne tanuljuk meg a TRILL-t. Olyan koncepció, ahol az egész hálózat egészen a hozzáférési szintig kizárólag L3, VLAN nélküli, így hatalmas lebegő multicast domain-ek nélkül. A „gyár” szó eredetét a következő részben találjuk meg.
SDN — Software Defined Network. Aligha igényel bemutatást. Az a megközelítés a hálózat kezelésében, amikor a hálózaton végrehajtott változtatásokat nem ember, hanem program végzi. Általában a Control Plane-t a végső hálózati eszközök határain túlra helyezi.
NFV — Network Function Virtualization — a hálózati eszközök virtualizálása, amely feltételezi, hogy a hálózat bizonyos funkciói virtuális gépek vagy konténerek formájában futtathatók az új szolgáltatások gyorsabb bevezetése, a Service Chaining megszervezése és a könnyebb horizontális skálázás érdekében.
VNF — Virtual Network Function. Konkrét virtuális eszköz: router, switch, tűzfal, NAT, IPS/IDS stb.
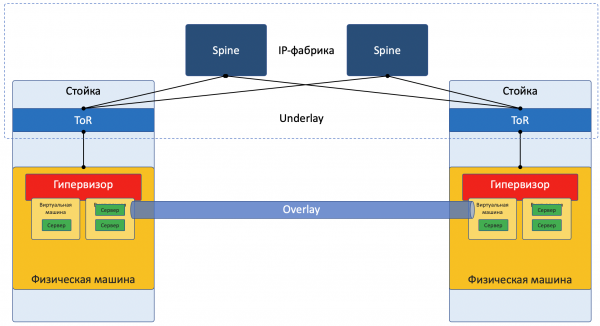
Jelenleg szándékosan leegyszerűsítem a leírást a konkrét megvalósításra, hogy ne zavarjam meg túlságosan az olvasót. A gondosabb olvasás érdekében a szekcióra utalok. Ezen kívül, Roma Gorge, aki kritizálta ezt a cikket a pontatlanságok miatt, ígérte, hogy külön kiadást ír a szerver- és hálózatvirtualizálási technológiákról, amely részletesebb és alaposabban megvizsgálja a részleteket.
A legtöbb hálózat ma nyilvánvalóan két részre bontható:
Alap — egy stabil konfigurációjú fizikai hálózat.
Fölérendeltség — az alap fölötti absztrakció a bérlők elszigetelésére.
Ez igaz mind a DCM (amelyet ebben a cikkben tárgyalunk), mind az ISP esetében (amelyet nem vizsgálunk, mert már korábban tárgyaltuk a ). Az üzleti hálózatok esetében természetesen a helyzet némileg más.
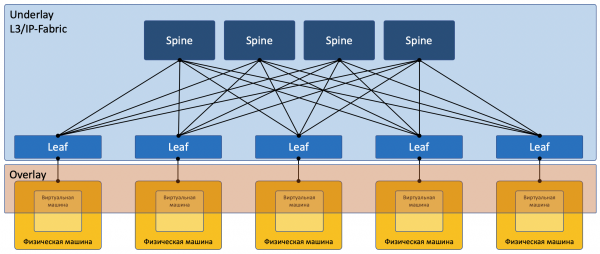
Kép a hálózatra összpontosítva:
Alap
Az Underlay egy fizikai hálózat: hardveres switch-ek és kábelek. Az Underlay-eszközök tudják, hogyan jussanak el a fizikai gépekhez.
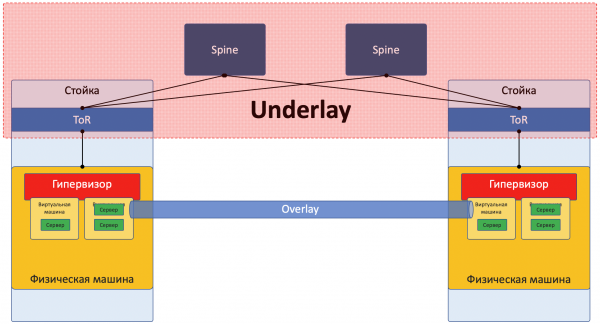
Ez alapvetően standard protokollokra és technológiákra épül. Nem utolsósorban azért, mert a hardveres eszközök ma is zárt szoftverekkel működnek, amelyek nem engedik meg a chip programozást, sem a saját protokolljaik megvalósítását, ezért szükséges a más gyártókkal való kompatibilitás és a standardizálás.
Viszont egy olyan cég, mint a Google, megengedheti magának, hogy saját switch-eket fejlesszen és elhagyja a megszokott protokollokat. De a LAN_DC nem Google.
Az Underlay viszonylag ritkán változik, mert a feladata az alapvető IP-kapcsolat biztosítása a fizikai gépek között. Az Underlay nem tud a rajta futó szolgáltatásokról, ügyfelekről, bérlőkről – csak annyit kell tennie, hogy eljuttat egy csomagot az egyik gépről a másikra.
Az Underlay például ilyen lehet:
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
Az Underlay hálózat klasszikus módon konfigurálható: CLI/GUID/NETCONF.
Manuálisan, szkriptekkel, zártosztályú segédprogramokkal.
Részletesebben az Underlay-ról a következő cikk fog szólni a sorozatban.
Fölérendeltség
Az Overlay egy virtuális alhálózat a tunel állam felett, amely lehetővé teszi egy ügyfél VM-jei közötti kommunikációt, és ezzel párhuzamosan izolációt biztosít más ügyfelektől.
Az ügyfél adatai valamilyen tunneling fejlécbe vannak csomagolva, hogy egy közös hálózaton keresztül továbbítsák.
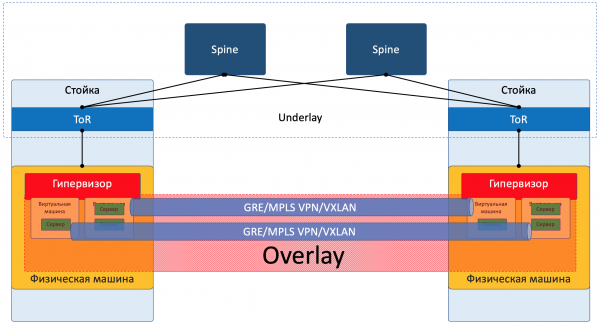
Így egy ügyfél VM-jei (egy szolgáltatás) Overlay-en keresztül kommunikálhatnak egymással, anélkül, hogy tisztában lennének azzal, milyen úton halad a csomag.
Az Overlay például ilyennek nézhet ki, mint amit korábban említettem:
- GRE-alagút
- VXLAN
- EVPN
- L3VPN
- GENEVE
Az Overlay hálózat általában központi vezérlőn keresztül kerül konfigurálásra és karbantartásra. A központból a konfiguráció, a Control Plane és a Data Plane eljut a készülékekhez, amelyek a kliensforgalom routing-jával és encapsulációjával foglalkoznak. Kicsit ezt példákon keresztül áttekintjük.
Igen, ez valódi SDN.
Két alapvetően eltérő megközelítés létezik az Overlay-hálózat kialakítására:
- Overlay a ToR-on
- Overlay a gazdagépen
Overlay a ToR-on
Az Overlay a rackben álló access switch-en (ToR) kezdődhet, ahogy ezt például a VXLAN gyár esetében láthatjuk.
Ez egy időtálló mechanizmus ISP hálózatokon, és minden hálózati eszköz gyártó támogatja.
Ebben az esetben a ToR kapcsolónak képesnek kell lennie a különböző szolgáltatások megkülönböztetésére, ezért a hálózati adminisztrátornak bizonyos mértékig együtt kell működnie a virtuális gépek adminisztrátoraival, és módosításokat kell végeznie az eszközök konfigurációjában (akár automatikusan is).
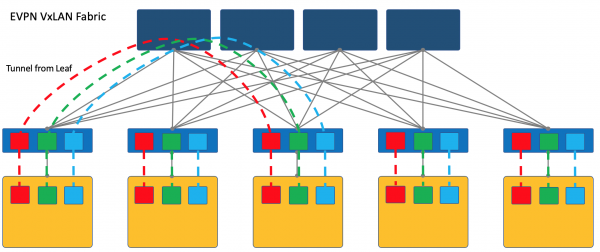
Erre az írásra hivatkoznám az olvasót, a régi ismerősünkről, .
Ebben a részletesen bemutatja az adatközponti hálózat építési megközelítéseit EVPN VXLAN gyárral.
A realitások mélyebb megértéséhez érdemes elolvasni Cisco könyvét, .
Megjegyzem, hogy a VXLAN csak egy encapsulációs módszer, és a tunneling terminálása nem feltétlenül a ToR-en történik, hanem a hoszton, ahogy az például OpenStack esetében történik.
A VXLAN gyár, ahol a felület a ToR-en kezdődik, az egyik megszokott megoldás az overlay hálózatban.
Overlay a gazdagépen
Egy másik megközelítés, ha a tunnelt a végső hosztokon kezdjük és termináljuk.
Ebben az esetben a hálózat (Underlay) a lehető legegyszerűbb és statikus marad.
A hoszt pedig elvégzi az összes szükséges encapsulációt.
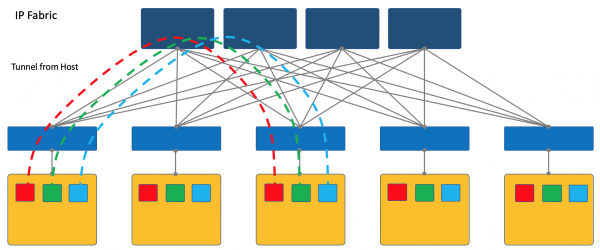
Ehhez természetesen külön alkalmazást kell futtatni a hosztokon, de megéri.
Először is, egyszerűbb ügyfélalkalmazást futtatni Linux gépen, vagyis egyáltalán lehetséges, míg a kapcsolón valószínűleg a proprietary SDN megoldásokhoz kellene folyamodni, ami megöli a több gyártós megoldás lehetőségét.
Másodszor, a ToR kapcsoló ebben az esetben maximálisan egyszerű maradhat, mind a vezérlési, mind az adatforgalmi síkon. Valóban — SDN vezérlővel nem kell kommunikálnia, és nem szükséges tárolni a kapcsolódó ügyfelek hálózatait/ARP-jét — elegendő, ha tudja a fizikai gép IP-címét, ami jelentősen megkönnyíti a kapcsolási/routing táblákat.
Az ADSM sorozatban az overlay megközelítést választom a hosztról — továbbiakban csak erről fogunk beszélni, és már nem térünk vissza a VXLAN gyárhoz.
A legegyszerűbb példákon keresztül szemléltetni. Kísérleti alanyunk a nyílt forráskódú SDN platform, az OpenContrail, amely ma már ismert, mint .
A cikk végén bizonyos megfontolásokat fogok bemutatni az OpenFlow és az OpenvSwitch analógiájáról.
A Tungsten Fabric példáján
Minden fizikai gépen található vRouter — virtuális útválasztó, amely tudomással bír a hozzá csatlakozó hálózatokról és azokhoz tartozó ügyfelekről — lényegében PE-útválasztó. Minden egyes ügyfél számára izolált útválasztási táblát tart fenn (olvass VRF). Maga a vRouter pedig Overlay-alapú alagútépítést végez.
Kicsit részletesebben a vRouter-ről — a cikk végén.
Minden egyes VM, amely a hypervisoron található, a gép vRouter-éhez csatlakozik a .
TAP — Terminal Access Point — virtuális interfész a Linux kernelben, amely lehetővé teszi a hálózati kommunikációt.
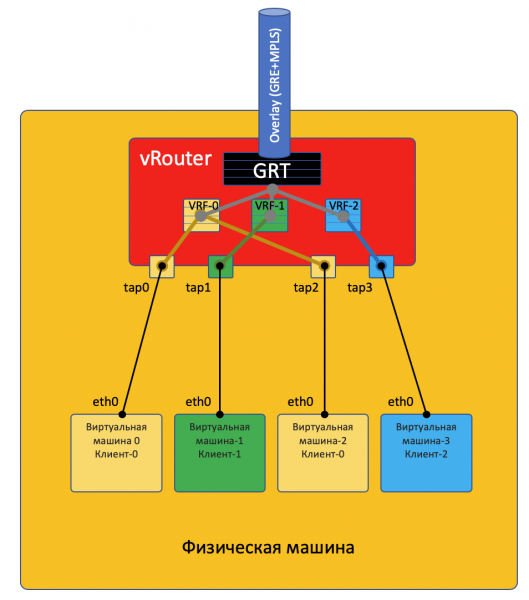
Ha a vRouter mögött több hálózat található, akkor mindegyikhez létrejön egy virtuális interfész, amelyhez IP-cím tartozik — ez lesz az alapértelmezett átjáró címe.
Az egy ügyfélhez tartozó összes hálózat egy VRF (egy táblába) kerül, a különbözőek pedig külön.
Itt megjegyzem, hogy nem minden ilyen egyszerű, és a kíváncsi olvasót a cikk végére irányítom..
Ahhoz, hogy a vRouter-ek kommunikálni tudjanak egymással, így az azon túli VM-ekkel is, útválasztási információt cserélnek SDN-vezérlővel.
Ahhoz, hogy eljussunk a külső világba, van egy kijárati pont a mátrixból — a virtuális hálózat átjárója, VNGW — Virtual Network GateWay (ez a kifejezés az enyém)).
Most nézzük meg a kommunikációs példákat — és minden világossá válik.
Kommunikáció egyetlen fizikai gépen belül
VM0 csomagot szeretne küldeni VM2-nek. Tegyük fel, hogy ez egy ügyfél VM-je.
Adat sík
- A VM-0-nek van alapértelmezett útvonala az eth0 interfészen. A csomag ide kerül elküldésre.
Ez az eth0 interfész valójában virtuálisan csatlakozik a virtuális útválasztóhoz, a vRouter-hez a TAP interfészen, a tap0-n. - A vRouter elemzi, hogy melyik interfészen érkezett a csomag, vagyis melyik ügyfélhez (VRF) tartozik, és összeveti a címzett címet az ügyfél útválasztási táblájával.
- Amikor észleli, hogy a címzett ezen a gépen egy másik porton van, a vRouter egyszerűen elküldi a csomagot anélkül, hogy bármilyen további fejlécet hozzáadna — erre az esetre a vRouter-en már van ARP-bejegyzés.
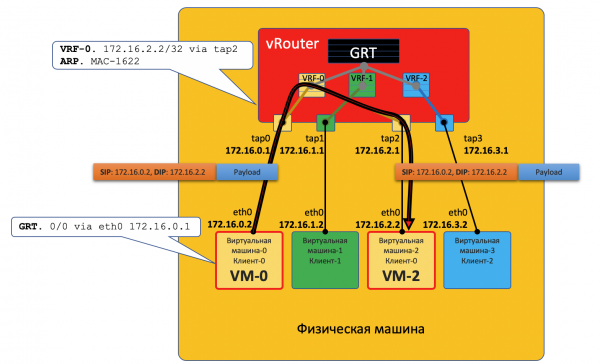
A csomag ebben az esetben nem jut be a fizikai hálózatba — a vRouter-en belül lett irányítva.
Irányító sík
A hypervisor a virtuális gép indításakor közli vele:
- A saját IP-címét.
- Alapértelmezett útvonal — a vRouter IP-címén keresztül ezen a hálózaton.
A vRouter-nek egy speciális API-n keresztül a hypervisor közli:
- Hogy létre kell hoznia egy virtuális interfészt.
- Milyen Virtual Network-ot kell létrehoznia (VM-nek).
- Melyik VRF-hez kell kapcsolni a VN-t.
- A statikus ARP-bejegyzés ennek a VM-nek — melyik interfészen található az IP-címe és melyik MAC-címhez van hozzárendelve.
Ismét, a valós interakciós eljárás leegyszerűsítésre került a koncepció megértése érdekében.
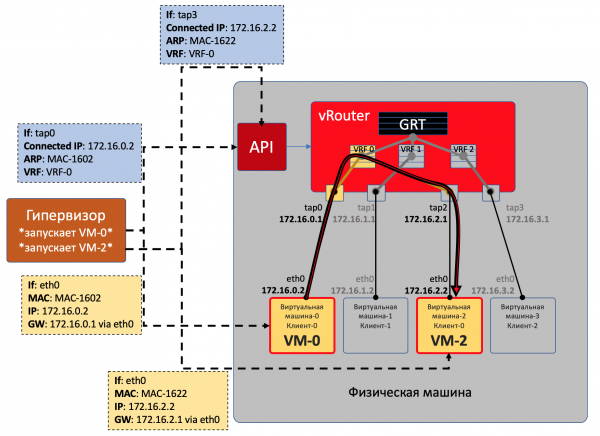
Így az összes VM, amely egy ügyfélnél van, ezen a gépen a vRouter számára közvetlenül csatlakoztatott hálózatként jelenik meg, és képes önállóan irányítani közöttük.
A VM0 és VM1 azonban különböző ügyfelekhez tartozik, így különböző vRouter táblákban helyezkednek el.
Az, hogy közvetlenül kommunikálhatnak-e, a vRouter beállításaitól és a hálózat tervezésétől függ.
Például, ha mindkét ügyfél VM-je nyilvános címeket használ, vagy NAT történik a vRouter-en, akkor lehetséges a közvetlen irányítás a vRouter-en.
Ellenkező esetben címzési térbeli ütközés lehet — NAT-szerveren kell átmenni a nyilvános cím eléréséhez — ez hasonlít a külső hálózatokhoz, amelyeket alább tárgyalunk.
Kommunikáció különböző fizikai gépeken elhelyezett VM-ek között
Adat sík
- A kezdet pontosan ugyanez: a VM-0 csomagot küld a címzett VM-7-nek (172.17.3.2) az alapértelmezett útján.
- A vRouter megkapja, és ezúttal látja, hogy a címzett egy másik gépen található, és elérhető a Tunnel0 alagúton keresztül.
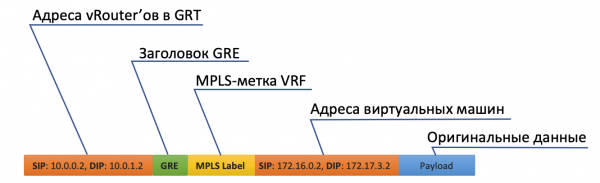
- Először MPLS címkét helyez rá, amely az eltávolított interfészt azonosítja, hogy a vRouter a másik oldalon tudja, hová kell ezt a csomagot elhelyezni, ráadásul további hurok nélkül.
- A Tunnel0 forrása 10.0.0.2, a címzett: 10.0.1.2.
A vRouter GRE (vagy UDP) fejlécet és egy új IP-t ad a kimenő csomaghoz. - A vRouter routing táblájában van egy alapértelmezett útvonal a ToR1 cím 10.0.0.1 felé. Odaküldi.

- A ToR1, mint az Underlay hálózat tagja, tudja (például OSPF alapján), hogyan juthat el a 10.0.1.2-höz, és a csomagot az úton küldi el. Feltételezze, hogy itt az ECMP is belekerül. A képen két következő ugrás van, és a különböző áramlatok ezeken hash alapján fognak megoszlani. Valódi gyár esetén valószínűleg inkább 4 következő ugrás lenne.
Ezen kívül tudnia sem kell, mi található a külső IP fejléc alatt. Tehát valójában az IP alatt lehet egy szendvics IPv6 over MPLS over Ethernet over MPLS over GRE over over over GRE.
- Ezért a befogadó oldalon a vRouter eltávolítja a GRE-t, és az MPLS címke alapján megérti, hogy melyik interfészre kell továbbítani ezt a csomagot, szétszedi, és az eredeti formájában elküldi a címzettnek.
Irányító sík
A gép indításakor minden ugyanaz történik, amit fentebb leírtunk.
És plusz még a következő:
- Minden ügyfél számára a vRouter MPLS-címkét jelöl ki. Ez az L3VPN szolgáltatási címke, amellyel az ügyfelek elkülönülnek egy fizikai gépen belül.
Valójában az MPLS-címkét a vRouter mindig, feltétel nélkül kiosztja — hiszen előre nem tudható, hogy a gép csak más vRouter mögötti gépekkel fog kommunikálni, és valószínű, hogy ez nem is így van.
- A vRouter BGP protokollon (vagy egy ahhoz hasonló, TF esetén XMPP 0_o) keresztül kapcsolódik az SDN-vezérlőhöz.
- Ezen a kapcsolaton keresztül a vRouter tájékoztatja az SDN-vezérlőt a csatlakoztatott hálózatok útvonalairól:
- A hálózat címe
- Az encapsuláció módszere (MPLSoGRE, MPLSoUDP, VXLAN)
- Az ügyfél MPLS-címkéje
- A saját IP-címe, mint nexthop
- Az SDN-vezérlő ilyen útvonalakat kap az összes csatlakoztatott vRouter-től, és átadja őket másoknak. Tehát Route Reflectorként működik.
Ugyanez történik megfordítva is.
Az overlay bármikor változhat. Körülbelül így történik ez a nyilvános felhőkben, amikor az ügyfelek rendszeresen elindítják és leállítják virtuális gépeiket.
A központi vezérlő minden bonyodalmat magára vállal a konfiguráció fenntartásával és a vRouter helyezési/routing tábláinak ellenőrzésével.
Durván szólva a vezérlő BGP-n (vagy egy ahhoz hasonló protokollon) keresztül csatlakozik minden vRouterhez, és egyszerűen továbbítja az útvonalinformációt. A BGP például már rendelkezik Address-Family-val az encapsulációs módszer átadására. vagy .
Ezen közben az Underlay-hálózat konfigurációja semmilyen módon nem változik, amit amúgy automatizálni sokkal nehezebb, míg egy ügyetlen mozdulattal könnyebben tönkretehető.
Kimenet a külvilág felé
Valahol a szimulációnak véget kell érnie, és a virtuális világból vissza kell lépni a valóságba. Szükség van egy hívó kimenetre.
Két megközelítést alkalmaznak:
- Hardveres routert állítanak be.
- Elindítanak egy appliance-t, amely a router funkcióit valósítja meg (igen, a SDN után a VNF-et is megismertük). Hívjuk ezt virtuális átjárónak.
A második megközelítés előnye a költséghatékony horizontális skálázhatóság – ha nem elég a kapacitás, indíts el egy újabb virtuális gépet az átjáróval. Bármely fizikai gépen, anélkül, hogy szabad rackeket, egységeket, tápegységet kellene keresni, vagy megvásárolni a hardvert, szállítani, telepíteni, csatlakoztatni, konfigurálni, majd még javítani az elromlott alkatrészeket.
A virtuális átjárónak azonban vannak hátrányai: a fizikai router egy egysége lényegesen erősebb, mint a sokmagos virtuális gép, és a szoftver, amely a saját hardveréhez van igazítva, jelentősen stabilabban működik (nem). Nem vitatható az a tény sem, hogy a szoftver-hardware kombináció egyszerűen működik, csak beállításokat igényel, míg a virtuális átjáró elindítása és karbantartása erős mérnökök feladata.
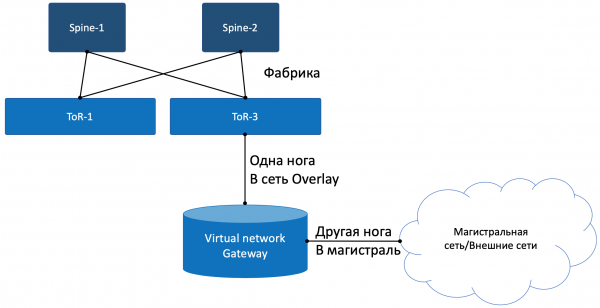
Az átjáró egyik lábával a virtuális Overlay hálózatra néz, mint egy szokásos virtuális gép, és képes interakcióba lépni a többi virtuális géppel. Ezen kívül terminálisan tud szervizelni minden ügyfélnél létrejött hálózatot, így képes azok között irányítást végezni.
A másik lábával az átjáró a gerinchálózatra néz, és tudja, hogyan lépjen ki az Internetre.
Adat sík
Tehát a folyamat így néz ki:
- A VM-0, alapértelmezett beállítással a vRouter felé, csomagot küld a külső világ címzettjének (185.147.83.177) az eth0 interfészen keresztül.
- A vRouter megkapja ezt a csomagot és végrehajt egy cím kereszthivatkozást az irányítási táblában - megtalálja az alapértelmezett útvonalat VNGW1 átjárón keresztül a Tunnel 1-en.
Látja azt is, hogy ez egy GRE alagút, SIP 10.0.0.2 és DIP 10.0.255.2, továbbá először meg kell határoznia az MPLS címkét, amelyet a VNGW1 vár. - A vRouter becsomagolja az eredeti csomagot az MPLS, GRE és új IP fejlécbe, majd alapértelmezettként elküldi a ToR1 10.0.0.1 címre.
- A háttérhálózat eljuttatja a csomagot a VNGW1 átjáróhoz.
- A VNGW1 átjáró eltávolítja a GRE és MPLS alagútfeliratokat, látja a célcímet, konzultál az irányítási táblájával és tudja, hogy az Internetre irányul - tehát a Full View vagy Default útvonalon. Szükség esetén NAT konverziót végez.
- A VNGW és a határ között lehet egy szokásos IP-hálózat, ami valószínűtlen.
Lehet egy klasszikus MPLS hálózat (IGP+LDP/RSVP TE), vagy lehet visszarendezési gyár BGP LU-val, illetve GRE alagút VNGW-től a határig IP-hálózaton keresztül.
Mindenesetre a VNGW1 végrehajtja a szükséges beleillesztéseket és az eredeti csomagot a határ felé küldi.
A forgalom visszafelé ugyanazokat a lépéseket követi, az ellenkező sorrendben.
- A határ eljuttatja a csomagot a VNGW1-hez.
- Az a csomagját szétszedve ellenőrzi a címzettet, és látja, hogy az elérhető a Tunnel1 alagúton keresztül (MPLSoGRE vagy MPLSoUDP).
- Ennek megfelelően MPLS címkét, GRE/UDP fejlécet és új IP-t helyez el, majd elküldi a saját ToR3 10.0.255.1 címére.
A tunnel destination address is the IP address of the vRouter, behind which the target VM is located — 10.0.0.2. - The underlay network delivers the packet to the necessary vRouter.
- The target vRouter decapsulates GRE/UDP, determines the interface by the MPLS label, and sends a raw IP packet to its TAP interface associated with eth0 of the VM.
Irányító sík
VNGW1 establishes a BGP adjacency with the SDN controller, from which it receives all routing information about clients: which client corresponds to which IP address (vRouter) and which MPLS label identifies them.
Similarly, it reports the default route with this client's label to the SDN controller, indicating itself as the nexthop. After that, this default route arrives at the vRouters.
Route aggregation or NAT translation usually occurs on VNGW.
In the opposite direction, in the session with borders or Route Reflectors, it provides this aggregated route. From them, it receives the default route or Full-View, or something else.
In terms of encapsulation and traffic exchange, VNGW is indistinguishable from the vRouter.
If we slightly expand the scope, we can add other network devices to VNGW and vRouters, such as firewalls, traffic cleansing or enhancement farms, IPS, and so on.
By sequentially creating VRF and properly announcing routes, you can cause traffic to loop as desired, which is known as Service Chaining.
Thus, the SDN controller also acts as a Route Reflector among VNGWs, vRouters, and other network devices.
However, the controller also pushes information about ACL and PBR (Policy-Based Routing), causing individual traffic streams to follow paths not dictated by the route.
GYIK
Why do you always make a remark about GRE/UDP?
Well, actually, it can be said to be specific to Tungsten Fabric — it can actually be overlooked.
But if we consider it, TF, when it was still OpenContrail, supported both encapsulations: MPLS in GRE and MPLS in UDP.
UDP is good because the Source Port in its header can easily encode a hash function from the original IP+Proto+Port, which allows load balancing.
In the case of GRE, unfortunately, there are only external IP and GRE headers that are the same for all encapsulated traffic, making load balancing irrelevant — few can look that deeply into the packet.
Egy ideig a routerek, ha tudtak is dinamikus alagútakat, csak MPLSoGRE-t kezeltek, és csak nemrég kezdtek el MPLSoUDP-t is kezelni. Ezért mindig meg kell említeni a két különböző enkapszuláció lehetőségét.
Az igazság kedvéért érdemes megjegyezni, hogy a TF teljes mértékben támogatja az L2-es kapcsolódást a VXLAN segítségével.
Megígérted, hogy párhuzamokat vonasz az OpenFlow-val.
Valóban adódnak. A vSwitch az OpenStack-en hasonló dolgokat csinál, VXLAN-t használva, amelynek egyébként UDP fejléc is van.
Az Adat Síkon körülbelül azonos módon működnek, a Vezérlő Síkon viszont lényegesen különböznek. A Tungsten Fabric XMPP-t használ a vRouter útvonal-információinak szállításához, míg az OpenStack-ben az OpenFlow működik.
Mondhatnál többet a vRouter-ról?
Két részre oszlik: vRouter Agent és vRouter Forwarder.
Az első a gazda operációs rendszer User Space-jében fut, és kommunikál az SDN vezérlővel, megosztva az útvonalakról, VRF-ről és ACL-ről szóló információkat.
A második valósítja meg az Adat Síkot - általában a Kernel Space-ben, de elindulhat SmartNIC-eken is - olyan hálózati kártyák, amelyek CPU-val és külön programozható kapcsolási chippel rendelkeznek, így csökkentve a gazda gép CPU-jára nehezedő terhet, miközben gyorsabbá és kiszámíthatóbbá teszik a hálózatot.
Lehetséges olyan forgatókönyv is, ahol a vRouter egy DPDK-alkalmazás a User Space-ben.
A vRouter Agent átadja a beállításokat a vRouter Forwarder-nek.
Mi az a Virtual Network?
A cikk elején említettem a VRF-et, hogy minden bérlő a saját VRF-hez kapcsolódik. Ha a felületes megértéshez az overlay hálózat működéséről ez elegendő volt, a következő iterációban már pontosítani kell.
A virtualizációs mechanizmusokban a Virtual Network entitást (ezt tekinthetjük saját névnek) általában külön kezelik a kliensektől/bérlőktől/virtuális gépektől - egy teljesen önálló dolog. Ezen a Virtual Network-en már interfészeken keresztül csatlakoztatható egy bérlőhöz, egy másikhoz, kettőhöz, bárhová. Így valósul meg például a Szolgáltatás Chaining, amikor a forgalmat bizonyos csomópontokon kell átvezetni, a megfelelő sorrendben létrehozva és hozzárendelve a Virtual Network-öket.
Ezért a Virtual Network és a bérlő között nincs egyértelmű megfelelő.
Zárás
Ez egy meglehetősen felületes leírás a virtuális hálózat működéséről az overlay és az SDN-vezérlő között. De bármelyik virtualizációs platformot is választja manapság, hasonló módon fog működni, legyen szó VMware-ről, ACI-ről, OpenStack-ről, CloudStack-ről, Tungsten Fabric-ról vagy Juniper Contrail-ról. A különbségek az encapsulációk és fejlécek típusában, valamint az információk végső hálózati eszközökre való szállítási protokollokban rejlenek, de az alapvető elve a programozható overlay hálózatnak, amely egy viszonylag egyszerű és statikus underlay hálózatra épül, változatlan marad.
Azt lehet mondani, hogy a privát felhő létrehozásának területén ma már az overlay alapú SDN győzött. Ez azonban nem jelenti azt, hogy az Openflow-nak nincs helye a modern világban — az OpenStack-ben és a VMware NSX-ben is használják, amennyire tudom, a Google is ezt alkalmazza az underlay hálózat konfigurálásához.
Lentebb linkeket adtam a részletesebb anyagokhoz, ha mélyebben szeretné tanulmányozni a kérdést.
Mi a helyzet az Underlay-jel?
Összességében nem sok. Az végig ugyanolyan maradt. Mindez, amit tennie kell az overlay és a host esetében, az útvonalak és ARP-frissítések kezelése, ahogy a vRouter/VNGW megjelenik és eltűnik, valamint a csomagok átirányítása közöttük.
Foglaljuk össze a követelménylistát az Underlay hálózatra vonatkozóan.
- Legyen képes egy útválasztási protokollra, a mi esetünkben — BGP.
- Legyen széles sávja, lehetőleg átírás nélkül, hogy ne veszítsenek el csomagokat a túlterhelés miatt.
- Támogatnia kell az ECMP-t — ez a gyártás szerves része.
- Képesnek kell lennie QoS biztosítására, beleértve a trükkös dolgokat is, mint az ECN.
- Támogatnia kell a NETCONF-ot — jövőbeli beruházás.
Az Underlay hálózat működésére itt nagyon keveset szenteltem időt. Ennek oka az, hogy a sorozat további részeiben éppen arra fogok összpontosítani, míg az Overlay-t csak érintőlegesen fogjuk megemlíteni.
Nyilvánvalóan jelentősen korlátozom mindannyiunkat, amikor például a DC-t egy IP-routing és overlay alapú gyárra épített hálózatként említem.
Azonban biztos vagyok benne, hogy bármilyen, tervezett hálózatot formális kifejezésekkel le lehet írni és automatizálni lehet. Csak azt a célt követem itt, hogy megértsem az automatizálási megközelítéseket, nem pedig az, hogy mindenkit összezavarjak a probléma általános kezelésével.
Az ADS-M keretein belül Romannal együtt külön kiadást tervezünk a számítási kapacitások virtualizációjáról és annak interakciójáról a hálózati virtualizációval. Maradjon velünk.
Hasznos linkek
- .
- . 6 órás összefoglaló a Yandex Felhőről, amely érinti a virtuális hálózatot is a TF keretein belül.
- .
- . Itt a DC teljes hálózatáról beszélünk, beleértve az Underlay-t, Overlay-t, a több szálú megközelítéseket és a menedzsmentet.
Köszönöm
- — a linkmeup korábbi műsorvezetőjének, jelenleg felhőplatformok szakértőjének. A megjegyzésekért és az észrevételekért. Várjuk a közeljövőben a virtuálisításról szóló részletes cikkét is.
- — a kollégámnak és a virtuális hálózatok fejlesztésének szakértőjének. A megjegyzésekért és az észrevételekért.
- — a kollégámnak és a Tungsten Fabric szakértőjének. A megjegyzésekért és az észrevételekért.
- — a linkmeup illusztrátorának. Köszönjük a KDPW-t.
- Alexander Limonovnak. A "automato" mémért.
Forrás: habr.com
