

Helló mindenkinek. Vezető rendszergazdaként dolgozom az OK-nál, és én vagyok felelős a portál stabil működéséért. Szeretném elmondani, hogyan építettük ki a lemezek automatikus cseréjének folyamatát, majd hogyan zártuk ki ebből a folyamatból az adminisztrátort, és cseréltük le egy bottal.
Ez a cikk egyfajta transliteráció. a HighLoad+ 2018-on.
Lemezcserélési folyamat kiépítése.
Először is néhány szám.
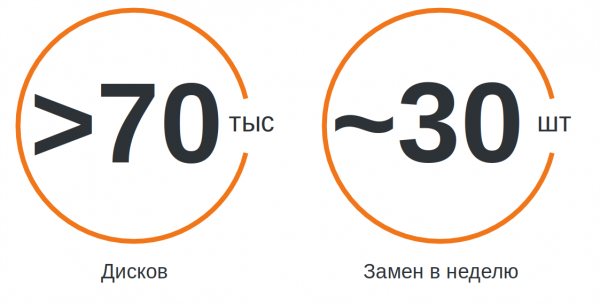
Az OK egy hatalmas szolgáltatás, amelyet milliók használnak. Körülbelül 7 ezer szerver szolgálja ki, amelyek 4 különböző adatközpontban találhatók. A szerverekben több mint 70 ezer lemez található. Ha egymásra helyezzük őket, akkor egy több mint 1 km magas torony jönne létre.
A merevlemezek a szerver egyik leggyakrabban meghibásodó alkatrészei. Ezekben a mennyiségekben körülbelül 30 lemezt kell cserélnünk hetente, és ez a folyamat nem válik éppen kellemes rutinná.
Incidensek
Cégünknél teljes körű incidensmenedzsment van bevezetve. Minden incidensünket rögzítjük a Jirában, majd megoldjuk és átbeszéljük. Ha az incidens hatással volt a felhasználókra, akkor feltétlenül összeülünk és azon gondolkodunk, hogyan lehet gyorsabban reagálni az ilyen esetekben, hogyan csökkenthető a hatás, és természetesen hogyan lehetne megakadályozni a megismétlődését.
A tárolók sem kivételek. Állapotukra a Zabbix figyel. Figyeljük a Syslog üzeneteket írási/olvasási hibák miatt, elemezzük a HW/SW RAID-ek állapotát, nyomon követjük a SMART-jelentéseket, SSD esetén számoljuk a kopást.
Hogyan zajlott a lemezek cseréje korábban.
Amikor a Zabbixban valamelyik trigger világítani kezd, a Jirában egy incidens jön létre, és automatikusan hozzárendelődik a megfelelő mérnökökhöz az adatközpontokban. Ezt minden HW-incidens esetén megteszik, azaz azok esetében, amelyek fizikai munkát igényelnek a hardverrel az adatközpontban.
Az adatközpont mérnöke az a személy, aki a hardverrel kapcsolatos problémákat megoldja, felelős a szerverek telepítéséért, karbantartásáért és leszereléséért. Ha megkap egy jegyet, a mérnök elkezdi a munkát. A lemeztárakban önállóan cseréli a lemezeket. De ha nincs hozzáférése a megfelelő eszközhöz, a mérnök a ügyeletes rendszergazdától kér segítséget. Először ki kell venni a lemezt a rotációból. Ehhez szükséges változtatásokat kell végezni a szerveren, leállítani az alkalmazásokat, és leválasztani a lemezt.
A felügyeleti rendszeradminisztrátor a munkanap során felelős az egész portál működéséért. Vizsgálja az eseményeket, javítja a problémákat, segít a fejlesztőknek kisebb feladatokat ellátni. Csak a merevlemezekkel nem foglalkozik.
Korábban a dataközpont mérnökei csevegésen keresztül kommunikáltak a rendszeradminisztrátorral. A mérnökök linkeket küldtek a Jira-jegyekhez, az adminisztrátor végigment rajtuk, és valamilyen jegyzetfüzetbe vezette a munkát. De az ilyen feladatokhoz a csevegések kényelmetlenek: az információ ott nem strukturált és gyorsan elveszik. Ráadásul az adminisztrátor akár el is távolodhatott a számítógéptől, és egy időre nem válaszolt a megkeresésekre, míg a mérnök ott állt a szerver mellett egy halom lemezzel és várakozott.
De a legrosszabb az volt, hogy az adminisztrátorok nem látták az egész képet: milyen lemezes incidensek léteznek, hol merülhet fel potenciális probléma. Ez azzal áll összefüggésben, hogy az összes hardveresi incidenshez a mérnököket adjuk. Igen, meg lehetett volna jeleníteni az összes incidenst az adminisztrátor irányítópultján. De nagyon sokan vannak, és az adminisztrátor csak néhány esetben vonódott be.
Ezen kívül a mérnök nem tudta helyesen rangsorolni a prioritásokat, mert semmit sem tudott a konkrét szerverek rendeltetéséről, az információk tárolókra való elosztásáról.
Új csereeljárás
Első lépésként minden lemezes eseményt külön «HW-lemez» típusra helyeztünk, és hozzáadtuk a «blokkeszköz neve», «méret» és «lemeztípus» mezőket, hogy ez az információ megmaradjon a jegyben, és ne kelljen állandóan csevegésen cserélni.
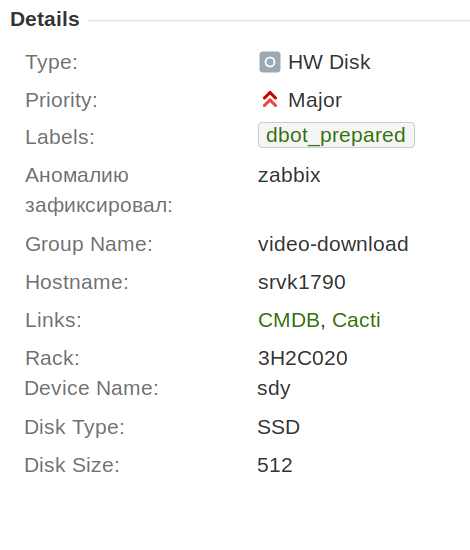
Ezen kívül megállapodtunk abban, hogy egy incidens keretein belül csak egy lemezt cserélünk. Ez jelentősen leegyszerűsítette a későbbiekben az automatizálás folyamatát, a statisztika gyűjtését és a munkát.
Továbbá hozzáadtunk egy «felelős adminisztrátor» mezőt is. Ide automatikusan bekerül a ügyeletes rendszergazda. Ez nagyon kényelmes, mert most a mérnök mindig látja, ki a felelős. Nem kell a naptárba nézni és keresgélni. Ennek a mezőnek köszönhetően tudtuk megjeleníteni az adminisztrátor irányítópultján azokat a jegyeket, amelyek esetleg segítségét igénylik.
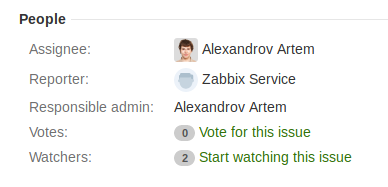
Annak érdekében, hogy minden résztvevő maximálisan profitáljon az újításokból, létrehoztunk szűrőket és irányítópultokat, és tájékoztattuk róluk a csapatot. Amikor az emberek értik a változásokat, nem távolodnak el tőlük, mint valami feleslegtől. A mérnöknek fontos tudnia a rack számát, ahol a szerver található, a lemez méretét és típusát. Az adminisztrátor számára pedig elsősorban azt kell értenie, hogy milyen szervercsoportokkal van dolga, és milyen hatásai lehetnek a lemez cseréjének.
A mezők megléte és megjelenítése hasznos, de a chatek használatának szükségességét ez nem szüntette meg. Ehhez meg kellett változtatnunk a munkafolyamatot.
Régen így működött:
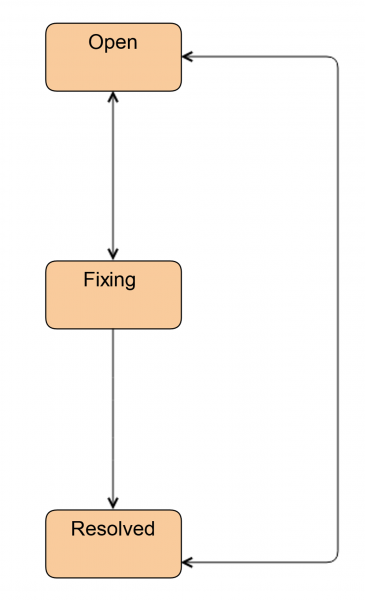
Ma így dolgoznak a mérnökök, amikor nincs szükségük az adminisztrátor segítségére.
Az első lépés, amit megtettünk, az új státusz bevezetése volt: Investigate. Ebben a státuszban van a jegy, amikor a mérnök még nem döntött arról, hogy szüksége van-e az adminisztrátorra. Ezen a státuszon keresztül a mérnök át tudja adni a jegyet az adminisztrátornak. Ezen kívül ezzel a státusszal jelöljük azokat a jegyeket is, amikor lemezcsere szükséges, de a lemez még nem áll rendelkezésre a helyszínen. Ez előfordulhat CDN és távoli telephelyek esetén.
Azt is hozzáadtuk, hogy státusz: Kész. Ebbe a státuszba kerül a jegy a lemez cseréje után. Tehát minden már el van végezve, de a szerveren a HW/SW RAID szinkronizálódik. Ez eltarthat egy ideig.
Ha az adminisztrátort bevonják a munkába, a folyamat egy kicsit bonyolultabbá válik.
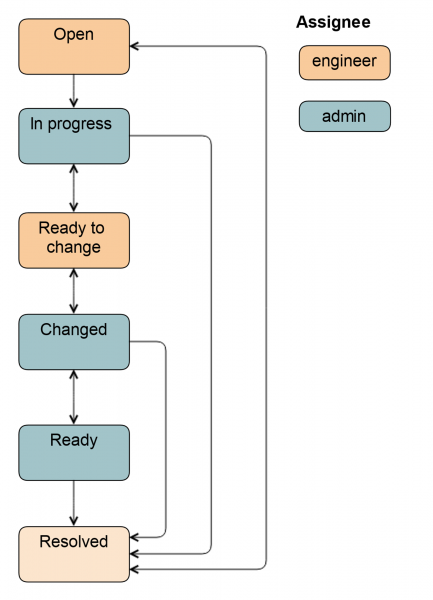
A státuszból: Megnyitás a jegyet áthelyezheti rendszergazda vagy mérnök. A státuszban: In progress az adminisztrátor eltávolítja a lemezt a rotációból, hogy a mérnök egyszerűen ki tudja venni: bekapcsolja a világítást, lecsatlakoztatja a lemezt, leállítja az alkalmazásokat, a szervercsoporttól függően.
Ezután a jegy átkerül a: Ready to change: ez jelzi a mérnöknek, hogy a lemez eltávolítható. Minden mező a Jirában már ki van töltve, a mérnök tudja, hogy milyen típusú és méretű lemezről van szó. Ezek az adatok vagy automatikusan, az előző státuszban kerülnek kitöltésre, vagy az adminisztrátor tölti ki őket.
A lemez cseréje után a jegy átkerül a: Changed. Ellenőrizzük, hogy a megfelelő lemezt helyeztük-e be, megcsináljuk a felosztást, elindítjuk az alkalmazást és néhány feladatot a adat-helyreállításhoz. A jegy átkerülhet a státuszba: Kész, ebben az esetben az adminisztrátor marad a felelős, mert ő hozta be a lemezt a rotációba. A teljes folyamat így néz ki.
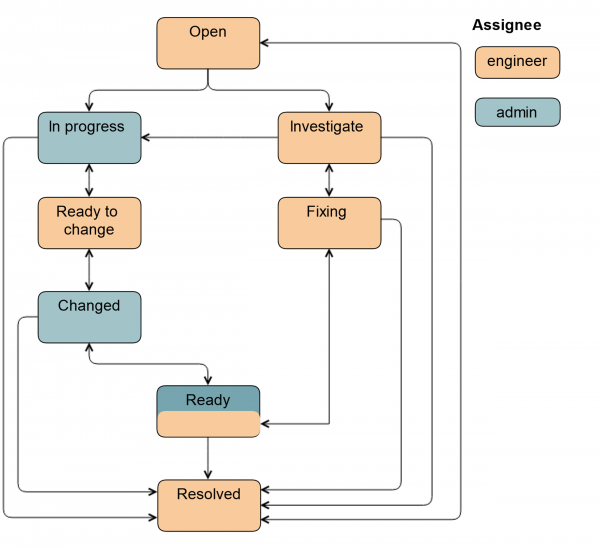
Az új mezők hozzáadása jelentősen megkönnyítette az életünket. A srácok elkezdtek strukturált információkkal dolgozni, világossá vált, hogy mit és mikor kell csinálni. A prioritások sokkal relevánsabbá váltak, mivel most már az adminisztrátor állítja őket fel.
Eltűnt a szükség a csevegésekre. Természetesen az adminisztrátor írhat az mérnöknek, hogy „itt gyorsan ki kell cserélni”, vagy „már este van, sikerül lecserélni?”. De már nem kommunikálunk ezekről a kérdésekről napi szinten a csevegésekben.
A lemezeket csoportosan kezdjük cserélni. Ha az adminisztrátor kicsit korábban érkezik a munkába, és van szabadidője, és még semmi nem történt, előkészíthet egy sor szervert a cserére: beállítja a mezőket, eltávolítja a lemezeket a forgásból, és átadja a feladatot az mérnöknek. Az mérnök kicsivel később érkezik az adatközpontba, látja a feladatot, elviszi a szükséges meghajtókat a raktárból, és azonnal kicseréli őket. Ennek eredményeként a csere sebessége nőtt.
A Workflow felépítése során szerzett tapasztalatok
- A eljárás kidolgozása során információt kell gyűjteni különböző forrásokból.
Néhány adminisztrátorunk nem tudta, hogy az mérnök önállóan cseréli a lemezeket. Néhányan azt hitték, hogy az MD RAID szinkronizálását az mérnökök figyelnek, pedig közülük néhányan nem is rendelkeztek hozzáféréssel. Néhány vezető mérnök ezt csinálta, de nem mindig, mert a folyamat sehol sem volt leírva. - Az eljárásnak egyszerűnek és érthetőnek kell lennie.
Az ember nehezen tudja a fejében tartani a számos lépést. A legfontosabb szomszédos állapotokat a Jirában ki kell emelni a fő képernyőre. Átnevezhetjük őket, például a 'Folyamatban' státuszt 'Készen a cserére' nevezhetjük. A többi státuszt el lehet rejteni egy legördülő menüben, hogy ne zavarja a szemet. De jobb, ha nem korlátozzuk az embereket, hanem lehetőséget adunk a váltásra.
Magyarázd el az újítások értékét. Amikor az emberek megértik, jobban elfogadják az új eljárást. Számunkra nagyon fontos volt, hogy az emberek ne kattintsanak végig a folyamaton, hanem kövessék azt. Később ezt automatizálásra építettük. - Várni, elemezni, megérteni.
Körülbelül egy hónapunkba telt az eljárás felépítése, a technikai megvalósítás, a találkozók és a megbeszélések. A bevezetésre pedig több mint három hónap volt szükség. Láttam, ahogy az emberek fokozatosan elkezdik használni az újítást. Az első szakaszokban sok negatív visszajelzés érkezett. De ez egyáltalán nem a magának az eljárásnak, vagy annak technikai megvalósításának volt köszönhető. Például az egyik adminisztrátor nem a Jira-t, hanem a Jira plugin-t használta a Confluence-ben, és így bizonyos dolgokhoz nem férhetett hozzá. Megmutattuk neki a Jira-t, és az adminisztrátor termelékenysége nőtt mind a globális feladatok, mind a lemezcserék tekintetében.
Lemezcsere automatizálása
Többször nekiláttunk a lemezcsere automatizálásának. Már voltak korábbi munkáink, szkriptek, de ezek interaktív vagy manuális módban működtek, és indítást igényeltek. Csak az új eljárás bevezetése után értettük meg, hogy éppen erre volt szükségünk.
Most, hogy a lemezcsere folyamatát szakaszokra bontottuk, minden szakaszhoz kijelölt felelős és teendőlista van, fokozatosan tudjuk bevezetni az automatizálást, nem pedig egyszerre mindent. Például a legkönnyebb szakasz — Ready (a RAID/adatok szinkronizálásának ellenőrzése) könnyen delegálható egy botra. Amikor a bot egy kicsit megtanul, adhatunk neki komolyabb feladatot is — a lemez bevezetése a rotációba, stb.
Setup állatkert
Mielőtt beszélnénk a botról, tegyünk egy kis kirándulást a mi installációs állatkertünkbe. Először is, ez a hatalmas infrastruktúránknak köszönhető. Másodszor, minden szolgáltatáshoz megpróbáljuk az optimális hardverkonfigurációt kiválasztani. Körülbelül 20 különböző RAID modellünk van, főként LSI és Adaptec, de HP és DELL különböző verziói is előfordulnak. Minden RAID-vezérlő saját kezelőprogrammal rendelkezik. A parancskészlet és a kibocsátás verzióról verzióra eltérhet minden RAID-vezérlő esetében. Ahol HW-RAID nem használatos, ott mdraid lehet.
A szinte minden új installációt lemezrezerválás nélkül végzünk. Igazából már nem akarunk hardveres és szoftveres RAID-et használni, mivel a rendszereinket adatközponti szinten, nem pedig szerver szinten rezerváljuk. Természetesen sok örökölt szerver van, amelyeket támogatnunk kell.
A RAID-vezérlőkben a lemezek néha nyers eszközökként jelennek meg, más esetekben pedig JBOD-ot használnak. Vannak olyan konfigurációk, ahol egyetlen rendszerlemez található a szerverben, és ha azt ki kell cserélni, akkor újra kell telepíteni a szervert az OS-sel és az alkalmazásokkal, ráadásul azonos verziókkal, majd hozzá kell adni a konfigurációs fájlokat, és el kell indítani az alkalmazásokat. Számos szervercsoport létezik, ahol a tartalékot nem a lemezes alrendszer szintjén, hanem magukban az alkalmazásokban valósítják meg.
Összesen több mint 400 egyedi szervercsoportunk van, amelyeken körülbelül 100 különböző alkalmazás fut. Az ilyen hatalmas számú lehetőség lefedéséhez multifunkcionális automatizáló eszközre volt szükségünk. Lehetőleg egyszerű DSL-t szeretnénk, hogy ne csak az tudja támogatni, aki írta.
Az Ansible mellett döntöttünk, mert agentless: nem kellett előkészíteni az infrastruktúrát, gyors a kezdet. Ráadásul Python nyelven íródott, ami a csapatban elfogadott standard.
Átfogó séma
Nézzük meg az automatizálás általános sémáját egy incidenst példaként. A Zabbix észleli, hogy az sdb lemez meghibásodott, a trigger bekapcsol, és ticket kerül létrehozásra a Jira-ban. Az adminisztrátor megnézi, megérti, hogy ez nem duplikátum és nem false positive, tehát a lemezt cserélni kell, és az ticketet átkonvertálja In progress állapotba.
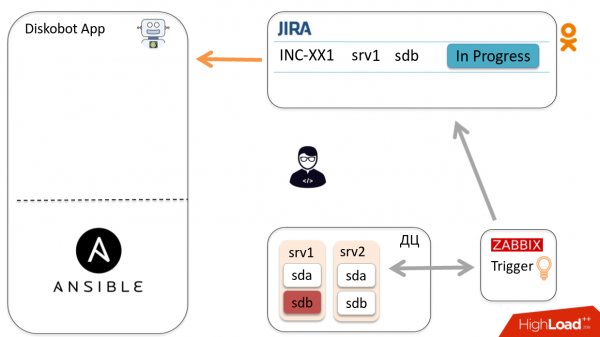
A DiskoBot alkalmazás, amely Python nyelven íródott, rendszeresen lekérdezi a Jira-t új ticketek után. Észleli, hogy új, In progress állapotú ticket van, és elindul a megfelelő thread, amely elindítja az Ansible playbook-ot (ez minden Jira állapotnál megtörténik). Ebben az esetben a Prepare2change indításra kerül.
Az Ansible a hosztra kerül, kibővíti a lemezt a rotációból, és jelentést küld az alkalmazásnak Callbacks-on keresztül.
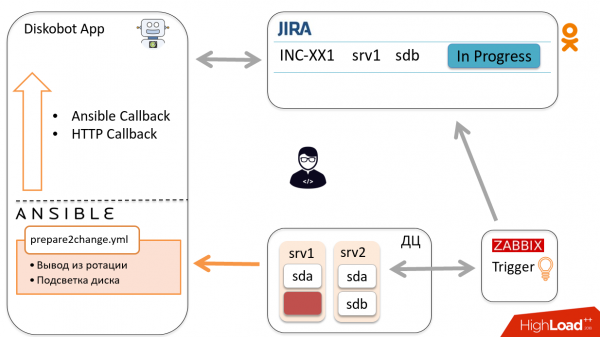
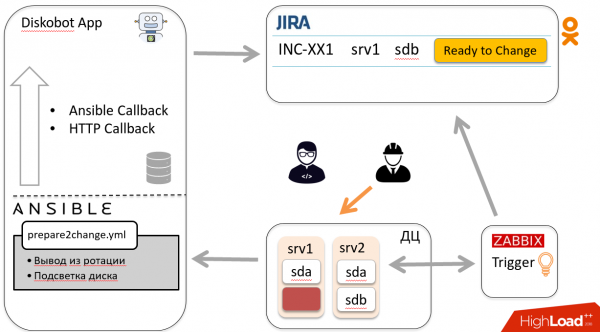
Eredményei alapján a bot automatikusan átkonvertálja a ticketet Ready to change állapotba. A mérnök értesítést kap, és elindul a lemez cseréjére, majd átkonvertálja a ticketet Changed állapotba.
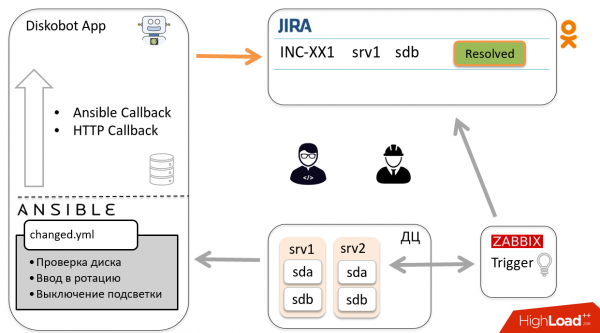
A fent leírt sémának megfelelően a ticket visszakerül a bothoz, az elindít egy másik playbook-ot, elmegy a hosztra és visszahelyezi a lemezt a rotációba. A bot lezárja a ticketet. Hurrá!
Most beszéljünk a rendszer egyes összetevőiről.
Diskobot
Ez az alkalmazás Python nyelven íródott. A Jira-ból választja ki a ticketeket a JQL szerint. A ticket állapota alapján az utolsó egy megfelelő feldolgozóhoz kerül, amely elindítja a kapcsolódó Ansible playbook-ot az állapotnak megfelelően.
A JQL és a lekérdezési időközök az alkalmazás konfigurációs fájljában vannak megadva.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Például az In progress állapotú jegyek közül csak azok kerülnek kiválasztásra, amelyekben a Disk size és a Device name mezők ki vannak töltve. A Device name a blokkeszköz neve, amely a playbook futtatásához szükséges. A Disk size arra szükséges, hogy a mérnök tudja, mekkora méretű lemezre van szükség.
A Ready állapotú jegyekből kiszűrik a dbot_ignore címkével ellátott jegyeket. Megjegyzendő, hogy a Jira címkéket ilyen típusú szűrésre, valamit a duplikált jegyek megjelölésére és statisztikák gyűjtésére használjuk.
Playbook hiba esetén a Jira a dbot_failed címkét rendeli hozzá, hogy később vizsgálni lehessen.
Interakció Ansible-lel
Az alkalmazás az Ansible-lel az alábbiakon keresztül lép kapcsolatba . A playbook_executor-ben átadjuk a fájl nevét és a változókat. Ez lehetővé teszi, hogy az Ansible projektet hagyományos yml fájlok formájában tartsuk, ahelyett, hogy Python kódként írnánk le.
Továbbá az Ansible-ban az *extra_vars* segítségével átadjuk a blokkeszköz nevét, a jegy státuszát, valamint a callback_url-t, amelyben szerepel az issue key – ezt a HTTP callbackhez használják.
Minden indításkor egy ideiglenes inventory jön létre, amely egy hostból és egy csoportból áll, amelybe ez a host tartozik, hogy alkalmazódjanak a group_vars.
Íme egy példa a feladatra, amely a HTTP callbacket valósítja meg.
A playbookok végrehajtásának eredményét callback(-ek) segítségével kapjuk meg. Két típusú:
- , biztosítja a playbook végrehajtásának eredményeit. Ott vannak leírva a feladatok, amelyeket futtattak, sikeresen vagy sikertelenül lettek végrehajtva. Ez a callback a playbook lejátszása után kerül meghívásra.
- HTTP callback az információk megszerzéséhez a playbook lejátszása alatt. Az Ansible feladatban POST/GET kérést küldünk az alkalmazásunk irányába.
A HTTP callback(-ek) segítségével átadjuk azokat a változókat, amelyeket a playbook futtatása során határoztunk meg, és amelyeket meg szeretnénk őrizni és felhasználni a későbbi futtatások során. Ezeket az adatokat sqlite-be írjuk.
A HTTP callback segítségével megjegyzéseket is hagyhatunk és megváltoztathatjuk a jegy státuszát.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Mint a hasonló feladatok esetén ezt egy külön közös fájlba vittük, és szükség esetén belefoglaljuk, hogy ne ismételjük meg folyamatosan a playbook-okban. Itt szerepel a callback_url, amelybe be van ágyazva a kérdés kulcs és a gazda neve. Amikor az Ansible végrehajtja ezt a POST-kérést, a bot tudja, hogy egy adott incidens keretein belül érkezett.
Íme egy példa a playbook-ból, amelyben eltávolítottuk a lemezt egy MD-egységből:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Ez a feladat átkonvertálja a Jira jegyet a 'Készen áll a változtatásra' státuszba, és hozzátold egy megjegyzést. Emellett az mdam_data változóban a lemezek listája tárolódik, amelyek az MD-egységekből lettek eltávolítva, és a parted_info-ban — A parted-ból készült partíciós mentés.
Amikor a mérnök behelyez egy új lemezt, ezeket a változókat tudjuk használni a partíciós mentés helyreállításához, valamint a lemezt azokba az MD-egységekbe is be tudjuk vinni, ahonnan eltávolították.
Ansible ellenőrző mód
Az automatizálás bekapcsolása ijesztő volt. Ezért úgy döntöttünk, hogy az összes playbook-ot a következő módban indítjuk
, amelyben az Ansible nem hajt végre semmilyen műveletet a szervereken, csak szimulálja azokat.
Ez a futtatás egy külön callback modulon keresztül történik, az playbook végrehajtásának eredményét pedig Jira-ban mentjük el megjegyzésként.
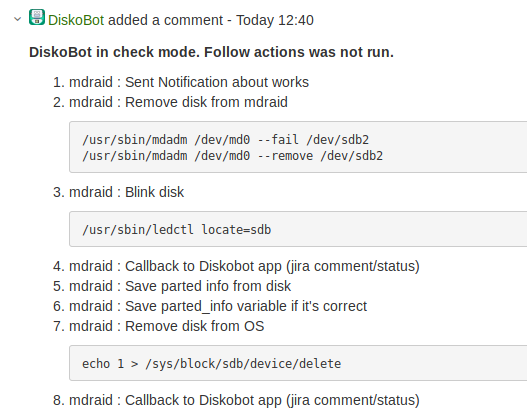
Először is lehetővé tette a bot és a playbook-ok működésének érvényesítését. Másodszor pedig növelte az adminisztrátorok bizalmát a bot iránt.
Amikor áthaladtunk az érvényesítésen, és megértettük, hogy az Ansible-t nemcsak száraz futás módban lehet üzemeltetni, létrehoztunk a Jira-ban egy Run Diskobot gombot, amely ugyanazt a playbook-ot indítja el ugyanazokkal a változókkal ugyanazon a gazdán, de normál módban.
Ezen kívül a gombot használják a playbook újbóli futtatására, ha az elbukik.
Playbook-ok felépítése
Már említettem, hogy a Jira-jegy állapotától függően a bot különböző playbook-okat indít.
Először is, így sokkal egyszerűbb megszervezni a beérkezést.
Másodszor, bizonyos esetekben ez elengedhetetlen.
Például, amikor a rendszerlemezt cseréljük, először a telepítési rendszerbe kell menni, feladatot létrehozni, és miután a szerver megfelelően települt, elérhetővé válik ssh-n keresztül, és telepíthetjük rá az alkalmazást. Ha mindezt egy playbook-ban végeznénk, az Ansible nem tudná végrehajtani, mivel a gazda nem lenne elérhető.
Ansible szerepeket használunk minden szervercsoport számára. Itt látható, hogyan vannak megszervezve a playbook-ok az egyikben.
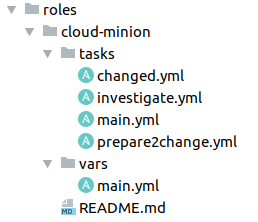
Ez kényelmes, mert azonnal világos, hogy hol helyezkednek el a különböző feladatok. A main.yml, amely az Ansible-rol belépési pontja, lehet egyszerű include a jegy státusza szerint vagy általános feladatok, amelyek mindenki számára szükségesek, például az azonosítás lebonyolítása vagy a token megszerzése.
Investigation.yml
Az Investigation és Open státuszú jegyekhez indítjuk. A legfontosabb dolog ennek a playbooknak a név, ami a blokkeszközhöz tartozik. Ez az információ nem mindig érhető el.
Ezt az információt a Jira összegzésének elemzésével kapjuk, az utolsó értéket a Zabbix-triggerből. Ott lehet a blokkeszköz neve – ha szerencsénk van. Vagy lehet benne a mount point, ekkor a szerverhez kell menni, parse-olni és kiszámítani a szükséges lemezt. A trigger átadhat SCSI-címet vagy valamilyen más információt is. De előfordulhat, hogy semmi nyom nem áll rendelkezésre, és elemezni kell.
Miután kiderítettük a blokkeszköz nevét, összegyűjtjük az információkat a típusáról és méretéről, hogy kitölthessük a mezőket a Jirában. Információt gyűjtünk a gyártóról, modellt, firmware-t, ID-t, SMART-ot, és ezt mind beillesztjük a Jira-jegy megjegyzésébe. Az adminisztrátornak és az mérnöknek most már nem kell keresnie ezeket az adatokat. 🙂
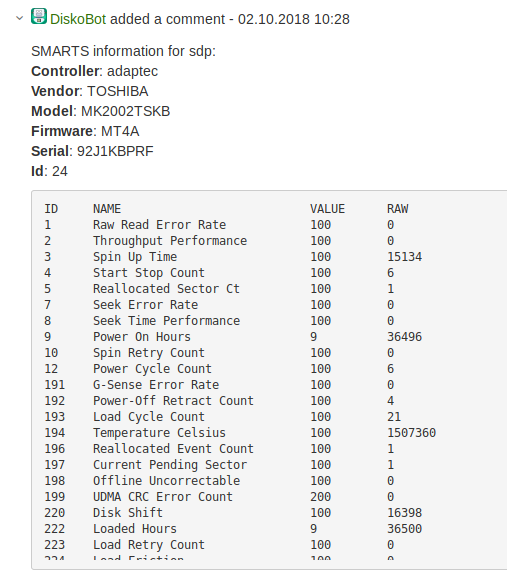
prepare2change.yml
Lemez eltávolítása a rotációból, felkészülés a cserére. Ez a legnehezebb, legfelelősebb szakasz. Itt lehet leállítani az alkalmazást, amikor azt nem szabad megállítani. Vagy kihúzni a lemezt, aminek nem volt elegendő replikája, ezzel hatással lenni a felhasználókra, elveszíteni néhány adatot. Itt van a legtöbb ellenőrzés és értesítés a csevegésben.
A legegyszerűbb esetben a lemez eltávolításáról beszélünk HW/MD RAID-ben.
Bonyolultabb helyzetekben (a tárolórendszereinkben), amikor az alkalmazás szintjén történik a redundálás, fel kell lépni az API-n keresztül az alkalmazáshoz, jelenteni az eltávolítást, deaktiválni és elindítani a helyreállítást.
Jelenleg tömeges migrálásban vagyunk , és ha a szerver felhős, akkor a Diskobot az API-hoz fordul, mondja, hogy dolgozni készül ezzel a minyon-nal – a szerverrel, amelyen tartályok futnak – és kéri, hogy "migrálj minden tartályt erről a minyonról". És egyben bekapcsolja a lemez kiemelését, hogy az mérnök azonnal lássa, melyiket kell kihúzni.
changed.yml
A lemez cseréje után elsőként ellenőrizzük a hozzáférhetőségét.
A mérnökök nem mindig helyeznek be új lemezeket, ezért hozzáadtuk a számunkra megfelelő SMART értékek ellenőrzését.
Milyen attribútumokat figyelünkÁtallocált szektorok száma (5) < 100
Jelenlegi függő szektorok száma (107) == 0
Ha a lemez nem teljesíti a tesztet, az mérnök értesítést kap a cseréről. Ha minden rendben van, a világítás kikapcsol, a jelölés elvégezhető, és a lemez forgatásra kerül.
ready.yml
A legegyszerűbb eset: HW/SW raid szinkronizációjának ellenőrzése, vagy az adat szinkronizálásának befejezése az alkalmazásban.
Alkalmazás API
Többször említettem, hogy a bot gyakran hívja meg az alkalmazás API-t. Természetesen nem minden alkalmazás rendelkezett a szükséges metódusokkal, ezért ki kellett őket egészíteni. Íme a legfontosabb metódusok, amelyeket használunk:
- Státusz. A klaszter vagy lemez állapota, hogy meghatározzuk, használható-e;
- Kezd/megállít. A lemez aktiválása/deaktiválása;
- Migrate/restore. Az adatok migrálása és helyreállítása a csere során és után.
Ansible-val kapcsolatos tapasztalat
Nagyon szeretem az Ansible-t. De gyakran, amikor különböző opensource projekteket nézek, és látom, hogy az emberek hogyan írnak playbook-okat, kicsit megijedek. Bonyolult logikai összefonódások a when/loop-ban, rugalmasság és idempotencia hiánya a shell/command gyakori használata miatt.
Elhatároztuk, hogy mindent maximálisan leegyszerűsítünk, kihasználva az Ansible előnyét - a moduláris felépítést. A legfelső szinten találhatók a playbook-ok, amelyeket bármely adminisztrátor vagy külső fejlesztő írhata, aki egy kicsit ismeri az Ansible-t.
- name: Villogó lemez
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Ha egy logika nehezen valósítható meg a playbook-okban, az Ansible-modulba vagy szűrőbe visszük. A szkriptek íródhatnak Python-ban vagy bármely más nyelven.
Könnyen és gyorsan írhatók. Például a lemez megvilágításához írt modul, amelynek fenti használati példája van, 265 sorból áll.
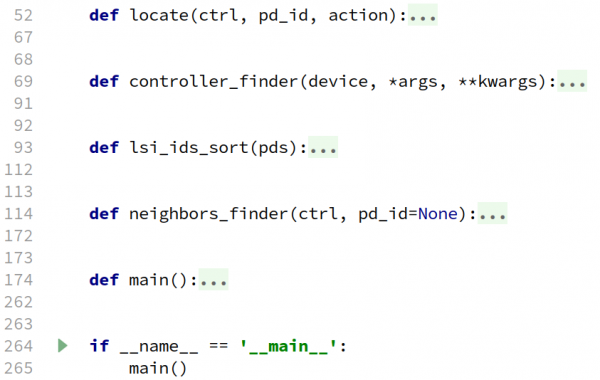
A legalacsonyabb szinten található a könyvtár. Ehhez a projekthez külön alkalmazást írtunk, egyfajta absztrakciót a hardveres és szoftveres RAID-ek felett, amelyek végrehajtják a megfelelő lekérdezéseket.
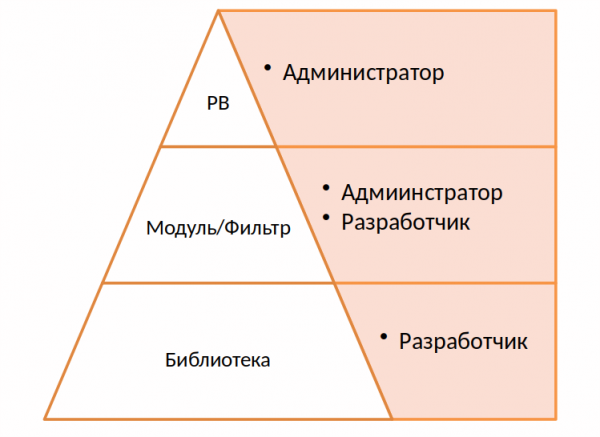
Az Ansible legerősebb pontjai a könnyű használat és a világos playbook-ok. Úgy gondolom, hogy ezt ki kell használni, és nem szörnyű yaml-fájlokat és hatalmas mennyiségű feltételt, shell-kódot és ciklusokat kell generálni.
Ha meg akarja ismételni a tapasztalatainkat az Ansible API-val kapcsolatban, vegye figyelembe a következő két dolgot:
- A Playbook_executor és maga a playbook nem fogadhat el timeout-ot. Van timeout az ssh-munkameneteknél, de a playbookhoz nincs. Ha megpróbálunk eltávolítani egy lemezt, amely már nem létezik a rendszerben, a playbook végtelenül fog futni, ezért egy külön wrapperbe kellett csomagolnunk a futtatását, és timeout alapján leölni.
- Az Ansible fork-processzek alapján működik, ezért az API-ja nem szálbiztos. Minden playbookunkat egy szálon futtatjuk.
Ennek eredményeként körülbelül 80%-kal sikerült automatizálni a lemezcseréket. Összességében a csere sebessége megduplázódott. Ma az adminisztrátor csak figyeli az eseményeket, és döntést hoz arról, hogy szükséges-e a lemez cseréje, majd egy kattintással végrehajtja.
De most egy másik problémával találkozunk: néhány új adminisztrátor nem tudja, hogyan kell lemezt cserélni. 🙂
Forrás: habr.com
