

Ez a cikk segít megérteni, hogyan működik a terheléselosztás a Kubernetes rendszerben, mi történik a tartós kapcsolatok skálázásakor, és miért érdemes megfontolni a kliensoldali terheléselosztást, ha HTTP/2-t, gRPC-t, RSockets-t, AMQP-t vagy más tartós protokollokat használ.
Egy kis információ arról, hogyan oszlik el a forgalom a Kubernetesben
A Kubernetes két kényelmes absztrakciót kínál az alkalmazások kihelyezésére: szolgáltatások (Services) és telepítések (Deployments).
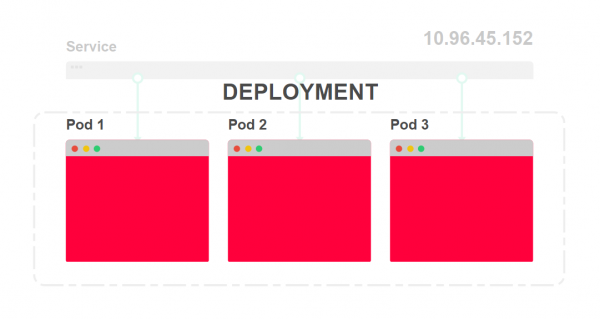
A telepítések meghatározzák, hogy hány példányának kell futnia az alkalmazásának bármikor. Minden alkalmazás pod-ként (Pod) van kihelyezve, és IP-címet kap.
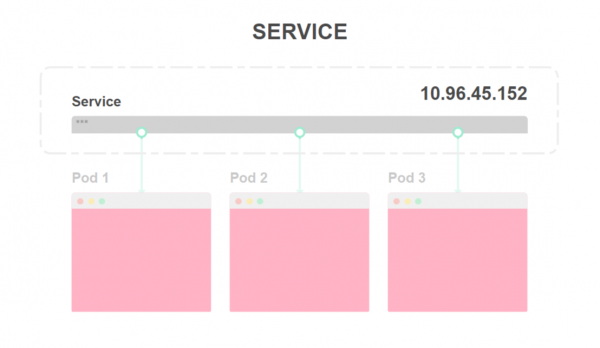
A szolgáltatások funkciók szempontjából hasonlóak a terheléselosztókhoz. Azért jönnek létre, hogy a forgalmat több pod között osszák el.
Nézzük meg, hogyan néz ez ki.
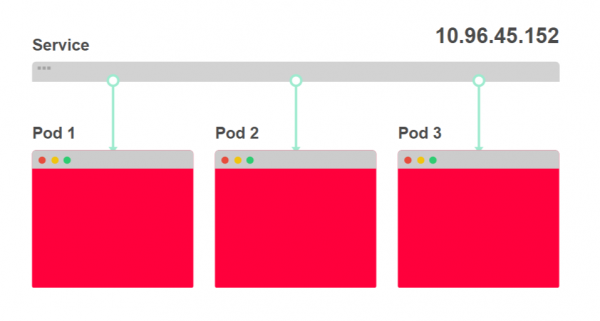
- Az alábbi diagramon három példányát látja egy alkalmazásnak és a terheléselosztónak:

- A terheléselosztót szolgáltatásnak (Service) hívják, és IP-címet rendeltünk hozzá. Minden bejövő kérést egy podhoz irányítunk:

- A telepítési forgatókönyv meghatározza az alkalmazás példányainak számát. Szinte soha nem kell közvetlenül podot telepítenie:

- Minden pod saját IP-címet kap:

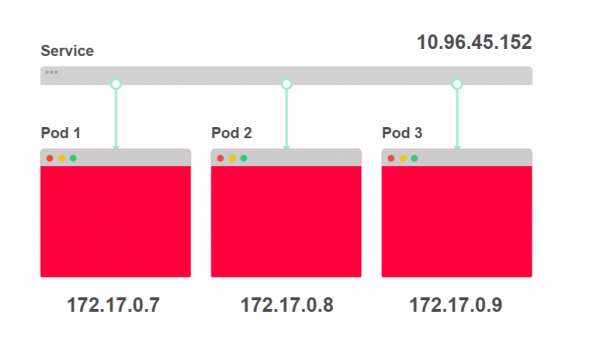
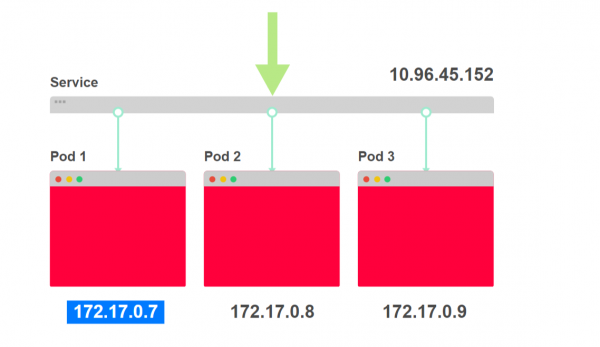
Hasznos a szolgáltatásokat IP-címek halmazaként kezelni. Valahányszor a szolgáltatáshoz fordul, választunk egy IP-címet a listából, és használjuk célcímként.
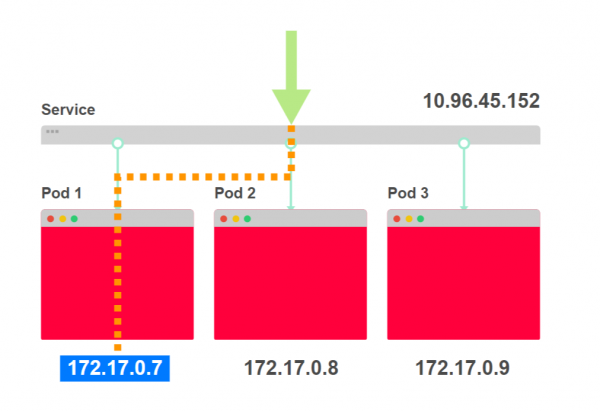
Ez a következőképpen néz ki.
- A curl 10.96.45.152 kérés érkezik a szolgáltatáshoz:

- A szolgáltatás az egyik három pod IP-címét választja ki célállomásként:

- A forgalom egy adott podhoz irányul:


Ha az alkalmazása frontendből és backendből áll, akkor mindkettőhöz lesz szolgáltatás és telepítés.
Amikor a frontend kérést küld a backendnek, nem szükséges tudnia, hogy pontosan hány pod szolgálja ki a backendet: lehet egy, tíz vagy akár száz is.
A frontendnek arról semmi tudomása sincs, hogy mely podok szolgálják ki a backendet.
Amikor a frontend kérést küld a backendnek, a backend szolgáltatásának IP-címét használja, amely nem változik.
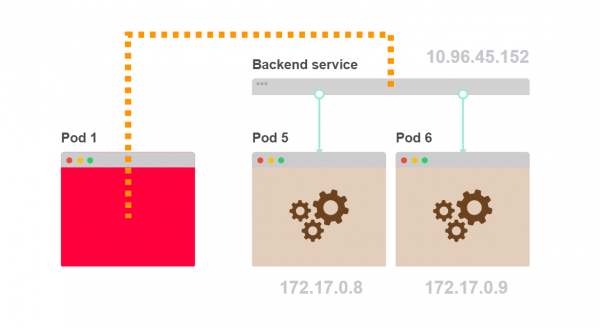
Így néz ki ez.
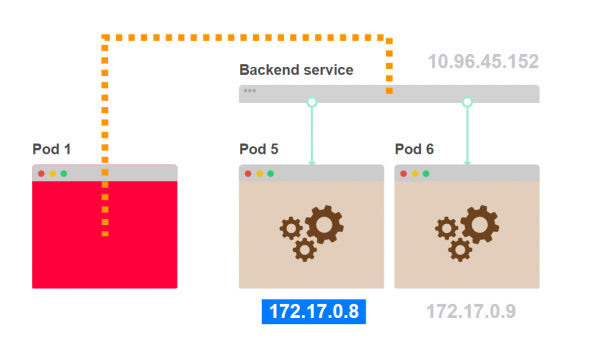
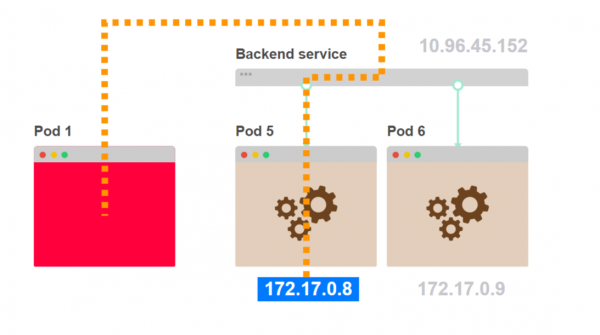
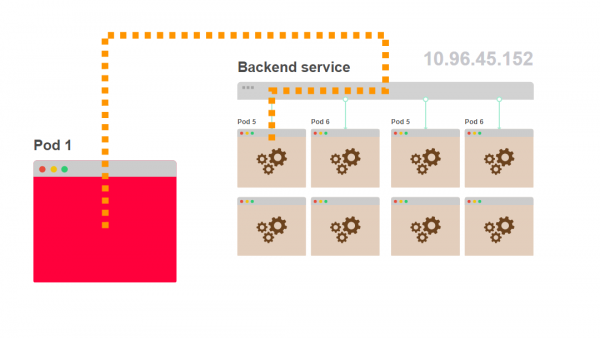
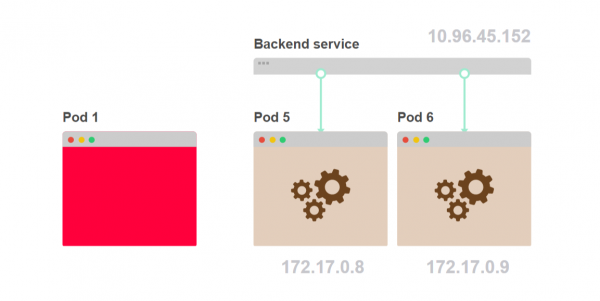
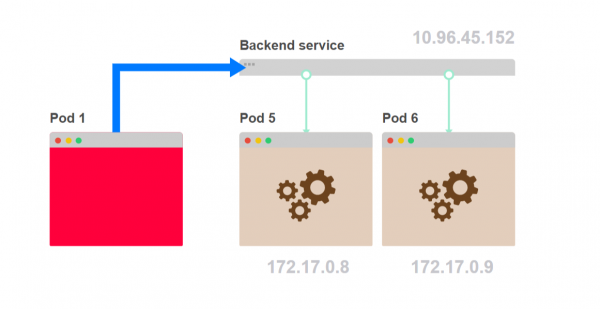
- Az 1. pod kérdést intéz a backend belső összetevőjéhez. Ahelyett, hogy egy konkrét backend podot választana, a szolgáltatás felé küldi a kérdést:

- A szolgáltatás egy backend podot választ ki célcímként:

- A forgalom az 1-es podból az 5-ös podba áramlik, amelyet a szolgáltatás választott:

- Az 1-es pod nem tudja, hány 5-ös pod rejtőzik a szolgáltatás mögött:

De hogyan osztja el a szolgáltatás a kéréseket? Úgy tűnik, a round-robin terheléselosztást használják? Nézzük meg közelebbről.
Terheléselosztás a Kubernetes szolgáltatásokban
A Kubernetes szolgáltatások nem léteznek. A szolgáltatásnak nincs folyamata, amely IP-címet és portot kapna.
Ezt megerősítheti, ha bármelyik klaszternódához belép, és végrehajt egy netstat -ntlp parancsot.
Még az IP-címet is nehezen találja meg, amelyet a szolgáltatásnak szántak.
A szolgáltatás IP-címe a vezérlési rétegben található, a vezérlőben, és az etcd adatbázisban van tárolva. Ezt az IP-címet egy másik komponens, a kube-proxy is használja.
A kube-proxy megkapja az összes szolgáltatás IP-címét, és iptables szabálygyűjteményt alakít ki a klaszter minden nodáján.
Ezek a szabályok azt mondják: 'Ha látunk egy szolgáltatás IP-címet, módosítsuk a kérés célcímét, és küldjük el az egyik podhoz'.
A szolgáltatás IP-címe csak belépési pontként használható, és nincs olyan folyamat, amely figyeli ezt az IP-címet és portot.
Nézzük meg ezt.
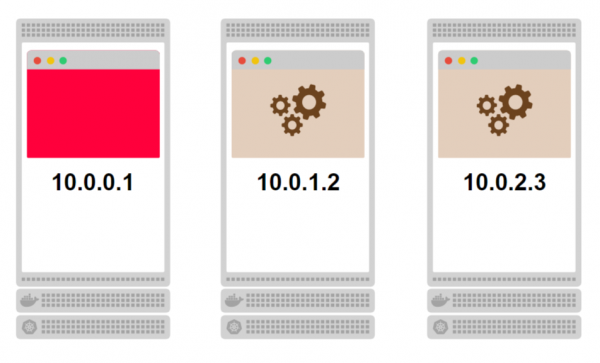
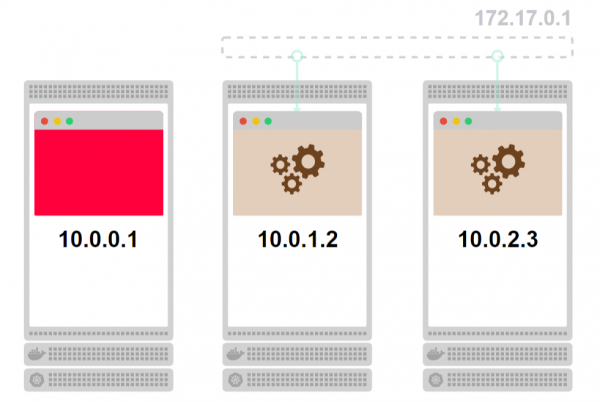
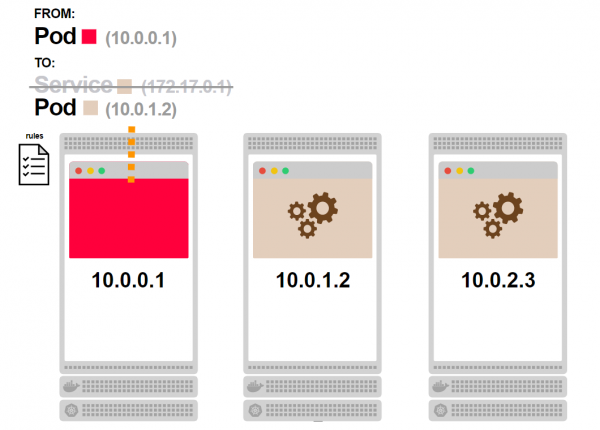
- Tekintsük meg a három nodából álló klasztert. Minden nodán találhatók podok:

- A krémszínű hátterű kapcsolódó podok a szolgáltatás részét képezik. Mivel a szolgáltatás nem létezik mint folyamat, szürke színnel ábrázolják:

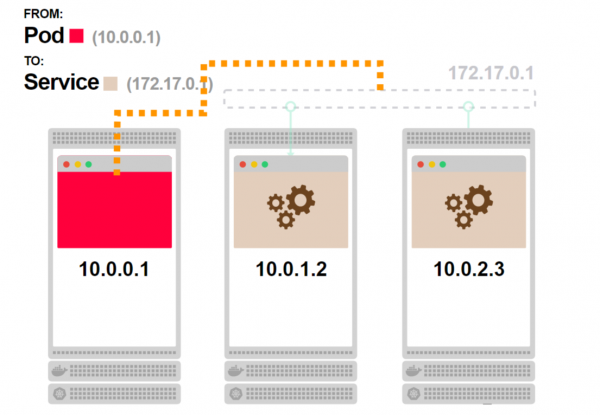
- Az első pod kéri a szolgáltatást és egy kapcsolódó podhoz kell eljutnia:

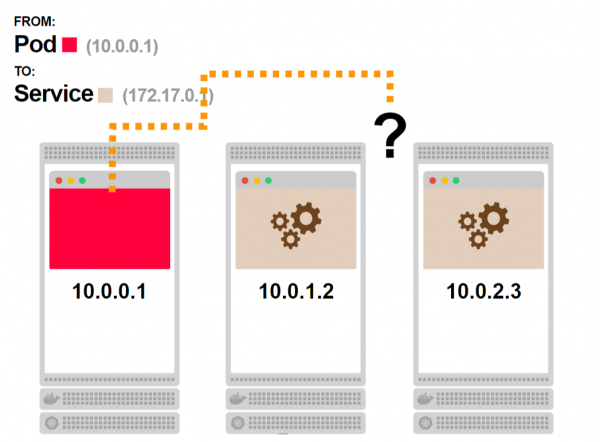
- De a szolgáltatás nem létezik, folyamat nincs. Hogyan működik ez?

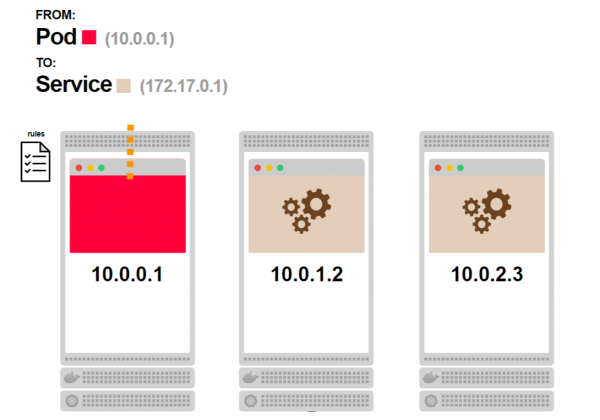
- Mielőtt a kérés elhagyná a nodát, átmegy az iptables szabályokon:

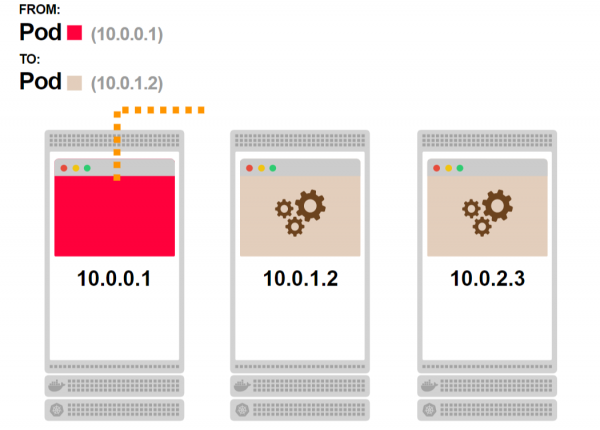
- Az iptables szabályok tudják, hogy a szolgáltatás nem létezik, és a szolgáltatás IP-címét egy kapcsolódó pod IP-címére cserélik:

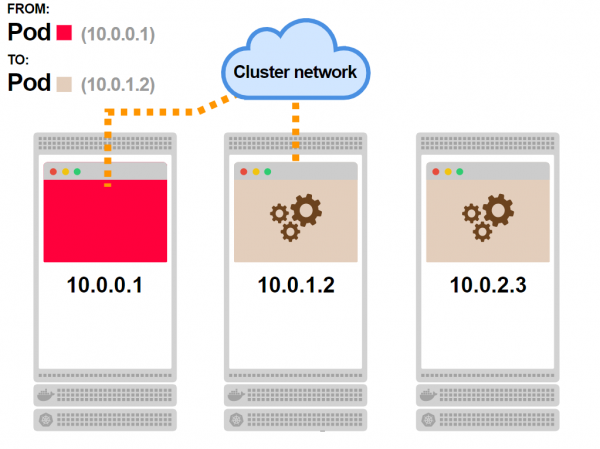
- A kérés érvényes IP-címet kap mint célcím, és normálisan feldolgozzák:
- A hálózati topológiától függően a kérés végül eljut egy podhoz:

Tudnak az iptables terhelést egyensúlyozni?
Nem, az iptables a szűrésre szolgál, és nem a terheléselosztásra tervezték.
Viszont lehetséges írni olyan szabályok halmazát, amelyek működnek mint .
És pontosan ez valósul meg a Kubernetesben.
Ha három podja van, a kube-proxy az alábbi szabályokat fogja írni:
- A valószínűség 33% legyen, hogy az első podot válassza, különben lépjen a következő szabályra.
- A második pod választása 50% valószínűséggel, egyébként lépjen a következő szabályra.
- Harmadik pod választása.
Ez a rendszer azt eredményezi, hogy minden pod 33% valószínűséggel kerül kiválasztásra.
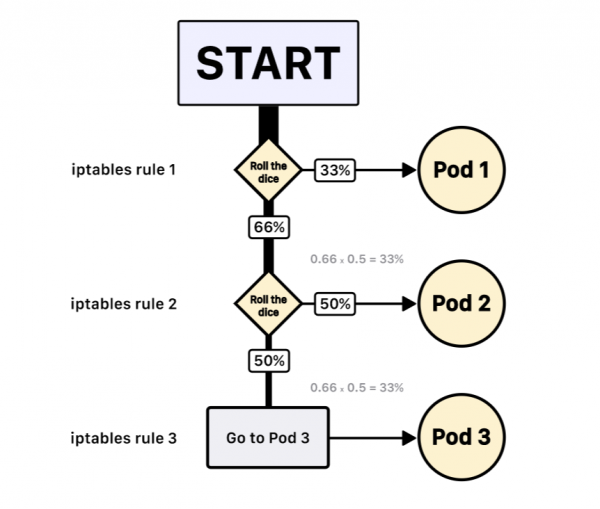
Nincs garancia arra, hogy a 2-es pod a 1-es pod után lesz választva.
Megjegyzés: az iptables statisztikai modult használ véletlenszerű elosztással. Így a terheléselosztó algoritmus véletlenszerű választáson alapul.
Most, hogy megértette, hogyan működnek a szolgáltatások, nézzünk meg érdekesebb működési forgatókönyveket.
A tartós kapcsolatok Kubernetesben alapértelmezett szerint nem skálázhatók.
Minden HTTP-kérés a frontend és a backend között külön TCP-kapcsolaton keresztül zajlik, amelyet megnyitnak és bezárnak.
Ha a frontend másodpercenként 100 kérést küld a backendnek, akkor 100 különböző TCP-kapcsolat nyílik meg és záródik be.
Csökkenthető a kérés feldolgozási ideje és a terhelés, ha egy TCP-kapcsolatot nyitunk meg és használunk minden további HTTP-kéréshez.
A HTTP-protokollban van egy lehetőség, amelyet HTTP keep-alive-nak vagy a kapcsolat újrafelhasználásának neveznek. Ebben az esetben egy TCP-kapcsolatot használnak több HTTP-kérés és válasz küldésére és fogadására:
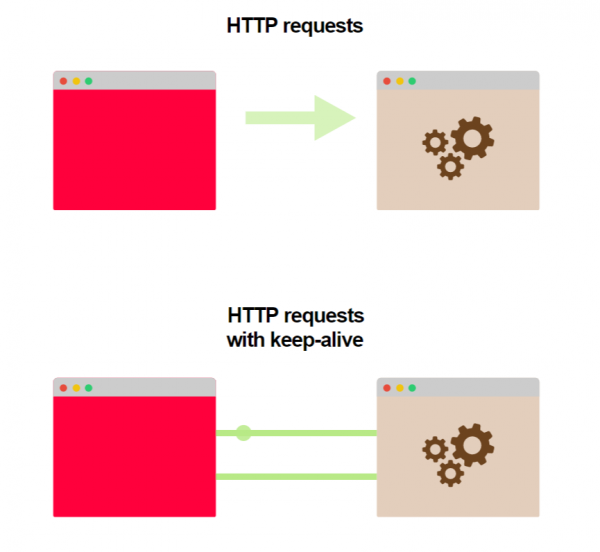
Ez a lehetőség alapértelmezés szerint nincs engedélyezve: mind a szervernek, mind a kliensnek megfelelően kell konfigurálva lennie.
Magának a beállításnak a megvalósítása egyszerű és a legtöbb programozási nyelv és környezet számára elérhető.
Íme néhány link példákra különböző nyelveken:
Mi fog történni, ha a keep-alive-ot használjuk a Kubernetes szolgáltatásban?
Tegyük fel, hogy a frontend és a backend is támogatja a keep-alive-ot.
Van egy frontend példányunk és három backend példányunk. A frontend elküldi az első kérést és megnyit egy TCP-kapcsolatot a backendhez. A kérés eljut a szolgáltatásig, ahol az egyik backend podot választják ki célszámként. A backend pod válaszol, és a frontend megkapja azt.
Egy átlagos esetben, amikor a választ megkapják, a TCP-kapcsolat záródik, most ez nyitva marad a következő HTTP-kérésekhez.
Mi fog történni, ha a frontend további kéréseket küld a backendnek?
Ezeknek a kéréseknek a továbbításához a nyitott TCP-kapcsolatot fogják használni, minden kérés ugyanahhoz a backend podhoz jut el, ahova az első kérés.
Nem kellene az iptables-nak újra elosztania a forgalmat?
Nem ebben az esetben.
Amikor TCP kapcsolat jön létre, az áthalad az iptables szabályain, amelyek kiválasztják a konkrét podot a backendből, ahová a forgalom kerül.
Mivel az összes következő kérés már megnyitott TCP kapcsolaton keresztül halad, az iptables szabályok már nem hívódnak meg.
Nézzük meg, hogyan néz ez ki.
- Az első pod küldi a kérést a szolgáltatás felé:

- Már tudja, mi fog történni. A szolgáltatás nem létezik, de vannak iptables szabályok, amelyek feldolgozzák a kérést:
- A backend egyik podja lesz kiválasztva célcímként:

- A kérés eljut a podhoz. Ekkor egy állandó TCP kapcsolat jön létre a két pod között:

- Bármely következő kérés az első podból az már létrehozott kapcsolaton keresztül fog menni:

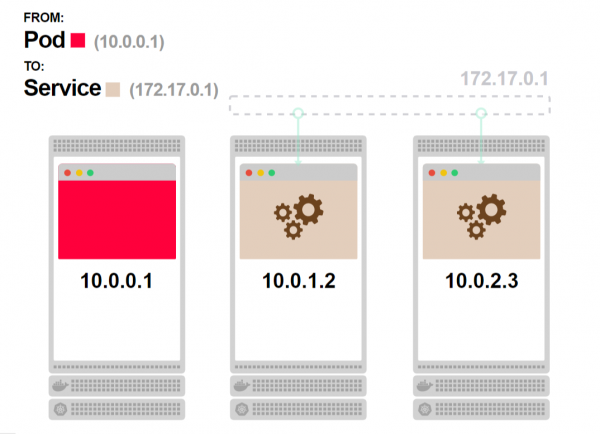
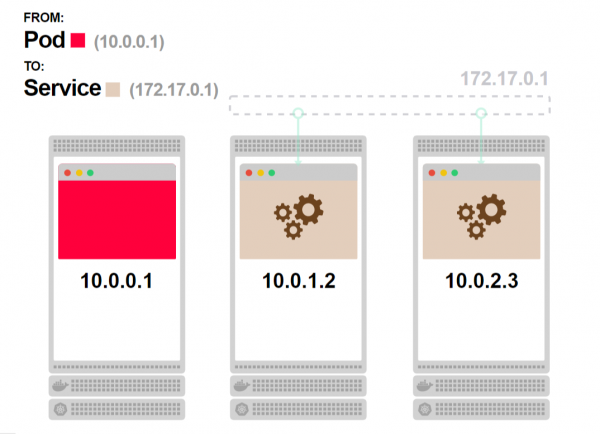
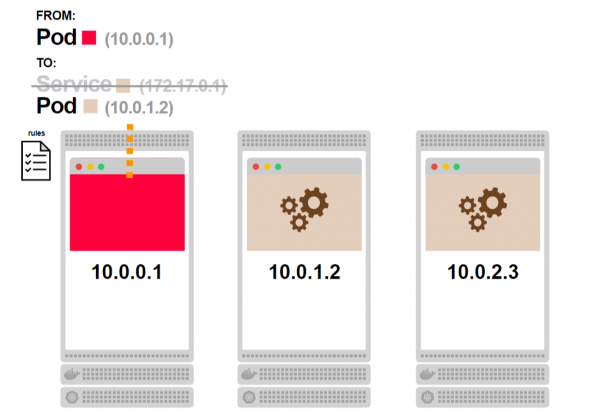
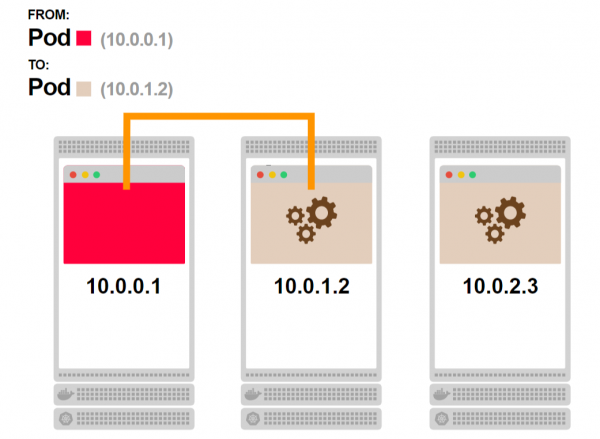
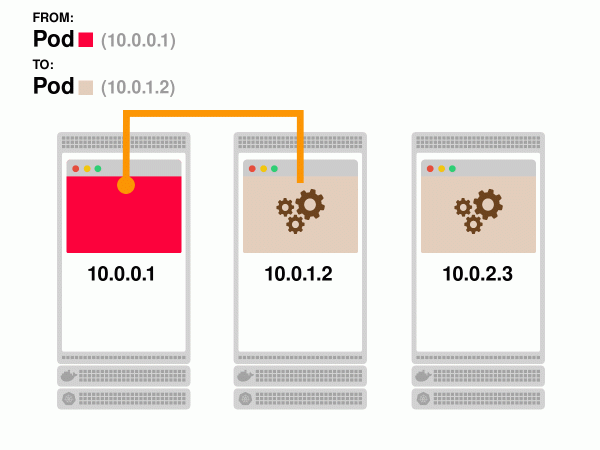
Ennek eredményeként gyorsabb válaszidőt és magasabb áteresztőképességet kapott, de elveszítette a backend skálázhatóságát.
Még ha a backendben két pod is van, az állandó kapcsolattal a forgalom folyamatosan az egyikre fog irányulni.
Lehet ezt javítani?
Mivel a Kubernetes nem tudja, hogyan kell kiegyenlíteni az állandó kapcsolatokat, ezt a feladatot önnek kell ellátnia.
A szolgáltatások IP-címek és portok halmazai, amelyeket végpontoknak neveznek.
Az alkalmazása megkaphatja a végpontok listáját a szolgáltatásból, és eldöntheti, hogyan ossza el a kéréseket köztük. Megnyithat egy állandó kapcsolatot minden poddal, és kiegyenlítheti a kéréseket ezek között a kapcsolatok között round-robin módszerrel.
Vagy alkalmazhatja a .
A kliensoldali kód, amely a kiegyenlítést végzi, a következő logikát kell kövesse:
- Kapja meg a végpontok listáját a szolgáltatásból.
- Minden végponthoz nyisson meg egy állandó kapcsolatot.
- Amikor szükséges kérni, használjon egyet a megnyitott kapcsolatok közül.
- Rendszeresen frissítse a végpontok listáját, hozzon létre új vagy zárjon le régi állandó kapcsolatokat a lista megváltozásakor.
Így fog kinézni.
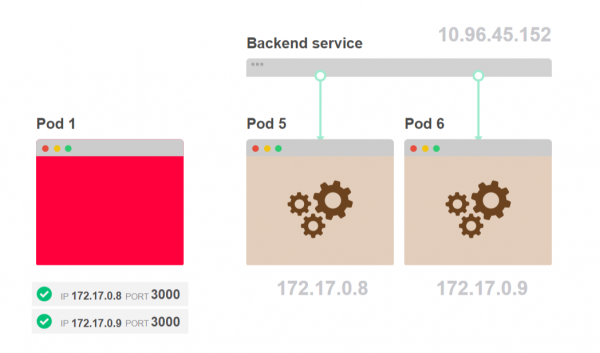
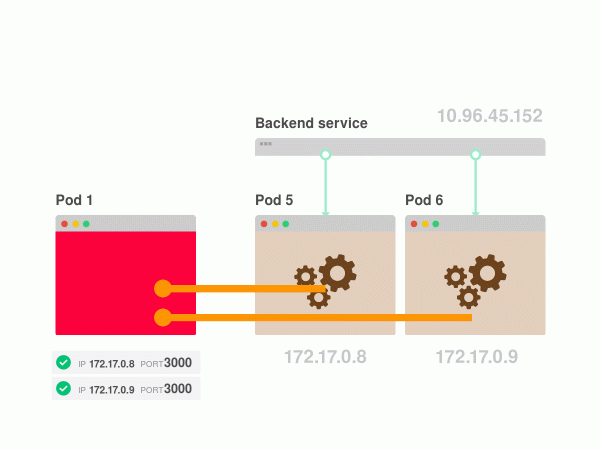
- Ahelyett, hogy az első pod kérést küld a szolgáltatás felé, kiegyenlítheti a kéréseket a kliens oldalán:

- Kódot kell írni, amely megkérdezi, mely podok képezik a szolgáltatás részét:

- Amint megkapja a listát, mentse el azt a kliens oldalán, és használja a podokkal való kapcsolatra:

- Ön felel a forgalomelosztási algoritmusért:
Most felmerül a kérdés: ez a probléma csak a HTTP keep-alive-ra vonatkozik?
Forrásoldali forgalomelosztás
A HTTP nem az egyetlen protokoll, amely állandó TCP-kapcsolatokat használhat.
Ha az alkalmazása adatbázist használ, akkor a TCP-kapcsolat nem nyílik meg minden alkalommal, amikor lekérdezést kell végrehajtania vagy dokumentumot kell kapnia az adatbázisból.
Ehelyett egy állandó TCP-kapcsolatot nyitnak meg és használnak az adatbázishoz.
Ha az adatbázisa Kubernetesben van telepítve, és a hozzáférés szolgáltatás formájában van biztosítva, akkor ugyanezekkel a problémákkal szembesül.
Egy adatbázis-replika jobban leterhelődik, mint a többi. A Kube-proxy és a Kubernetes nem segít a kapcsolatok elosztásában. Önnek kell gondoskodnia az adatbázisához intézett lekérdezések egyensúlyozásáról.
A felhasználni kívánt adatbázis-könyvtár függvényében különböző megoldási lehetőségei lehetnek ennek a problémának.
Íme egy példa a MySQL adatbázis klaszterhez való hozzáférésre Node.js-ből:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* retrieve endpoints from the Service */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Lekérdezéseket futtathat a klaszterezett MySQL adatbázison
Rengeteg más protokoll is létezik, amelyek állandó TCP-kapcsolatokat használnak:
- WebSockets és biztonságos WebSockets
- HTTP/2
- gRPC
- RSockets
- AMQP
Valószínűleg már ismeri a legtöbb ilyen protokollt.
De ha ezek a protokollok olyan népszerűek, miért nincs szabványos megoldás a forgalomelosztásra? Miért szükséges a kliens logikájának megváltozása? Létezik natív megoldás Kubernetesben?
A Kube-proxy és az iptables a legtöbb szabványos felhasználási forgatókönyv lekezelésére készült a Kubernetes telepítésekor. Ezt az egyszerűség miatt tették.
Ha olyan webszolgáltatást használ, amely REST API-t biztosít, Önnek szerencséje van - ebben az esetben nem használnak állandó TCP-kapcsolatokat, bármely Kubernetes-szolgáltatást használhat.
De amint kezd állandó TCP-kapcsolatokat használni, meg kell értenie, hogyan lehet egyenletesen elosztani a terhelést a háttérszolgáltatók között. A Kubernetes nem tartalmaz kész megoldásokat erre az esetre.
Természetesen léteznek olyan lehetőségek, amelyek segíthetnek.
Hosszan tartó kapcsolatok terheléselosztása Kubernetesben
A Kubernetesben négyféle szolgáltatás létezik:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
Az első három szolgáltatás egy virtuális IP-cím alapján működik, amelyet a kube-proxy használ az iptables szabályok létrehozásához. De minden szolgáltatás alapja a headless típusú szolgáltatás.
A headless szolgáltatáshoz nem kapcsolódik IP-cím, és csak a hozzá tartozó podok (végpontok) IP-címének és portjának listáját biztosítja.
Minden szolgáltatás headless szolgáltatáson alapul.
A ClusterIP szolgáltatás egy headless szolgáltatás néhány kiegészítéssel:
- A vezérlési réteg hozzárendel egy IP-címet.
- A kube-proxy létrehozza a szükséges iptables szabályokat.
Így figyelmen kívül hagyhatja a kube-proxy-t, és közvetlenül használhatja a headless szolgáltatásból kapott végpontok listáját a terheléselosztáshoz az alkalmazásában.
De hogyan lehet hasonló logikát hozzáadni az összes, a klaszterben telepített alkalmazáshoz?
Ha az alkalmazása már telepítve van, akkor ez a feladat lehetetlennek tűnhet. Van azonban alternatív megoldás.
A Service Mesh segíthet Önnek.
Valószínűleg észrevette, hogy az ügyfélnézet terheléselosztási stratégiája teljesen standard.
Amikor az alkalmazás elindul, akkor:
- Megkapja a szolgáltatás IP-címeinek listáját.
- Megnyit és fenntart egy kapcsolatfület.
- Időszakonként frissíti a kapcsolatfület, végpontok hozzáadásával vagy eltávolításával.
Amint az alkalmazás kérdést szeretne kezdeményezni, akkor:
- Kiválaszt egy elérhető kapcsolatot valamilyen logika használatával (például körkörös elosztással).
- Végrehajtja a kérdést.
Ezek a lépések ugyanúgy működnek a WebSockets, gRPC és AMQP kapcsolatokra is.
Ezt a logikát külön könyvtárba is kiemelheti, és felhasználhatja az alkalmazásaiban.
De ez helyett használhat szolgáltatási hálózatokat, például Istio vagy Linkerd.
A Service Mesh kiegészíti az alkalmazását egy folyamattal, amely:
- Automatikusan keresi a szolgáltatások IP-címeit.
- Ellenőrzi a kapcsolatokat, például a WebSockets és gRPC esetében.
- Terheli a kéréseket a megfelelő protokoll használatával.
A Service Mesh segít kezelni a forgalmat a klaszteren belül, de meglehetősen erőforrás-igényes. Más lehetőségek között szerepelhet harmadik féltől származó könyvtárak, például a Netflix Ribbon, vagy programozható proxik, például az Envoy használata.
Mi történik, ha figyelmen kívül hagyja a terheléselosztás kérdéseit?
Lehet, hogy nem használ terheléselosztást, és mégsem észlel változásokat. Nézzük meg néhány működési forgatókönyvet.
Ha több ügyfele van, mint szervere, az nem olyan nagy probléma.
Tegyük fel, hogy öt ügyfél csatlakozik két szerverhez. Még ha nincs is terheléselosztás, mindkét szerver használatban lesz:
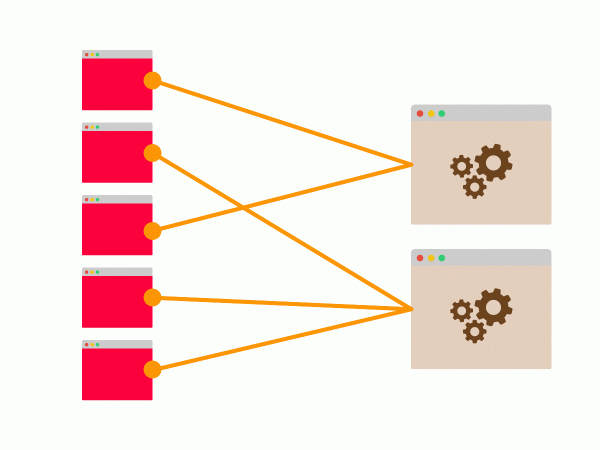
A kapcsolatok egyenlőtlenül is eloszthatók: lehet, hogy négy ügyfél csatlakozik ugyanahhoz a szerverhez, de van jó esély arra, hogy mindkét szerver használt lesz.
Ami problémásabb, az az ellenkező forgatókönyv.
Ha kevesebb ügyfele és több szervere van, az erőforrásai nem biztos, hogy elégségesen kiaknázottak, és potenciális szűk keresztmetszet alakulhat ki.
Tegyük fel, hogy két ügyfél és öt szerver van. A legjobb esetben két állandó kapcsolat lesz két szerverhez az öt közül.
A többi szerver inaktív lesz:
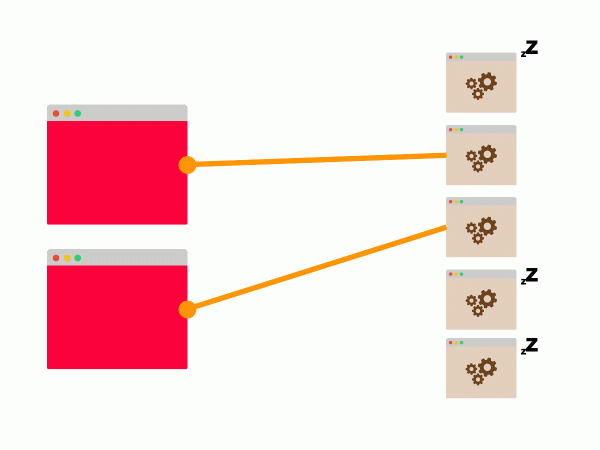
Ha ezek a két szerver nem képesek kezelni az ügyfélek kérésének feldolgozását, a vízszintes skálázás nem fog segíteni.
Zárás
A Kubernetes szolgáltatások a legtöbb szabványos webalkalmazási forgatókönyvben működésre lettek tervezve.
Azonban, ha elkezd alkalmazásprotokollokkal dolgozni, amelyek állandó TCP kapcsolatokra támaszkodnak, mint például adatbázisok, gRPC vagy WebSockets, a szolgáltatások már nem megfelelőek. A Kubernetes nem biztosít belső mechanizmusokat az állandó TCP kapcsolatok terheléselosztására.
Ez azt jelenti, hogy az alkalmazásokat a kliensoldali terheléselosztás lehetőségének figyelembevételével kell megírni.
A fordítást a csapat készítette .
Mit érdemes még olvasni a témában:
- .
- .
- .
Forrás: habr.com
