

A Beszéltünk a Watcher használatára tett kísérletekről, és bemutattuk a tesztelési jelentést. Az ilyen teszteket időről időre elvégezzük a nagyvállalati vagy szolgáltatói felhő kritikus funkcióinak egyensúlyozására.
A megoldandó feladat magas bonyolultsága miatt valószínűleg több cikkre lesz szükség a projektünk leírásához. Ma közzétesszük a ciklus második cikkét, amely a felhőben lévő virtuális gépek egyensúlyozásának szentel.
Néhány terminológia
A VmWare bevezette a DRS (Distributed Resource Scheduler) eszközt a virtuális környezetükben a terhelés egyensúlyozására.
Ahogy írja
„A VMware DRS (Elosztott erőforrás-tervező) egy olyan eszköz, amely a számítási terheket a rendelkezésre álló erőforrásokkal egyensúlyozza a virtuális környezetben. Ez az eszköz része a VMware Infrastructure nevű virtualizációs csomagnak.
A VMware DRS segítségével a felhasználók meghatározzák a fizikai erőforrások elosztásának szabályait a virtuális gépek (VM) között. Az eszköz manuális vagy automatikus vezérlésre állítható be. A VMware erőforrásai könnyen hozzáadhatók, eltávolíthatók vagy átszervezhetők. Ha szükséges, az erőforrás-poolok elkülöníthetők különböző üzleti egységek között. Ha a terhelés egy vagy több virtuális gépen hirtelen változik, a VMware DRS újraelosztja a virtuális gépeket a fizikai szerverek között. Ha az összes terhelés csökken, egyes fizikai szerverek ideiglenesen leállíthatók, és a terhelés konszolidálható.
Miért szükséges az egyensúlyozás?
Véleményünk szerint a DRS kötelező funkció a felhőben, bár ez nem jelenti azt, hogy a DRS-t mindig és mindenhol használni kell. A felhő céljától és igényeitől függően különböző követelmények lehetnek a DRS-re és az egyensúlyozási módszerekre. Lehet, hogy vannak olyan helyzetek, amikor az egyensúlyozás egyáltalán nem szükséges. Vagy akár káros is lehet.
Ahhoz, hogy jobban érthető legyen, hogy hol és milyen ügyfeleknek van szüksége DRS-re, nézzük meg a céljaikat és feladataikat. A felhők nyilvános és magánfelhőkre oszthatók. Íme a legfőbb különbségek e felhők és az ügyfelek céljai között.
Magánfelhők / Nagyvállalati ügyfelek
Nyilvános felhők / Közép- és kisvállalkozások, magánszemélyek
Az üzemeltető fő kritériuma és célja
Megbízható szolgáltatás vagy termék biztosítása
A szolgáltatások költségeinek csökkentése a versenyképes piacon
A szolgáltatás követelményei
Megbízhatóság minden szinten és a rendszer minden elemében
Garantált teljesítmény
A virtuális gépek prioritása több kategóriára
Adatok informatikai és fizikai biztonsága
SLA és 24 órás támogatás
A szolgáltatás megszerzésének maximális egyszerűsége
Viszonylag egyszerű szolgáltatások
Az adatokért a kliens felelős
A virtuális gépek prioritása nem szükséges
Informatikai biztonság az alapvető szolgáltatások szintjén, a felelősség a klienst terheli
Lehetnek leállások
Nincs SLA, a minőség nem garantált
Támogatás e-mailben
A biztonsági mentés nem kötelező
Az ügyfél sajátosságai
Nagyon széles spektrumú alkalmazások.
Örökölt alkalmazások a cégen belül.
Bonyolult, testreszabott architektúrák minden egyes ügyfél számára.
Affinitás szabályok.
A szoftver folyamatos működése 7x24 módban.
Azonnali biztonsági mentési eszközök.
Előrejelezhető ciklikus terhelés a kliens részéről.
Alapvető alkalmazások – hálózat egyensúlyozás, Apache, WEB, VPN, SQL
Az alkalmazás bizonyos időre leállítható
A virtuális gépek szabad elosztása a felhőben engedélyezett
A biztonsági mentés a kliens feladata
Előrejelezhető átlagos terhelés nagy számú ügyfél esetén.
Következmények az architektúrára
Geoklaszterezés
Központosított vagy elosztott tárolórendszer
Fenntartható SRK
Helyi adatraktározás a számítógépes csomópontokon
Az egyensúlyozás céljai
Terhelés egyenletes elosztása
Maximális alkalmazás-reakcióidő
Minimális késlekedés az egyensúlyozás során
Csak nyilvánvaló szükségesség esetén történik az egyensúlyozás
Egyes eszközök kivonása karbantartásra
A szolgáltatás és az üzemeltető költségeinek csökkentése
Egyes erőforrások leállítása alacsony terheltség esetén
Villamosenergia-megtakarítás
A személyzet költségeinek csökkentése
A következő következtetéseket vonjuk le magunk számára:
Privát felhők esetén, amelyeket nagy vállalati megrendelőknek kínálnak, a DRS alkalmazható a következő korlátozások figyelembevételével:
- informatikai biztonság és az affinitás szabályainak figyelembe vétele az egyensúlyozás során;
- elbírálva, hogy elég erőforrás álljon rendelkezésre vészhelyzet esetén;
- a virtuális gépek adatai egy központosított vagy elosztott tárolórendszerben találhatók;
- az adminisztrációs, biztonsági mentési és terheléselosztási eljárások időbeli eltolása;
- terheléselosztás csak a kliens gazdagépeinek aggregátumán belül;
- terheléselosztás csak jelentős terheléseltolódás esetén, a legbiztonságosabb és leghatékonyabb virtuális gépek migrációja (a migráció akár kudarcot is vallhat);
- terheléselosztás a 'nyugodt' virtuális gépek figyelembevételével (a 'zajos' virtuális gépek migrációja nagyon hosszú ideig tarthat);
- terheléselosztás a 'költség' figyelembevételével - terhelés a tárolórendszeren és a hálózaton (nagy ügyfelek egyedi architektúrái esetén);
- terheléselosztás a virtuális gépek egyedi viselkedési jellemzői figyelembevételével;
- terheléselosztás lehetőleg munkaidőn kívül (éjjel, hétvégén, ünnepeken).
Nyilvános felhők esetén, amelyek kis megrendelőknek nyújtanak szolgáltatásokat, a DRS sokkal gyakrabban alkalmazható, kibővített lehetőségekkel:
- az információbiztonsági és affinitási szabályok hiánya;
- terheléselosztás a felhőn belül;
- terheléselosztás bármilyen ésszerű időben;
- terheléselosztás bármely virtuális gépre;
- terheléselosztás a 'zajos' virtuális gépek esetén (hogy ne zavarja a többieket);
- a virtuális gépek adatai gyakran helyi lemezeken találhatóak;
- a tárolórendszer és a hálózat átlagos teljesítményének figyelembevételével (a felhő architektúrája egységes);
- terheléselosztás általános szabályok és a folyamatközpontú statisztikák alapján.
A probléma összetettsége
A terheléselosztás összetettsége abban rejlik, hogy a DRS-nek sok bizonytalan tényezővel kell foglalkoznia:
- az ügyfelek informatikai rendszereinek felhasználói viselkedése;
- az informatikai rendszerek szervereinek működési algoritmusai;
- az adatbázis-kezelő szerverek viselkedése;
- a számítási erőforrásokra, tárolórendszerekre és hálózatra vonatkozó terhelések;
- a szerverek közötti kölcsönhatás a felhő erőforrásaiért folytatott verseny során.
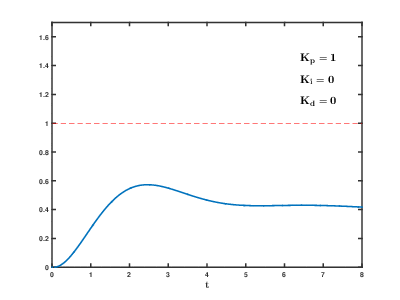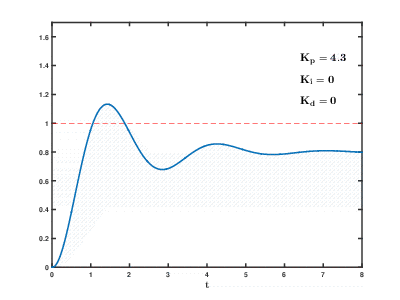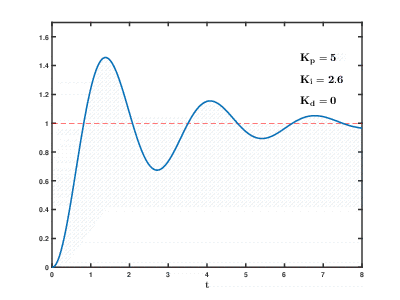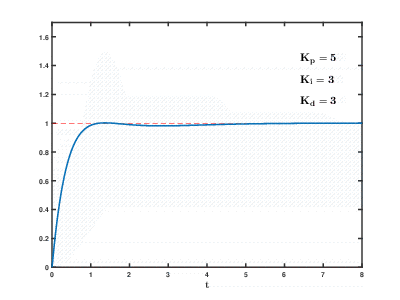
A virtuális alkalmazásszerverek és adatbázisok nagy számú terhelése az erőforrásokra időben terjed, a következmények előre nem látható módon jelentkezhetnek és egymásra rakódhatnak, kiszámíthatatlan hatással, kiszámíthatatlan időn belül. Még a viszonylag egyszerű folyamatok (például egy motor, vagy a ház vízmelegítő rendszerének irányítása) kezeléséhez is összetett visszajelzési algoritmusokat kell alkalmazni.
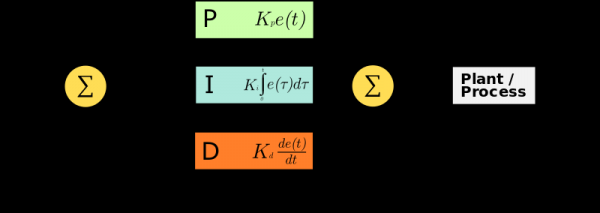
Feladatunk sokkal bonyolultabb, és fennáll a kockázata, hogy a rendszer ésszerű időn belül nem tudja a terheléselosztást a stabil értékekre végezni, még akkor sem, ha nincsenek külső hatások a felhasználók részéről.
Fejlesztéseink története
A probléma megoldása érdekében úgy döntöttünk, hogy nem kezdünk mindent elölről, hanem a meglévő tapasztalatokra támaszkodva működünk együtt a területen tapasztalattal rendelkező szakemberekkel. Szerencsére a probléma megértése teljes mértékben egybeesett velünk.
1. lépés
Olyan rendszert használtunk, amely a neurális hálózatok technológiáján alapul, és próbáltuk optimalizálni erőforrásainkat ezzel.
A szakasz érdekessége az új technológia kipróbálásában rejlett, míg fontossága abban, hogy nem szokványos megközelítést alkalmaztunk a probléma megoldására, ahol egyébként a standard megközelítések szinte kimerültek.
Elindítottuk a rendszert, és tényleg működésbe lépett a terheléselosztás. A felhőnk mérete nem tette lehetővé, hogy optimista eredményeket érjünk el, amiket a fejlesztők ígértek, de látható volt, hogy a terheléselosztás működik.
Ebben a folyamatban voltak komoly korlátaink:
- A neurális háló tanítása érdekében a virtuális gépeknek jelentős változtatások nélkül kell működniük hetekig vagy hónapokig.
- Az algoritmus az korábbi "történeti" adatokra épülő optimalizálásra van tervezve.
- A neurális háló tanulásához elegendő mennyiségű adat és számítási erőforrás szükséges.
- Az optimalizálás és terheléselosztás viszonylag ritkán – néhány óránként végezhető, ami nyilvánvalóan nem elegendő.
2. lépés
Mivel az állapotunk nem volt kielégítő, úgy döntöttünk, hogy módosítjuk a rendszert, és ehhez meg kell válaszolnunk a fő kérdést – kinek készítjük ezt?
Elsődlegesen – vállalati ügyfeleknek. Tehát olyan rendszerre van szükségünk, amely gyorsan működik, azokkal a vállalati korlátokkal, amelyek csak megkönnyítik a megvalósítást.
A második kérdés – mit értsünk „gyorsan” alatt? Rövid viták után úgy döntöttünk, hogy a 5-10 perces válaszidővel érdemes kiindulni, hogy a rövid távú ugrások ne indítsák el a rendszert rezonanciába.
Harmadik kérdés – milyen méretű szerverek kiegyenlítendő mennyiségét válasszuk ki?
Ez a kérdés magától megoldódott. Általában a kliensek nem teszik túl nagyra a szerveraggregátumokat, és ez összhangban van a cikk ajánlásaival, miszerint 30-40 szerverre érdemes korlátozni az aggregátumokat.
Ezenkívül a szerverek tömbjének szegmentálásával egyszerűsítjük a terheléselosztó algoritmus feladatát.
Negyedik kérdés – mennyire alkalmas számunkra a neurális hálózat a hosszú tanulási folyamatával és a ritka egyensúlyozásokkal? Döntöttünk arról, hogy lemondunk róla, és egyszerűbb operatív algoritmusok mellett tettük le a voksunkat, hogy másodpercek alatt eredményt kapjunk.
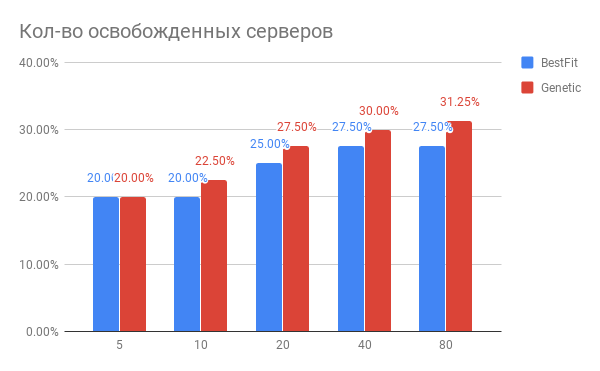
A rendszerről, amely ilyen algoritmusokat használ, és az azokkal kapcsolatos hátrányokról itt tájékozódhat.
Megvalósítottuk és elindítottuk ezt a rendszert, és biztató eredményeket kaptunk – most rendszeresen elemzi a felhő terhelését, és javaslatokat ad a virtuális gépek áthelyezésére, amelyek nagyrészt helyesek. Még most is látszik, hogy 10-15%-os erőforrás-kibocsátást érhetünk el új virtuális gépek számára, miközben javul a meglévők teljesítménye.
A RAM vagy CPU egyensúlytalanságának észlelésekor a rendszer parancsokat ad a Tionix ütemezőnek a szükséges virtuális gépek élő migrációjának végrehajtására. A megfigyelőrendszerből látható, hogy a virtuális gép egyik (felső) gazdagépről a másikra (alsó) költözött, és felszabadította a memóriát a felső gazdagépen (sárga körökkel kiemelve), miközben azt az alsó gazdagépen foglalta el (fehér körökkel kiemelve).
Jelenleg arra törekszünk, hogy pontosabban felmérjük a folyamatban lévő algoritmus hatékonyságát, és megpróbáljuk megtalálni benne a lehetséges hibákat.
3. lépés
Úgy tűnik, ezen lehetne pihenni, várni a bizonyított hatékonyságra, és lezárni a témát.
De a következő nyilvánvaló optimalizálási lehetőségek arra ösztönöznek minket, hogy új szakaszra lépjünk.
- A statisztika például és azt mutatja, hogy a kétrészes és négy részes rendszerek teljesítménye lényegesen alacsonyabb az egyrészesekénél. Ezért minden felhasználó sokkal kisebb teljesítményt kap a többszörös rendszerekben vásárolt CPU, RAM, SSD, LAN, FC eszközöktől, összehasonlítva az egyrészesekkel.
- Maguk az erőforrás-ütemezők súlyos hibákkal dolgozhatnak, erről a témáról.
- Az Intel és az AMD által ajánlott RAM- és cache-monitoring technológiák lehetővé teszik a virtuális gépek viselkedésének tanulmányozását és elhelyezésüket úgy, hogy a 'zajos' szomszédok ne zavarják a 'csendes' virtuális gépeket.
- A paraméterek halmazának bővítése (hálózat, tárolórendszer, virtuális gép prioritása, migrációs költség, a migrációra való felkészültsége).
Összesen
Munkánk eredményeként a terheléselosztó algoritmusok tökéletesítésében egyértelmű következtetést vontunk le: a modern algoritmusok jelentős optimalizációt (25-30%) érhetnek el az adatközpontok erőforrásaiban és egyúttal javíthatják a szolgáltatás minőségét.
A neurális hálózatokon alapuló algoritmus kétségtelenül érdekes, de további fejlesztést igénylő megoldás, és a meglévő korlátok miatt nem alkalmas az ilyen feladatok megoldására a magánfelhők jellegzetes volumenein. Ugyanakkor a jelentős méretű nyilvános felhőkben az algoritmus jónak bizonyult.
Részletesebben a processzorok, ütemezők és magas szintű terheléselosztás lehetőségeiről a következő cikkekben fogunk beszélni.
Forrás: habr.com
