

KDB+, a cég terméke — egy széles körben elismert, kivételesen gyors oszlopalapú adatbázis, amelyet időbeli sorok és azok alapján végzett analitikai számítások tárolására terveztek. Eredetileg nagy népszerűségnek örvendett a pénzügyi iparban — a legjobb 10 befektetési bank és számos ismert hedge fund, tőzsdék és egyéb szervezetek használják. Az utóbbi időben a KX bővíteni kívánta ügyfélkörét, és most más területeken is kínál megoldásokat, ahol nagy mennyiségű időben vagy más módon rendezett adat található — telekommunikáció, bioinformatika, gyártás stb. Ezek között partnerséget alakítottak ki az Aston Martin Red Bull Racing csapatával a Forma-1-ben, ahol segítenek az autók érzékelőiből származó adatok gyűjtésében és feldolgozásában, valamint az aerodinamikai csőtesztek elemzésében. Ebben a cikkben szeretném bemutatni, hogy milyen tulajdonságokkal rendelkezik a KDB+, ami szuperhatékonnyá teszi, miért hajlandók a cégek nagy összegeket költeni rá, és végül, hogy miért nem is adatbázis valójában.
Ebben a cikkben megpróbálom összefoglalni, hogy mit jelent a KDB+, milyen lehetőségei és korlátai vannak, és hogyan segíthet a nagy mennyiségű adat feldolgozására vágyó cégek számára. Nem kívánok a KDB+ megvalósításának részleteibe és a Q programozási nyelvének részleteibe belemenni. Ezek a témák nagyon kiterjedtek, és külön cikket érdemelnek. Sok információt találhat ezekről a témákról a code.kx.com weboldalon is, beleértve a Q-ról szóló könyvet is — Q For Mortals (lásd az alábbi linket).
Néhány kifejezés
- Memóriában lévő adatbázis. Olyan adatbázis, amely az adatokat a RAM-ban tárolja, hogy felgyorsítsa a hozzáférést. Az ilyen típusú adatbázis előnyei nyilvánvalóak, a hátrányai viszont a potenciális adatvesztés, valamint a szerveren nagymennyiségű memória szükségessége.
- Oszlopalapú adatbázis. Olyan adatbázis, ahol az adatok oszloponként, nem pedig rekordonként vannak tárolva. Az ilyen típusú adatbázis fő előnye, hogy egy oszlop adatai együtt tárolódnak a lemezen és a memóriában, ami jelentősen felgyorsítja a hozzáférést. Nincs szükség a lekérdezésben nem használt oszlopok betöltésére. Fő hátránya, hogy nehéz módosítani és törölni a rekordokat.
- Időbeli sor. Dátum- vagy időtípusú adatok. Általában az ilyen adatoknál fontos a temporális sorrend, hogy könnyen meg lehessen határozni, hogy egy adott rekord megelőzi vagy követi a jelenlegit, vagy hogy olyan funkciókat alkalmazzunk, amelyek eredménye a rekordok sorrendjétől függ. A klasszikus adatbázisok teljesen más elven alapulnak - egy halmazként kezelik a rekordok összességét, ahol a rekordok sorrendje alapvetően nem meghatározott.
- Vektor. A KDB+ kontextusában - ez egy elemekből álló lista, amely az atomáris típusok egyikét képviseli, például számokat. Más szavakkal, az elemek tömbje. A tömbök, ellentétben a listákkal, tömören tárolhatók és feldolgozhatók a processzor vektori utasításaival.
Történelmi háttér
A KX társaságot 1993-ban alapította Arthur Whitney, aki korábban a Morgan Stanley banknál dolgozott az A+ nyelven, amely az APL örököse - egy nagyon eredeti és egykor népszerű nyelv a pénzügyi világban. Természetesen a KX-nál Arthur azonos szellemiségben folytatta, és létrehozta a vektor-funkcionális K nyelvet, a radikális minimalizmus ötleteit követve. A K nyelven írt programok látszólag kaotikus írásjelek és speciális szimbólumok halmazai, a szimbólumok és funkciók jelentése a kontextustól függ, és minden művelet sokkal nagyobb jelentőséggel bír, mint a hagyományos programozási nyelvekben. Ennek köszönhetően egy K nyelvű program a lehető legkevesebb helyet foglalja el - néhány sor helyettesíthet szövegoldalak hosszú nyelveken, mint például a Java -, és a algoritmusok rendkívül tömör megvalósítását jelenti.
K nyelvű függvény, amely megvalósítja az LL1 parser generátorának legnagyobb részét a megadott nyelvtan alapján:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/;1_r),"]";""]]}
Arthur is embodied this philosophy of extreme efficiency with minimal movement also in KDB+, which appeared in 2003 (I think it’s now clear where the letter K in the name comes from) and is nothing more than an interpreter of the fourth version of the K language. Over K, a more visually appealing version called Q has been added. Q also includes support for a specific SQL dialect — QSQL, along with support for tables as a system data type, tools for working with tables in memory and on disk, etc.
Thus, from a user's point of view, KDB+ is simply a Q language interpreter with table support and SQL-like expressions in LINQ style from C#. This is the key difference of KDB+ from other databases and its main competitive advantage, which is often overlooked. It is not a database + a supporting crippled language, but a full-fledged powerful programming language + built-in database function support. This distinction will play a decisive role when listing all the advantages of KDB+. For example…
Méret
By modern standards, KDB+ has a microscopic size. It literally consists of a single executable file smaller than one megabyte and one small text file containing some system functions. In reality, it is less than one megabyte, and companies pay tens of thousands of dollars a year for one processor on the server for this program.
- Such a size allows KDB+ to perform excellently on any hardware — from a Pi microcomputer to servers with terabytes of memory. This does not affect functionality; moreover, Q starts instantaneously, which allows it to be used as a scripting language as well.
- With such a size, the Q interpreter completely fits into the processor cache, speeding up program execution.
- With such a size of the executable file, the Q process takes an insignificant amount of space in memory, and it can be launched in hundreds. At the same time, if necessary, Q can operate with dozens or hundreds of gigabytes of memory within a single process.
Univerzalitás
A Q tökéletesen alkalmas a legkülönbözőbb feladatokhoz. A Q folyamat történeti adatbázisként működhet, és gyors hozzáférést biztosít terabájt adatainkhoz. Például több történeti adatbázisunk van, amelyek közül néhányban egy tömörítetlen napi adat több mint 100 gigabájtot foglal el. Ennek ellenére ésszerű korlátok mellett a lekérdezések több tucat, akár száz milliszekundum alatt is végrehajthatók. Általánosságban a felhasználói lekérdezésekhez egy univerzális időkorlátot állítottunk be — 30 másodperc — és ez nagyon ritkán lép életbe.
Ugyanolyan könnyedséggel a Q lehet in-memory adatbázis is. Az új adatok memória-táblákhoz való hozzáadása olyan gyorsan történik, hogy a korlátozó tényező a felhasználói lekérdezések sebessége. Az adatok a táblákban oszlopok szerint tárolódnak, így bármely oszlopművelet maximálisan kihasználja a processzor gyorsítótárát. Ezen kívül a KX megpróbálta megvalósítani az összes alapvető műveletet, mint például az aritmetikai műveletek, processzor vektorinstrukcióival, maximalizálva azok sebességét. A Q képes olyan feladatokat is végrehajtani, amelyek nem jellemzők az adatbázisokra — például feldolgozni a folyamatos adatokat és
Végül a Q-n bárminemű szolgáltatási folyamatokat is lehet írni. Például Gateway folyamatok, amelyek automatikusan elosztják a felhasználói lekérdezéseket a szükséges adatbázisok és szerverek között. A programozó teljes szabadsággal rendelkezik bármilyen algoritmus megvalósítására a terheléselosztás, priorizálás, hibatűrés, hozzáférési jogok, kvóták és akármi más tekintetében. A fő probléma itt az, hogy mindezt magának kell megvalósítania.
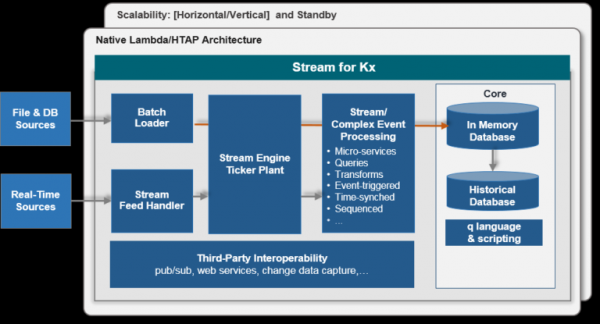
Például felsorolom, milyen típusú folyamatokkal rendelkezünk. Mindegyik aktívan használatban van, együttműködik, és egyesítve van tucatnyi különböző adatbázist, több forrásból feldolgozva az adatokat, és kiszolgálva százakat felhasználók és alkalmazások.
- Adatforrásokhoz (feedhandler) kapcsolódó csatlakozók. Ezek a folyamatok jellemzően külső könyvtárakat használnak, amelyeket a Q-ban töltenek be. A Q C interfésze rendkívül egyszerű, és lehetővé teszi, hogy könnyedén proxy függvényeket hozzunk létre bármilyen C/C++ könyvtárhoz. A Q elég gyors ahhoz, hogy például egyszerre kezelje az összes európai tőzsdéről érkező FIX üzenetáramot.
- Adatelosztók (tickerplant), amelyek köztes linkként működnek a csatlakozók és a fogyasztók között. Ezen kívül rögzítik a bejövő adatokat egy speciális bináris naplóban, biztosítva, hogy a fogyasztók stabilan hozzáférjenek az adatokhoz, még akkor is, ha a kapcsolat megszakad vagy újraindításra kerül.
- Memóriában tárolt adatbázisok (rdb). Ezek az adatbázisok a lehető leggyorsabb hozzáférést biztosítják a friss nyers adatokhoz, tartva őket a memóriában. Jellemzően napközben gyűjtik az adatokat táblázatokba, és éjszaka nullázzák azokat.
- Tartós adatbázisok (pdb). Ezek az adatbázisok a mai nap során gyűjtött adatokat történeti adatbázisba mentik. Jellemzően, ellentétben az rdb-vel, nem tárolják az adatokat a memóriában, hanem egy speciális lemezes gyorsítótárat használnak a nap folyamán, és éjfélkor átmásolják az adatokat a történeti adatbázisba.
- Történeti adatbázisok (hdb). Ezek az adatbázisok hozzáférést biztosítanak az előző napok, hónapok és évek adataihoz. Méretük (napokban) csak a merevlemezek méretével van korlátozva. Az adatok bárhol elhelyezhetők, különösen különböző lemezeken a hozzáférés felgyorsítása érdekében. Lehetséges az adatok tömörítése, választható algoritmusok segítségével. Az adatbázis struktúrája jól dokumentált és egyszerű, az adatok szakaszosan, normál fájlokban vannak tárolva, így azokat az operációs rendszer eszközeivel is lehet kezelni.
- Aggregált információs adatbázisok. Különböző aggregációkat tárolnak, jellemzően az eszköz neve és az időintervallum szerint csoportosítva. A memóriában tárolt adatbázisok frissítik állapotukat minden bejövő üzenetnél, míg a történeti adatbázisok előre kiszámított adatokat tárolnak a történeti adatokhoz való gyors hozzáférés érdekében.
- Végül, gateway folyamatok, alkalmazások és felhasználók kiszolgálására. A Q lehetővé teszi a bejövő üzenetek teljesen aszinkron feldolgozását, elosztását az adatbázisok között, a hozzáférési jogok ellenőrzését stb. Megjegyzem, hogy az üzenetek nem korlátozódnak, és a legtöbbször nem SQL kifejezések, ahogy más adatbázisokban szokás. Legtöbbször az SQL kifejezés egy speciális funkcióban rejtőzik, és a felhasználó által kért paraméterek alapján kerül megépítésre – időkonverzió történik, szűrés, az adatok normalizálása (például a részvények ára kiigazításra kerül, ha osztalékfizetés történt) stb.
Tipikus architektúra egy adat típusa számára:
Sebesség
Bár a Q egy értelmezett nyelv, egyben vektoralapú nyelv is. Ez azt jelenti, hogy sok beépített funkció, így a matematikai műveletek is, bármilyen formájú argumentumokat elfogadnak – számokat, vektorokat, mátrixokat, listákat, és a programozótól elvárják, hogy a programot tömbműveletekként valósítsa meg. Egy ilyen nyelvben, ha két vektort adsz össze egymillió elemmel, már nem számít, hogy a nyelv értelmezett, az összeadás egy szuperoptimalizált bináris funkcióval történik. Mivel a Q programok időtartamának jelentős része táblákon végzett műveletekre megy el, amelyek ezeket az alapvető vektorizált funkciókat használják, az eredmény egy meglehetősen tisztességes sebesség, amely lehetővé teszi hatalmas adatmennyiségek feldolgozását még egyetlen folyamatban is. Ez hasonló a Python matematikai könyvtáraihoz – bár maga a Python nem egy túl gyors nyelv, sok nagyszerű könyvtára van, mint a numpy, amelyek lehetővé teszik a numerikus adatok feldolgozását egy lefordított nyelv sebességén (mellesleg a numpy ideológiailag közel áll a Q-hoz).
A KX nagyon alaposan megtervezte a táblákat és az azokkal való munkát. Először is, többféle indexet támogat, amelyeket a beépített funkciók támogatnak, és amelyek alkalmazhatók nemcsak a táblák oszlopaira, hanem bármilyen vektorra — csoportosítás, rendezés, egyediségi attribútum és speciális csoportosítás a történeti adatbázisok számára. Az indexek elemi módon alkalmazhatók, és automatikusan módosulnak, amikor elemeket adunk hozzá egy oszlophoz/vektorhoz. Az indexek egyaránt sikeresen alkalmazhatók a táblák oszlopaira, akár memóriában, akár lemezen. A QSQL lekérdezés végrehajtásakor az indexek automatikusan használatra kerülnek, ha ez lehetséges. Másodszor, a történeti adatokkal való munka a fájlok OS mappa mechanizmusának segítségével történik. A nagy táblák sohasem kerülnek betöltésre a memóriába, ehelyett a szükséges oszlopok közvetlenül a memóriába vannak leképezve, és csak az a részük töltődik be, amely valóban szükséges (ebben az indexek is segítenek). A programozó számára nincs különbség abban, hogy az adatok a memóriában vannak-e, vagy sem; a mmap mechanizmusa teljesen el van rejtve a Q belső részeiben.
A KDB+ nem relációs adatbázis, a táblák tetszőleges adatokat tartalmazhatnak, miközben a táblában lévő sorok sorrendje nem változik új elemek hozzáadása során, és ezt a sorrendet használni kell a lekérdezések írásakor. Ez a tulajdonság kulcsfontosságú a időbeli sorozatokkal való munkához (tőzsdei adatok, telemetria, eseménynaplók), mert ha az adatok idő szerint vannak rendezve, a felhasználónak nem kell semmilyen SQL trükköt alkalmaznia, hogy megtalálja a táblában az első vagy utolsó időpontú sort, vagy N sort, valamint meghatározza, hogy melyik sor követi az N-edik sort stb. A táblák összekapcsolása is jelentősen egyszerűbbé válik; például a 16000 VOD.L (Vodafone) ügylet legutolsó árajánlatának keresése egy 500 millió elemű táblában körülbelül egy másodpercet vesz igénybe lemezen, és néhány milliszekundumot memóriában.
Például az idő szerinti összekapcsolás — a quote táblázat memóriába van leképezve, ezért nem szükséges megadni a VOD.L-t a WHERE záradékban; a sym oszlopon lévő index és az, hogy az adatok idő szerint rendezettek, automatikusan figyelembe vannak véve. Szinte minden összekapcsolás a Q-ban szokásos funkciók, nem pedig a SELECT kifejezés részei:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Végül említést érdemel, hogy a KX mérnökei, kezdve Arthur Whitney-val, valójában meg vannak őrülve a hatékonyságért, és mindent megtesznek annak érdekében, hogy a Q alapfunkcióiból a lehető legtöbbet hozzák ki, és optimalizálják a leggyakoribb használati mintákat.
Result
A KDB+ elsődlegesen a kivételes sokoldalúsága miatt népszerű a vállalkozások körében — egyaránt jól szolgál in-memory adatbázisként, terabájt összehasonlító történeti adatok tárolójaként és adat-analízis platformként. Az adatkezelés közvetlenül az adatbázisban történik, melynek következtében a munkafolyamatok gyorsak és erőforrás-takarékosak. A programozási nyelv, amely be van építve az adatbázis funkcióival, lehetővé teszi az összes szükséges folyamat végrehajtását egy platformon — az adatok megnyerésétől kezdve a felhasználói kérdések feldolgozásáig.
További információk
Hátrányok
A KDB+/Q jelentős hátránya a magas belépési küszöb. A nyelvnek furcsa a szintaxisa, egyes funkciói túlságosan overloadozottak (például a value körülbelül 11 különböző felhasználási változattal bír). A legfontosabb, hogy radikálisan más megközelítést igényel a programok írásához. A vektori nyelvben folyamatosan az array-ek transzformációi formájában kell gondolkodni, és az összes ciklust a map/reduce funkciók (amelyeket a Q-ban adverbenek neveznek) különböző típusain keresztül kell megvalósítani — soha nem szabad megpróbálni spórolni az atomic műveletek vektoros műveletekre való cserélésével. Például, hogy megtaláljuk az N-edik előfordulás indexét egy array-ben, ezt kell írni:
1. (where element=vector)[N]
bár ez rémisztően hatékonytalanul hangzik a C/Java mércéje szerint (= létrehoz egy boolean vektort, ahol a where az igaz elemek indexeit adja vissza). De ez a felírás segít világosabbá tenni a kifejezés értelmét, és gyors vektori műveleteket használ, a lassú atomicok helyett. A koncepcionális különbség a vektori nyelv és a többi között hasonlítható az imperatív és funkcionális programozási megközelítések közötti különbséghez, és erre fel kell készülni.
Néhány felhasználó elégedetlen a QSQL-lal. Az a helyzet, hogy ez csak hasonlít a valódi SQL-re. Valójában csupán egy SQL-szerű kifejezések értelmezője, amely nem támogatja a lekérdezések optimalizálását. A felhasználónak magának kell optimalizált lekérdezéseket írnia, méghozzá Q nyelven, amelyhez sokan nem készülnek fel. Másrészről természetesen mindig írhatunk magunk is egy optimalizált lekérdezést, ahelyett, hogy egy fekete doboz optimalizálóra bíznánk magunkat.
A Q nyelvről szóló könyv, a Q For Mortals ingyenesen elérhető a , emellett sok más hasznos anyag is található ott.
Egy másik nagy hátrány a licenc költsége. Ez évi több tízezer dollár egy CPU-ért. Csak nagy cégek engedhetik meg maguknak az ilyen kiadásokat. Az utóbbi időben a KX rugalmasabbá tette a licencpolitikáját, és lehetőséget kínál, hogy csak a használati időt kelljen fizetni, vagy a KDB+ kölcsönzésére a Google és az Amazon felhőiben. A KX emellett letölthetővé kínálja (32 bites verzió vagy 64 bites kérésre).
Versenytársak
Számos olyan speciális adatbázis létezik, amelyek hasonló elvek alapján épültek fel – oszlop-orientált, in-memory, nagyon nagy adatmennyiségekre optimalizált. A probléma az, hogy ezek kifejezetten speciális adatbázisok. A Clickhouse egy ékes példa. Ennek az adatbázisnak nagyon hasonló a KDB+ -hoz a fájlba történő adatok tárolására és az indexépítésre vonatkozó elve. Néhány lekérdezést gyorsabban hajt végre, mint a KDB+, bár nem lényegesen. De még mint adatbázis a Clickhouse specializáltabb, mint a KDB+ – webanalitika szemben az önkényes idősortársakkal (ez a különbség nagyon fontos – emiatt például a Clickhouse-ban nincs lehetőség a rekordok sorrendjének használatára). De a legfontosabb, hogy a Clickhouse-nak nincs a KDB+ univerzális jellege, amely lehetővé tenné az adatok közvetlen feldolgozását az adatbázisban anélkül, hogy először külön alkalmazásba töltenénk be őket, önkényes SQL kifejezések létrehozását, önkényes funkciók alkalmazását a lekérdezésben, és olyan folyamatok létrehozását, amelyek nem kapcsolódnak a történeti adatbázis funkcióinak végrehajtásához. Ezért nehéz összehasonlítani a KDB+ -ot más adatbázisokkal; azok jobbak lehetnek különböző használati forgatókönyvekben, vagy egyszerűen jobbak, ha klasszikus adatbázisok feladatáról van szó, de nekem nem ismert más olyan hatékony és sokoldalú eszköz az időalapú adatok feldolgozására, mint a KDB+.
Integráció Python-nal
A KDB+ használatának leegyszerűsítése érdekében, azok számára, akik nincsenek tisztában a technológiával, a KX könyvtárakat hozott létre a Python-nal való szoros integrációra egyetlen folyamat keretein belül. Lehetőség van bármely Python-funkciót hívni a Q-ból, és fordítva – bármely Q-funkciót a Python-ból (különösen QSQL kifejezéseket). A könyvtárak szükség esetén (hatékonysági okokból nem mindig) konvertálják az adatokat az egyik nyelv formátumáról a másikra. Ennek eredményeként a Q és a Python olyan szoros szimbiózisban élnek, hogy a határok közöttük elmosódnak. Ennek eredményeképpen a programozónak, egyrészt, teljes hozzáférése van a számos hasznos Python könyvtárhoz, másrészt egy integrált, Python-ba ágyazott gyors adatbázist kap, amely nagy adatokkal való munkához különösen hasznos az adatmérnökséggel vagy modellezéssel foglalkozók számára.
Q használata Python-ban:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Hivatkozások
A cég weboldala —
Fejlesztői weboldal —
A Q For Mortals könyv (angol nyelven) —
Cikkek a KDB+ / Q alkalmazásáról a kx munkatársaitól —
Forrás: habr.com
