

Sikeresen megterveztük a PostgreSQL adatbázisunk felépítését a levelezés tárolására, eltelt egy év, a felhasználók aktívan töltik fel, már több millió bejegyzést tartalmaz., és... valami kezd el akadozni.
- 2. rész: élő szekcionálás
A dolog az, hogy a táblák méretének növekedésével nő az indexek "mélysége" is — bár logaritmikusan. De idővel ez arra kényszeríti a szervert, hogy ugyanazokhoz a read/write feladatokhoz sokkal több adatoldalt dolgozzon fel, mint kezdetben.
Itt jön a képbe a szekcionálás..
Megjegyzem, hogy nem a shardingról beszélünk, ami azt jelenti, hogy az adatokat különböző adatbázisok vagy szerverek között osztjuk el. Mert még ha el is osztja az adatokat több szerverek között, akkor sem tudja megszüntetni az "indexek felfúvódásának" problémáját az idő múlásával. Nyilvánvaló, hogy ha megengedheti magának, hogy minden nap új szervert állítson üzembe, akkor a problémái már nem a konkrét adatbázis dimenziójában vannak.
Mi nem konkrét szkripteket fogunk megvizsgálni a "hardveren" történő szekcionálás végrehajtására, hanem magát az megközelítést — hogy mit és hogyan érdemes "szeletekre vágni", és ez a vágy hova vezet.
Koncept
Még egyszer határozzuk meg a célunkat: azt szeretnénk, hogy ma, holnap, és egy év múlva is a PostgreSQL adatok olvasási művelet során bármikor körülbelül azonos mennyiségben maradjanak.
Bármilyen kronológiailag halmozott adatok (üzenetek, dokumentumok, naplók, archívumok, …) a szekcionálás kulcsként természetes választásként a esemény időpontja. A mi esetünkben az esemény az üzenet elküldési időpontja..
Megjegyezzük, hogy a felhasználók szinte mindig csak a "legfrissebb" adatokkal dolgoznak — a legújabb üzeneteket olvassák, a legújabb naplókat elemzik,… Nem, természetesen visszasorolhatnak az időben, de ezt nagyon ritkán teszik.
Ezekből a korlátozásokból nyilvánvaló, hogy az üzenetek esetében az optimális megoldás a "napi" szekciók — hiszen szinte mindig a felhasználók azt olvassák, ami "ma" vagy "tegnap" érkezett.
Ha a nap folyamán szinte csak egy szekcióban írunk és olvasunk, az még hatékonyabb memória- és lemezhasználatot is eredményez. — mivel az összes szekció indexe kényelmesen elfér a RAM-ban, ellentétben a "nagy és vaskos" táblázattal.
lépésről lépésre
Összességében az előzőek egy folyamatos profitnak hangzanak. És elérhető, de ehhez jól kell dolgoznunk — mert egy entitás szekcionálása szükségessé teszi a hozzá kapcsolódó "darabolást" is.
Az üzenet, annak tulajdonságai és vetületei
Mivel úgy döntöttünk, hogy az üzeneteket dátum szerint szétszedjük, az azokhoz kapcsolódó entitásokat-tulajdonságokat (mellékletek, címzett lista) is érdemes szétválasztani, és szintén az üzenet dátuma szerint.
Mivel az egyik tipikus feladatunk a levelezési nyilvántartások (nem olvasott, bejövő, mindent) megtekintése, ezért ezeket is logikusan "be kell vonni" az üzenetek dátum szerinti szekciónálásába.
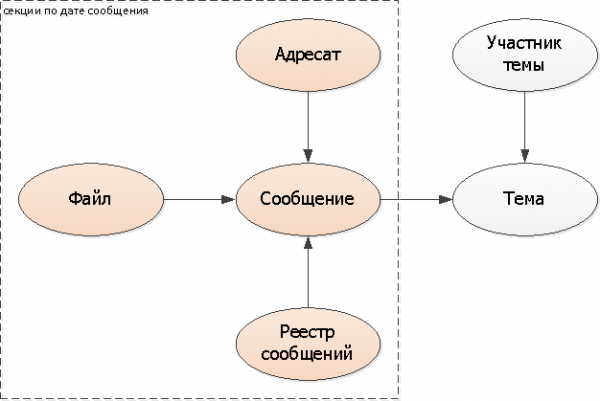
Hozzáadjuk a szekcionálás kulcsát (az üzenet dátumát) minden táblához: címzettek, fájl, nyilvántartások. Magába az üzenetbe nem szükséges hozzáadni, használhatjuk a meglévő DátumIdő-t.
Témák
Mivel a téma több üzenetre vonatkozik, azt már nem lehet ugyanabban a modellben "szétvágni", valami másra kell támaszkodnunk. Ebben az esetben tökéletesen megfelel az első üzenet dátuma a levelezésben — tehát a téma létrehozásának pillanata.
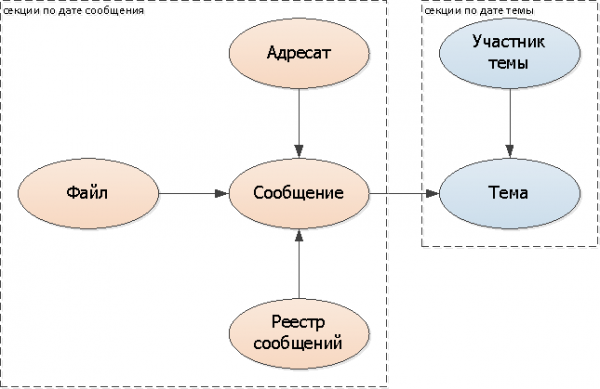
Hozzáadjuk a szekcionálás kulcsát (a téma dátumát) minden táblához: téma, résztvevő.
De most azonnal két probléma merül fel:
- melyik szekcióban keressük az üzeneteket a témában?
- melyik szekcióban keressük a témát az üzenettől?
Természetesen lehet folytatni a keresést az összes szekcióban, de ez nagyon szomorú lenne, és nullázza az összes nyereségünket. Ezért, hogy tudjuk, hol keressünk pontosan, logikai hivatkozásokat/utalásokat készítünk a szekciókra:
- az üzenetben hozzáadunk egy mezőt a téma dátumával
- a témához hozzáadunk a kapcsolódó üzenetek dátumait e levelezés (lehet külön táblázatban, vagy dátumos tömbként is)
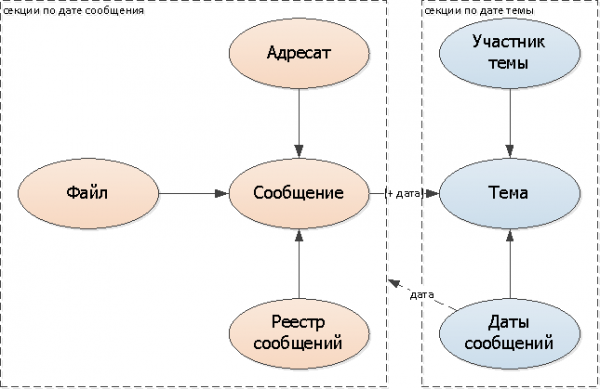
Mivel a különböző levelezésekhez tartozó üzenetek dátumainak módosításai számottevően kevesek lesznek (hiszen szinte minden üzenet 1-2 szomszédos napon belül érkezik), én éppen ezen a megoldáson fogok állni.
Összegzésül, az adatbázisunk struktúrája a következő módon alakult szekcionálás figyelembevételével:
Táblák: RU, a cirill betűs táblázatok/mezők elnevezéseiről való undorban jobb nem nézni
-- üzenetek dátum szerint
CREATE TABLE "Üzenet_YYYYMMDD"(
  "Üzenet"
    uuid
      PRIMARY KEY
, "Téma"
    uuid
, "TémaDátum"
    date
, "Szerző"
    uuid
, "DátumIdő" -- mint dátum
    timestamp
, "Szöveg"
    text
);

CREATE TABLE "Címzett_YYYYMMDD"(
  "ÜzenetDátum"
    date
, "Üzenet"
    uuid
, "Személy"
    uuid
, PRIMARY KEY("Üzenet", "Személy")
);

CREATE TABLE "Fájl_YYYYMMDD"(
  "ÜzenetDátum"
    date
, "Fájl"
    uuid
      PRIMARY KEY
, "Üzenet"
    uuid
, "BLOB"
    uuid
, "Név"
    text
);

CREATE TABLE "ÜzenetekNaplója_YYYYMMDD"(
  "ÜzenetDátum"
    date
, "Tulajdonos"
    uuid
, "NaploTípus"
    smallint
, "DátumIdő"
    timestamp
, "Üzenet"
    uuid
, PRIMARY KEY("Tulajdonos", "NaploTípus", "Üzenet")
);
CREATE INDEX ON "ÜzenetekNaplója_YYYYMMDD"("Tulajdonos", "NaploTípus", "DátumIdő" DESC);

-- témák dátuma szerint
CREATE TABLE "Téma_YYYYMMDD"(
  "TémaDátum"
    date
, "Téma"
    uuid
      PRIMARY KEY
, "Dokumentum"
    uuid
, "Cím"
    text
);

CREATE TABLE "TémaRésztvevő_YYYYMMDD"(
  "TémaDátum"
    date
, "Téma"
    uuid
, "Személy"
    uuid
, PRIMARY KEY("Téma", "Személy")
);

CREATE TABLE "ÜzenetekTémákDátumai_YYYYMMDD"(
  "TémaDátum"
    date
, "Téma"
    uuid
      PRIMARY KEY
, "Dátum"
    date
);
Pénzt spórolunk
Nos, ha nem a használjuk, amely az oszlopértékek eloszlásán alapul (trigger-ek és öröklődés, vagy PARTITION BY), hanem „kézzel” az alkalmazás szintjén, akkor észrevehetjük, hogy a szekcionálási kulcs értéke már a tábla nevében is tárolva van.
Ezért, ha annyira aggódsz a tárolt adatok mennyisége miatt, akkor ezektől a „felesleges” mezőktől meg is lehet szabadulni, és közvetlenül hivatkozni a konkrét táblákra. Igaz, hogy ebben az esetben minden több szekcióból származó lekérdezést már az alkalmazás oldalára kell helyezni.
Forrás: habr.com
