

A nevem Denis Rozsikov, a „Gazinformservis“ vállalat szoftverfejlesztési vezetője vagyok, a termékcsapatban. . A jogszabályok és a vállalati normák bizonyos követelményeket támasztanak az adatok biztonságos tárolásával kapcsolatban. Senki sem szeretné, ha harmadik felek hozzáférnének bizalmas információkhoz, ezért bármely projekt szempontjából fontosak a következő kérdések: azonosítás és hitelesítés, az adatokhoz való hozzáférés irányítása, a rendszer információinak integritásának biztosítása, a biztonsági események naplózása. Ezért szeretném megosztani néhány érdekes szempontot a DBMS biztonságával kapcsolatban.
A cikk a szervezésével készült. . Ha nem akar olvasni, megtekintheti:
A cikk három részből áll:
- Hogyan védjük a kapcsolódásokat.
- Mi az auditálás, és hogyan rögzíthetjük, hogy mi történik az adatbázis oldaláról és a kapcsolódásról.
- Hogyan védjük az adatokat magában az adatbázisban, és milyen technológiák állnak rendelkezésre ehhez.
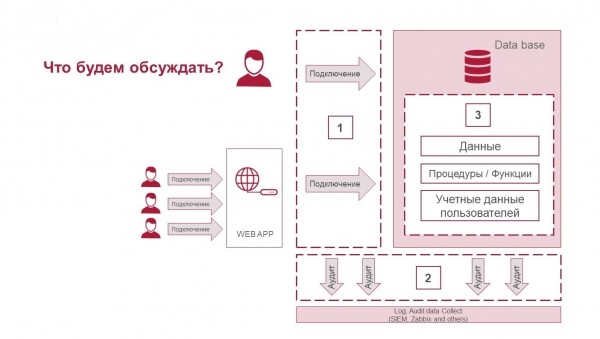
A DBMS biztonságának három összetevője: a kapcsolatok védelme, az auditalás és az adatok védelme.
Kapcsolatok védelme
Az adatbázishoz közvetlenül vagy közvetve, webalkalmazásokon keresztül lehet csatlakozni. Általában az üzleti felhasználó, azaz az, aki az DBMS-sel dolgozik, nem közvetlenül lép kapcsolatba vele.
Mielőtt a kapcsolatok védelméről beszélnénk, fontos kérdésekre kell választ adnunk, amelyek befolyásolják, hogyan valósulnak meg a biztonsági intézkedések:
- egy üzleti felhasználó egy DBMS felhasználóval egyenértékű-e;
- biztosított-e a hozzáférés az DBMS adataihoz csak azon API-n keresztül, amelyet Ön irányít, vagy van közvetlen hozzáférés a táblázatokhoz;
- külön védett szegmensbe van-e elkülönítve az DBMS, és ki, illetve hogyan lép kapcsolatba vele;
- használják-e a pooling/proxy és azokat a köztes rétegeket, amelyek módosíthatják a kapcsolódási információkat és a DBMS-t használó felhasználók adatait.
Most nézzük meg, milyen eszközöket alkalmazhatunk a kapcsolatok védelmére:
- Használjon adatbázis tűzfal kategóriájú megoldásokat. A további védelem legkevesebb egy réteggel növeli a DBMS átláthatóságát, maximálisan pedig biztosítani tudja az adatok további védelmét.
- Használja a jelszópolitikákat. Az alkalmazásuk attól függ, hogyan épült fel az architektúrája. Mindenesetre a webalkalmazás konfigurációs fájljában található egy jelszó nem elegendő a védelemhez, amely a DBMS-hez csatlakozik. Számos DBMS-eszköz létezik, amelyek lehetővé teszik a felhasználó és a jelszó aktualizálásának ellenőrzését.
További információt a felhasználói értékelés funkcióiról olvashat. , és a MS SQL Vulnerability Assessment-ről is tájékozódhat. .
- Gazdagítsa a munkamenet kontextusát a szükséges információkkal. Ha a munkamenet átláthatatlan, és nem érti, ki dolgozik a DBMS-en belül, kiegészítheti az információt arról, hogy ki, mit és miért csinál az elvégzett műveletek keretében. Ezt az információt az auditálás során ellenőrizheti.
- Állítsa be az SSL-t, ha a DBMS és a végző felhasználók között nincs hálózati szegmentálás, és nem külön VLAN-on található. Ilyen esetekben kötelező biztosítani a csatorna védelmét a fogyasztó és a DBMS között. Vannak védelmi eszközök, köztük open source megoldások is.
Hogyan befolyásolja ez a DBMS teljesítményét?
Nézzük meg a PostgreSQL példáján, hogyan hat az SSL a CPU terhelésére, a válaszidők növekedésére és a TPS csökkenésére, nem használ-e el túlságosan sok erőforrást, ha engedélyezzük.
Terheljük a PostgreSQL-t a pgbench használatával – ez egy egyszerű program a teljesítménymérések futtatására. Ismételten végrehajt egy parancssorozatot, esetleg párhuzamos adatbázis-munkamenetekben, majd kiszámítja az átlagos tranzakciós sebességet.
1. teszt SSL nélkül és SSL használatával — kapcsolatot hoz létre minden egyes tranzakciónál:
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"2. teszt SSL nélkül és SSL használatával — minden tranzakció egy kapcsolaton belül történik:
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"A többi beállítás:
skálázási faktor: 1
lekérdezési mód: egyszerű
ügyfelek száma: 10
szálak száma: 1
ügyfelenkénti tranzakciók száma: 5000
valójában feldolgozott tranzakciók száma: 50000/50000
Tesztelési eredmények:
NINCS SSL
SSL
Kapcsolatot létesít minden tranzakciónál
átlagos késleltetés
171.915 ms
187.695 ms
tps beleértve a kapcsolatok létrehozását
58.168112
53.278062
tps a kapcsolatok létrehozása nélkül
64.084546
58.725846
CPU
24%
28%
Minden tranzakció egy kapcsolaton belül történik
átlagos késleltetés
6.722 ms
6.342 ms
tps beleértve a kapcsolatok létrehozását
1587.657278
1576.792883
tps a kapcsolatok létrehozása nélkül
1588.380574
1577.694766
CPU
17%
21%
Kis terhelések mellett az SSL hatása összehasonlítható a mérés hibájával. Ha az átvitt adatok mennyisége nagyon nagy, a helyzet más lehet. Ha minden tranzakcióhoz egy kapcsolatot létesítünk (ez ritkán fordul elő, általában a felhasználók osztják meg a kapcsolatokat), akkor sok csatlakozás/készlet bontás történik, a hatás valamivel nagyobb lehet. Tehát a teljesítmény csökkenésének kockázatai létezhetnek, azonban a különbség nem annyira jelentős, hogy ne használjuk a védelmet.
Figyeljen oda — jelentős különbség van a működési módok összehasonlításakor: ugyanazon session keretein belül vagy különbözőek esetén. Ez érthető: minden kapcsolat létrehozásához erőforrások szükségesek.
Volt egy esetünk, amikor a Zabbixet trust módban csatlakoztattuk, azaz az md5-öt nem ellenőriztük, így az autentikáció nem volt szükséges. Később az ügyfél kérte az md5-autentikáció bekapcsolását. Ez nagy terhelést rótt a CPU-ra, a teljesítmény csökkent. Kezdtük keresni az optimalizálás lehetőségeit. Az egyik lehetséges megoldás a probléma megoldására a hálózati korlátozás bevezetése, külön VLAN-ok létrehozása az adatbázis kezelő rendszerekhez, olyan beállítások hozzáadása, amelyekkel látható, ki és honnan csatlakozik, valamint az autentikáció eltávolítása. Az autentikációs beállítások optimalizálásával is csökkenthetjük az autentikáció bekapcsolásakor felmerülő költségeket, de alapvetően a különböző autentikálási módszerek alkalmazása hatással van a teljesítményre és figyelembe kell venni ezeket a tényezőket a szerverek (hardver) számítási kapacitásának tervezésekor az adatbázis kezelő rendszerekhez.
Következtetés: bizonyos megoldásokban még a legkisebb részletek az autentikáció terén is erőteljesen befolyásolhatják a projektet, és rossz, ha ez csak a termelésbe való bevezetés során válik világossá.
Tevékenységek auditálása
Az auditálás nemcsak az adatbázis kezelő rendszerekre vonatkozhat. Az auditálás információk beszerzése arról, hogy mi történik a különböző szegmensekben. Ez lehet adatbázis tűzfal és az operációs rendszer is, amelyre az adatbázis kezelő rendszer épül.
A kereskedelmi Enterprise szintű adatbázis kezelő rendszerek auditálása rendben van, az open source esetében ez nem mindig így van. Íme, amit a PostgreSQL kínál:
- default log — beépített naplózás;
- extensions: pgaudit — ha nem elegendő a default naplózás, külön beállításokat használhatunk, amelyek néhány feladatot megoldanak.
Kiegészítés a videós előadáshoz:
A kezdeti operátorok regisztrálása standard naplózási eszközzel végezhető, ahol a log_statement = all.
Ez elfogadható a megfigyeléshez és más felhasználási módokhoz, de nem biztosítja azt a részletességet, amely általában szükséges az auditáláshoz.
Nem elegendő, hogy csak a kezdeményezett adatbázis-műveletek listáját tartsuk nyilván.
Lehetővé kell tenni, hogy megtaláljunk konkrét állításokat, amelyek érdeklik az auditort.
A standard naplózó eszköz azt mutatja, amit a felhasználó kért, míg a pgAudit a kérés végrehajtásának részleteire összpontosít.
Például az auditor szeretné biztosítani, hogy egy adott táblázat a dokumentált karbantartási ablakban lett létrehozva.
Ez egy egyszerű feladatnak tűnhet az alapvető auditálás és a grep segítségével, de mi történik, ha valami ilyen (szándékosan összezavart) példával találkozunk:
DO $$
Kezd
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
A standard naplózás ezt fogja adni:
LOG: állítás: DO $$
Kezd
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Úgy tűnik, hogy a megfelelő táblázat kereséséhez szükség lehet bizonyos kódismeretekre, amikor a táblák dinamikusan jöttek létre.
Ez nem ideális, mivel jobb lenne egyszerűen a táblázat nevére keresni.
Itt válik hasznossá a pgAudit.
Ugyanezen bemenetre ezt a kimenetet adja a naplóban:
AUDIT: SESSION,33,1,FUNCTION,DO,,,«DO $$
Kezd
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;"
AUDIT: SESSION,33,2,DDL,CREATE TABLE,TABLE,public.important_table,CREATE TABLE important_table (id INT)
Nemcsak a DO blokk, hanem a CREATE TABLE teljes szövege is regisztrálva van, a művelet típusával, objektumtípusával és teljes nevével, ami megkönnyíti a keresést.
A SELECT és DML operátorok naplózásánál a pgAudit beállítható, hogy külön bejegyzést rögzítsen minden kapcsolatra vonatkozóan, amelyre hivatkoznak az operátorban.
Nem szükséges szintaktikai elemzés, hogy megtaláljuk az összes olyan operátort, amely egy adott táblázatra vonatkozik ()».
Hogyan befolyásolja ez a DBMS teljesítményét?
Indítsunk teszteket a teljes audit engedélyezésével, és nézzük meg, mi történik a PostgreSQL teljesítményével. A lehető legnagyobb naplózást fogjuk beállítani az adatbázis minden paraméteréhez.
A konfigurációs fájlban szinte semmit sem változtatunk, csak annyit, hogy beállítjuk a debug5 módot, hogy a lehető legtöbb információt kapjuk.
, hogy a tesztadatbázisunk ne akarjon csendesen biztosítékot létrehozni.
log_destination = ‘stderr’
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = on
log_checkpoints = on
log_connections = on
log_disconnections = on
log_duration = on
log_hostname = on
log_lock_waits = on
log_replication_commands = on
log_temp_files = 0
log_timezone = ‘Europe/Moscow’
A PostgreSQL adatbázison 1 CPU, 2,8 GHz, 2 GB RAM, 40 GB HDD paraméterekkel három terheléses tesztet végzünk, a következő parancsok használatával:
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
A tesztelési eredmények:
Nincs naplózás
Naplózással
Az adatbázis feltöltésének végső ideje
43,74 másodperc
53,23 másodperc
RAM
24%
40%
CPU
72%
91%
Teszt 1 (50 kapcsolódás)
Tranzakciók száma 10 perc alatt
74169
32445
Tranzakciók/másodperc
123
54
Átlagos késleltetés
405 ms
925 ms
Teszt 2 (150 kapcsolódás 100 lehetséges)
Tranzakciók száma 10 perc alatt
81727
31429
Tranzakciók/másodperc
136
52
Átlagos késleltetés
550 ms
1432 ms
A méretekről
Az adatbázis mérete
2251 MB
2262 MB
Az adatbázis naplói
0 MB
4587 MB
Összességében: a teljes audit nem túl jó. Az auditból származó adatok mennyisége megegyezik az adatbázisban lévő adatokéval, vagy akár több is. Az adatbázis működése közben generált naplózási mennyiség szokásos probléma a termelésben.
Nézzük meg a többi paramétert:
- A sebesség nem változik drámaian: naplózás nélkül — 43,74 másodperc, naplózással — 53,23 másodperc.
- A RAM és a CPU teljesítménye csökkenni fog, mivel audit fájlokat kell generálni. Ez a termelés során is megfigyelhető.
A kapcsolódások számának növelése természetesen kismértékű romlást eredményez.
A vállalatoknál az audit még bonyolultabb:
- sok adat van;
- audit nemcsak syslogon keresztül a SIEM-ben, hanem fájlokban is szükséges: ha a sysloggal valami történik, közel az adatbázishoz kell lennie egy fájlnak, amelyben az adatok tárolódnak;
- az audit számára külön adatkapacitásra van szükség, hogy ne maradjon le a lemezek I/O-ján, mivel ez sok helyet foglal el;
- előfordul, hogy a biztonsági alkalmazottaknak mindenhol szüksége van a GOST dokumentumokra, a vendégazonosítást követelik.
Hozzáférés korlátozása az adatokhoz
Nézzük meg a technológiákat, amelyeket az adatok védelmére és a hozzáférésük biztosítására használnak kereskedelmi adatbázisokban és nyílt forráskódú megoldásokban.
Mit használhatunk általánosságban:
- Adatok titkosítása és obfuszkálása (Wrapping) — azaz különböző eszközök és segédprogramok, amelyek a szöveges kódot olvashatatlanná teszik. Igaz, azt később nem lehet sem módosítani, sem visszaépíteni. Ilyen megoldásra néha szükség van legalább az adatbázis szintjén — a licenszelési korlátozások vagy az engedélyezés logika titkosítva van pontosan a függvények és eljárások szintjén.
- A sorok láthatóságának korlátozása (RLS) azt jelenti, hogy különböző felhasználók ugyanazt a táblázatot látják, de eltérő sorösszetétellel, vagyis valakinek tilos megmutatni valamit a sorok szintjén.
- A megjelenített adatok szerkesztése (Masking) azt jelenti, hogy a felhasználók egy táblázat egy oszlopában vagy adatokat, vagy csak csillagokat látnak, vagyis bizonyos felhasználók számára az információ zárva lesz. A technológia meghatározza, hogy melyik felhasználónak mit mutasson a hozzáférési szint figyelembevételével.
- A hozzáférés korlátozása Security DBA/Application DBA/DBA - ez inkább a DBMS-hez való hozzáférés korlátozásáról szól, azaz a IT munkatársakat el lehet választani az adatbázis-adminisztrátoroktól és az alkalmazás-adminisztrátoroktól. Nyílt forráskódú megoldásokból van néhány ilyen technológia, de kereskedelmi DBMS-ekből bőven van. Akkor van szükség rájuk, amikor sok felhasználónak van hozzáférése magukhoz a szerverekhez.
- A fájlokhoz való hozzáférés korlátozása a fájlrendszer szintjén. Lehet jogosultságokat, hozzáférési előjogokat adni könyvtárakra, hogy minden adminisztrátor csak a szükséges adatokhoz férhessen hozzá.
- A mandátumos hozzáférés és memória-tisztítás ezeket a technológiákat ritkán alkalmazzák.
- A végponttól végpontig terjedő titkosítás a DBMS-nél - ez a kliensoldali titkosítás, ahol a kulcskezelés a szerveroldalon történik.
- Adatok titkosítása. Például oszlopok titkosítása - amikor olyan mechanizmust használ, amely egy adott oszlopot titkosít a bázison belül.
Hogyan hat ez a DBMS teljesítményére?
Nézzük meg a PostgreSQL oszlopos titkosításának példáját. Ott van a pgcrypto modul, amely lehetővé teszi, hogy bizonyos mezőket titkosítva tároljunk. Ez hasznos, amikor csak bizonyos adatok értékesek. A titkosított mezők olvasásához a kliens továbbítja a dekódoló kulcsot, a szerver dekódolja az adatokat és visszaadja a kliensnek. Kulcs nélkül senki sem tud semmit kezdeni az Ön adataival.
Teszteljük a pgcryptót. Hozzunk létre egy táblát titkosított és normál adatokkal. Az alábbiakban a táblák létrehozásához szükséges parancsok, az első sorban egy hasznos parancs – az extension létrehozása a DBMS regisztrálásával:
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
Ezután megpróbáljuk adatokat lekérdezni minden táblából, és megvizsgáljuk a végrehajtási időket.
Lekérdezés a táblából titkosítási funkció nélkül:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
A stopper elindult.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 sor)
Idő: 1,386 ms
Lekérdezés a táblából titkosítási funkcióval:
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
A stopper elindult.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 sor)
Idő: 50,203 ms
Tesztelési eredmények:
Titkosítás nélkül
Pgcrypto (dekódolás)
Lekérdezés 1000 sorra
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
A titkosítás jelentősen befolyásolja a teljesítményt. Látható, hogy a teljesítményidő nőtt, mivel a titkosított adatok dekódolási műveletei (és a dekódolás általában még a logikádat is magába foglalja) jelentős erőforrásokat igényelnek. Tehát a minden oszlop titkosítása, amely valamilyen adatokat tartalmaz, a teljesítmény csökkenésével járhat.
Ugyanakkor a titkosítás nem ezüst lövedék, amely minden problémát megold. A dekódolt adatok és a dekódoló kulcs a dekódolás és az adatok átvitele során a szerveren találhatóak. Ezért a kulcsok elfoghatók azok számára, akik teljes hozzáféréssel rendelkeznek az adatbázis szerverhez, például a rendszergazdák általi.
Amikor egy oszlop teljes terjedelemben minden felhasználó számára egy kulcs van (akkor is, ha nem mindenki számára, hanem egy korlátozott ügyfélkör számára), az nem mindig jó és helyes. Éppen ezért kezdték el az end-to-end titkosítást, az adatbázisokban elkezdték megvizsgálni az adatok titkosítási lehetőségeit a kliens és a szerver oldaláról, megjelentek a kulcsnyilvántartó tárolók — külön termékek, amelyek a DBMS (adatbázis-kezelő rendszer) oldalán kulcskezelést biztosítanak.

Biztonsági eszközök kereskedelmi és nyílt forráskódú DBMS-ben
Funkciók
Típus
Jelszópolitika
Audit
A folyamatok és funkciók forráskódjának védelme
RLS
Titkosítás
Oracle
Kereskedelmi
+
+
+
+
+
MsSql
Kereskedelmi
+
+
+
+
+
Kereskedelmi
+
+
+
+
bővítmények
PostgreSQL
Ingyenes
bővítmények
bővítmények
—
+
bővítmények
MongoDb
Ingyenes
—
+
—
—
Csak a MongoDB Enterprise verzióban elérhető
A táblázat messze nem teljes, de a helyzet a következő: a kereskedelmi termékeknél a biztonsági kihívásokra már régóta megoldások vannak, a nyílt forráskódú megoldásoknál általában különböző kiegészítőket használnak a biztonságra, sok funkció hiányzik, és néha szükség van a kiegészítésükre. Például a jelszópolitikák — a PostgreSQL-ben sok különböző kiegészítést találhatunk., , , , ), amelyek jelszópolitikákat alkalmaznak, de véleményem szerint a hazai vállalati szegmens igényeit egyik sem fedi le.
Mit tegyünk, ha sehol sem találjuk, amire szükség van?? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
Ilyenkor harmadik féltől származó megoldásokat lehet használni, amelyek különböző DBMS-ekkel működnek, például a 'Crypto DB'-t vagy a 'Garda DB'-t. Ha a hazai szegmens megoldásairól van szó, ők jobban ismerik a GOST-okat, mint az open source közösség.
A második lehetőség, hogy saját magunk írjuk meg, amire szükség van, és megvalósítjuk az adat-hozzáférést és titkosítást az alkalmazás szintjén. Igaz, a GOST-tal nehezebb lesz. De összességében — el tudjuk rejteni az adatokat a szükséges módon, belehelyezni a DBMS-be, majd onnan kivenni és a megfelelő módon dekriptálni, közvetlenül az alkalmazás szintjén. Közben pedig érdemes elgondolkodni, hogyan védjük meg ezeket az algoritmusokat az alkalmazáson belül. Véleményünk szerint ezt a DBMS szintjén kellene megtenni, mert így gyorsabban fog működni.
Ez a beszéd először hangzott el a Mail.ru Cloud Solutions által. Nézd megmás előadásokat, és iratkozz fel az események értesítéseire a Telegramon .
Mit érdemes még olvasni a témában:
- .
- .
Forrás: habr.com
