

Előszó
Ez a cikk a bináris keresőfáknak szentelt. Nemrég írtam egy cikket a Ott nem figyeltem túlságosan a bináris fákra, mert a keresési, beszúrási és törlési módszerek nem voltak aktuálisak. Most úgy döntöttem, hogy kifejezetten a fákról írok. Kezdjük talán.
A fa egy adatstruktúra, amely csúcsokból áll, amelyeket élek kötnek össze. Mondhatjuk, hogy a fa a gráf egy különleges esete. Íme egy példa a fára:
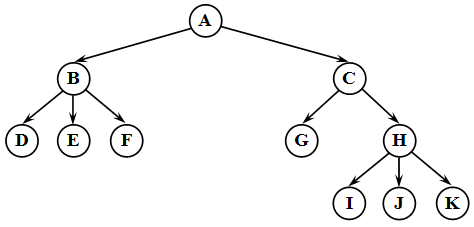
Ez nem bináris keresőfa! Minden a hajtás alatt!
Terminológia
Gyökér
A fa gyökere az a legfelső csúcs. A példában ez az A csúcs. A fából a gyökértől bármely más csúcs felé csak egy út vezethet! Valójában bármely csúcsot úgy is tekinthetünk, mint a hozzá tartozó részfa gyökerét.
Szülők/leszármazottak
Minden csúcs, kivéve a gyökér csúcsot, pontosan egy éllel rendelkezik, amely felfelé vezet egy másik csúcs felé. A jelenlegi csúcs felett elhelyezkedő csúcsot szülőnek nevezik. A jelenlegi csúcs alatt elhelyezkedő csúcs, amely összeköttetésben áll vele, leszármazottnak nevezik. Vegyünk egy példát. Tegyük fel, hogy a B csúcsot nézzük, ebben az esetben a szülője az A csúcs, a leszármazottai pedig a D, E és F csúcsok.
Lapot
A csúcs, amelynek nincsenek leszármazottai, a fa levelének nevezik. A példában a levelek a D, E, F, G, I, J és K csúcsok.
Ez az alapvető terminológia. Más fogalmakat később tárgyalunk. Tehát a bináris fa — egy fa, amelyben minden csúcs legfeljebb két leszármazottal rendelkezik. Ahogy kitalálhattad, a példa fája nem lesz bináris, mivel a B és H csúcsoknak több mint két leszármazottjuk van. Íme egy példa bináris fára:
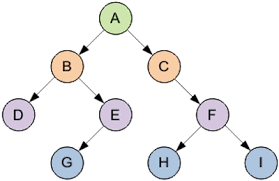
A fa csúcsában bármilyen információ lehet. A bináris keresőfa egy bináris fa, amelynek a következő tulajdonságai vannak:
- Mindkét részfa — a bal és a jobb — bináris keresőfák.
- X bármely csúcsának bal részfájában a csúcsok adatkulcsaival rendelkező értékek kisebbek, mint a X csúcs adatkulcsa.
- X bármely csúcsának jobb részfájában a csúcsok adatkulcsaival rendelkező értékek nagyobbak vagy egyenlők, mint a X csúcs adatkulcsa.
Kulcs — bármilyen jellemző (például szám). A kulcs arra szolgál, hogy megtaláljuk a fában azt az elemet, amelyhez ez a kulcs tartozik. Példa egy bináris keresőfára:
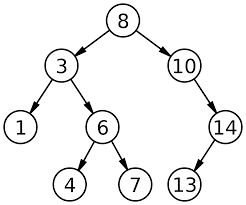
A fa megjelenítése
Ahogy haladunk előre, bemutatok néhány (lehetségesen nem teljes) kódrészletet, hogy jobban megértsd. A teljes kód a cikk végén lesz.
A fa csúcsokból áll. A csúcs szerkezete:
public class Node<T> {
    private T data;
    private int key;
    private Node<T> leftChild;
    private Node<T> rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }
    public Node<T> getLeftChild() {
        return leftChild;
    }

    public Node<T> getRightChild() {
        return rightChild;
    }
//...a csúcs további metódusai
}
Minden csúcsnak két leszármazottja van (valószínű, hogy a leftChild és/vagy rightChild értéke null lesz). Valószínűleg megérted, hogy ebben az esetben a data — a csúcsban tárolt adat; key — a csúcs kulcsa.
Megértettük a csúcsot, most beszéljünk a fák aktuális problémáiról. Itt és a továbbiakban a "fa" kifejezés alatt a bináris keresőfa fogalmát értem. A bináris fa struktúrája:
public class BinaryTree<T> {
     private Node<T> root;

    //fa metódusok
}
A osztály mezőjeként csak a fa gyökere szükséges, mivel a gyökérből a getLeftChild() és getRightChild() metódusok használatával elérhetjük a fa bármely csúcsát.
Algoritmusok a fában
Mint mindig, létezik egy weboldal, amely a jó kérdésekkel foglalkozik, és amelynek neve
Tegyük fel, hogy van egy felépített fád. Hogyan találod meg a kulcs key-vel rendelkező elemet? Fokozatosan kell haladni a gyökértől lefelé a fán, és össze kell hasonlítani a key értékét a következő csúcs kulcsával: ha a key kisebb, mint a következő csúcs kulcsa, akkor át kell lépni a csúcs bal leszármazottjára, ha nagyobb, akkor a jobb leszármazottra, ha pedig a kulcsok egyenlőek — a keresett csúcs megtalálva! A megfelelő kód:
public Node<T> find(int key) {
    Node<T> current = root;
    while (current.getKey() != key) {
        if (key < current.getKey())
            current = current.getLeftChild();
        else
            current = current.getRightChild();
        if (current == null)
            return null;
    }
    return current;
}
Ha a current null lesz, akkor a keresés elérte a fa végét (fogalmilag egy nem létező helyen vagy, a levél leszármazottjánál).
Nézzük az algoritmus keresési hatékonyságát egy kiegyensúlyozott fában (abban a fában, ahol a csúcsok viszonylag egyenletesen oszlanak el). Ekkor a keresés hatékonysága O(log(n)), ahol a logaritmus alapja 2. Nézd: ha a kiegyensúlyozott fában n elem van, akkor az azt jelenti, hogy log(n) alapú 2 szint lesz a fában. A keresés során minden ciklus lépésnél egy szinttel lejjebb haladsz.
Beszúrás
Ha megértetted a keresés lényegét, akkor a beszúrás megértése sem okoz nehézséget. Csak le kell menni a fa lapjára (a keresésben leírt leereszkedési szabályok szerint), és ennek megfelelően a bal vagy a jobb utódjává kell válni, attól függően, hogy mi a kulcs. Megvalósítás:
   public void insert(T insertData, int key) {
        Node current = root;
        Node parent;
        Node newNode = new Node(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }
Ebben az esetben a jelenlegi csomópont mellett a szülő csomópontra vonatkozó információt is meg kell tárolni. Amikor a current null lesz, akkor a parent változóban megtaláljuk a szükséges lapot.
A beszúrás hatékonysága nyilvánvalóan ugyanaz lesz, mint a keresésé — O(log(n)).
Törlés
A törlés a legbonyolultabb művelet, amelyet a fával el kell végezni. Nyilvánvaló, hogy először meg kell találni az elemet, amelyet törölni kívánunk. De mi történik utána? Ha egyszerűen nullát rendelünk az értékéhez, akkor elveszítjük az al-fához tartozó információt, amelynek gyökere ez a csomópont. A fa törlési módszereket három esetre osztják.
Első eset. A törlendő csomópontnak nincsen utódja
Ha a törlendő csomópontnak nincsen utódja, akkor ez azt jelenti, hogy levél. Következésképpen a szülője leftChild vagy rightChild mezőjét egyszerűen null értékre kell állítani.
Második eset. A törlendő csomópontnak van egy utódja
Ez az eset sem túl bonyolult. Térjünk vissza a példánkhoz. Tegyük fel, hogy törölni kell a 14-es kulcsú elemet. Egyetértesz, hogy mivel ez a 10-es kulcsú csomópont jobb utóda, ezért bármely utódja (ebben az esetben a jobb) nagyobb kulccsal fog bírni, mint 10, így könnyen "kivághatjuk" a fából, és a szülőt közvetlenül összekapcsolhatjuk a törölni kívánt gyerekével, azaz a 10-es kulcsú csomópontot összekapcsolhatjuk a 13-as kulcsú csomóponttal. Hasonló lenne a helyzet, ha egy olyan csomópontot kellene törölni, amely a szülője bal utódja. Gondolkodj el ezen magad — pontos analógia.
Harmadik eset. A csomópontnak két utódja van
A legbonyolultabb eset. Vizsgáljuk meg egy új példán.
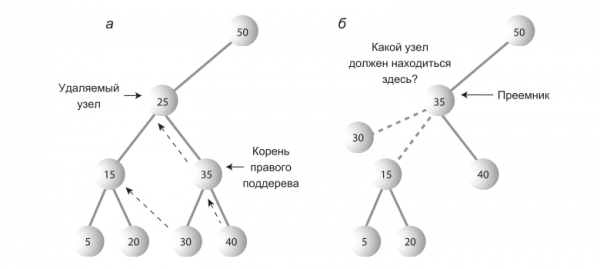
Az utód keresése
Tegyük fel, el kell távolítanunk a 25-ös kulccsal rendelkező csomópontot. Kit állítunk a helyére? Valakinek a követői közül (utódok vagy az utódok utódai) kell, hogy legyen a jogutód(az a személy, aki elfoglalja az eltávolított csomópont helyét).
Hogyan érthetjük meg, ki kell, hogy legyen a jogutód? Intuitíven világos, hogy ez a fában található csomópont lesz, amelynek a kulcsa a következő legnagyobb az eltávolított csomóponténál. Az algoritmus a következőképpen működik. Először a jobb utódjához kell lépnünk (mindig a jobbra, mert már említettük, hogy a jogutód kulcsa nagyobb, mint az eltávolítandó csomópont kulcsa), majd végig kell mennünk a bal utódok láncán a jobb utódnál. A példánkban a 35-ös kulcsú csomópontra kell lépnünk, majd lefelé kell haladnunk a bal utódok láncán - ebben az esetben ez a lánc csak a 30-as kulcsú csomópontból áll. Szó szerint a keresett csomópontok halmazában a legkisebb csomópontot keressük, amely nagyobb mint a keresett csomópont.
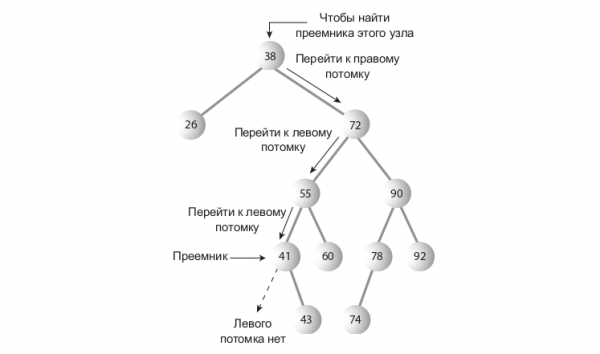
A jogutód keresési módszer kódja:
    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode; // a jogutód szülője
        Node<T> successor = deleteNode; // jogutód
        Node<T> current = successor.getRightChild(); // egyszerű "bejárás" csomópont
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }
        // kilépéskor a jogutódot és a jogutód szülőjét kapjuk meg
        if (successor != deleteNode.getRightChild()) { // ha a jogutód nem egyezik meg az eltávolítandó csomópont jobb utódjával
            parentSuccessor.setLeftChild(successor.getRightChild()); // akkor a szülője átvállalja a jogutód utódját, hogy ne veszítse el
            successor.setRightChild(deleteNode.getRightChild()); // összekapcsoljuk a jogutódot az eltávolítandó csomópont jobb utódjával
        }
        return successor;
    }
A delete módszer teljes kódja:
public boolean delete(int deleteKey) {
        Node current = root;
        Node parent = current;
        boolean isLeftChild = false; // A változó, hogy a törölt csomópont bal vagy jobb gyermek-e a szülőjének, a logikai változó isLeftChild true vagy false értéket vesz fel ennek megfelelően.
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) { // első eset
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) { // második eset
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else { // harmadik eset
            Node successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }
A komplexitás körülbelül O(log(n))-nek tekinthető.
Maximum/minimum keresése a fában
Nyilvánvaló, hogy a minimum/máximális érték a fában úgy található meg, hogy fokozatosan haladunk a fa bal/jobb elemei mentén; amikor elérjük a levelet, az lesz a minimum/máximális elem.
    public Node getMinimum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node getMaximum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }
A komplexitás — O(log(n))
Szimmetrikus bejárás
A bejárás — a fa minden csomópontjának meglátogatása céljából, hogy valamilyen műveletet végezzünk rajta.
A rekuzív szimmetrikus bejárás algoritmus:
- Cselekedj a bal gyermekkel
- Cselekedj saját magaddal
- Cselekedj a jobb gyermekkel
Kód:
    public void inOrder(Node current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");//Itt bármi lehet
            inOrder(current.getRightChild());
        }
    }
Zárás
Végre! Ha valamit nem magyaráztam el jól, vagy bármilyen megjegyzésed van, várom a kommentek között. Ahogy ígértem, itt van a teljes kód.
Node.java:
public class Node {
    private T data;
    private int key;
    private Node leftChild;
    private Node rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }

    public void setLeftChild(Node newNode) {
        leftChild = newNode;
    }

    public void setRightChild(Node newNode) {
        rightChild = newNode;
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public T getData() {
        return data;
    }

    public int getKey() {
        return key;
    }
}
BinaryTree.java:
public class BinaryTree<T> {
    private Node<T> root;

    public Node<T> find(int key) {
        Node<T> current = root;
        while (current.getKey() != key) {
            if (key < current.getKey())
                current = current.getLeftChild();
            else
                current = current.getRightChild();
            if (current == null)
                return null;
        }
        return current;
    }

    public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }

    public Node<T> getMinimum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node<T> getMaximum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }

    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode;
        Node<T> successor = deleteNode;
        Node<T> current = successor.getRightChild();
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }

        if (successor != deleteNode.getRightChild()) {
            parentSuccessor.setLeftChild(successor.getRightChild());
            successor.setRightChild(deleteNode.getRightChild());
        }
        return successor;
    }

    public boolean delete(int deleteKey) {
        Node<T> current = root;
        Node<T> parent = current;
        boolean isLeftChild = false;
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {
            Node<T> successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }

    public void inOrder(Node<T> current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");
            inOrder(current.getRightChild());
        }
    }
}
P.S.
Degenerálás O(n)-re
Sokan észrevehettétek: mi lenne, ha a fát nem kiegyensúlyozottá tennénk? Például, ha növekvő kulcsokkal (1,2,3,4,5,6…) töltenénk fel a fát: akkor az fa valami olyasmit fog hasonlítani, mint egy láncolt lista. Igen, a fa elveszíti fára jellemző struktúráját, ami miatt csökken az adat-hozzáférési hatékonyság. A keresés, beszúrás és törlés műveletek időbeli bonyolultsága ugyanolyan lesz, mint a láncolt listáknál: O(n). Ez pedig egyike azoknak a legfontosabb hátrányoknak, amik a véleményem szerint a bináris fákhoz kapcsolódnak.
Csak a regisztrált felhasználók vehetnek részt a szavazáson. , kérem.
Nem régóta vagyok a Hubon, és szeretném tudni, milyen témákban szeretnétek több cikket látni?
Adatszerkezetek
Algoritmusok (Dinamika Programozás, rekurzió, adatok tömörítése stb.)
Adatszerkezetek és algoritmusok alkalmazása a valós életben
Android alkalmazások programozása Javában
Webalkalmazások programozása Javában
2 felhasználó szavazott. 1 felhasználó tartózkodott.
Forrás: habr.com
