

Tehát, te is gyűjtöd a metrikákat. Mint mi. Mi is gyűjtünk metrikákat. Természetesen, amelyek fontosak az üzlet számára. Ma bemutatjuk a monitoring rendszerünk első elemét - a statsd-kompatibilis aggregáló szervert. , miért írtuk meg, és miért mondtunk le a brubeckről.
Előző cikkeinkből (, ) megtudhattad, hogy egy ideig a címkéket a segítségével gyűjtöttük. C nyelven íródott. Kód szempontjából - olyan egyszerű, mint egy dugó (ez fontos, ha közreműködni szeretnél), és ami a legfontosabb, különösebb problémák nélkül kezeli a csúcsidőszakban a másodpercenkénti 2 millió metrikát (MPS). A dokumentáció 4 millió MPS támogatást ígér csillaggal. Ez azt jelenti, hogy ezt a számot akkor érheted el, ha helyesen állítod be a hálózatot Linuxon. (Hány MPS-t tudnánk elérni, ha a hálózatot érintetlenül hagynánk, azt nem tudjuk). Ezeket az előnyöket figyelembe véve, a brubeckkel kapcsolatban volt néhány komoly kifogásunk.
Kifogás 1. A projekt fejlesztője, a Github, leállította annak támogatását: nem publikál patch-eket és javításokat, nem fogad el a mi és (nem csak a mi) PR-ainkat. Az utolsó hónapokban (valahol 2018 februárjában-márciusában) megújult a tevékenység, de előtte majdnem 2 év teljes csend volt. Ezen kívül a projektet fejlesztették, ami komoly akadályt jelenthet az új lehetőségek bevezetésében.
Kifogás 2. A számítások pontossága. A Brubeck csak 65536 értéket gyűjt össze az aggregáláshoz. A mi esetünkben egyes metrikák aggregálási időszakában (30 másodperc) ennél sokkal több érték is érkezhet (1 527 392 a csúcson). Az ilyen mintavételezés eredményeként a maximumok és minimumok értékei haszontalannak tűnnek. Például így:
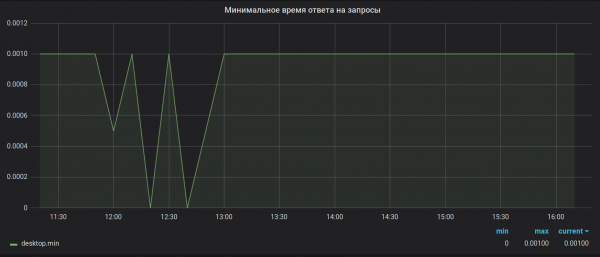
Hogyan volt
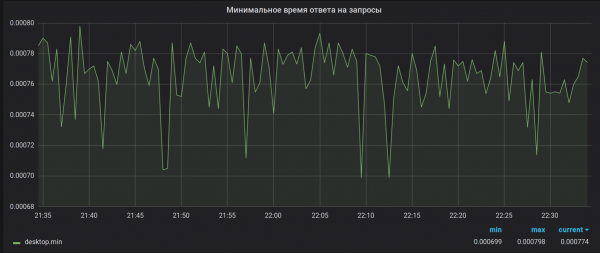
Hogyan kellett volna lennie
Ugyanezen okból az összegek teljesen pontatlanul kerülnek kiszámításra. Ehhez jön még a 32 bites float túlcsordulás bugja, amely a látszólag ártatlan metrika érkezésekor a szervert is segfaultba küldi, és ez már igazán nagyszerű. A bugot egyébként azóta sem javították.
És végül, Kifogás X. A cikk írásakor készen állunk, hogy bemutassuk az összes 14 működő statsd megoldást, amit sikerült megtalálnunk. Képzeljük el, hogy egy bizonyos infrastruktúra olyan mértékben nőtt, hogy a 4 millió MPS már nem elegendő. Vagy talán még nem nőtt meg, de a metrikák már olyan fontosak, hogy a 2-3 perces grafikon-összeomlások kritikusak lehetnek, és elkerülhetetlen depressziót okozhatnak a menedzserek körében. Mivel a depresszió kezelése hálátlan feladat, technikai megoldásokra van szükség.
Először is, a hibatűrés, hogy egy váratlan probléma a szerveren ne indítson el pszichiátriai zombiapokalipszist az irodában. Másodszor, a skálázhatóság, hogy lehetőségünk legyen több mint 4 millió MPS fogadására anélkül, hogy mélyre ásnánk a Linux hálózati veremébe, és nyugodtan növekedjünk "szélességben" a szükséges méretig.
Mivel a skálázás terén volt némi tartalékunk, úgy döntöttünk, hogy a hibatűréssel kezdjük. "Ó! Hibatűrés! Ez egyszerű, ezt tudjuk," gondoltuk, és elindítottunk 2 szervert, minden egyes brubeck példányával. Ehhez a forgalmat mindkét szerverre kellett másolni a metrikákkal, és még írni kellett hozzá egy . Ezzel a hibatűrés problémáját megoldottuk, de... nem túl jól. Eleinte minden rendben volt: minden brubeck a saját aggregálását gyűjtötte, 30 másodpercenként írt adatokat a Graphite-ba, felülírva a régi intervallumot (ezt a Graphite végzi). Ha az egyik szerver leáll, mindig van egy másik a saját aggregált adataival. De itt a probléma: ha a szerver leáll, a grafikonokon "fűrészfog" jelenik meg. Ennek oka, hogy a brubeck 30 másodperces intervallumai nincsenek szinkronizálva, és a leállás pillanatában az egyik nem írja felül magát. Amikor elindítjuk a második szervert, ugyanaz történik. Teljesen elviselhető, de jobb szeretnénk! A skálázhatóság problémája sem tűnt el. Minden metrika továbbra is egyetlen szerverre "repül", ezért ugyanazokkal a 2-4 millió MPS korlátokkal vagyunk kénytelenek szembenézni, az alkalmazott hálózat teljesítményétől függően.
Ha egy kicsit elgondolkodunk a problémán, miközben lapáttal ássuk a havat, akkor egy nyilvánvaló ötlet juthat eszünkbe: szükség van egy statsd-re, ami képes elosztott módban működni. Tehát olyanra, amelyben az idő és a metrikák közötti szinkronizálás megvalósított. „Természetesen ilyen megoldás már biztosan létezik” - mondtuk, és elkezdtünk keresni… de semmit sem találtunk. Különböző statsd-kről szóló dokumentációt átnézve ( 2017.12.11-ig) egyáltalán nem találtunk semmit. Valószínűleg sem a fejlesztők, sem a felhasználók ezekkel a MEGANNYI metrikával eddig még nem találkoztak, különben biztosan kitaláltak volna valamit.
Ekkor eszünkbe jutott a „játékszerű” statsd - a bioyino, amit a hackathonon írtunk csak a szórakozás kedvéért (a projekt nevét a hackathon előtt generálta egy szkript), és rájöttünk, hogy sürgősen szükségünk van egy saját statsd-re. Miért?
- mert a világon túl kevés a statsd klón,
- mert biztosítani lehet a kívánt vagy ahhoz közeli hibatűrést és skálázhatóságot (többek között a szerverek közötti aggregált metrikák szinkronizálását és a konfliktusok megoldását),
- mert pontosabban lehet mérni a metrikákat, mint amit a brubeck csinál,
- mert magunk is gyűjthetünk részletesebb statisztikát, amit a brubeck gyakorlatilag nem adott meg,
- mert adódott a lehetőség, hogy programozzuk a saját high-performance distributed scalable application-nünket, ami nem fogja teljesen megismételni egy másik hasonló high-performance… nos, bocsánat, architektúráját.
Mire írjunk? Természetesen Rust-ra. Miért?
- mert már volt egy prototípusunk,
- mert a cikk írója abban az időben már ismerte a Rust-ot és szeretett volna rajta valamit készíteni a produkció számára, lehetőséggel, hogy open-source-ba kiadja,
- mert a GC-vel rendelkező nyelvek nem megfelelőek számunkra a beérkező forgalom természetét figyelembe véve (gyakorlatilag valós idejű) és a GC-szünetek gyakorlatilag elfogadhatatlanok,
- mert maximális teljesítményre van szükség, ami összehasonlítható a C-vel,
- mert a Rust félelem nélküli párhuzamosságot kínál nekünk, és ha C/C++-ban kezdtünk volna el írni, akkor még több sebezhetőséget, puffer túlcsordulást, versenyhelyzetet és egyéb szörnyű szót kaptunk volna, mint a brubeck.
Volt egy érv a Rust ellen. A cégnek nem volt tapasztalata Rust alapú projektek létrehozásában, és most sem tervezzük, hogy fő projektünkben használjuk. Ezért komoly aggályaink voltak, hogy nem fog működni, de úgy döntöttünk, hogy kockáztatunk, és kipróbáltuk.
Eltelt az idő…
Végül, néhány sikertelen próbálkozás után, elkészült az első működő verzió. Mi lett belőle? Ilyen lett.
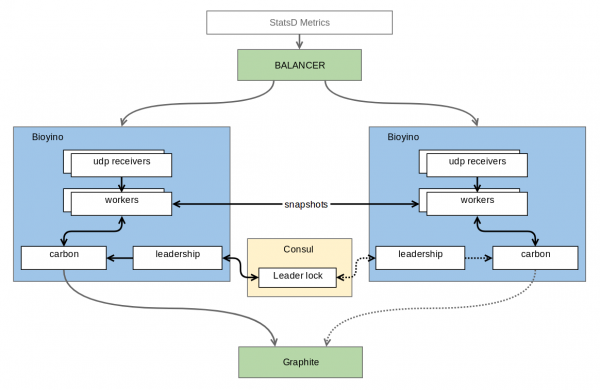
Minden node a saját metrikájának egy saját készletét kapja, és ezeket felhalmozza, nem aggregálva azokat a típusokat, ahol a végső aggregáláshoz a teljes készletre van szükség. A node-ok egy elosztott zár (distributed lock) protokollal vannak összekötve, amely lehetővé teszi a kiválasztást az közöttük lévő egyetlen (itt sírtunk), amely méltó arra, hogy a metrikákat a Nagyhoz küldje. Jelenleg ezt a problémát , de a jövőben a szerző ambíciói kiterjednek a Raft-ra, ahol a méltó persze a konszenzus vezető node-ja lesz. A konszenzus mellett a node-ok viszonylag gyakran (alapértelmezés szerint másodpercenként egyszer) küldenek a szomszédaiknak azon elő-agregált metrikáknak a részeit, amelyeket az adott másodperc alatt sikerült felhalmozni. Így a skálázhatóság és a hibatűrés megmarad — mindegyik node továbbra is megőrzi a teljes metrikakészletet, de a metrikák már aggregálva kerülnek küldésre, TCP-n keresztül és bináris protokollba kódolva, így a duplikációs költségek jelentősen csökkennek az UDP-hez képest. A viszonylag nagy számú bejövő metrika ellenére a felhalmozás nagyon kevés memóriát és még kevesebb CPU-t igényel. Jól tömöríthető metrikáink számára ez csupán néhány tucat megabájt adatot jelent. További bónusz, hogy elkerülhetjük a felesleges adatfelülírásokat a Graphite-ban, ahogy az a burbeck esetében történt.
A UDP csomagok a hálózati berendezéseken a hálózati eszközök között egyszerű Round Robin módszerrel vannak elosztva. Magától értetődik, hogy a hálózati hardver nem elemzi a csomagok tartalmát, és ezért sokkal többet képes kezelni, mint 4M csomag másodpercenként, nem is beszélve a metrikákról, amelyekről egyáltalán nem tud. Figyelembe véve, hogy a metrikák nem egyenként érkeznek minden csomagban, nem előrelátható teljesítményproblémák ebből a szempontból. Ha a szerver leáll, a hálózati eszköz gyorsan (1-2 másodpercen belül) észleli ezt, és eltávolítja a leállt szervert a rotációból. Ennek eredményeként a passzív (azaz nem vezető) csomópontokat úgy lehet be- és kikapcsolni, hogy szinte észre sem vesszük a grafikonokon a csökkenést. A legrosszabb, amit veszítünk, az az utolsó másodpercben érkezett metrikák egy része. A vezető váratlan elvesztése/kikapcsolása/átkapcsolása még mindig egy kis anomáliát okoz (a 30 másodperces intervallum továbbra is szinkronizálatlan), de ha van kapcsolat a csomópontok között, akkor ezeket a problémákat minimálisra lehet csökkenteni, például szinkronizáló csomagok küldésével.
Néhány szó a belső felépítésről. Az alkalmazás természetesen párhuzamos, de a szálak architektúrája eltér a brubeckben használtól. A brubeckben a szálak azonosak - mindegyik egyszerre felelős az információgyűjtésért és az aggregálásért. A bioyinó munkaszálai (workers) két csoportra vannak osztva: az egyik a hálózatért, a másik az aggregációért felel. Ez a felosztás lehetővé teszi, hogy rugalmasabban kezeljük az alkalmazást a metrikák típusa szerint: ahol intenzív aggregáció szükséges, növelhetjük az aggregátorok számát, ahol sok a hálózati forgalom - ott pedig a hálózati szálak számát növelhetjük. Jelenleg szervereink 8 hálózati és 4 aggregáló szálon működnek.
Az aggregáló (aggregációval foglalkozó) rész viszonylag unalmas. A hálózati szálak által feltöltött pufferek elosztásra kerülnek az aggregáló szálak között, ahol később feldolgozásra és aggregálásra kerülnek. A metrikák kérésére más csomópontokra való küldésre kerülnek. Mindez, beleértve az adatküldést a csomópontok között és a Consul-lal való munkát, aszinkron módon történik, a keretrendszeren alapul. .
A hálózati rész, amely a metrikák fogadásáért felelős, sokkal több problémát okozott a fejlesztés során. A hálózati folyamatok külön entitásokba való kiemelésének fő célja az volt, hogy csökkentse az időt, amelyet a folyamat eltölt nem az adatokat a socketből való olvasásra. Az aszinkron UDP és a hagyományos recvmsg használatával kapcsolatos lehetőségek gyorsan elbuktak: az első túl sok user-space CPU-t igényel az események feldolgozásához, a második pedig túl sok kontextusváltást igényel. Ezért most nagy bufferrel használunk (és a bufferek, hölgyeim, nem éppen triviális dolgok!). A hagyományos UDP támogatását fenntartottuk az alacsony terhelésű esetekhez, amikor a recvmmsg nem szükséges. A multimessage módban sikerül elérni a fő célt: a hálózati folyamat túlnyomó többsége az operációs rendszer sorát takarítja el — az adatokat kiolvassa a socketből és áthelyezi a userspace bufferbe, csak ritkán kapcsolódva arra, hogy a megtelt buffert átadja az aggregátoroknak. A socketben a sor gyakorlatilag nem halmozódik fel, a kidobott csomagok száma szinte nem növekszik.
Megjegyzés
Az alapértelmezett beállítások szerint a buffer mérete elég nagyra van állítva. Ha esetleg úgy dönt, hogy saját maga kipróbálja a szervert, lehet, hogy belefut arra, hogy egy kis mennyiségű metrika elküldése után azok nem érkeznek meg a Graphite-ba, hanem a hálózati folyamat bufferében maradnak. Kis mennyiségű metrikák esetén a konfigurációban a bufsize és task-queue-size értékeket kisebbre kell állítani.
Végül — itt van néhány grafikon a grafikonok kedvelőinek.
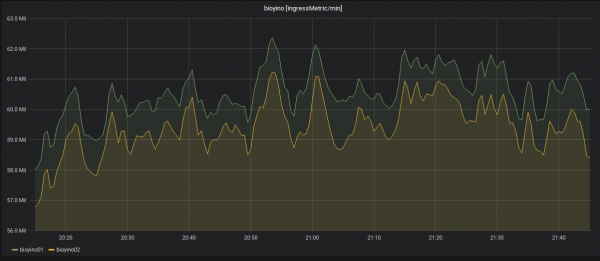
A bejövő metrikák számának statisztikája minden szerverre vonatkozóan: több mint 2 millió MPS.
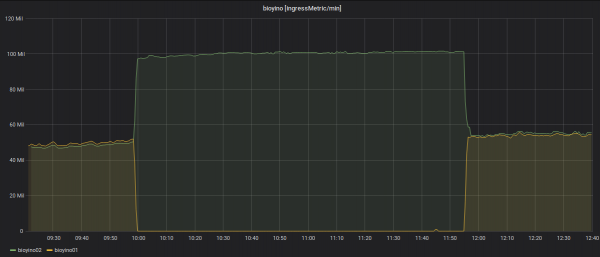
Az egyik node leállítása és a bejövő metrikák újraelosztása.
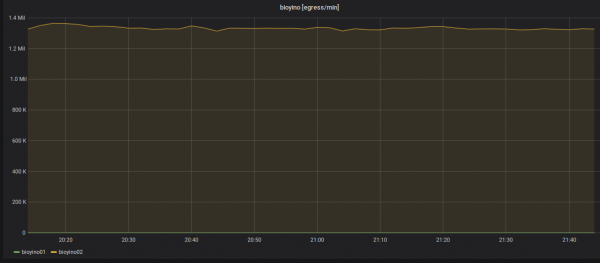
A kimenő metrikák statisztikája: mindig csak egy node küld — a raidboss.
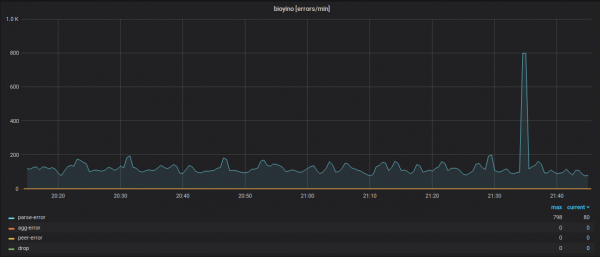
Minden node működésének statisztikái a rendszer különböző moduljaiban előforduló hibák figyelembevételével.
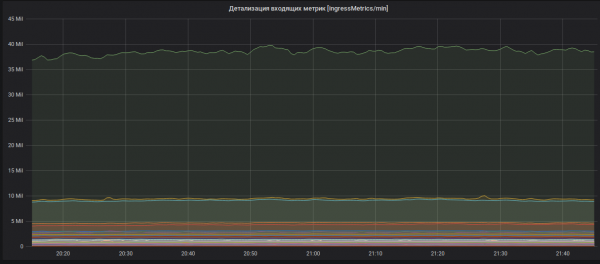
A bejövő metrikák részletezése (a metrikák nevei el vannak rejtve).
Mit tervezünk tenni mindezzel a jövőben? Természetesen kódot írni, hűha! A projekt eredetileg open-source projektnek indult, és így is marad egész élete során. A közeljövő tervei között szerepel a saját Raft verzióra való áttérés, a peer-protokoll átváltása egy hordozhatóbb megoldásra, további belső statisztikák hozzáadása, új metrikatípusok bevezetése, hibák javítása és egyéb fejlesztések.
Természetesen örömmel várunk mindenkit, aki segítene a projekt fejlődésében: készítsetek PR-t, Issues-t, amennyire csak lehet, válaszolni fogunk, finomítani fogunk stb.
Ezzel, ahogy mondani szokták, ennyi volt, vegyétek meg a mi elefántjainkat!
Forrás: habr.com
