

Jelenleg a „Bitrix24” szolgáltatás nem rendelkezik több száz gigabitnyi forgalommal, és nem áll rendelkezésére hatalmas szerverpark (bár természetesen sok van). De sok ügyfél számára ez a legfontosabb munkaeszköz a cégben, valóban business-critical alkalmazás. Ezért nem szabad, hogy leálljon – semmiképpen sem. Mi van, ha mégis bekövetkezik a leállás, de a szolgáltatás olyan gyorsan „feltámad”, hogy senki sem veszi észre? Hogyan lehet megvalósítani a failovert a munka minősége és az ügyfelek száma csökkenése nélkül? Alexander Demidov, a „Bitrix24” felhőszolgáltatásokért felelős igazgatója beszélt blogunknak arról, hogyan fejlődött a biztonsági rendszer a termék 7 éve alatt.
SaaS formátumban 7 éve indítottuk el a „Bitrix24”-et. Talán a fő nehézség a következő volt: a nyilvános SaaS indításig ez a termék csupán dobozos megoldásként létezett. Az ügyfelek megvették tőlünk, a saját szervereiken helyezték üzembe, létrehozták a vállalati portált - közös megoldást a munkatársak közötti kommunikációra, fájlok tárolására, feladatkezelésre, CRM-re, stb. 2012-re úgy döntöttünk, hogy ezt SaaS-ként szeretnénk elindítani, magunk adminisztrálva, biztosítva a megbízhatóságot és a hibatűrést. Tapasztalatokat a folyamat során szereztünk, mert addig még nem volt ilyen tapasztalatunk – csak szoftvergyártók voltunk, nem szolgáltatók.
A szolgáltatás indításakor tudtuk, hogy a legfontosabb a hibatűrés, megbízhatóság és a szolgáltatás folyamatos elérhetősége, mert ha van egy sima weboldalad, például egy bolt, és az leáll egy órára – akkor csak te magad szenvedsz, elveszíted a rendeléseket, elveszíted az ügyfeleket, de a te ügyfeled számára ez nem olyan kritikus. Persze csalódott, de elmegy és vásárol egy másik weboldalon. De ha ez egy alkalmazás, amelyre a cég munkája, kommunikációja és döntései épülnek, akkor a legfontosabb az, hogy megszerezzük a felhasználók bizalmát, tehát nem szabad őket cserben hagyni és leállni. Mert ha valami belül nem működik, az egész munka megakad.
Bitrix24 mint SaaS
Az első prototípust egy évvel a nyilvános indítás előtt, 2011-ben állítottuk össze. Körülbelül egy hét alatt megvolt, megnéztük, megforgattuk – még működőképes is volt. Tehát be lehetett lépni az űrlapba, megadni a portál nevét, és egy új portálhoz jutottunk el, felépült a felhasználói adatbázis. Megnéztük, értékeltük a terméket, majd bezártuk, és egy egész évig tovább dolgoztunk rajta. Mert nagy célunk volt: nem akartunk két különböző kódalapot készíteni, nem akartunk külön box terméket és külön felhőmegoldásokat fenntartani - mindezt egy kód keretein belül szerettük volna megvalósítani.
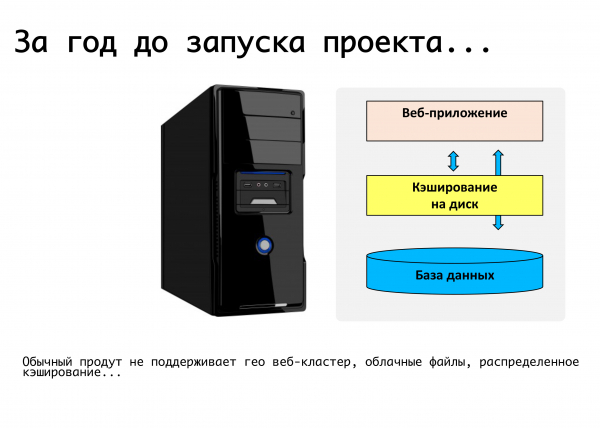
Akkoriban egy tipikus webalkalmazás egy szerveren futó php kód volt, mysql adatbázissal, fájlok feltöltésével, dokumentumokkal és képekkel, amik az upload mappába kerültek - és ennyi. Sajnos egy ilyen alapú kritikus szempontból megbízható webszolgáltatást nem lehetett indítani. Ott nem támogatott a megosztott gyorsítótár, az adatbázisok replikációja nem volt lehetséges.
Megfogalmaztuk az igényeket: az a képesség, hogy különböző helyszíneken helyezkedjen el, támogassa a replikációt, ideálisan különböző földrajzilag elosztott adatközpontokban. El kell választani a termék logikáját és magát az adatokat. Dinamikusan képesnek kell lennie a terhelés skálázására, a statikus tartalmat pedig teljesen ki kell emelni. Ezekből a szempontokból alakultak ki a termék igényei, amelyet pontosan egy éven át finomítottunk. Ebben az időszakban a platform, amely végül egységes lett - a dobozos megoldásokhoz, a saját szolgáltatásunkhoz - támogatást kapott azokra a dolgokra, amelyekre szükségünk volt. A mysql replikáció támogatása magának a terméknek a szintjén: tehát a fejlesztő, aki a kódot írja - nem kell gondolkodnia, vajon hogyan osztódnak a kérései, használja a mi api-nkat, és mi tudjuk helyesen elosztani a írási és olvasási kéréseket a mesterek és a slave-ek között.
Támogatást nyújtottunk a termék szintjén különböző felhőalapú objektumtárolókhoz: google storage, amazon s3 - plusz, open stack swift támogatása. Ezért ez kényelmes volt számunkra mint szolgáltatás, és a dobozos megoldással dolgozó fejlesztőknek: ha egyszerűen a mi api-nkat használják, nem kell gondolkodniuk, hol fog végül a fájl tárolódni, helyben a fájlrendszeren vagy egy objektumtárolóba kerül.
Végül azonnal eldöntöttük, hogy az egész adatközpontra fogunk tartalékolni. 2012-ben teljes mértékben az Amazon AWS-en indultunk, mert már volt tapasztalatunk ezzel a platformmal – a saját weboldalunk ott volt elhelyezve. Az vonzott bennünket, hogy az Amazonban minden régióban több elérhetőségi zóna van – lényegében (a terminológiájuk szerint) több adatközpont, amelyek többé-kevésbé függetlenek egymástól, és lehetővé teszik a tartalékolást egy egész adatközpont szintjén: ha az elromlik, az adatbázisok master-master módon replikálódnak, a webalkalmazás szerverek tartalékolva vannak, a statikus tartalom pedig az s3 objektumtárolóba került. A terhelés kiegyenlítése – akkor az Amazon elb-jével, de kicsivel később saját terhelésmegosztóinkhoz jutottunk, mert bonyolultabb logikára volt szükségünk.
Amit akartunk – azt meg is kaptuk...
Minden alapvető dolgot, amit biztosítani akartunk – a szerverek, webalkalmazások és adatbázisok megbízhatóságát – mind jól működött. A legegyszerűbb forgatókönyv: ha bármelyik webalkalmazásunk elromlik, akkor itt minden egyszerű – ki vannak kapcsolva a terhelésmegosztásból.
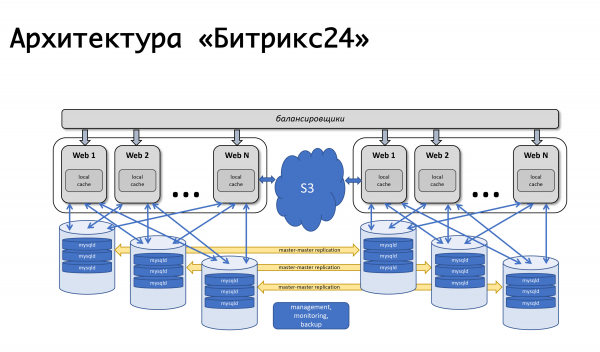
Az elromlott gépeket a terheléselosztó (akkor az Amazon elb volt) automatikusan megjelölte unhealthy-ként, és leállította a terhelés elosztását rajtuk. Működött az Amazon auto-scaling: amikor a terhelés nőtt, új gépek kerültek az auto-scaling csoportba, a terhelés az új gépekre oszlott el – minden rendben volt. A saját terhelésmegosztóinkkal a logika nagyjából ugyanaz: ha valami történik az alkalmazásszerverrel, eltávolítjuk róla a kéréseket, kivesszük ezeket a gépeket, újakat indítunk, és folytatjuk a munkát. A rendszer az évek során kicsit változott, de továbbra is működik: egyszerű, érthető, és ezzel nincs semmiféle nehézség.
Világszerte dolgozunk, az ügyfelek terhelési csúcsai teljesen különbözőek, és igazából lehetőséget kell adnunk arra, hogy a rendszerünk bármely komponensével bármikor karbantartási munkálatokat végezhessünk – az ügyfelek számára észrevétlenül. Ezért lehetőségünk van lekapcsolni az adatbázist, a terhelést pedig áthelyezve a második adatközpontra.
Hogyan működik ez az egész? — A forgalmat a működő adatközpontra irányítjuk — ha ez egy adatközponti hiba, akkor teljesen, ha tervezett karbantartás van egy adott adatbázison, akkor a forgalom egy részét, amely ezeket az ügyfeleket szolgálja ki, átirányítjuk a második adatközpontra, a replikáció pedig leáll. Ha új gépekre van szükség webalkalmazásokhoz, mivel megnőtt a terhelés a második adatközpontban, akkor automatikusan elindulnak. A munkálatokat befejezzük, a replikáció helyreáll, és visszaállítjuk az összes terhelést. Ha tükrözve kell végezni bizonyos munkálatokat a második DC-ben, például rendszernyűjtések telepítése vagy beállítások megváltoztatása a második adatbázisban, akkor lényegében ugyanazt ismételjük meg, csak a másik irányba. Ha viszont hiba történik, akkor a legegyszerűbben járunk el: a monitoring rendszerben eseménykezelő mechanizmust használunk. Ha több ellenőrzés aktiválódik, és a státusz kritikusra vált, akkor elindul ez a kezelő, amit különböző logikák végrehajtására terveztek. Minden adatbázisunkhoz meg van határozva, hogy melyik szerver a failover, és hová kell átirányítani a forgalmat, ha az nem érhető el. Történelmileg úgy alakult, hogy valamilyen formában nagios-t vagy annak forkjait használjuk. Alapvetően ilyen mechanizmusok szinte bármilyen monitoring rendszerben elérhetőek, egyelőre nem használunk bonyolultabbat, de lehetséges, hogy a jövőben majd fogunk. Jelenleg a monitoring az elérhetetlenségre aktiválódik, és képes arra, hogy valamit átirányítson.
Mindent lefoglaltunk?
Sok ügyfelünk van az Egyesült Államokból, sok ügyfelünk van Európából, sok ügyfelünk, aki közelebb van a Kelethez – Japán, Szingapúr és így tovább. Természetesen egy hatalmas része az ügyfeleinknek Oroszországból származik. Tehát a munka nem korlátozódik egy régióra. A felhasználók gyors válaszidőt szeretnének, vannak követelmények, amelyek a különböző helyi törvények betartására vonatkoznak, és minden régión belül két adatközpontot rezerválunk, plusz vannak olyan kiegészítő szolgáltatások, amelyeket megint csak kényelmes elhelyezni egy régión belül – azoknak az ügyfeleknek, akik ezen a területen dolgoznak. A REST kezelők, az autorizáló szerverek kevésbé kritikusak az ügyfél általános működése szempontjából, ezeken egy kis elfogadható késleltetéssel lehet váltani, de nem akarjuk feltalálni a kerék újra, hogy hogyan kell ezeket monitorozni és mit kell velük csinálni. Ezért a maximumot próbáljuk kihozni a már meglévő megoldásokból, és nem fejlesztünk egy újabb kompetenciát kiegészítő termékek terén. Valahol egyszerűen dns szinten váltunk, és a szolgáltatás élét éppen a dns határozza meg. Az Amazonnál van a Route 53 szolgáltatás, de ez nem csak egy dns, amelybe fel tudod vinni a bejegyzéseket, és kész – sokkal rugalmasabb és kényelmesebb. Ezen keresztül geo-elosztott szolgáltatásokat lehet kialakítani geolokációkkal, amikor ezen keresztül határozod meg, honnan érkezett az ügyfél, és adsz neki az egyes bejegyzésekből – ezen keresztül failover-architektúrákat lehet kialakítani. Ugyanazokat az health-checks-et a Route 53-ban lehet beállítani, ahol megadod az endpointokat, amelyeket monitorozni kell, megadod a metrikákat, megadod, hogy mely protokollok segítségével határozzuk meg a szolgáltatás „élőségét” – tcp, http, https; megadod a vizsgálatok gyakoriságát, amely meghatározza, hogy a szolgáltatás él-e vagy sem. A dns-ben pedig megadod, mi lesz az elsődleges, mi lesz a másodlagos, hová kell váltani, ha a health-check a Route 53-ban aktiválódik. Mindez más eszközökkel is megvalósítható, de az a kényelmes benne, hogy egyszer beállítod, és ezután egyáltalán nem kell aggódnunk azon, hogy hogyan zajlanak a vizsgálatok, hogyan történik a váltás: minden automatikusan működik.
Első „de”: de mivel és hogyan lehet biztonsági másolatot készíteni a Route 53-ról? Ki tudja, mi történik vele? Szerencsére eddig nem ütköztünk hasonló problémákba, de eljön az idő, amikor elmondom, miért gondoltuk, hogy mégiscsak érdemes biztonsági másolatot készíteni. Itt időben felkészítjük magunkat. Naponta többször teljes adatmentést végzünk az összes zónáról, amelyet létrehoztunk a Route 53-ban. Az Amazon API-ja lehetővé teszi, hogy ezeket nyugodtan JSON formátumban átadjuk, és több biztonsági szervert üzemeltetünk, ahová ezt konvertáljuk, exportáljuk konfiguráció formájában, és mondhatni, van egy biztonsági konfigurációnk. Ha bármi történik, gyorsan, kézzel tudjuk telepíteni, nem veszítjük el a DNS beállítások adatait.
A második 'de': mi az, ami még nincs biztosítva? Maga a terheléselosztó! Az ügyfelek regionális elosztását nagyon egyszerűen megoldottuk. Van bitrix24.ru, bitrix24.com, .de domainünk – most körülbelül 13 különböző, amelyek a legkülönfélébb zónákban működnek. Arra a következtetésre jutottunk, hogy minden régióban saját terheléselosztók legyenek. Ez kényelmesebb a régiók közötti elosztáshoz, attól függően, hogy hol van a legnagyobb hálózati terhelés. Ha egy adott terheléselosztónál hiba lép fel, akkor azt egyszerűen kivonjuk a forgalomból, és eltávolítjuk a DNS-ből. Ha több terheléselosztó csoportban merül fel probléma, akkor más helyeken biztosítják őket, és a közöttük való átkapcsolás ugyanazzal a Route 53-mal történik, mert a rövid TTL miatt a váltás maximum 2, 3, 5 percen belül megtörténik.
A harmadik 'de': mi az, ami még nincs biztosítva? Az S3, igaz. Amikor a felhasználók által tárolt fájlokat helyezzük el az S3-ban, őszintén hittük, hogy az biztos, és nincs szükség a biztonsági másolatra. De a történelem azt mutatja, hogy a dolgok másképp alakulnak. Az Amazon általában az S3-at alapvető szolgáltatásként írja le, mert maga az Amazon is az S3-at használja virtuális gépek képeinek, konfigurációknak, AMI képeknek, pillanatképnek a tárolására... És ha az S3 leáll, mint ahogy egyszer megtörtént az elmúlt 7 évben, amióta a Bitrix24-et használjuk, akkor rengeteg minden mást is magával ránt — a virtuális gépek indításának elérhetetlensége, API működési hibák, és így tovább.
S3 is capable of failure — it happened once. Therefore, we came to the following conclusion: several years ago, there were no serious public object storage options in Russia, and we considered creating something of our own... Fortunately, we didn't start this, as we would have been buried in expertise we lacked and would have inevitably made mistakes. Now, there are S3-compatible storage solutions available from Mail.ru, Yandex, and several other providers. In the end, we realized that we want, firstly, redundancy, and secondly, the ability to work with local copies. For the specific Russian region, we use the Mail.ru Hotbox service, which is API-compatible with S3. We didn't need significant code changes in our application, and we implemented the following mechanism: there are triggers in S3 that activate on the creation/deletion of objects, and Amazon has a service called Lambda — this is serverless code execution that occurs when those triggers are activated.
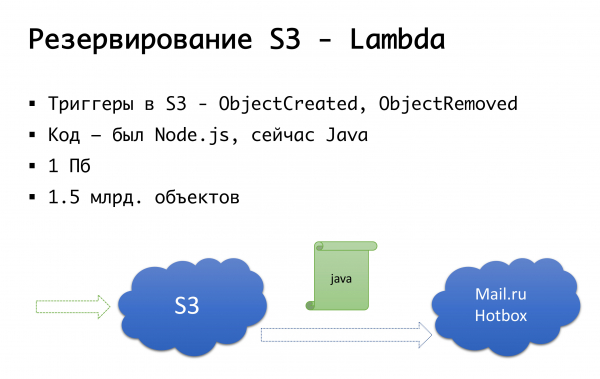
We made it very simple: if a trigger is activated, we execute code that copies the object to Mail.ru storage. To fully initiate operation with local data copies, we also need reverse synchronization so that clients located in the Russian segment can work with storage that is closer to them. Mail is about to complete the triggers in their storage — it will soon be possible to execute reverse synchronization at the infrastructure level, but for now, we handle this at the level of our own code. If we see that a client has uploaded a file, we place an event in the queue at our code level, process it, and perform reverse replication. The downside is that if any operations occur with our objects outside our product, meaning through external means, we won't account for that. Therefore, we wait until the triggers at the storage level are available, so that regardless of where our code is executed, the object that comes to us is copied in the opposite direction.
A kód szintjén minden egyes ügyfél számára mindkét tároló be van állítva: az egyik főként, a másik pedig biztonsági másolatként működik. Ha minden jól megy, azzal a tárolóval dolgozunk, amelyik közelebb van hozzánk: például a mi ügyfeleink, akik az Amazonon vannak, az S3 at használják, míg akik Oroszországban dolgoznak, ők a Hotbox-t használják. Ha aktiválódik a kapcsoló, akkor failover-nek kell bekapcsolnia, és átállítjuk az ügyfeleket egy másik tárolóra. Ezt a kapcsolót regionálisan függetlenül tudjuk állítani, és ide-oda kapcsolgatni. Gyakorlatban még nem használtuk, de ezt a mechanizmust előirányoztuk, és úgy gondoljuk, hogy egyszer még szükségünk lesz az átkapcsolásra. Egyszer már megtörtént ez.
Ó, az Amazon elment tőletek...
Idén áprilisban van a Telegram oroszországi blokkolásainak évfordulója. A legjobban érintett szolgáltató, aki áldozatul esett ennek, az Amazon. Sajnos, az orosz cégek, akik az egész világra dolgoztak, további károkat szenvedtek el.
Ha a cég globális és Oroszország egy nagyon kis szegmenst képvisel számára, 3-5% -ot, akkor így vagy úgy, áldozatot kell hozni.
Ha ez egy kifejezetten orosz cég — biztos vagyok benne, hogy helyben kell működniük — egyszerűen a felhasználóknak kényelmes lesz, az kockázatok pedig csökkennek.
De ha ez egy globálisan működő cég, amelynek körülbelül egyenlő számú ügyfele van Oroszországból és világszerte, akkor a szegmensek közötti kapcsolódás fontos, és akármilyen módon együtt kell működniük.
Még 2018 március végén a Roskomnadzor levelet küldött a legnagyobb szolgáltatóknak, hogy tervezik néhány millió amazon ip blokkolását, hogy blokkolják... a Zello üzenetküldőt. Köszönjük ezeknek a szolgáltatóknak — sikeresen kiszivárogtatták a levelet, és világossá vált, hogy a kapcsolódás az Amazonhoz megszakadhat. Ez péntek volt, pánikban futottunk a servers.ru kollégáihoz, mondván: „Barátok, szükségünk van néhány szerverre, amelyek nem Oroszországban, nem az Amazonon, hanem például valahol Amszterdamban állnak, hogy legalább valamilyen módon telepíthessük ott a saját vpn és proxy bizonyos endpointokhoz, amelyekre semmiképpen nem tudunk hatni, például ugyanannak az s3-nak az endpointjai — nem lehet új szolgáltatást indítani és más IP-t kapni, úgyis el kell jutnunk oda. Néhány nap alatt ezeket a szervereket beállítottuk és üzembe helyeztük, és általában a blokkolások kezdete előtt felkészültünk. Érdekes, hogy a RKN, látva a felhajtást és a pánikot, azt mondta: „Nem, most nem fogunk semmit blokkolni.” (De ez pontosan addig tartott, amíg el nem kezdték a Telegram blokkolását.) A lehetőségek beállítása után és mivel tudtuk, hogy a blokkolást nem vezették be, azért nem kezdtük el az egészet szétszedni. Csak úgy, a biztonság kedvéért.
És így 2019-ben tényleg blokkolások között élünk. Tegnap éjjel néztem: körülbelül egymillió IP-t továbbra is blokkolnak. Igaz, az Amazon szinte teljes egészében feloldották, a csúcsidőszakban elérte a 20 millió címet… A valóság az, hogy a kapcsolatok, a jó kapcsolatok — ezek néha hiányozhatnak. Hirtelen. Technikai okok miatt hiányozhatnak — tűz, ásók, ilyesmi. Vagy, ahogy láttuk, nem egészen technikai okok miatt. Tehát valaki nagy és jelentős, saját AS-kkal valószínűleg más utakon tudja ezeket kezelni — direct connect és egyéb dolgok már szinten l2. De az egyszerűbb megoldásban, ahogy mi vagy más kisebbek, érdemes biztonsági másolatot tartani a szerverek szintjén, amelyek valahol máshol vannak, előre beállított VPN-nel, proxy-kal, a lehetőséggel, hogy gyorsan átkapcsoljuk a konfigurációt azokban a szegmensekben, amelyek kritikusak a kapcsolatok szempontjából. Ezt többször is használtuk, amikor elkezdődtek az Amazon blokkolások, ilyenkor a legrosszabb esetben a S3 forgalmát éppen rajtuk keresztül irányítottuk, de ezt fokozatosan megoldottuk.
És hogyan lehet biztonsági másolatot készíteni… egy teljes szolgáltatóról?
Jelenleg nincs forgatókönyvünk arra az esetre, ha az egész Amazon leállna. Van egy hasonló forgatókönyvünk Oroszországra. Oroszországban egy szolgáltatónál helyezkedtünk el, ahol kiválasztottuk, hogy több helyszínünk legyen. És egy éve problémával szembesültünk: még ha két adatközpont is létezik, a szolgáltató hálózati konfigurációjának szintjén is lehetnek problémák, amelyek mindkét adatközpontot érintik. Ezáltal mindkét helyszínen elérhetetlenséget tapasztalhatunk. Természetesen ez valóban így történt. Végül újraértékeltük a belső architektúrát. Ez nem változott meg jelentősen, de Oroszországban most két helyszínünk van, amelyek nem egy szolgáltatónál, hanem két különbözőnél találhatók. Ha az egyik meghibásodik, átválthatunk a másikra.
Hipotetikusan az Amazon számára megfontoljuk, hogy egy másik szolgáltató szintjén biztosítsunk tartalékot; talán a Google-t, talán valaki mást... De eddig tapasztalataink szerint, ha az Amazonon belül egy availability zónában történik baleset, a teljes régióra kiterjedő balesetek meglehetősen ritka jelenségek. Tehát elméletileg van elképzelésünk arról, hogy lehet, hogy „Amazon - nem Amazon” tartalékot szervezünk, de gyakorlatilag ilyesmi eddig nincs.
Néhány szó az automatizálásról
Mindig szükség van automatizálásra? Itt érdemes megemlíteni a Dunning-Kruger hatást. Az „x” tengelyen a tudásunk és tapasztalatunk áll, amelyet megszereztünk, míg az „y” tengelyen a cselekvésünk iránti bizalmunk. Először nem tudunk semmit, és teljesen bizonytalanok vagyunk. Ezután tudunk egy kicsit, és hiperbiztosak leszünk – ez a „butaság csúcsa”, amit a „bölcsesség és bátorság” kép illusztrál. Később már valamennyire tanultunk, és készen állunk a harcra. Aztán kerülünk valami óriási csapdába, belekerülünk a kétségbeesés völgyébe, amikor úgy tűnik, hogy tudunk valamit, de valójában sok mindent nem tudunk. Ezután a tapasztalatokkal egyre magabiztosabbá válunk.
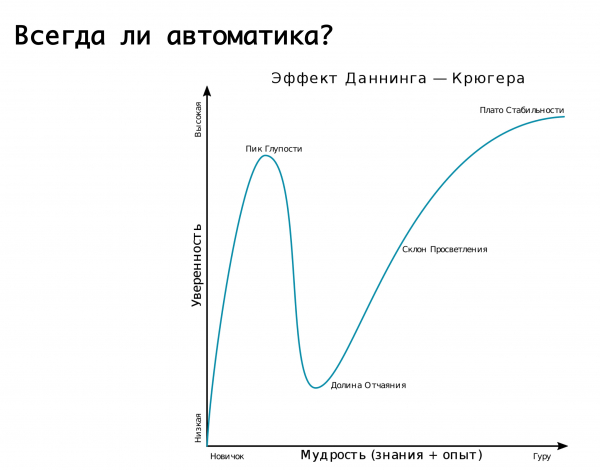
Az a logika, amit az automatikus átkapcsolásokkal a különféle hibákra építünk, nagyon jól leírható ezzel a grafikon. Elkezdtük — még semmit sem tudtunk, gyakorlatilag minden munkát kézzel végeztünk. Aztán rájöttünk, hogy mindent automatizálni lehet, így könnyebben aludhatunk. És hirtelen a legnagyobb hibák közepette találjuk magunkat: a hamis riasztások miatt oda-vissza kapcsolgatjuk a forgalmat, amikor valójában nem kellett volna. Ennek következményeként megszakadhat a replikáció vagy más probléma léphet fel — ez a kétségbeesés völgye. Ezután arra jutunk, hogy mindent ésszel kell kezelni. Vagyis érdemes bízni az automatizálásban, felkészülve a hamis riasztások lehetőségére. De! Ha a következmények pusztítóak lehetnek, akkor jobb, ha ezt a feladatot a váltott ügyeletesekre bízzuk, akik biztosítják, hogy valóban hiba történt, és a szükséges lépéseket manuálisan végrehajtják...
Zárás
Hét év alatt eljutottunk odáig, hogy amikor valami leállt, — pánik volt, a megértéshez, hogy nincsenek problémák, csak feladatok, amelyek megoldásra várnak — és ez lehetséges. Amikor építünk valamilyen szolgáltatást, ránézünk a dologra felülről, felmérjük az összes kockázatot, ami előfordulhat. Ha azonnal észleljük őket, akkor előre tervezzük meg a redundanciát és a hibatűrő infrastruktúra kialakításának lehetőségét, mert bármely olyan elem, amely hibásan működhet és a szolgáltatás megszűnését okozhatja — az biztosan el fog romlani. És még ha úgy tűnik, hogy egyes infrastruktúraelemek, mint például az s3, biztosan nem fognak meghibásodni — azért tartsuk szem előtt, hogy mégis előfordulhat. Legalább elméletben legyen bennünket elképzelés arról, mit fogunk tenni velük, ha valami baj történik. Legyen vészhelyzeti tervünknk a kockázatok kezelésére. Amikor arra gondolsz, hogy mindent automatizálj vagy kézzel végezz, — mérd fel a kockázatokat: mi történik, ha az automatizálás mindent átkapcsol — nem okoz-e ez még rosszabb helyzetet, mint a hiba? Lehet, hogy egy ésszerű kompromisszum szükséges az automatizálás és a műszakban lévő mérnök reakciója között, aki értékeli a valós helyzetet és megérti, hogy szükséges-e azonnal váltani, vagy „igen, de nem most”.
Ésszerű kompromisszum a perfekcionizmus és a tényleges erőforrások, idő és pénz között, amelyeket a végső rendszerre költhet.
Ez a szöveg Alexander Demidov előadásának kiegészített és kibővített változata a konferencián. .
Forrás: habr.com
