

Gyakran azok, akik a Data Science területére belépnek, nem teljesen reális elképzelésekkel rendelkeznek arról, hogy mi vár rájuk. Sokan úgy gondolják, hogy mostantól menő neurális hálókat fognak írni, Hangsegédet készítenek a Vasemberből, vagy mindenkit megvernek a pénzügyi piacokon.
De a munka Data a tudományos elemzőként az adatokra épül, és az egyik legfontosabb és időigényes pillanat az adatok feldolgozása, mielőtt azokat bemennénk egy neurális hálóba vagy valamilyen módon elemeznénk.
Ebben a cikkben csapatunk bemutatja, hogyan lehet könnyen és gyorsan feldolgozni az adatokat lépésről lépésre útmutatóval és kóddal. Igyekeztünk úgy megoldani, hogy a kód elég rugalmas legyen, és különböző adatbázisokhoz alkalmazható legyen.
Sok szakember talán nem talál semmi különöset ebben a cikkben, de a kezdők valószínűleg új dolgokat tanulhatnak, és mindazok, akik régóta álmodtak arról, hogy készítsenek egy külön notebookot az adatok gyors és strukturált feldolgozásához, lemásolhatják a kódot és személyre szabhatják, vagy
Megkaptuk az adatbázist. Mi a következő lépés?
Tehát a szabvány: meg kell értenünk, mivel állunk szemben, a teljes képet. Ehhez a pandas-t használjuk, hogy egyszerűen meghatározzuk a különböző adattípusokat.
import pandas as pd #pandas importálása
import numpy as np  #numpy importálása
df = pd.read_csv("AB_NYC_2019.csv") #az adatbázis beolvasása és a df változóhoz való rendelés
df.head(3) #megnézzük az első 3 sort, hogy lássuk, hogy néznek ki az értékek 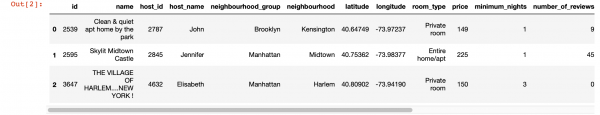
df.info() #Az oszlopokkal kapcsolatos információk bemutatása 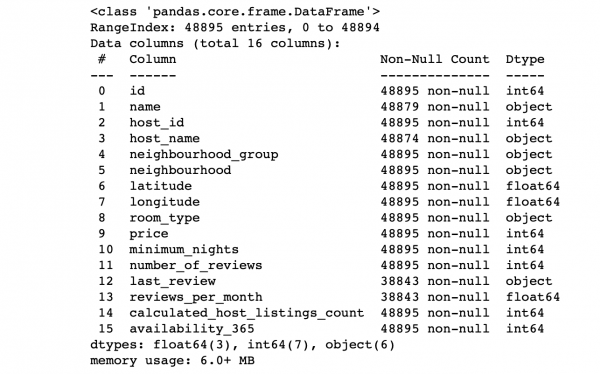
Nézzük meg az oszlopok értékeit:
- Megfelel-e az oszlopok sora a teljes sorok számának?
- Mik a tartalmak minden oszlopban?
- Melyik oszlopot szeretnénk célnak tekinteni a jövőbeni előrejelzésekhez?
Ezekre a kérdésekre adott válaszok lehetővé teszik az adatbázis elemzését, és nagyjából felvázolják a következő lépéseket.
Továbbá, ha alaposabb betekintést nyerünk az egyes oszlopok értékeibe, használhatjuk a pandas describe() függvényt. Azonban ennek a függvénynek a hátránya, hogy nem ad információt a string értékeket tartalmazó oszlopokról. Ezekkel később foglalkozunk.
df.describe() 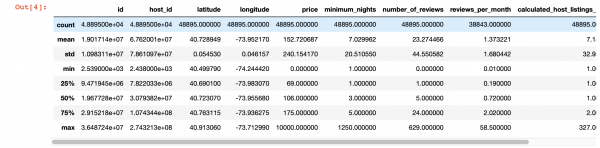
Varázslatos vizualizáció
Nézzük meg, hol teljesen hiányoznak az értékek:
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 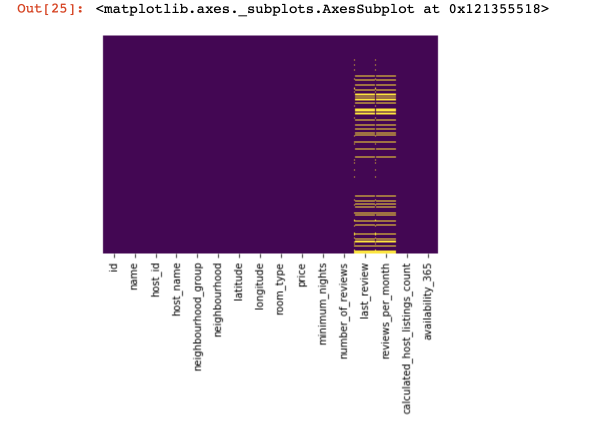
Ez egy rövid áttekintés volt, most pedig érdekesebb dolgokhoz fogunk átállni.
Próbáljuk meg megtalálni és, ha lehetséges, eltávolítani azokat az oszlopokat, amelyekben minden sorban csak egy érték található (ezek nem befolyásolják az eredményt):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Felülírjuk az adatállományt, csak azokat az oszlopokat hagyva meg, amelyekben több mint egy egyedi érték van
Most megóvjuk magunkat és a projektünk sikerét a duplikált soroktól (sorok, amelyek ugyanazt az információt tartalmazzák ugyanabban a sorrendben, mint már egy meglévő sor):
df.drop_duplicates(inplace=True) # Ezt tesszük, ha szükségesnek tartjuk.
                                 # Néhány projektben nem érdemes ilyen adatokat az elején eltávolítani.
Két részre osztjuk az adatállományt: az egyik minőségi értékeket, a másik pedig mennyiségiakat tartalmaz
Itt szükséges egy kis pontosítás: ha a hiányzó adatokkal rendelkező sorok a minőségi és mennyiségi adatok között erősen nem aránylanak, akkor döntést kell hozni arról, hogy mit áldozunk fel - az összes hiányzó adatú sort, csak ezek egy részét vagy bizonyos oszlopokat. Ha viszont a sorok aránylanak, akkor teljes joggal oszthatjuk két részre az adatállományt. Ellenkező esetben először foglalkozni kell a sorokkal, amelyekben a hiányzó adatok nem aránylanak a minőségi és mennyiségi adatokban, és csak utána oszthatjuk két részre az adatállományt.
df_numerical = df.select_dtypes(include=[np.number])
df_categorical = df.select_dtypes(exclude=[np.number])
Ezt azért tesszük, hogy könnyebb legyen kezelni ezeket a két különböző adattípust - később meg fogjuk érteni, mennyire megkönnyíti az életünket.
Dolgozzunk a mennyiségi adatokkal
Az első dolog, amit tennünk kell, hogy meghatározzuk, van-e "kémoszlop" a mennyiségi adatok között. Ezeket az oszlopokat így nevezzük, mert mennyiségi adatoknak álcázva magukat, valójában minőségi adatként működnek.
Hogyan tudjuk őket meghatározni? Természetesen ez attól függ, hogy milyen típusú adatokat elemez, de ezek az oszlopok általában kevesebb egyedi adatot tartalmaznak (körülbelül 3-10 egyedi értéket).
print(df_numerical.nunique())Miután meghatároztuk a kémoszlopokat, át fogjuk helyezni őket a mennyiségi adatokból a minőségi adatok közé:
spy_columns = df_numerical[['oszlop1', 'oszlop2', 'oszlop3']]# elkülönítjük a kém oszlopokat és külön dataframe-be mentjük
df_numerical.drop(labels=['oszlop1', 'oszlop2', 'oszlop3'], axis=1, inplace = True)# kivágjuk ezeket az oszlopokat a numerikus adatokból
df_categorical.insert(1, 'oszlop1', spy_columns['oszlop1']) # hozzáadjuk az első kém oszlopot a kategóriás adatokhoz
df_categorical.insert(1, 'oszlop2', spy_columns['oszlop2']) # hozzáadjuk a második kém oszlopot a kategóriás adatokhoz
df_categorical.insert(1, 'oszlop3', spy_columns['oszlop3']) # hozzáadjuk a harmadik kém oszlopot a kategóriás adatokhoz
Végre teljesen elkülönítettük a numerikus adatokat a kategóriástól, és most már alaposan tudunk dolgozni velük. Először is meg kell értenünk, hol vannak üres értékek (NaN, és bizonyos esetekben 0 is üres értéknek számít).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
Ezen a ponton fontos megérteni, hogy mely oszlopokban jelenthet a nulla hiányzó értékeket: ez összefügg a gyűjtési módokkal? Vagy lehet, hogy az adatok értékei miatt van ez így? Ezekre a kérdésekre minden egyes esetben választ kell adni.
Tehát, ha végül úgy döntöttünk, hogy az adatok hiányozhatnak ott, ahol nullák vannak, akkor a nullákat NaN-ra kell cserélni, hogy később könnyebb legyen dolgozni ezekkel az elveszett adatokkal:
df_numerical[["oszlop 1", "oszlop 2"]] = df_numerical[["oszlop 1", "oszlop 2"]].replace(0, nan)Most nézzük meg, hol vannak hiányzó adataink:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Az df_numerical.info() is hasznos lehet 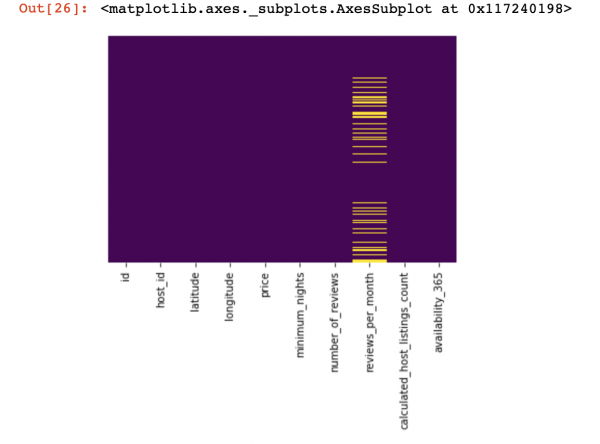
Itt sárga színnel kellene jelölni azokat az értékeket az oszlopokban, amelyek hiányoznak. És most kezdődik az igazi érdekesség - hogyan kezeljük ezeket az értékeket? Eltávolítsuk a sorokat ezekkel az értékekkel, vagy eltávolítsuk az oszlopokat? Vagy töltsük ki ezeket az üres értékeket valami mással?
Itt van egy általános séma, amely segíthet eldönteni, hogy mit lehet kezdeni a hiányzó értékekkel:
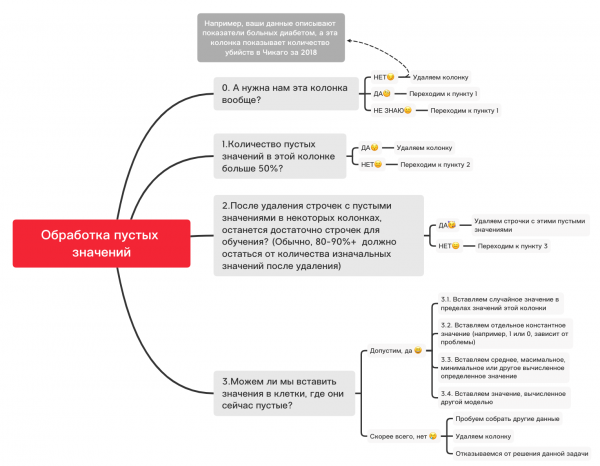
0. Eltávolítjuk a felesleges oszlopokat
df_numerical.drop(labels=["oszlop1","oszlop2"], axis=1, inplace=True)1. A hiányzó értékek száma ezen az oszlopon meghaladja az 50%-ot?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["oszlop1","oszlop2"], axis=1, inplace=True)# Eltávolítjuk, ha bármelyik oszlopnak több mint 50 hiányzó értéke van2. Eltávolítjuk a sorokat a hiányzó értékekkel
df_numerical.dropna(inplace=True)#Eltávolítjuk az üres értékkel rendelkező sorokat, ha elegendő adat marad a tanuláshoz3.1. Véletlen érték beszúrása
import random #véletlenszám importálása
df_numerical["oszlop"].fillna(lambda x: random.choice(df[df[column] != np.nan]["oszlop"]), inplace=True) #véletlenszerű értékek beillesztése az üres cellákba
3.2. Állandó érték beszúrása
from sklearn.impute import SimpleImputer #SimpleImputer importálása, amely segít az értékek beillesztésében
imputer = SimpleImputer(strategy='constant', fill_value="") #konkrét érték beillesztése SimpleImputer segítségével
df_numerical[["uj_oszlop1",'uj_oszlop2','uj_oszlop3']] = imputer.fit_transform(df_numerical[['oszlop1', 'oszlop2', 'oszlop3']]) #A táblázatunkra való alkalmazás
df_numerical.drop(labels = ["oszlop1","oszlop2","oszlop3"], axis = 1, inplace = True) #Az oszlopok eltávolítása a régi értékekkel
3.3. Átlag vagy leggyakoribb érték beszúrása
from sklearn.impute import SimpleImputer #SimpleImputer importálása, amely segít az értékek beillesztésében
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #mean helyett leggyakoribb is használható
df_numerical[["uj_oszlop1",'uj_oszlop2','uj_oszlop3']] = imputer.fit_transform(df_numerical[['oszlop1', 'oszlop2', 'oszlop3']]) #A táblázatunkra való alkalmazás
df_numerical.drop(labels = ["oszlop1","oszlop2","oszlop3"], axis = 1, inplace = True) #Az oszlopok eltávolítása a régi értékekkel
3.4. Egy másik modell által számított érték beszúrása
Néha az értékeket regressziós modellek segítségével lehet kiszámítani, a sklearn könyvtár vagy más hasonló könyvtárak modelljeivel. Csapatunk egy külön cikket szentel annak, hogyan lehet ezt a közeljövőben megtenni.
Tehát most a mennyiségi adatokkal kapcsolatos elbeszélés megszakad, mivel sok más szempont van, amelyek segíthetnek a legjobb adat-előkészítés és -előfeldolgozás során különböző feladatokhoz, és az alapvető dolgok a mennyiségi adatokkal kapcsolatosan e cikkben figyelembe lettek véve, és most itt az ideje visszatérni a minőségi adatokhoz, amelyeket néhány lépéssel ezelőtt elválasztottunk a mennyiségi adatoktól. Ezt a notebookot átalakíthatod úgy, ahogyan szeretnéd, igazítva különböző feladatokhoz, hogy az adat-előfeldolgozás rendkívül gyorsan menjen!
Minőségi adatok
Alapvetően a minőségi adatokhoz a One-hot encoding módszert használják, hogy azokat string (vagy objektum) típusból számmá alakítsák. Mielőtt rátérnénk erre a pontra, használjuk az itt található sémát és kódot, hogy megértsük az üres értékeket.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 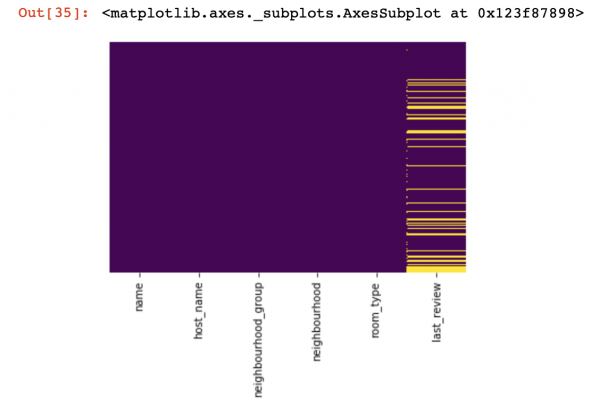
0. Eltávolítjuk a felesleges oszlopokat
df_categorical.drop(labels=["oszlop1", "oszlop2"], axis=1, inplace=True)1. A hiányzó értékek száma ezen az oszlopon meghaladja az 50%-ot?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["oszlop1", "oszlop2"], axis=1, inplace=True) # Eltávolítjuk, ha bármelyik oszlop
# több mint 50% üres értéket tartalmaz2. Eltávolítjuk a sorokat a hiányzó értékekkel
df_categorical.dropna(inplace=True) # Eltávolítjuk az üres értékű sorokat,
 # ha marad elég adat a tanuláshoz
3.1. Véletlen érték beszúrása
import random
df_categorical["oszlop"].fillna(lambda x: random.choice(df[df[column] != np.nan]["oszlop"]), inplace=True)
3.2. Állandó érték beszúrása
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["uj_oszlop1", 'uj_oszlop2', 'uj_oszlop3']] = imputer.fit_transform(df_categorical[['oszlop1', 'oszlop2', 'oszlop3']])
df_categorical.drop(labels=["oszlop1", "oszlop2", "oszlop3"], axis=1, inplace=True)
Tehát végre megtaláltuk az üres értékek kezelését a minőségi adatokban. Most itt az idő, hogy one-hot encodingot végezzünk az adatbázisában lévő értékeken. Ezt a módszert rendkívül gyakran alkalmazzák annak érdekében, hogy az Ön algoritmusa a minőségi adatok figyelembevételével tanulhasson.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["oszlop1", "oszlop2", "oszlop3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Tehát végre befejeztük a minőségi és mennyiségi adatok külön-külön történő feldolgozását – itt az idő, hogy újra egyesítsük őket.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Miután egyesítettük az adatkereteket egyetlen adathalmazon, végül használhatjuk az adattranszformációt a MinMaxScaler segítségével a sklearn könyvtárból. Ez 0 és 1 közötti értékekké alakítja a számainkat, ami segít a modell jövőbeni tanulásában.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Ezek az adatok most készen állnak mindenre – neurális hálózatokra, standard ML algoritmusokra stb!
Ebben a cikkben nem foglalkoztunk az időbeli sorozatokkal kapcsolatos adatok kezelésével, mivel ezekhez a feladatokhoz kicsit más feldolgozási technikák szükségesek, a feladat függvényében. A jövőben csapatunk külön cikket szentel ennek a témának, és reméljük, hogy ez valami érdekeset, újat és hasznosat hoz az életébe, akárcsak ez.
Forrás: habr.com
