

Üdv mindenkinek! A nevem Dmitrij Samsonov, a «Odnoklassznikik» vezető rendszeradminisztrátoraként dolgozom. Több mint 7000 fizikai szerverünk, 11000 konténerünk van a felhőnket, és 200 alkalmazás különböző konfigurációban 700 különböző klasztert alkot. A szerverek túlnyomó többsége CentOS 7 operációs rendszeren fut.
2018. augusztus 14-én közzétették a FragmentSmack sebezhetőségről szóló információt.
() és a SegmentSmack (). Ezek hálózati támadási vektort használó sebezhetőségek, amelyek magas, 7,5-ös kockázati besorolással rendelkeznek, és szolgáltatásmegtagadást (DoS) okozhatnak, mivel kimerítik az erőforrásokat (CPU). A FragmentSmack javítása a kernelben akkor még nem állt rendelkezésre, sőt, jelentősen a sebezhetőség nyilvánosságra hozatalát követően készült el. A SegmentSmack megszüntetéséhez kernelfrissítés szükséges. Magyarázó csomagját ugyanazon a napon adták ki, csupán telepíteni kellett azt.
Nem, egyáltalán nem ellenzünk a kernel frissítésének! Azonban vannak finomságok...
Hogyan frissítjük a kernelt a termelési környezetben
Alapvetően nincs benne semmi bonyolult:
- Csomagok letöltése;
- Telepíteni őket néhány szerverre (beleértve a felhőnket hosztoló szervereket);
- Ellenőrizni, hogy semmi sem romlott el;
- Biztosítani, hogy minden alapértelmezett kernelbeállítás hibamentesen alkalmazásra került;
- Várni néhány napot;
- Ellenőrizni a szerverek mutatóit;
- Átállítani az új szerverek telepítését az új kernelre;
- Frissíteni az összes szervert a különböző adatközpontokban (egy adatközpontot egyszerre, hogy minimalizáljuk a felhasználókra gyakorolt hatást problémák esetén);
- Újraindítani az összes szervert.
Megismételve az összes meglévő kernelverzióra. Jelenleg ezek:
- Alapértelmezett CentOS 7 3.10 — a legtöbb normál szerverhez;
- Vanília 4.19 — a mi mert szükségünk van BFQ, BBR stb. frissítésekre;
- Elrepo kernel-ml 5.2 — a mivel a 4.19 korábban instabilan viselkedett, de ugyanazokra a funkciókra van szükségünk.
Ahogy azt kitalálhatták, a legtöbb időt a több ezer szerver újraindítása veszi igénybe. Mivel nem minden sebezhetőség kritikus minden szerver számára, csak azokat indítjuk újra, amelyek közvetlenül az interneten elérhetők. A felhőben, hogy ne korlátozzuk a rugalmasságot, nem kötvünk külsőleg elérhető konténereket külön szerverekhez új kernelhez, hanem minden hosztot kivétel nélkül újraindítunk. Szerencsére itt a folyamat egyszerűbb, mint a hagyományos szerverek esetében. Például a stateless konténerek egyszerűen átköltözhetnek egy másik szerverre az újraindítás során.
Ennek ellenére a munka továbbra is sok, és hetekig eltarthat, ha pedig probléma merül fel az új verzióval, akkor akár hónapokig is. A rosszindulatú támadók ezt jól tudják, ezért szükség van egy B tervre.
FragmentSmack/SegmentSmack. Workaround
Szerencsére néhány sebezhetőség esetén létezik ilyen B terv, amely Workaround névre hallgat. Leggyakrabban ez a kernel/alkalmazások beállításainak módosítása, amelyek minimalizálják a potenciális hatást, vagy teljesen megszüntetik a sebezhetőségek kihasználását.
A FragmentSmack/SegmentSmack esetében A net.ipv4.ipfrag_high_thresh és net.ipv4.ipfrag_low_thresh (és azok analógjai ipv6 esetén net.ipv6.ipfrag_high_thresh és net.ipv6.ipfrag_low_thresh) alapértelmezett értékeit 4MB és 3MB helyett 256 kB-ra és 192 kB-ra kell módosítani, vagy alacsonyabbra. A tesztek a CPU használatának kis mértékű vagy jelentős csökkenését mutatják a támadás idején, a hardver, a beállítások és a körülmények függvényében. Azonban ez a beállítás ipfrag_high_thresh=262144 bytes miatt bizonyos teljesítményhatással járhat, mivel egyszerre csak két 64K fragmentum fér el a rekonstrukciós sorban. Például fennáll a kockázat, hogy a nagy UDP csomagokkal dolgozó alkalmazások meghibásodhatnak.
«Maguk a paraméterek».
a kernel dokumentációjában A produkciós szolgáltatásaink között nagy UDP forgalom nem szerepel. A LAN-on a fragmentált forgalom hiányzik, a WAN-on van, de nem jelentős. Semmi nem utal arra — lehet alkalmazni a workaroundot!
ipfrag_high_thresh - HOSSZÚ EGÉSZ SZÁM
     A maximális memória az IP fragmentumok újraegyesítéséhez.
ipfrag_low_thresh - HOSSZÚ EGÉSZ SZÁM
     Maximális memória, amelyet az IP-fragmentumok újbóli összeállításához használnak, mielőtt a kernel
     kezdené eltávolítani a hiányos fragmentum várólistákat az erőforrások felszabadítása érdekében.
     A kernel továbbra is elfogad új fragmentumokat a töredezettség-mentesítéshez.
FragmentSmack/SegmentSmack. Az első vér
FragmentSmack/SegmentSmack. Az első vér
Az első probléma, amellyel szembesültünk, az volt, hogy a felhőalapú konténerek néha csak részben alkalmazták az új beállításokat (csak az ipfrag_low_thresh), máskor pedig egyáltalán nem alkalmazták — egyszerűen leálltak az indításkor. A problémát stabilan reprodukálni nem tudtuk (manuálisan minden beállítást bármiféle nehézség nélkül alkalmaztak). Megérteni, hogy miért omlik össze a konténer az indításkor, szintén nem volt egyszerű: semmilyen hibát nem találtunk. Egy azonban biztos volt: a beállítások visszaállítása megoldotta a konténerek összeomlásának problémáját.
Miért nem elegendő a Sysctl alkalmazása a gazdagépen? A konténer a saját elkülönített hálózati névtérben él, így legalább a konténerben eltérhetnek a gazdagéptől.
Hogyan kerülnek alkalmazásra a Sysctl beállítások a konténerben? Mivel a konténereink nem privilegizáltak, bármilyen Sysctl-beállítást módosítani nem lehet, ha belépünk magába a konténerbe — egyszerűen nem lesz elegendő jogunk. A konténerek elindításához felhőnk abban az időszakban Docker-t használt (jelenleg már ). A Docker API-ján keresztül adtuk át az új konténer paramétereit, beleértve a szükséges Sysctl beállításokat is.
A verziók áttekintése során kiderült, hogy a Docker API nem adta vissza az összes hibát (legalábbis az 1.10-es verzióban). Amikor megpróbáltuk elindítani a konténert a “docker run” segítségével, végre láttunk valamit:
write /proc/sys/net/ipv4/ipfrag_high_thresh: érvénytelen argumentum docker: Hiba a daemon válaszában: A konténer elindítása nem lehetséges <...>: [9] Rendszerhiba: nem sikerült szinkronizálni a konténer folyamattal.
A paraméter értéke érvénytelen. De miért? És miért érvénytelen ez néha? Kiderült, hogy a Docker nem garantálja a Sysctl paraméterek alkalmazásának sorrendjét (az utolsó ellenőrzött verzió — 1.13.1), ezért néha az ipfrag_high_thresh 256K-ra próbált beállítani, amikor az ipfrag_low_thresh még 3M volt, ami azt jelenti, hogy a felső határ alacsonyabb volt, mint az alsó, ami a hibához vezetett.
Abban az időszakban már használtunk egy saját mechanizmust a konténer indítása utáni konfigurálására (a konténer fagyasztása a és parancsok végrehajtása a konténer névtérben a ), és ezt a részleget is kiegészítettük a Sysctl-paraméterek beírásával. A probléma megoldódott.
FragmentSmack/SegmentSmack. Első vér 2
Mielőtt még sikerült volna tisztázni a Workaround felhőben való alkalmazását, megkezdték megérkezni az első ritka panaszok a felhasználók részéről. Ekkor már több hét eltelt az első szervereken történő Workaround alkalmazásának megkezdése óta. Az elsődleges vizsgálat azt mutatta, hogy a panaszok különböző szolgáltatásokra érkeztek, és nem minden szerverre vonatkoztak. A probléma újra rendkívül bizonytalan jelleget öltött.
Elsősorban természetesen megpróbáltuk visszaállítani a Sysctl beállításokat, de ez nem hozott semmilyen eredményt. A szerver és az alkalmazás beállításaival végzett különböző manipulációk szintén nem segítettek. A reboot segített. A Linux számára a reboot annyira természetellenes, mint amennyire a Windowshoz való régi időkben a normális működéshez szokásos volt. Mégis segített, és mindent a Sysctl új beállításaival kapcsolatos "kernelben lévő glitch"-nek tudtunk be. Mennyire könnyelmű volt ez...
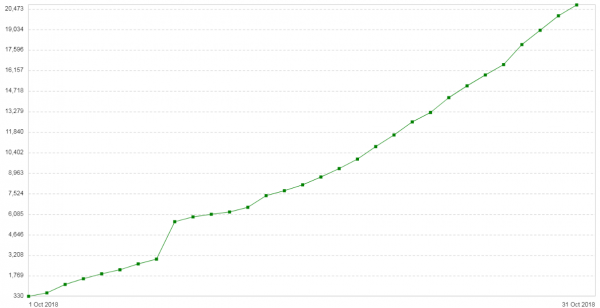
Három héttel később a probléma újra megjelent. A szerverek konfigurációja meglehetősen egyszerű volt: Nginx proxy / load balancer módban. A forgalom minimális. Új információ: a klienseknél minden nap nő a 504-es hibák száma (). A grafikonon a 504-es hibák napi száma látható ezen a szolgáltatáson:
Az összes hiba ugyanarra a háttérre vonatkozott — arra, amely a felhőben található. A memóriát használó statisztikai grafikon ezen a háttérben a következőképpen nézett ki:
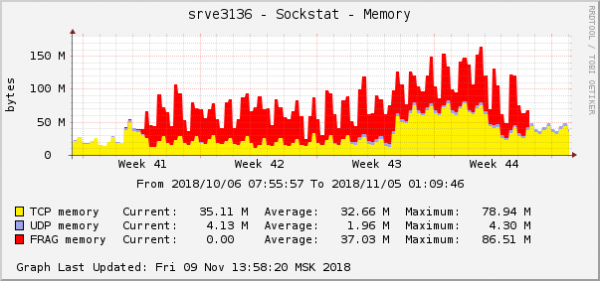
Ez az operációs rendszer grafikonján a probléma egyik legszembetűnőbb megnyilvánulása. A felhőben éppen ekkor javítottak egy másik hálózati problémát a QoS (Traffic Control) beállításokkal kapcsolatban. A memóriát felhasználó statisztikai grafikon pontosan így nézett ki:
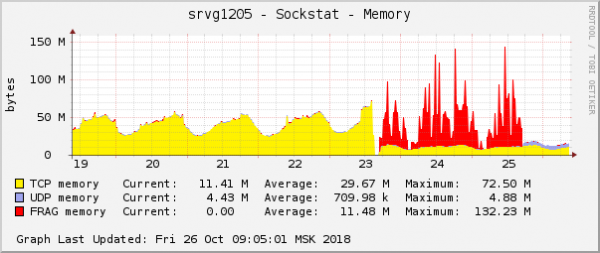
A feltételezés egyszerű volt: ha a grafikonokon ugyanolyanok, akkor az okuk is azonos. Főleg, hogy az e típusú memóriával kapcsolatos problémák rendkívül ritkán fordulnak elő.
A javított probléma lényege az volt, hogy az QoS-ban a fq csomagsorozó alapértelmezett beállításaival dolgoztunk. Alapértelmezés szerint egy kapcsolat esetén 100 csomagot engedélyez a sorba állításra, és néhány kapcsolat a csatorna szűkössége miatt telítette a sort a végsőkig. Ilyenkor a csomagok eldobásra kerülnek. A tc statisztikában (tc -s qdisc) ez így látszik:
qdisc fq 2c6c: szülő 1:2c6c limit 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Küldött 454701676345 bájt 491683359 pkt (elvesztett 464545, túllépések 0, újrahelyezések 0)
  visszatartás 0b 0p újrahelyezések 0
   1024 folyamat (1021 inaktív, 0 korlátozott)
   0 gc, 0 highprio, 0 korlátozott, 464545 flows_plimit
A „464545 flows_plimit” az a csomag, amelyeket a kapcsolat sorának túllépése miatt dobtak el, míg a „dropped 464545” a scheduler összes eldobott csomagjának összege. A sor hosszának 1000-re növelése és a konténerek újraindítása után a probléma megszűnt. Le lehet dőlni a foteleinkbe és élvezni egy smoothie-t.
FragmentSmack/SegmentSmack. Az utolsó vér
Először is, hónapokkal a kernel sebezhetőségek bejelentése után végre megjelent a FragmentSmack javítása (emlékeztetnék, hogy a bejelentéssel együtt augusztusban csak a SegmentSmack javítása érkezett), ami lehetőséget adott, hogy megszabaduljunk a workaroundtól, amely elég sok kellemetlenséget okozott számunkra. Addigra már néhány szerverünket átállítottuk az új kernelre, és most elölről kellett kezdenünk. Miért frissítettük a kernelt a FragmentSmack javítása előtt? Azért, mert a védekezési folyamatok a sebezhetőségek ellen egybeestek (és összeolvadtak) a CentOS frissítési folyamatával (ami még több időt vesz igénybe, mint csak a kernel frissítése). Ráadásul a SegmentSmack egy sokkal veszélyesebb sebezhetőség, amelyhez a javítás azonnal megérkezett, így mindenképpen volt értelme. Azonban csak úgy frissíteni a kernelt a CentOS-on nem tudtuk, mert a FragmentSmack sebezhetőséget, amely a CentOS 7.5 idején jelent meg, csak a 7.6 verzióban javították, így le kellett állítanunk a frissítést a 7.5-re és mindent elölről kellett kezdenünk a 7.6 frissítéssel. Ilyen is van.
Másodszor, ritka felhasználói panaszok tértek vissza. Most már biztosan tudjuk, hogy mindegyik a kliensek fájlfeltöltésével kapcsolatos problémákhoz köthető néhány szerverünkön. Ráadásul ezeken a szervereken nagyon kis mennyiségű feltöltés zajlott az összes feltöltés közül.
Ahogy az előbbi beszámolóból emlékezünk, a Sysctl visszaállítása nem segített. A Reboot ugyan segített, de csak ideiglenesen.
A Sysctl által keltett gyanúk nem szűntek meg, de ezúttal minél több információt kellett gyűjteni. Nagyon hiányzott a lehetőség, hogy a fájlfeltöltési problémát a kliens oldalon reprodukáljuk, hogy pontosan megvizsgálhassuk, mi történik.
Az összes elérhető statisztika és napló elemzése nem közelített minket a történtek megértéséhez. Nagyon hiányzott a lehetőség a probléma reprodukálására, hogy "megfogdossuk" a konkrét kapcsolatot. Végül a fejlesztőknek a specializált alkalmazásverzión sikerült stabil reprodukciót elérniük a problémákhoz egy teszteszközön Wi-Fi kapcsolaton keresztül. Ez áttörést jelentett a nyomozásban. Az ügyfél az Nginx-hez csatlakozott, amely a backendre, vagyis a Java alkalmazásunkra irányított.
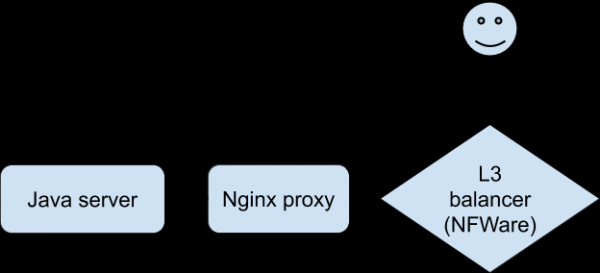
A probléma során a párbeszéd a következő volt (az Nginx-proxyn rögzítve):
- Ügyfél: kérés a fájl letöltésének információjára.
- Java-szerver: válasz.
- Ügyfél: POST fájllal.
- Java-szerver: hiba.
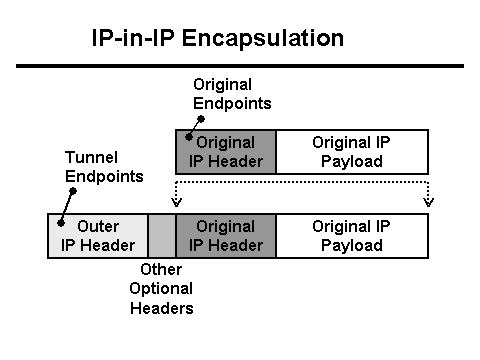
A Java szerver eközben azt írta a naplóba, hogy 0 bájt adat érkezett az ügyféltől, míg az Nginx-proxy azt, hogy a kérés több mint 30 másodpercet vett igénybe (30 másodperc az ügyféles alkalmazás időtúllépése). Miért van tehát időtúllépés és miért 0 bájt? HTTP szempontjából minden úgy működik, ahogy kell, de a fájl POST üzenete mintha eltűnne a hálózatból. Ráadásul eltűnik a kliens és az Nginx között. Itt az idő, hogy a Tcpdump-ot elővegyük! De először is meg kell értenünk a hálózat konfigurációját. Az Nginx-proxy egy L3 terheléselosztó mögött helyezkedik el. . Csomagok szállításához a L3 terheléselosztótól a szerverig tunnelinget használunk, ami saját fejléceit adja a csomagokhoz:
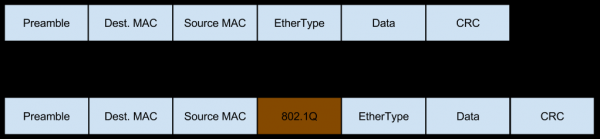
Ez a hálózat VLAN-tagolt forgalom formájában érkezik a szerverhez, ami szintén saját mezőit adja a csomagokhoz:
Ezenkívül ez a forgalom fragmentálódhat (az a kis százalék bejövő fragmentált forgalom, amelyről a Workaround kockázatértékeléskor beszéltünk), ami szintén megváltoztatja a fejlécek tartalmát:
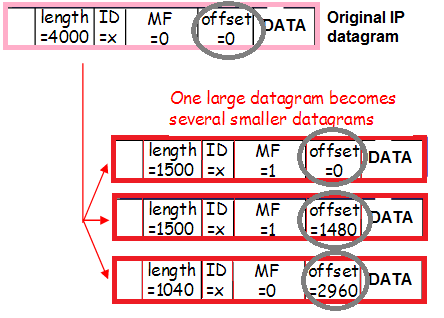
Még egyszer: a csomagok VLAN-taggel, alagútba zárva, fragmentálva érkeznek. Ahhoz, hogy pontosabban megértsük, hogyan történik ez, kövessük nyomon a csomagnak az ügyféltől az Nginx-proxyig tartó útját.
- A csomag az L3 terheléselosztóra érkezik. A megfelelő adatközponti útvonalhoz a csomag belekerül a tunnelingbe és elküldik a hálózati kártyának.
- Mivel a csomag + alagútfejlécek nem férnek el az MTU-ban, a csomag darabokra vágódik és elküldésre kerül a hálózatba.
- Az L3 terheléselosztó utáni switch, amikor megkapja a csomagot, hozzáadja a VLAN-taget és továbbküldi.
- A switch before the Nginx proxy sees (according to port settings) that the server is expecting a VLAN-encapsulated packet, so it sends it as is, without removing the VLAN tag.
- Linux receives fragments of individual packets and stitches them into one large packet.
- Next, the packet arrives at the VLAN interface, where the first layer—VLAN encapsulation—is removed.
- Then Linux sends it to the Tunnel interface, where another layer—Tunnel encapsulation—is removed.
The challenge is to pass all this as parameters into tcpdump.
Let's start from the end: are there clean (without extra headers) IP packets from clients, with VLAN and tunnel encapsulation removed?
tcpdump host
No, there were no such packets on the server. Thus, the issue must be earlier. Are there packets with only VLAN encapsulation removed?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx — this is the client IP address in hex format.
32:4 — the address and length of the field where the SCR IP is recorded in the Tunnel packet.
The field address had to be identified by trial and error, as the internet suggests 40, 44, 50, 54, but the IP addresses were not there. You can also look at one of the packets in hex (using the -xx or -XX parameter in tcpdump) and calculate the address of the known IP.
Are there packet fragments without VLAN and Tunnel encapsulation removed?
tcpdump ((ip[6:2] > 0) és (nem ip[6] = 64))
This magic will show us all fragments, including the last one. Probably, the same can be filtered by IP, but I didn't try since there aren't many such packets, and I easily found the ones I needed in the overall stream. Here they are:
14:02:58.471063 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), length 1516: (tos 0x0, ttl 63, id 53652, offset 0, flags [+], proto IPIP (4), length 1500)
     11.11.11.11 > 22.22.22.22: truncated-ip - 20 bytes missing! (tos 0x0, ttl 50, id 57750, offset 0, flags [DF], proto TCP (6), length 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.], seq 0:1448, ack 1, win 343, options [nop,nop,TS val 11660691 ecr 2998165860], length 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), length 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), length 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
These are two fragments of one packet (same ID 53652) with a photo (the word Exif is visible in the first packet). The reason is that at this level packets exist, while in the stitched form in dumps—they do not, thus the problem is clearly with the assembly. Finally, there is documentary evidence of this!
The packet decoder did not detect any issues preventing assembly. I tried it here: . Először, amikor megpróbáltunk valamit betenni, a dekóder nem tűrte a csomag formátumát. Kiderült, hogy volt két felesleges oktett a Srcmac és az Ethertype között (amelyek nem tartoztak a töredékek információihoz). Ezek eltávolítása után a dekóder működött. Azonban nem mutatott problémákat.
Akárhogyan is nézzük, a Sysctl-okon kívül más nem akadt. Meg kellett találni a hibás szerverek azonosításának módját, hogy megértsük a problémák mértékét, és döntsünk a további lépésekről. Elég gyorsan meg is találtam a szükséges számlálót:
netstat -s | grep "packet reassembles failed”
Ez SNMPD-ben is megtalálható OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
„A törvényes IP újraegyesítő algoritmus által észlelt hibák száma (bármilyen okból: időtúllépés, hibák stb.)”.
A problémát vizsgáló szerverek közül kettőnél ez a számláló gyorsabban nőtt, kettőnél lassabban, kettőnél pedig egyáltalán nem növekedett. Ennek a számlálónak a dinamikája és a Java-szerver HTTP-hibáinak dinamikája közötti összehasonlítás korrelációt mutatott. Tehát a számlálót lehetett monitorozni.
A megbízható problémakijelző megléte nagyon fontos, hogy pontosan meghatározhassuk, hogy segít-e a Sysctl visszagörgetése, mivel az előző beszámolóból tudjuk, hogy az alkalmazásból azt nem lehet azonnal észlelni. Ez a kijelző lehetővé tette volna a problémás területek feltárását a termelésben, mielőtt a felhasználók ezt észlelik.
A Sysctl visszagörgetése után a monitorozás során a hibák megszűntek, így bizonyítást nyert a problémák oka, valamint az, hogy a visszagörgetés segít.
Visszagörgettük a töredezettségi beállításokat más szervereken, ahol új monitorozás indult, máshol pedig a töredékek számára még több memóriát is kijelöltünk, mint korábban alapértelmezetten (ez UDP statisztika volt, amelynek részleges elveszítése nem volt észlelhető az összképhez képest).
A legfontosabb kérdések
Miért töredeznek a csomagok az L3 terheléselosztónkon? A felhasználóktól a terheléselosztókhoz érkező csomagok többsége SYN és ACK. Ezek a csomagok kicsik. De mivel ezek aránya nagyon magas, ezért nem észleltük a nagyobb csomagok töredezését.
Az ok egy hibás konfigurációs szkript volt Vlan-interfészekkel rendelkező szervereken (a címkézett forgalmú szerverekből akkoriban nagyon kevés volt az üzemeltetésben). Az Advmss lehetővé teszi, hogy eljuttassuk az ügyfélhez azt az információt, hogy a felénk lévő csomagoknak kisebb méretűnek kell lenniük, hogy a hozzájuk kapcsolt alagútfejlécek után ne kelljen őket fragmentálni.
Miért nem segített a Sysctl visszaállítása, de a reboot igen? A Sysctl visszaállítása megváltoztatta a csomagok összeragasztásához elérhető memória mennyiségét. Közben úgy tűnik, hogy a fragmentumok számára fenntartott memória túlcsordulásának ténye lassította a kapcsolatokat, ami a fragmentumok hosszú várakozásához vezetett a sorban. Tehát a folyamat ciklikussá vált.
A reboot nullázta a memóriát, és minden a helyére került.
Lehetett volna workaround nélkül is? Igen, de nagy a kockázata annak, hogy a támadás esetén az ügyfelek kiszolgálás nélkül maradnak. Természetesen a workaround alkalmazása különféle problémákhoz vezetett, beleértve egy szolgáltatás lassulását a felhasználóknál, de ennek ellenére úgy véljük, hogy a lépések indokoltak voltak.
Nagyon köszönöm Andrej Timofejevnek () a nyomozás lefolytatásában nyújtott segítségért, valamint Alekszej Krenyovnak () — a Centos és a kernetek frissítése során végzett hatalmas munkáért. A folyamat, amelyet ebben az esetben többször is el kellett kezdeni a legelejéről, ezért hónapokig elhúzódott.
Forrás: habr.com
