

A Berkeley Packet Filter (BPF) egy olyan Linux kernel technológia, amely már évek óta a angol nyelvű technikai kiadványok címlapjain szerepel. A konferenciák tele vannak a BPF használatáról és fejlesztéséről szóló előadásokkal. David Miller, a Linux hálózati alrendszerének karbantartója a Linux Plumbers 2018 konferencián tartott beszédét (Az XDP a BPF egyik felhasználási módja). Brendan Gregg olyan előadásokat tart, amelyek címe . Toke Høiland-Jørgensen , hogy a kernel most már mikrokernel. Thomas Graf hirdeti azt az ötletet, hogy .
A Habr-on még mindig nincs rendszerszintű leírás a BPF-ről, ezért egy cikk sorozatban megpróbálom elmesélni a technológia történetét, leírni az architektúrát és a fejlesztési eszközöket, illetve felvázolni a BPF alkalmazási területeit és gyakorlatait. Ebben a nulladik cikkben a klasszikus BPF történetéről és architektúrájáról van szó, valamint felfedjük a működési elvek titkait tcpdump, seccomp, strace, és sok más dolgot.
A BPF fejlesztését a Linux hálózati közössége irányítja, a BPF fő alkalmazási területei a hálózatokkal kapcsolatosak, így A , az "BPF a legkisebbek számára" sorozatot neveztem el, az "A legkisebbek számára" című nagyszerű sorozat tiszteletére. .
A BPF történetének rövid áttekintése (c)
A modern BPF technológia a klasszikus BPF néven ismert, régi technológia fejlesztett és továbbfejlesztett változata, amelyet a zűrzavar elkerülése érdekében most klasszikus BPF-nek neveznek. A klasszikus BPF alapján létrehozták az összesen ismert segédprogramot tcpdump, a mechanizmust seccomp, valamint a kevésbé ismert modult xt_bpf a iptables , és a klasszifikátort cls_bpf.A modern Linuxban a klasszikus BPF programokat automatikusan új formába fordítják, azonban felhasználói szempontból az API változatlan maradt, és a klasszikus BPF új alkalmazásai, ahogy ezt a cikkben látni fogjuk, még mindig léteznek. Ezért, valamint hogy követve a klasszikus BPF fejlődéstörténetét a Linuxban világossá válik, hogy és miért alakult át a modern formájára, éppen ezért döntöttem úgy, hogy éppen a klasszikus BPF-ről szóló cikkel kezdem.
A nyolcvanas évek végén a híres Lawrence Berkeley Laboratory mérnökei elkezdték kutatni, hogyan lehet helyesen szűrni a hálózati csomagokat a nyolcvanas évek végén lévő, modern hardveren. A szűrés alapgondolata, amelyet eredetileg a CSPF (CMU/Stanford Packet Filter) technológiában valósítottak meg, az volt, hogy a felesleges csomagokat a lehető legkorábban, azaz a kernel térben szűrjük, mivel ez lehetővé teszi a felesleges adatok felhasználói térbe másolásának elkerülését. A kernel térben futó felhasználói kód végrehajtásának biztonságának biztosítására virtuális gépet - homokozót - használtak.
A létező szűrők számára tervezett virtuális gépek azonban verem architektúrájú gépeken történő futtatásra készültek, és új RISC gépeken nem működtek olyan hatékonyan. Ennek eredményeként a Berkeley Labs mérnökeinek munkája nyomán kifejlesztettek egy új technológiát, a BPF (Berkeley Packet Filters) néven ismert módszert, amelynek virtuális gép architektúrája a Motorola 6502 processzor alapján készült, amely olyan jól ismert termékek munkalovaként működött, mint vagy . Az új virtuális gép a meglévő megoldásokhoz képest tízszeresére növelte a szűrők teljesítményét.
A BPF gép architektúrája
A működő architektúrával ismerkedünk meg, példák segítségével. Azonban először is elmondhatjuk, hogy a gépnek volt két, felhasználó által elérhető 32 bites regisztere, a processzor, A és az indexregiszter, X, 64 byte memória (16 szó), amely írásra és olvasásra áll rendelkezésre, valamint egy kis utasításkészlet, amely működik ezekkel az objektumokkal. A programokban elérhetők voltak ugrási utasítások is a feltételes kifejezések végrehajtására, azonban a program időben történő befejezésének garantálása érdekében csak előre lehetett ugrani, azaz különösen tiltotta a ciklusok létrehozását.
A gép indításának általános sémája a következő. A felhasználó elkészít egy programot a BPF architektúrához, és valamilyen mechanizmuson keresztül (például rendszerhívás segítségével) betölti és csatlakoztatja a programot valamilyen eseménygenerátorhoz a kernelben (például az esemény - egy új csomag érkezése a hálózati kártyára). Az esemény bekövetkezésekor a kernel elindítja a programot (például az értelmezőben), miközben a gép memóriája megfelel. eseménygenerátorhoz a kernelben (például egy esemény — egy új csomag érkezése a hálózati kártyára). Esemény bekövetkeztekor a kernel elindítja a programot (például egy értelmezőben), miközben a gép memóriája megfelel. eseménygenerátorhoz a kernelben (például az esemény - egy új csomag érkezése a hálózati kártyára). Az esemény bekövetkezésekor a kernel elindítja a programot (például az értelmezőben), miközben a gép memóriája megfelel. a magmémória régiójára (például a beérkező csomag adataira).
A fentiek elegendőek lesznek ahhoz, hogy elkezdjük az példák átvizsgálását: megismerkedünk a rendszerrel és a parancsformátummal szükség esetén. Ha azonban azonnal szeretné tanulmányozni a virtuális gép parancsrendszerét és megismerni annak összes lehetőségét, érdemes elolvasni az eredeti cikket. és/vagy a fájl első felét a kernel dokumentációjából. Ezen kívül megismerhetjük a , amelyben McCanne, a BPF egyik szerzője, beszél a létrehozásának történetéről. libpcap.
Mi pedig a klasszikus BPF Linuxban való alkalmazásainak minden fontos példáját fogjuk megvizsgálni: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf..
tcpdump
A BPF fejlesztése párhuzamosan zajlott a csomagszűrés frontendjének fejlesztésével - az általunk jól ismert tcpdump. Mivel ez a klasszikus BPF legidősebb és legismertebb példája, amely számos operációs rendszeren elérhető, ezzel kezdjük a technológia tanulmányozását.
(Minden példa ebben a cikkben Linux alatt futott. 5.6.0-rc6. Néhány parancs kimenete a jobb olvashatóság érdekében lett szerkesztve.)
Példa: IPv6 csomagok figyelése
Tegyük fel, hogy minden IPv6 csomagot szeretnénk látni a hálózati interfészen eth0. Ehhez elindíthatjuk a programot tcpdump a legegyszerűbb szűrővel ip6:
$ sudo tcpdump -i eth0 ip6Ez idő alatt tcpdump a szűrőt ip6 BPF architektúrájának bájtódjára fordítja, és elküldi a kernelnek (részletek a ) szakaszban). Az elküldött szűrő minden csomag esetében futni fog, amely áthalad a hálózati interfészen. eth0Ha a szűrő nem nulla értéket ad vissza, n, akkor a csomag n byte-jai fel lesznek másolva a felhasználói térbe, és ezt látni fogjuk a kimenetben. tcpdump.
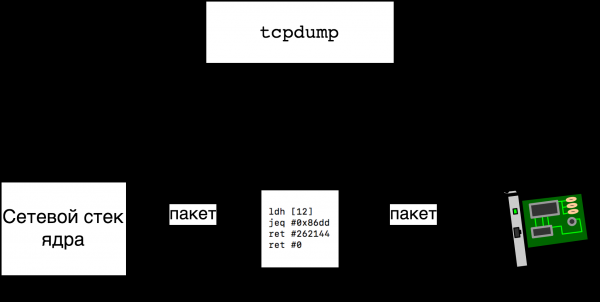
Kiderül, hogy könnyen megtudhatjuk, hogy pontosan milyen bájtódot küldünk el a kernelnek tcpdump a tcpdump, ha a -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
nulladik sorban elindítjuk a parancsot ldh [12], ami "betölti a regiszterbe A a fél szót (16 bit), amely a 12-es címen található", és az egyetlen kérdés az, hogy milyen memória címezéséről van szó? A válasz az, hogy a címnél x kezdődik (x+1)-dik byte a vizsgált hálózati csomagban. Ethernet interfészen olvassuk a csomagokat, eth0, így , hogy a csomag a következőképpen néz ki (egyszerűsítés céljából feltételezzük, hogy a csomag nem tartalmaz VLAN címkéket):
       6              6          2
|Destination MAC|Source MAC|Ether Type|...|
Tehát a parancs végrehajtása után ldh [12] a regiszterben A egy mező fog megjelenni Ether Type — a kérdéses Ethernet keretben továbbított csomag típusa. Az 1. sorban az általunk látott regiszter tartalmát hasonlítjuk össze A (csomagtípus) a 0x86dd, így az általa érdeklő csomag IPv6. Az 1. sorban a hasonlítási parancs mellett még két oszlop található — jt 2 és jf 3 — címkék, amelyekre kapcsolni kell a sikeres összehasonlítás esetén (A == 0x86dd) és sikertelen esetén. Tehát siker esetén (IPv6) áttérünk a 2. sorra, míg sikertelen esetén a 3. sorra. A 3. sorban a program 0-ás kóddal zárul (ne másold a csomagot), a 2. sorban a program 262144-es kóddal zárul (másolj maximum 256 kilobyte csomagot).
Bonyolultabb példa: nézzük meg a TCP csomagokat a célport szerint
Nézzük meg, hogyan néz ki a szűrő, amely másolja az összes TCP csomagot a 666 célporttal. IPv4-es esetet fogunk megvizsgálni, mivel az IPv6 eset könnyebb. Ennek a példának a tanulmányozása után, mint feladat, önállóan tanulmányozhatja az IPv6 szűrőt (ip6 and tcp dst port 666) és a közönséges eset szűrőjét (tcp dst port 666). Tehát az általunk érdeklő szűrő a következőképpen néz ki:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
A 0. és 1. sor már ismert. A 2. sorban már ellenőriztük, hogy IPv4-es csomagról van szó (Ether Type = 0x800) és betöltjük a regiszterbe A a csomag 24. bájtját. A csomagunk így néz ki
       14            8      1     1
|ethernet header|ip fields|ttl|protocol|...
ezért betöltjük a regiszterbe A az IP fejléc Protocol mezőjét, ami logikus, hiszen csak TCP csomagokat akarunk másolni. Összehasonlítjuk a Protocol-t a 0x6 () a 3. sorban.
A 4. és 5. sorban fél szavakat töltünk be a 20-as címről, és a jset utasítással ellenőrizzük, hogy nem áll-e be az egyik három — a kiadott maszkban jset a három legmagasabb bit ki van tisztítva. Két bit közül három informál minket arról, hogy a csomag töredezett IP csomag része-e, és ha igen, akkor az utolsó fragment-e. A harmadik bit fenntartott, és 0-nak kell lennie. Nem akarjuk ellenőrizni sem a töredékes, sem a hibás csomagokat, ezért mindhárom bitet ellenőrizzük.
A 6. sor a legérdekesebb ebben a listában. A kifejezés ldxb 4*([14]&0xf) azt jelenti, hogy betöltjük a regiszterbe X a tizenötödik bájt négy legkisebb bitje, megszorozva 4-gyel. A tizenötödik bájt négy legkisebb bitje – ez a mező az IPv4 fejlécben található, amely a fejléc hosszát tárolja szavakban, ezért aztán meg kell szoroznunk 4-gyel. Érdekes, hogy a kifejezés 4*([14]&0xf) – ez egy speciális címzés jelölés, amelyet csak így lehet használni, és csak a regiszterhez X, azaz nem mondhatjuk, hogy ldb 4*([14]&0xf) sem ldxb 5*([14]&0xf) (csak másik eltolást adhatunk meg, például ldxb 4*([16]&0xf)). Nyilvánvaló, hogy ezt a címzési sémát a BPF-be pontosan azért adták hozzá, hogy megkaphassuk a X (indexelt regiszter) IPv4 fejléc hosszát.
Így a 7. sorban megpróbáljuk betölteni a fél szót a címről (X+16). Emlékezve arra, hogy a 14 bájt az Ethernet fejlécet foglalja el, és X tartalmazza az IPv4 fejléc hosszát, megértjük, hogy A a TCP célportot tölti be:
       14           X           2             2
|ethernet header|ip header|source port|destination port|
Végül a 8. sorban összehasonlítjuk a célportot a keresett értékkel, és a 9. vagy 10. sorban visszatérünk az eredménnyel — másoljuk a csomagot, vagy sem.
Tcpdump: betöltés
Az előző példákban szándékosan nem álltunk meg részletesen azon, hogyan töltjük be a BPF bájt-kódot a kernelbe a csomagok szűrésére. Általánosságban tcpdump több rendszeren portálva van, és szűrők kezelésére , pontosabban — írjunk két függvényt: egyet a pseudoszorzott mátrix használatával (nem ajánlott a gyakorlatban, mert a számítási folyamat bonyolult és instabil), a másikat a mátrix egyenlet használatával. . Röviden, a szűrő interfészre való ültetéséhez libpcap, így kell csinálni:
- létrehozni egy
pcap_tdeszkriptort az interfész nevéből: , - aktiválni az interfészt: ,
- fordítani a szűrőt: ,
- csatlakoztatni a szűrőt: .
Ahhoz, hogy megnézzük, hogyan van a függvény pcap_setfilter megvalósítva a Linuxban, használjuk strace (néhány sor el lett távolítva):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Az első két sorban létrehozunk minden Ethernet keret olvasására, és összekapcsoljuk az interfésszel eth0. Az tudjuk, hogy a szűrő ip négy BPF utasításból fog állni, és a harmadik sorban látjuk, ahogy a rendszerhívás setsockopt segítségével betöltjük és kapcsoljuk a 4-es hosszúságú szűrőt. Ez tehát a mi szűrőnk.
Érdemes megjegyezni, hogy a klasszikus BPF esetében a szűrő betöltése és csatlakoztatása mindig atomikus műveletként történik, míg az új BPF verzióban a program betöltése és az eseménygenerátorhoz való hozzárendelés időben el van választva.
Rejtett igazság
Egy kicsit teljesebb verziója a kimenetnek így néz ki:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Erőforrás ideiglenesen nem elérhető)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Ahogy korábban említettük, a 5. sorban betöltjük és csatlakoztatjuk a szűrőnket a sockethez, de mi történik a 3. és 4. sorban? Kiderül, hogy ez libpcap gondoskodik rólunk — azért, hogy a szűrőnkre nem megfelelő csomagok ne kerüljenek a kimenetre, a könyvtár ál-szűrőt ret #0 (minden csomag eldobása), átváltja a socketet nem blokkoló módba, és megpróbálja kiolvasni az összes, a korábbi szűrők által hátrahagyott csomagot.
Összességében ahhoz, hogy csomagokat szűrjünk Linuxon a klasszikus BPF segítségével, szükség van egy szűrőre, amely a következő struktúra típusú: struct sock_fprog és egy megnyitott socketre, ezt követően a szűrőt a rendszerhívás segítségével csatlakoztathatjuk a sockethez. setsockopt.
Érdekes, hogy a szűrőt bármely sockethez csatlakoztathatjuk, nem csak a raw típusúhoz. Íme egy program, amely eltávolít mindent, kivéve az első két bájt valamennyi bejövő UDP datagrammból. (A megjegyzéseket a kódhoz adtam, hogy ne zsúfoljam meg a cikket.)
További információ a szűrők csatlakoztatásáról, lásd a setsockopt socket(7) segítség nélkül struct sock_fprog beszélni fogunk a tcpdump BPF programozása a saját kezünkkel .
A BPF 1997 óta része a Linuxnak, és hosszú ideig kestett a munka ló
jelentős változtatások nélkül (természetesen a Linux-specifikus változtatások voltak, libpcap , de ezek nem változtatták meg a globális képet). Az első komoly jelei annak, hogy a BPF fejlődni fog, 2011-ben jelentkeztek, amikor Eric Dumazet javasolta a javítást, amely a Just In Time Compiler-t adta a kernelhez — egy fordítót, amely a BPF bytecode-ot natív A JIT fordító volt az első a változások sorában: 2012-ben x86_64 lehetőséget kaptunk szűrők írására
, 2013 januárjában , amely lehetővé tette szabályok írását BPF segítségével, majd 2013 októberében érkezett modul xt_bpfmég egy modul. iptables modul is . cls_bpf., amely lehetővé teszi a BPF segítségével a forgalmi osztályozók írását.
Hamarosan részletesebben megvizsgáljuk ezeket a példákat, de először hasznos lesz megtanulni a szabad programok írását és fordítását BPF-hez, mivel a könyvtár által biztosított lehetőségek libpcap korlátozottak (egyszerű példa: a generált libpcap csak két értéket tud visszaadni — 0 vagy 0x40000) vagy egyáltalán nem alkalmazható, mint a seccomp esetében.
Klasszikus BPF és a XXI. század
Ismerkedjünk meg a BPF utasítások bináris formátumával, ami nagyon egyszerű:
   16    8    8     32
| code | jt | jf |  k  |
Minden utasítás 64 bitet foglal el, amelyek első 16 bitje az utasítás kódja, majd két nyolcbites ugrás következik, jt és jf, és 32 bit az argumentum számára, K, amelynek jelentése változik az utasítástól függően. Például az utasítás ret, amely lezárja a programot, kódot tartalmaz 6, és a visszatérési érték egy konstansból származik K. C nyelven egy BPF utasítás egy strukturaként jelenik meg:
struct sock_filter {
        __u16   code;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
és egy egész program egy strukturaként:
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Így már tudunk programokat írni (az utasítások kódját már ismerjük, mondjuk, a ). Így néz ki a szűrő: ip6 a :
struct sock_filter code[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(code),
        .filter = code,
};
A programot prog legálisan használhatjuk a hívásban:
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Programot gépi kódok formájában írni nem túl kényelmes, de néha szükséges (például hibakereséshez, egységtesztek írásához, cikkek írásához a hubra stb.). Az egyszerűség kedvéért a fájlban <linux/filter.h> segítő makrókat definiálnak — az ugyanazt a példát így is átírhattuk volna:
struct sock_filter code[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Azonban még ez a változat sem túl kényelmes. Így gondolták a Linux kernel programozói is, ezért a mappa alatt található egy assembler és debuggerek a klasszikus BPF-vel való munkához.
Az assembly nyelv nagyon hasonlít a hibakeresési kimenetre, tcpdump, de emellett szimbolikus címkéket is megadhatunk. Például, itt egy program, amely eldob minden csomagot, kivéve a TCP/IPV4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Alapértelmezés szerint az assembler kódot generál az alábbi formátumban &, ,..., a TCP példa esetében
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
A C programozók kényelme érdekében egy másik kimeneti formátumot is használhatunk:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Ezt a szöveget beilleszthetjük a struct sock_filtertípusú struktúra definíciójába, mint ahogyan ezt a szakasz elején tettük.
Linux és netsniff-ng kiterjesztések
A BPF szabványos utasításai mellett, a Linux és tools/bpf/bpf_asm támogatja az . Főleg, hogy az utasítások a struct sk_buffstruktúra mezőihez való hozzáférésre szolgálnak, amely a kernelben a hálózati csomagot írja le. Azonban vannak más típusú segédutasítások is, például ldw cpu betölti a regiszterbe A a kernel funkciója, a raw_smp_processor_id()eredményét. (Az új BPF verzióban ezek a nem szabványos kiterjesztések bővültek, hogy a kernel segédprogramoknak lehetőséget adjanak a memória, struktúrák elérésére és események generálására.) Íme egy érdekes példa egy szűrőre, amelyben csak a csomagok fejlécét másoljuk a felhasználói térbe, a poff, terhelési eltolási értékkel:
ld poff
ret a
A BPF kiterjesztései nem alkalmazhatók tcpdump, de ez egy jó alkalom arra, hogy megismerkedjünk a csomaggal, amely többek között egy fejlett programot tartalmaz netsniff-ng, amely a BPF által végzett szűrések mellett egy hatékony forgalomgenerátort is magába foglal, és egy fejlettebb, mint tools/bpf/bpf_asm, BPF assemblernek nevezett szoftvert tartalmaz. bpfc. A csomag meglehetősen részletes dokumentációt tartalmaz, lásd még a cikk végén található linkeket.
seccomp
Tehát már tudunk BPF programokat írni bármilyen összetettséggel és készen állunk új példákra, az első a seccomp technológia, amely lehetővé teszi BPF szűrők segítségével a hozzáférhető rendszerhívások számának és argumentumainak kezelését a folyamat és utódai számára.
A seccomp első verzióját 2005-ben adták hozzá a kernelhez, és nem volt túl népszerű, mivel csupán egy lehetőséget biztosított — korlátozni a folyamat számára elérhető rendszerhívások számát, nevezetesen: read, write, exit és sigreturn, és a szabályokat megsértő folyamatot megölték SIGKILL. 2012-ben a seccomp-hoz BPF szűrők használatának lehetőségét is hozzáadták, amelyek lehetővé teszik a különböző engedélyezett rendszerhívások meghatározását és akár azok argumentumainak ellenőrzését is. (Érdekes, hogy az egyik első felhasználója ennek a funkciónak a Chrome volt, és jelenleg a Chrome csapata olyan KRSI mechanizmust fejleszt, amely egy új BPF verzióra épül, lehetővé téve a Linux Security Modules testreszabását.) További dokumentációk linkjei a cikk végén találhatók.
Érdemes megjegyezni, hogy a Habr-on már voltak cikkek a seccomp használatáról, ezért lehet, hogy valakinek kedve támad elolvasni őket a következő alfejezetek előtt (vagy helyett). A cikkben példák találhatók a seccomp használatára, mind 2007-es verzióban, mind BPF használatával (a szűrők a libseccomp segítségével generálódnak), beszélnek a seccomp és a Docker közötti kapcsolatokról, valamint sok hasznos hivatkozást is tartalmaznak. A cikkben részletezve van, hogy miként adhatunk feketelistákat vagy fehérlistákat a systemd alatt futó démonokhoz.
Ezután megnézzük, hogyan írjunk és töltsünk be szűrőket seccomp nyers C-ben és a libseccomp segítségével, és milyen előnyök és hátrányok vannak mindkét lehetőség esetén, végül megnézzük, hogyan használja a seccomp programunk strace.
Szűrők írása és betöltése a seccomp számára
Már tudjuk írni a BPF programokat, ezért először a seccomp programozási interfészére nézünk. A szűrőt folyamat szintjén lehet beállítani, és minden gyerekfolyamat örökli a korlátozásokat. Ezt a syscalls segítségével tehetjük meg :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)ahol &filter – ez a már jól ismert struktúránkra mutató mutató struct sock_fprog, vagyis a BPF programra.
Miben különböznek a seccomp programok a socket programoktól? Az átadott kontextusban. Socket esetén egy memóriaterületet adtak át, amely a csomagot tartalmazta, míg seccomp esetén egy olyan struktúrát adnak át nekünk, mint
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Itt nr – ez a végrehajtandó rendszerhívás száma, arch – az aktuális architektúra (erről később), args – legfeljebb hat érvet a rendszerhívás számára, míg instruction_pointer — ez egy mutató a felhasználói térbeni utasításra, amely végrehajtotta ezt a rendszerhívást. Így például a rendszerhívás számának betöltéséhez a regiszterbe A azt kell mondanunk,
ldw [0]A seccomp programok esetében más sajátosságok is vannak, például a kontextushoz való hozzáférés csak 32 bites igazítással lehetséges, és nem lehet fél szót vagy bájtot betölteni – a szűrő betöltésének kísérlete során ldh [0] a rendszerhívás seccomp visszaadja EINVAL. A betöltendő szűrők ellenőrzését a funkció végzi. (Vicces, hogy az eredeti commitban, amely a seccomp funkcionalitást hozta létre, ezt a funkciót elfelejtették felhatalmazni a mod (maradékos osztás) utasítás használatára, és most ez nem elérhető a seccomp BPF programok számára, mivel hozzáadása ABI-t.)
Alapvetően már tudunk mindent ahhoz, hogy seccomp programokat írjunk és olvassunk. A programok logikája általában fehér vagy fekete lista a rendszerhívásokról, például a program
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
ellenőrzi négy rendszerhívás fekete listáját az 304, 176, 239, 279 számokkal. Mik ezek a rendszerhívások? Pontosan nem tudjuk megmondani, mert nem tudjuk, mely architektúrára írták a programot. Ezért a seccomp szerzői hogy minden programot az architektúra ellenőrzésével kezdjünk (a jelenlegi architektúra a kontextusban mint mező szerepel arch a struktúrában struct seccomp_data). Az architektúra ellenőrzésével a példa kezdete így nézne ki:
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
és ekkor a rendszerhívás számok meghatározott értékeket kapnának.
Szűrők írása és betöltése seccomp számára libseccomp
A szűrők gépi kódokban való írása vagy BPF assembly számára lehetővé teszi a teljes kontrollt az eredmény felett, de ugyanakkor néha előnyösebb van hordozható és/vagy olvasható kód. Ebben segít nekünk a könyvtár, amely standard interfészt biztosít fekete vagy fehér szűrők írásához.
Nézzük például, írjunk egy programot, amely a felhasználó választása szerint futtat egy bináris fájlt, először beállítva a rendszerhívások fekete listáját az (a programot egyszerűsítettük a nagyobb olvashatóság érdekében, a teljes változatot megtalálhatja ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
Először definiálunk egy tömböt sys_numbers a 40+ rendszerhívás blokkolására. Ezután inicializáljuk a kontextust ctx és elmondjuk a könyvtárnak, hogy engedélyezni szeretnénk (SCMP_ACT_ALLOW) az összes rendszerhívást alapértelmezettként (a fekete listák létrehozása egyszerűbb). Ezután, egyenként hozzáadjuk az összes rendszerhívást a fekete listáról. A fekete listás rendszerhívásra reagálva kérjük SCMP_ACT_TRAP, ebben az esetben a seccomp jelet küld a folyamatnak SIGSYS a pontos leírással, hogy melyik rendszerhívás sértette meg a szabályokat. Végül betöltjük a programot a kernelbe a seccomp_load, amely lefordítja a programot és csatlakoztatja azt a folyamathoz a rendszerhívás segítségével seccomp(2).
A program sikeres fordításához a következőket kell összekapcsolni a könyvtárral libseccomp, például:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Sikeres indítás példa:
$ .\/seccomp_lib echo ok
ok
Blokkolt rendszerhívás példa:
$ sudo .\/seccomp_lib mount -t bpf bpf \/tmp
Hibás rendszerhívás
Használjuk strace, hogy részleteket tudjunk meg:
$ sudo strace -e seccomp .\/seccomp_lib mount -t bpf bpf \/tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ SIGSYS által megölve (core dump) +++
Hibás rendszerhívás
ahonnan megtudhatjuk, hogy a programot egy tiltott rendszerhívás miatt állították le mount(2).
Összességében írtunk egy szűrőt a libseccomp, amely nem trivialis kódot érintett négy sorban. A fentebbi példában, ha sok rendszerhívásunk van, a végrehajtási idő jelentősen csökkenthető, mivel a lekérdezés csak egy összehasonlító lista. A nemrégiben a libseccomp-ban , amely támogatja a szűrő attribútumát SCMP_FLTATR_CTL_OPTIMIZE. Ha ezt az attribútumot 2-re állítjuk, akkor a szűrő egy bináris kereső programra lesz átalakítva.
Ha szeretné megnézni, hogyan működnek a bináris kereső szűrők, nézze meg , amely BPF assembly programokat generál a rendszerhívás számok készlete alapján, például:
$ echo 1 3 6 8 13 | .\/generate_bin_search_bpf.py
ld [0]
jeq #6, bad
jgt #6, check8
jeq #1, bad
jeq #3, bad
ret #0x7fff0000
check8:
jeq #8, bad
jeq #13, bad
ret #0x7fff0000
bad: ret #0
Nem lehet lényegesen gyorsabban írni, mivel a BPF programok nem tudnak ugrani (nem tehetjük például a, jmp A vagy jmp [label+X]) és ezért minden ugrás statikus.
seccomp és strace
Mindenki ismeri a segédprogramot strace — nélkülözhetetlen eszköz a Linux rendszeren futó folyamatok viselkedésének kutatásához. Azonban sokan hallottak a ezen eszköz használata során. Az a helyzet, hogy strace a ptrace(2)-t, és ennél a mechanizmusnál nem tudjuk megadni, hogy pontosan melyik rendszerhívások halmazánál állítsuk meg a folyamatot, azaz például a parancsoknál
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
és
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
körülbelül ugyanolyan idő alatt futnak, bár a második esetben csak egy rendszerhívást akarunk nyomozni.
Az új opció --seccomp-bpf, amit a strace 5.3-as verzióban adtak hozzá, számos alkalommal felgyorsítja a folyamatot, és a nyomozás alatt álló egyetlen rendszerhívás indítási ideje már összehasonlítható a szokásos indítás idejével:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Itt természetesen van egy kis megtévesztés abban, hogy nem a parancs alapvető rendszerhívását nyomozzuk. Ha például a newfsstat-ot, akkor strace ugyanúgy megakasztaná, mint nélküle. --seccomp-bpf.)
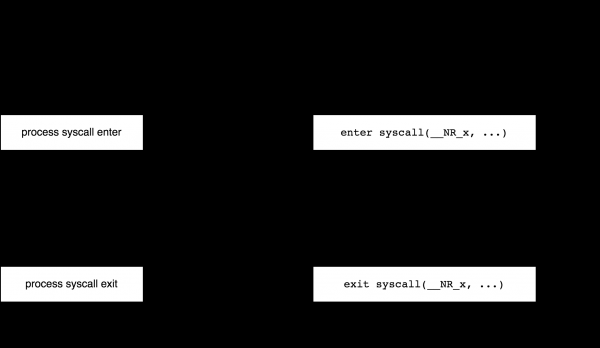
Hogyan működik ez az opció? Nélküle strace kapcsolódik a folyamathoz, és a PTRACE_SYSCALLsegítségével elindítja. Amikor a vezérelt folyamat elindít (bármilyen) rendszerhívást, a vezérlés átkerül strace, amely megnézi a rendszerhívás argumentumait, és elindítja azt a PTRACE_SYSCALL. Egy idő elteltével a folyamat befejezi a rendszerhívást, és amikor kiszáll belőle, a vezérlés ismét átkerül strace, amely megnézi a visszatérési értékeket, és elindítja a folyamatot a PTRACE_SYSCALL, és így tovább.
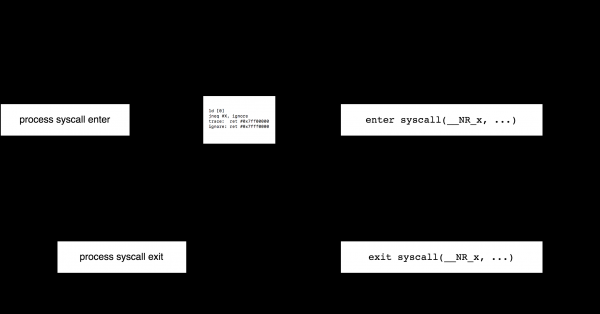
A seccomp segítségével azonban ezt a folyamatot pontosan úgy optimalizálhatjuk, ahogyan szeretnénk. Ha csak a rendszerhívást szeretnénk figyelni, X, akkor írnunk kell egy BPF szűrőt, amely X visszaadja a SECCOMP_RET_TRACEértéket, a minket nem érdeklő hívások esetén pedig — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
Ebben az esetben strace kezdettől fogva elindítja a folyamatot, mint PTRACE_CONT, minden egyes rendszerhívásnál a szűrőnk működik, ha a rendszerhívás nem X, akkor a folyamat folytatja a munkát, de ha ez X, akkor a seccomp átadja a vezérlést strace, amely megvizsgálja az argumentumokat, és a folyamatot elindítja. PTRACE_SYSCALL (mivel a seccomp nem tud programot indítani a rendszerhívásból való kilépéskor). Amikor a rendszerhívás visszatér, strace újraindítja a folyamatot a következő segítségével PTRACE_CONT és várni fog új üzenetekre a seccomp-tól.
A lehetőség használatánál --seccomp-bpf két korlátozás van. Először is, nem lehet csatlakozni egy már létező folyamathoz (lehetőség parancsban programok strace), mivel ezt a seccomp nem támogatja. Másodszor, nincs lehetőség nem megnézni a gyermek folyamatokat, mivel a seccomp szűrők öröklődnek minden gyermek folyamattól, és nem lehet ezt letiltani.
Néhány részlet arról, hogy pontosan strace kompatibilis seccomp tudható meg a . Számunkra a legérdekesebb tény az, hogy a klasszikus BPF a seccomp révén ma is alkalmazásban van.
xt_bpf
Most visszatérünk a hálózatok világába.
Előzmény: réges-régen, 2007-ben, a kernelbe került modul xt_u32 a netfilter számára. Ezt egy még régebbi forgalomklasszifikátor, cls_u32 mintájára írták, és lehetővé tette tetszőleges bináris szabályok írását az iptables számára a következő egyszerű műveletekkel: 32 bitet betölteni a csomagból, és elvégezni rajta egy halmaz aritmetikai műveletet. Például,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Betölti az IP fej egy 32 bitjét 6-os eltolástól kezdve, és alkalmaz egy maszkot 0xFF (a legkisebb bájt). Ez az IP fejléc protocol mezője, és ezt összehasonlítjuk 1-gyel (ICMP). Egy szabályban sok ellenőrzést kombinálhatunk, és végrehajthatunk a műveletet @ — lépj X bájttal jobbra. Például, a szabály
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"ellenőrzi, hogy a TCP Sorozatszám 0x29nem egyenlő-e. Nem szeretnék további részletekbe bonyolódni, mivel már világos, hogy ilyen szabályokat kézzel nem túl kényelmes írni. A cikkben , van néhány link példákkal a használatra és a szabályok generálására xt_u32. További linkek a cikk végén találhatók.
2013 óta a modul helyett xt_u32 felhasználható egy BPF alapú modul xt_bpf. Akik eddig eljutottak, már biztosan értik a működésének elvét: a BPF bájtkódot futtatni, mint szabályokat az iptables-ben. Új szabályt létrehozhatunk például így:
iptables -A INPUT -m bpf --bytecode -j LOGitt — ez az assembler kimeneti formátumban levő kód bpf_asm alapértelmezés szerint, például,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
Ebben a példában az összes UDP csomagot szűrjük. A BPF program kontextusa a modulban xt_bpf, persze, utal a csomag adatainak kezdetére, az iptables esetében pedig az IPv4 fejléc kezdetére. A BPF programból visszakapott érték , ahol hamis azt jelenti, hogy a csomag nem egyezett.
Nyilvánvaló, hogy a modul xt_bpf bonyolultabb szűrőket támogat, mint a fenti példa. Nézzük meg a Cloudfare valódi példáit. Nemrégig a xt_bpf DDoS támadások elleni védelemre használt modult. A cikkükben beszélnek arról, hogy (és miért) generálnak BPF szűrőket, és hivatkozásokat publikálnak olyan segédprogramok készletére, amelyek ilyen szűrők létrehozására szolgálnak. Például a bpfgen segítségével létrehozható egy BPF program, amely illeszkedik a DNS-kérelemhez a névvel habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
A programban először betöltjük a regiszterbe X a karakterlánc kezdő címét x04habrx03comx00 a UDP datagramon belül, majd ellenőrizzük a kérelmet: 0x04686162 "x04hab" stb.
Később a Cloudfare közzétette a p0f fordító kódját -> BPF. A cikkükben beszélnek arról, hogy mi az a p0f és hogyan lehet a p0f aláírásokat BPF-é alakítani:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
Jelenleg a Cloudfare már nem használja xt_bpf, mivel áttértek az XDP-re — a BPF új verziójának használatának egyik formájára, lásd. .
cls_bpf.
Az utolsó példa a klasszikus BPF kernelbeli használatára egy forgalomellenőrző osztályozó cls_bpf. a Linux forgalomkezelő rendszeréhez, amelyet 2013 végén adtak hozzá a Linuxhoz, és lényegében a régi cls_u32.
Egyébként most nem fogjuk leírni a működését, cls_bpf.mivel a klasszikus BPF tudás szempontjából ez nekünk semmit nem ad — már találkoztunk az összes funkcióval. Ezen kívül, a későbbi cikkekben, amelyek az Extended BPF-ről beszélnek, még sokszor találkozunk ezzel az osztályozóval.
Egy újabb ok, hogy ne beszéljünk a klasszikus BPF használatáról, cls_bpf. az az, hogy az Extended BPF-hez képest itt drámaian csökken a alkalmazási terület: a klasszikus programok nem tudják megváltoztatni a csomagok tartalmát, és nem tudják megőrizni az állapotot a hívások között.
Úgyhogy elérkezett az idő, hogy búcsút mondjunk a klasszikus BPF-nek és betekintsünk a jövőbe.
Búcsú a klasszikus BPF-től
Megnéztük, hogyan élt túl a BPF technológia, amelyet az 1990-es évek elején fejlesztettek ki, egy negyed évszázadon át, és hogyan találta meg új alkalmazásait. Azonban, ahogyan a stack gépekről RISC-re való átállás ösztönözte a klasszikus BPF fejlesztését, a 2000-es években megtörtént az áttérés a 32 bites gépekről a 64 bitesekre, ami miatt a klasszikus BPF elavult. Ezen kívül a klasszikus BPF képességei erősen korlátozottak, és az elavult architektúra mellett nincs lehetőségünk az állapot megőrzésére BPF programhívások között, nincs lehetőség közvetlen interakcióra a felhasználóval, és nincs lehetőség a rendszermaggal való interakcióra, csak a struktúra korlátozott mezőinek olvasására. sk_buff és a legegyszerűbb segédfunkciók elindítására, nem lehet módosítani a csomagok tartalmát és újra címezni őket.
Valójában a klasszikus BPF-ből a Linuxban ma már csak egy API interfész maradt, míg a rendszermag belső működésében az összes klasszikus program, legyenek ezek socket szűrők vagy seccomp szűrők, automatikusan átíródik az új formátumba, az Extended BPF-re. (Bemutatjuk, hogyan történik ez a következő cikkben.)
Az új architektúrára való áttérés 2013-ban kezdődött, amikor Aleksey Starovoitov javasolta a BPF frissítési séma elképzelését. 2014-ben a megfelelő javítások a rendszermagban. Amennyire én tudom, kezdetben csak az architektúra és a JIT-compiler optimalizálása volt a cél, hogy hatékonyabban működjenek a 64 bites gépeken, de ehelyett ezek az optimalizálások egy új fejezet kezdetét jelentették a Linux fejlesztésében.
A sorozat következő cikkei az új technológia architektúrájáról és alkalmazásairól fognak szólni, amely kezdetben internal BPF néven ismert, később extended BPF-nek, és most már egyszerűen csak BPF-nek hívják.
Hivatkozások
- Steven McCanne és Van Jacobson, "A BSD Packet Filter: A New Architecture for User-level Packet Capture",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: An Architecture and Optimization Methodology for Packet Capture",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF — a feledésbe merült bájtód:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - A BPF Eszköz Bemutatása:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- A seccomp áttekintése:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: egy pillantás a motorháztető alá",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Forrás: habr.com
