

Ahogy az IPv4 címek elfogynak, sok szolgáltató kénytelen szervezni az ügyfelek internet-hozzáférését címtfordítással. Ebben a cikkben arról fogok beszélni, hogyan érhetjük el a Carrier Grade NAT teljesítményt kereskedelmi szervereken.
Egy kis történelem
Az IPv4 címtartomány kimerülésének témája már nem új. Egy idő után a RIPE-nél várólisták (waiting list) jelentek meg, majd létrejöttek azok a tőzsdék, ahol címblokkokat adtak-vettek és bérleti szerződéseket kötöttek. Fokozatosan a szolgáltatók internet-hozzáférési szolgáltatásokat kezdtek kínálni címtfordítással és porttfordítással. Volt, aki nem tudta megszerezni a megfelelő címek számát, hogy minden előfizetőnek „fehér” címet kioszthasson, míg mások anyagi megfontolásból lemondtak a címek vásárlásáról a másodlagos piacon. A hálózati berendezések gyártói támogatták ezt az ötletet, mivel ez a funkció általában további bővítő modulokat vagy licenceket igényel. Például a Juniper MX routercsaládjában (kivéve az utolsó MX104 és MX204 modelleket) a NAPT-ot külön szolgáltatói kártyán, az MS-MIC-en lehet végrehajtani, a Cisco ASR1k esetében CGN licence szükséges, míg a Cisco ASR9k esetében egy külön modul, az A9K-ISM-100 és a hozzá tartozó A9K-CGN-LIC licence szükséges. Összességében nem olcsó mulatság.
IPTables
A NAT végrehajtásához nem szükségesek speciális számítási erőforrások, ezt bármilyen általános célú processzor képes megoldani, amely például bármely otthoni routerben megtalálható. Szolgáltatói szinten ezt a feladatot kereskedelmi szerverek segítségével lehet megoldani FreeBSD (ipfw/pf) vagy GNU/Linux (iptables) operációs rendszeren. A FreeBSD-t nem fogjuk figyelembe venni, mivel már régen lemondtam ennek az OS-nek a használatáról, így a GNU/Linux-ra összpontosítunk.
A címtfordítás bekapcsolása nem nehéz. Először is, egy szabályt kell beírni az iptables-nel a nat táblába:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
A rendszer betölti az nf_conntrack modult, amely nyomon követi az összes aktív kapcsolatot és elvégzi a szükséges átalakításokat. Itt van néhány apróság. Először is, mivel a NAT-ot szolgáltatói szinten alkalmazzuk, módosítani kell a timeout értékeket, mert az alapértelmezett értékek mellett a fordítási táblázat mérete elég gyorsan elérheti a katasztrofális szinteket. Az alábbiakban egy példa a beállításokra, amelyeket a szervereimen használtam:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
Másodszor, mivel az alapértelmezett fordítási táblázat mérete nem lett kiszámítva szolgáltatói környezetre, növelni kell:
net.netfilter.nf_conntrack_max = 3145728
Növelni kell a hash-táblázat bucketeinek számát is, amely az összes fordítást tárolja (ez az nf_conntrack modul opciója):
options nf_conntrack hashsize=1572864
Ezek után a kis módosítások után egy teljesen működőképes struktúrát kapunk, amely képes nagy mennyiségű kliens címet a külső poolba fordítani. Azonban, ennek a megoldásnak a teljesítménye hagy maga után kívánnivalót. Az első GNU/Linux NAT használati kísérleteim során (körülbelül 2013-ban) körülbelül 7Gbit/s sebességet és 0.8Mpps-t tapasztaltam egy szerveren (Xeon E5-1650v2). Azóta a GNU/Linux kernel hálózati stack-jében sokféle optimalizálás történt, így ugyanazon hardver mellett egy szerver teljesítménye gyakorlatilag 18-19 Gbit/s-ra nőtt 1.8-1.9 Mpps mellett (ezek voltak a határesetek), de a forgalom mennyisége, amelyet egy szerver feldolgozott, sokkal gyorsabban növekedett. Végül azonosították a terheléselosztási séma különböző szerverek közötti megosztását, de mindez növelte a konfiguráció, karbantartás és a szolgáltatási minőség fenntartásának bonyolultságát.
NFTables
Jelenleg a DPDK és XDP használata divatos irányzat a programozott "csomagok átvitelében". E témában rengeteg cikk készült, számos előadás hangzott el, és kereskedelmi termékek jelentek meg (például a VasExperts által készített SKAT). De a szolgáltatók korlátozott programozói erőforrásaival a saját "alkotás" elkészítése ezen keretrendszerek alapján meglehetősen problémás. Az ilyen megoldás későbbi alkalmazása sokkal bonyolultabb lesz, többek között diagnosztikai eszközöket is fejleszteni kell. Például a szokásos tcpdump nem fog működni DPDK-val, és a XDP-vel visszaküldött csomagokat sem fogja "látni". A csomagok felhasználói térbe való továbbításáról szóló új technológiákra vonatkozó összes beszélgetés hátterében a és Pablo Neira Ayuso, az iptables karbantartója a flow offloading nftables-ban való fejlesztéséről. Nézzük meg közelebbről ezt a mechanizmust.
Az alapötlet az, hogy ha az útválasztó mindkét irányban átengedte egy session csomagjait (a TCP session állapota ESTABLISHED lett), akkor nincs szükség a session további csomagjait az összes tűzfalszabályon átkonfigurálni, mivel az összes ellenőrzés végül a csomag továbbításához vezet a routingon keresztül. Sőt, az útvonal kiválasztását sem szükséges elvégezni — már tudjuk, melyik interfészhez és melyik hoszthoz kell továbbítani a csomagokat ezen a session keretein belül. Csak meg kell őrizni ezeket az információkat, és használni őket a csomagok korai feldolgozása során a routinghoz. NAT végrehajtásakor további információt kell megőrizni a címmel és portokkal kapcsolatos változásokról, amelyeket az nf_conntrack modul átalakít. Igen, természetesen ilyenkor a különféle policy-k és egyéb információs-statisztikai szabályok az iptables-ben nem fognak működni, de egy egyedi NAT vagy pl. a borderek esetében ez nem olyannyira fontos, mert a szolgáltatások el vannak osztva az eszközök között.
Konfiguráció
Ahhoz, hogy ezt a funkciót igénybe vegyük, a következőkre van szükség:
- Friss kernel használata. Bár a funkció önállóan már a 4.16-os kernelben megjelent, meglehetősen sokáig nagyon "nyers" volt, és rendszeresen kernel panikot okozott. 2019 decemberében stabilizálódott, amikor megjelentek az LTS kernelforgalmok, a 4.19.90 és az 5.4.5.
- Írja át az iptables szabályokat nftables formátumba, friss nftables verziót használva. Pontosan működik a 0.9.0 verzióban.
Ha az első pont alapvetően érthető, a legfontosabb, hogy ne felejtsük el beilleszteni a modult a konfigurációba a fordítás során (CONFIG_NFT_FLOW_OFFLOAD=m), a második pont további magyarázatot igényel. Az nftables szabályok megfogalmazása teljesen más, mint az iptables esetében. szinte minden szempontot feltár, emellett speciális iptables-ból nftables-ba. Ezért csak egy NAT és flow offload beállítási példát mutatok be. Egy kis legenda a példához: <i_if>, <o_if> — ezek azok a hálózati interfészek, amelyeken keresztül a forgalom átmegy, valójában több mint kettő is lehet. <pool_addr_start>, <pool_addr_end> — a „fehér” címek tartományának kezdeti és végcíme.
A NAT konfiguráció nagyon egyszerű:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
A flow offload egy kicsit bonyolultabb, de teljesen érthető:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Ez tehát az összes beállítás. Mostantól minden TCP/UDP forgalom a fastnat táblába fog kerülni, és sokkal gyorsabban lesz feldolgozva.
Eredmények
Hogy érthetőbb legyen, mennyivel „gyorsabb” ez, mellékelek egy képernyőképet két valós szerver terheléséről, amelyek azonos hardverrel rendelkeznek (Xeon E5-1650v2), azonos beállításokkal, ugyanazt a Linux kernelt használják, de az iptables (NAT4) és nftables (NAT5) NAT-ot hajtanak végre.
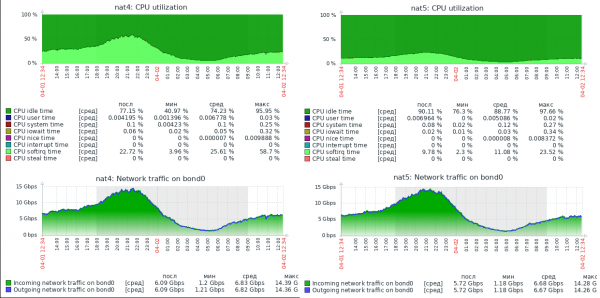
A képernyőképen nincs csomagok másodpercre vonatkozó grafikon, de ezen szerverek terhelési profiljában a csomagok átlagos mérete körülbelül 800 bájt, ezért az értékek elérik az 1.5Mpps-t. Mint látható, hatalmas teljesítménytartalék van az nftables-szal rendelkező szervernél. Jelenleg ez a szerver 30Gbit/s-ot kezel 3Mpps mellett, és egyértelműen képes elérni a 40Gbps fizikai hálózati korlátot, miközben CPU erőforrásai még mindig szabadok.
Remélem, hogy ez az anyag hasznos lesz a hálómérnökök számára, akik javítani próbálják szervereik teljesítményét.
Forrás: habr.com
