

Helló! A nevem Vadim Madison, az Avito System Platform fejlesztését irányítom. Rendszeresen szóba került, hogyan térünk át a monolitikus architektúráról a mikroszolgáltatásokra. Itt az ideje, hogy megosszam, hogyan alakítottuk át az infrastruktúránkat, hogy a mikroszolgáltatásokból a lehető legtöbbet hozhassuk ki, és elkerüljük, hogy elveszünk bennük. Hogyan segít bennünket a PaaS, hogyan egyszerűsítettük le a telepítést és hogyan csökkentettük a mikroszolgáltatás létrehozását egy kattintásra – olvass tovább. Nem minden, amiről az alábbiakban írok, valósult meg az Avitónál teljes mértékben, részben pedig azt, hogyan fejlesztjük a platformunkat.
(És a cikk végén beszámolok egy lehetőségről, hogy részt vehess egy háromnapos szemináriumon a mikroszolgáltatás-architektúra szakértője, Chris Richardson által).
Hogyan jutottunk el a mikroszolgáltatásokhoz
Az Avito a világ egyik legnagyobb hirdetési platformja, ahol naponta több mint 15 millió új hirdetést publikálnak. A backendünk másodpercenként több mint 20 ezer kérést kezel. Jelenleg több száz mikroszolgáltatásunk van.
A mikroszolgáltatás-architektúrát nem most kezdtük el kiépíteni. Hogyan is – kollégáink a részletekről a RIT++ 2017-es szekciónkon. A CodeFest 2017-en (lásd: ), Sergey Orlov és Mihail Prokopcsuk részletesen elmagyarázták, hogy miért volt szükségünk egyáltalán a mikroszolgáltatásokra, és milyen szerepet játszott nálunk a Kubernetes. Jelenleg mindent megteszünk, hogy minimalizáljuk azokat az üzemeltetési költségeket, amelyeket ez az architektúra magában hordoz.
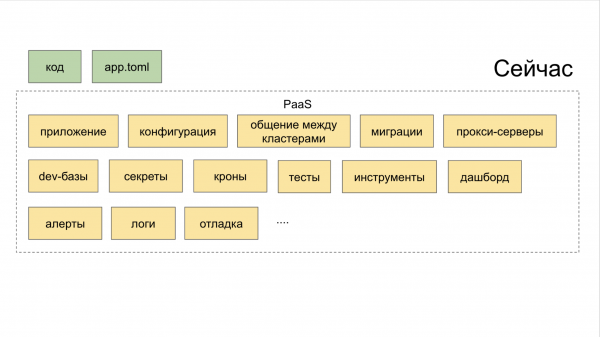
Eredetileg nem alakítottunk ki egy olyan ökoszisztémát, amely átfogóan segítette volna a mikroszolgáltatások fejlesztését és indítását. Csak összegyűjtöttük a hasznos nyílt forráskódú megoldásokat, üzembe helyeztük őket, és javasoltuk a fejlesztőknek, hogy foglalkozzanak velük. Ennek eredményeként a fejlesztők számos helyre (irányítópultok, belső szolgáltatások) jártak, így megerősödtek abban a vágyban, hogy a régi, monolitikus módon írják meg a kódot. Az alábbi ábrákon zöld színnel jelöljük azt, amit a fejlesztő valamilyen módon a saját kezével végez el, sárga színnel pedig az automatizálást.
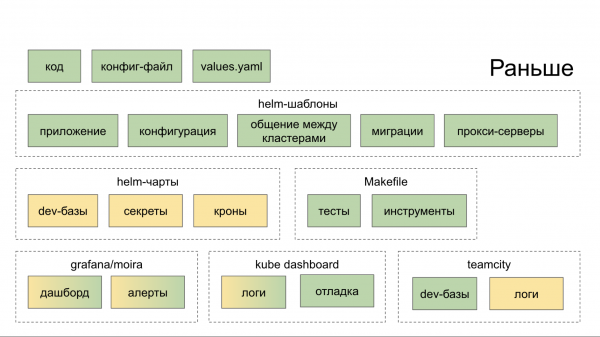
Most a PaaS CLI segédprogramjában egy parancs használatával új szolgáltatás jön létre, két másikkal pedig új adatbázis hozzáadása és a Stage-be történő telepítés történt.
Hogyan lehet leküzdeni a „mikroszolgáltatásból adódó fragmentáltság” korszakát
A monolit architektúra esetében a termékben végrehajtott változások következetessége érdekében a fejlesztők kénytelenek voltak tisztában lenni a szomszédjaik munkájával. Az új architektúra alkalmazásakor a szolgáltatások összefonódása megszűnt.
A mikroservice architektúra hatékonyságának biztosításához számos folyamatot kell bevezetni, nevezetesen:
• naplózás;
• kérések nyomkövetése (Jaeger);
• hibák aggregálása (Sentry);
• állapotok, üzenetek, események a Kubernetesből (Eseménystream-feldolgozás);
• race limit / circuit breaker (Hystrix használható);
• a szolgáltatások összefonódásának ellenőrzése (mi a Netramesh-t használjuk);
• monitorozás (Grafana);
• buildelés (TeamCity);
• kommunikáció és értesítés (Slack, e-mail);
• feladatkövetés (Jira);
• dokumentáció készítése.
Annak érdekében, hogy a rendszer a méretezés során ne veszítse el integritását, és továbbra is hatékony maradjon, újragondoltuk a mikroservice-ek munkaszervezését az Avitónál.
Hogyan kezeljük a mikroservice-eket
A sok különálló Avito-mikroszolgáltatás között az egységes "politika" végrehajtásához segít:
- az infrastruktúra rétegekre osztása;
- a Platform as a Service (PaaS) fogalma;
- minden, a mikroservice-ekkel kapcsolatos esemény monitorozása.
Az infrastruktúra absztrakciós szintjei három rétegre oszlanak. A legfelsőről indulunk lefelé.
A. Legfelső — service mesh. Kezdetben kipróbáltuk az Istiót, de kiderült, hogy túl sok erőforrást használ, ami a mi volumenünknél túlságosan drága. Ezért a csapatunk architektúráért felelős vezető mérnöke, Alekszandr Lukjančenko kidolgozott egy saját megoldást — (Open Source elérhető), amelyet most a gyakorlatban használunk, és amely jóval kevesebb erőforrást fogyaszt, mint az Istio (de nem is tesz meg mindent, amire az Istio képes).
B. Középső — Kubernetes. Ezen futtatjuk és üzemeltetjük a mikroservice-eket.
C. Alsó — bare metal. Nem használunk felhőket és hasonló megoldásokat, mint az OpenStack, teljes mértékben bare metal-al dolgozunk.
Az összes réteg a PaaS-t egyesíti. Ez a platform pedig három részből áll.
I. Generátorok, amelyeket CLI-eszközön keresztül irányítunk. Ez segít a fejlesztőknek, hogy helyesen és minimális erőfeszítéssel hozzanak létre mikroservice-t.
II. Összegyűjtő gyűjtő a közös irányítópulton keresztül az összes eszköz ellenőrzésével.
III. Tároló. Kompatibilis azokkal a tervezőkkel, amelyek automatikusan aktiválják a jelentős események triggereit. Ennek a rendszernek köszönhetően egyetlen feladat sem marad el, csak azért, mert valaki elfelejtette feltenni magának a feladatot a Jira-ba. Ehhez belső eszközt használunk, amelynek neve Atlas.
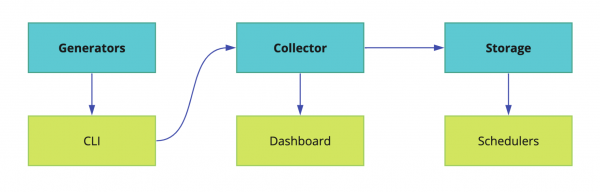
A mikroszolgáltatások megvalósítása az Avitonál egységes schemá szerint történik, ami megkönnyíti a kontollt minden fejlesztési és kiadási szakaszban.
Hogyan működik a mikroszolgáltatás fejlesztésének standard folyamata
Általános nézetben a mikroszolgáltatás létrehozásának láncolata a következőképpen néz ki:
CLI-push → Folyamatos Integráció → Bake → Telepítés → Mesterséges tesztek → Canary-tesztek → Squeeze Testing → Éles üzem → Karbantartás.
Most lépésről lépésre végigmegyünk rajta.
CLI-push
• Mikroszolgáltatás készítése.
Sokáig dolgoztunk azon, hogy minden fejlesztőt megtanítsunk a mikroszolgáltatások létrehozására. Részletes útmutatókat írtunk a Confluence-be. De a sémák folyamatosan változtak és bővültek. Az eredmény — üvegnyak alakult ki az út elején: a mikroszolgáltatások elindítása több időt vett igénybe, mint ami megengedett, és ennek ellenére gyakran problémák merültek fel a létrehozásuk során.
Végül elkészítettünk egy egyszerű CLI-eszközt, amely automatizálja a mikroszolgáltatás létrehozásának fő lépéseit. Gyakorlatilag ez helyettesíti az első git push-t. Íme, mit csinál pontosan.
— Szerviz létrehozása sablon szerint — lépésről-lépésre, "varázsló" üzemmódban. Van néhány sablonunk az Avito háttérprogramozási nyelveihez: PHP, Golang és Python.
— Egy parancsra telepíti a helyi fejlesztési környezetet egy adott gépen — Minikube elindítása, Helm-diagramok automatikusan generálódnak és elindulnak a helyi Kubernetes környezetben.
— Csatlakoztatja a szükséges adatbázist. A fejlesztőnek nem kell tudnia az IP-t, felhasználónevet és jelszót, hogy hozzáférjen a szükséges adatbázishoz — akár helyben, akár a Stage-en, akár éles környezetben. Ráadásul az adatbázis azonnal hibatűrő konfigurációban és terheléselosztással kerül telepítésre.
— Magától végzi a live build-et. Tegyük fel, hogy a fejlesztő helyben módosít valamit a mikroszolgáltatásban a saját IDE-jében. Az eszköz érzékeli a fájlrendszerbeli változásokat, és ezen alapulva újraépíti az alkalmazást (Golang esetén) és újraindítja. PHP esetén egyszerűen áthúzzuk a könyvtárat a konténerbe, és ott a live-reload automatikusan történik.
— Automatikus teszteket generál. Sablonformában, de teljesen használható.
• Mikroszolgáltatás telepítése.
Korábban kissé bonyolult volt a mikroszolgáltatásunk telepítése. Kötelező volt:
I. Dockerfile.
II. Konfiguráció.
III. Helm-diagram, amely önmagában is terjedelmes, és tartalmazza:
— magukat a diagramokat;
— sablonokat;
— konkrét értékeket a különböző környezetek figyelembevételével.
Megszabadultunk a Kubernetes-mánifestek átírásával járó fájdalmaktól, és most már automatikusan generálódnak. De a legfontosabb, hogy a telepítés a lehető legegyszerűbbé vált. Most már van Dockerfile-unk, és az összes konfigurációt a fejlesztő egyetlen rövid app.toml fájlban adja meg.
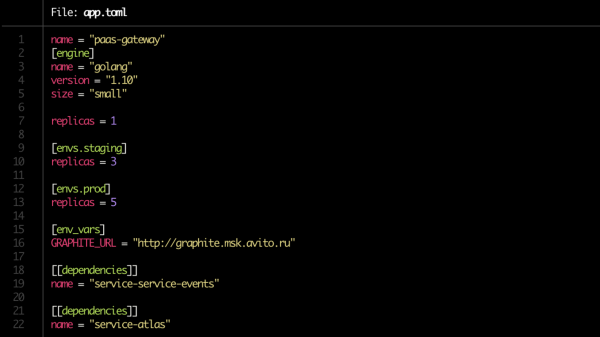
Az app.toml fájl elkészítése most már percek kérdése. Megadjuk, hogy hány példányt indítsunk a szolgáltatásból (fejlesztői szerveren, staging-en, éles környezetben), és feltüntetjük a függőségeit. Figyeljen arra a size = "small" sorra a [engine] blokkban. Ez az a limitek, amit a szolgáltatásnak a Kubernetesen keresztül biztosítanak.
Ezt követően a konfiguráció alapján automatikusan generálódnak az összes szükséges Helm-diagram, és létrejönnek az adatbázishoz való kapcsolatok.
• Alapvető validáció. Ezeket az ellenőrzéseket is automatizálták.
Figyelemmel kell kísérni:
— van-e Dockerfile;
— van-e app.toml;
— létezik-e dokumentáció;
— rendben vannak-e a függőségek;
— meg vannak-e adva az alert szabályok.
A legutolsó ponthoz: a szolgáltatás tulajdonosa meghatározza, hogy milyen termékmetrikákat kell figyelni.
• Dokumentáció előkészítése.
Ez még mindig problémás hely. Látszólag a legnyilvánvalóbb, de mégis a rekordgyanúsan 'leggyakrabban elfelejtett', tehát a lánc legsebezhetőbb láncszeme.
Szükséges, hogy minden mikroszolgáltatáshoz készüljön dokumentáció. Az alábbi blokkokat tartalmazza.
I. A szolgáltatás rövid leírása. Pár mondat arról, mit csinál és miért szükséges.
II. Hivatkozás az architektúra diagramra. Fontos, hogy egy pillantással könnyen megértsük, például használunk-e Redis-t cache-elésre vagy mint alapvető adattárolót állandó módban. Az Avito esetében ez egy hivatkozás a Confluence-re.
III. Runbook. Rövid útmutató a szolgáltatás indításához és a használatára vonatkozó finomságokhoz.
IV. FAQ, ahol érdemes lenne előre látni a problémákat, amelyekkel a kollégák a szolgáltatás használata során szembesülhetnek.
V. Az API végpontok leírása. Ha véletlenül nem jelezte a célállomásokat, akkor szinte biztos, hogy a kollégái fognak ezért fizetni, akiknek a mikroszolgáltatásai kapcsolódnak az Önéhez. Jelenleg ehhez a Swagger-t és a brief nevű megoldásunkat használjuk.
VI. Címkék. Vagy olyan jelölők, amelyek megmutatják, hogy a szolgáltatás melyik termékhez, funkcióhoz vagy a cég melyik struktúrájához tartozik. Segítenek gyorsan megérteni, például nem készíti-e el ismét ugyanazt a funkciót, amelyet a kollégái egy héttel ezelőtt vezettek be ugyanannak az üzleti egységnek.
VII. A szolgáltatás tulajdonosa vagy tulajdonosai. A legtöbb esetben őt — vagy őket — a PaaS segítségével automatikusan meg tudjuk határozni, de a biztonság kedvéért megköveteljük a fejlesztőtől, hogy őket manuálisan is feltüntesse.
Végül, jó gyakorlat a dokumentáció áttekintése, hasonlóan a kódellenőrzéshez.
folyamatos integrációnak
- A tárolók előkészítése.
- A pipeline létrehozása a TeamCityben.
- A jogosultságok beállítása.
- A szolgáltatás tulajdonosainak keresése. Itt hibrid séma van — kézi címkézés és minimális automatizálás a PaaS-tól. A teljesen automatikus séma hibát okoz, amikor a szolgáltatásokat más fejlesztőcsapatba adják támogatásra, vagy például ha a szolgáltatás fejlesztője távozik.
- A szolgáltatás regisztrálása az Atlasban (lásd fent). Minden tulajdonosával és függőségeivel.
- A migrációk ellenőrzése. Ellenőrizzük, hogy van-e köztük potenciálisan veszélyes. Például egyik migrációnál előfordul az alter table vagy más, ami megsértheti az adatsémák kompatibilitását a szolgáltatás különböző verziói között. Ekkor a migráció nem hajtható végre, és feliratkozik — a PaaS-nek jeleznie kell a szolgáltatás tulajdonosának, amikor biztonságosan alkalmazható.
Bake
A következő szakasz — a szolgáltatások becsomagolása a telepítés előtt.
- Az alkalmazás összegyűjtése. A klasszikus módon — Docker-képekké.
- A Helm-diagramok generálása a szolgáltatás és a kapcsolódó erőforrások számára. Amit a adatbázisok és a cache is tartalmaz. Ezek automatikusan jönnek létre az app.toml konfigurációval összhangban, amely a CLI-push szakaszban készült.
- A nyitott portok megnyitására adminisztrátoroknak jegyek létrehozása (amikor ez szükséges).
- Egységes tesztek futtatása és a kódlefedettség kiszámításaHa a kódlefedettség a megadott küszöbérték alatt van, valószínűleg a következő lépés, a deploy, nem fog sikerülni. Ha az elfogadható határon van, akkor a szolgáltatás „pesszimista” értékelést kap: ha a mutatók időben történő javulása elmarad, a fejlesztő értesítést kap arról, hogy nem történik előrehaladás a tesztelés terén (és tenni kellene valamit ezzel kapcsolatban).
- Memória és CPU korlátok figyelembe vételeFőként a mikroserviszokat Golang nyelven írjuk és Kubernetesben futtatjuk. Ebből adódik egy apróság, amely a Golang nyelv sajátosságával függ össze: alapértelmezés szerint a gépen lévő összes magot aktiválják, hacsak a GOMAXPROCS változót nem állítjuk be kifejezetten, és amikor egy gépen több ilyen szolgáltatást indítunk, akkor azok versenyeznek az erőforrásokért, zavarva egymást. Az alábbi grafikonokon látható, hogyan változik a végrehajtási idő, ha az alkalmazást verseny nélkül és erőforrást kivéve futtatják. (A grafikonok forrásai itt találhatók ).
Futtatás ideje, kevesebb – jobb. Maximum: 643ms, minimum: 42ms. A kép kattintható.
Műveleti idő, kevesebb – jobb. Maximum: 14091 ns, minimum: 151 ns. A kép kattintható.
A build előkészítése során ezt a változót kifejezetten be lehet állítani, vagy használhatjuk a az Uber csapatától.
Deploy
• A konvenciók ellenőrzése. Mielőtt elkezdenénk a szolgáltatás buildjeit a tervezett környezetekbe telepíteni, a következőket kell ellenőrizni:
— API végpontok.
— API végpontok válaszainak megfelelősége a sémának.
— A naplóformátum.
— Fejlécek beállítása a szolgáltatáshoz intézett kérések során (jelenleg ezt a netramesh végzi)
— A tulajdonos jelző beállítása az eseménybuszra küldött üzenetek során. Ez szükséges a szolgáltatások közötti kapcsolódás nyomon követéséhez az buszon. Az buszra lehet küldeni idempotens adatokat, amelyek nem növelik a szolgáltatások közötti kapcsolódást (ami jó), valamint üzleti adatokat, amelyek erősítik a szolgáltatások közötti kapcsolódást (ami nagyon rossz!). És abban a pillanatban, amikor ez a kapcsolódás problémát okoz, a megértés, hogy ki írja és olvassa az buszt, segít a szolgáltatások helyes elosztásában.
Jelenleg még nem sok konvenció van az Avito rendszereiben, de a választék bővül. Minél több ilyen megállapodás van a csapat számára érthető és kényelmes formában, annál könnyebb fenntartani a következetességet a mikroserviszok között.
Szintrikus tesztek
• Tesztelés zárt környezetben. Ehhez jelenleg nyílt forráskódú Először feljegyzi a szolgáltatás tényleges terhelését, majd — egy zárt környezetben — azt emulálja.
• Terheléstesztelés. Minden szolgáltatást a lehető legjobb teljesítményre igyekszünk optimalizálni. Minden szolgáltatás minden verzióját terheléstesztelésnek vetjük alá — így megérthetjük a szolgáltatás aktuális teljesítményét és a korábbi verziókhoz viszonyított eltéréseket. Ha a szolgáltatás frissítése után a teljesítménye másfélszeresére csökken, az egyértelmű jelzés a tulajdonosoknak: meg kell keresniük a problémát a kódban.
Az összegyűjtött adatokra alapozva például helyesen tudjuk megvalósítani az auto scalinget, és végül megérthetjük, mennyire skálázható a szolgáltatás.
Terheléstesztelés során ellenőrizzük, hogy a forrásfogyasztás megfelel-e a megadott korlátozásoknak. Különösen a szélsőségekre összpontosítunk.
a) Megfigyeljük az összes terhelést.
— Túl alacsony — valószínűleg valami teljesen nem működik, ha a terhelés hirtelen több alkalommal esett.
— Túl magas — optimalizálás szükséges.
b) Megfigyeljük a RPS küszöböt.
Itt nézzük a jelenlegi és a korábbi verzió közötti eltérést, valamint az összesített számot. Például, ha a szolgáltatás 100 rps-t szolgáltat — akkor vagy rosszul van megírva, vagy ez a speciális jellemzője, de mindenesetre ez okot ad arra, hogy nagyon alaposan megvizsgáljuk a szolgáltatást.
Ha az RPS viszont túl magas, akkor lehet, hogy valamilyen hiba miatt valamelyik endpoint nem hajtja végre a hasznos terhelést, és egyszerűen csak aktiválódik egy ilyen return true;
Canary tesztek
Miután a szintetikus teszteken átestünk, kipróbáljuk a mikroszolgáltatás működését egy kis felhasználói körön. Óvatosan kezdünk, a potenciális szolgáltatói közönségnek kevesebb mint 0,1%-ával. Ezen a szakaszon nagyon fontos, hogy a monitoringban megfelelő technikai és termékmetrikák legyenek beállítva, hogy a lehető leggyorsabban jelezzék a problémát a szolgáltatásban. Minimális ideje a canary tesztnek — 5 perc, főként — 2 óra. Bonyolultabb szolgáltatások esetén kézi üzemmódban állítunk be időt.
Elemzünk:
— nyelvspecifikus metrikák, különösen a php-fpm munkafolyamatok;
— hibák a Sentryn;
— válaszállapotok;
— válaszidők (response time), pontos és átlagos;
— késleltetés;
— kezelhető és nem kezelhető kivételek;
— termékmetrikák.
Squeeze Testing
A Squeeze Testing-et "squeeze"-nek is nevezik. Ezt a módszert a Netflix vezette be. Az eljárás lényege, hogy először valós forgalommal feltöltünk egy példányt a meghibásodás állapotáig, és így meghatározzuk a határát. Ezután hozzáadunk egy másik példányt, és újra maximális terhelésnek tesszük ki őket; látjuk a maximális teljesítményüket és a különbséget az első „squeeze” után. Így lépésről lépésre kapcsolunk be újabb példányokat és számítjuk ki a változások tendenciáját.
A „squeeze” tesztadatai is egy közös metrikákkal ellátott adatbázisba kerülnek, ahol vagy gazdagítjuk a mesterséges terhelés eredményeit, vagy teljesen helyettesítjük a „szintetikus” adatokkal.
Termelés
• Skálázás. A szolgáltatás bevezetésekor figyelemmel kísérjük, hogyan skálázódik. Tapasztalataink szerint a CPU mutatók megfigyelése önmagában nem hatékony. Az auto scaling tiszta RPS benchmarking-el működik, de csak egyes szolgáltatások, például online streaming esetén. Ezért elsősorban az alkalmazás-specifikus termékmetrikákkal foglalkozunk.
Végül a skálázás során elemezzük:
— a CPU és RAM mutatókat,
— a sorban álló kérések számát,
— a válaszidőt,
— a felhalmozott történeti adatok alapján készült előrejelzést.
A szolgáltatás skálázásakor fontos követni a függőségeit, hogy elkerüljük, hogy az első szolgáltatás a láncban skálázódik, míg azok, amelyekre hivatkozik, a terhelés alatt összeomlanak. Az elfogadható terhelés megállapításához a legközelebbi függő szolgáltatás történeti adataira (CPU és RAM kombinációja, valamint alkalmazás-specifikus metrikák) támaszkodunk, és ezeket összehasonlítjuk az indító szolgáltatás történeti adataival, és így tovább a „függőségek láncolataként”, felülről lefelé.
Karbantartás
Miután a mikroszolgáltatást üzembe helyeztük, trigger-eket állíthatunk be rá.
Íme a trigger bekapcsolásának tipikus helyzetei.
— Potenciálisan veszélyes migrációk kerültek elő.
— Biztonsági frissítések kerültek kiadásra.
— A szolgáltatás régen nem frissült.
— Érezhetően csökkent a szolgáltatás terhelése, vagy bármelyik termékmetrikája a normálempontok alá esik.
— A szolgáltatás már nem felel meg a platform új követelményeinek.
A triggerek egy része a stabilitásért felelős, másik része — mint a rendszer karbantartási funkciója — például, ha egy szolgáltatás hosszú ideje nem került telepítésre, és az alapképe már nem felel meg a biztonsági ellenőrzéseknek.
Irányítópult
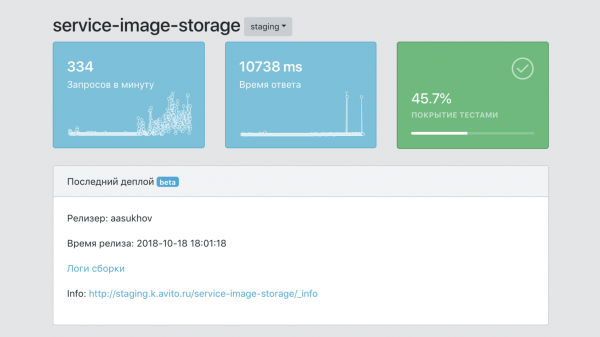
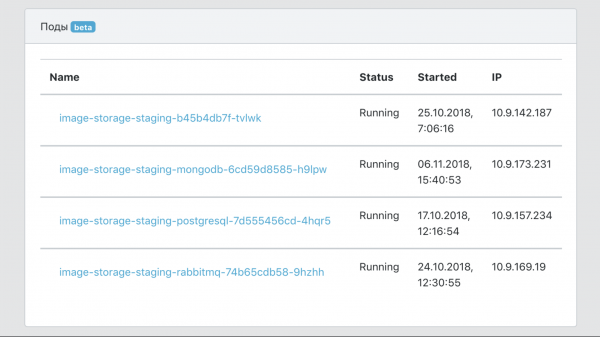
Röviden, az irányítópult a PaaS teljes vezérlőpanele.
- Egységes információs pont a szolgáltatásokról, adatokkal a tesztelésük lefedettségéről, a képeik számáról, a produkciós másolatok számáról, verzióikról, stb.
- Adatok szűrésére szolgáló eszközök a szolgáltatások és címkék (üzleti egységekhez, termékelőnyökhöz stb. való tartozás jelölője) alapján.
- Az infrastruktúraeszközökkel való integrációs eszköz a nyomozáshoz, naplózáshoz, monitorozáshoz.
- Egységes dokumentációs pont a szolgáltatásokról.
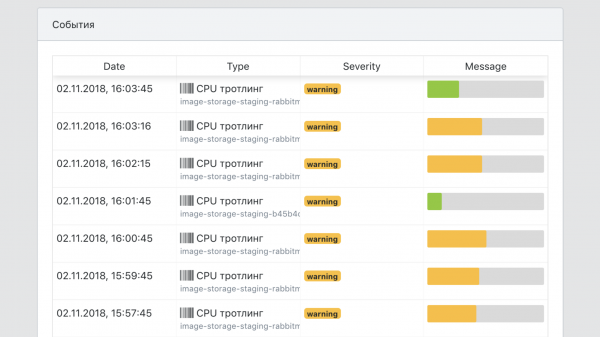
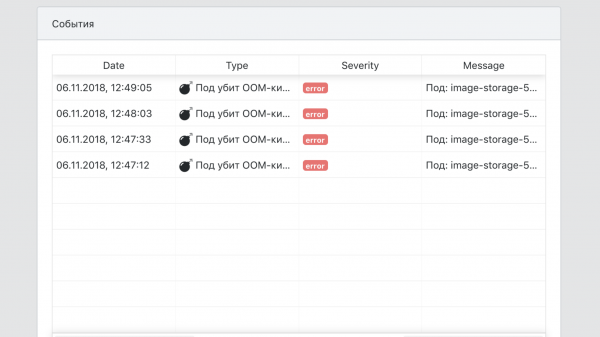
- Egységes áttekintési pont az összes eseményről a szolgáltatások kapcsán.
Összesen
A PaaS bevezetése előtt egy új fejlesztő akár hetekig is eltölthette az összes szükséges eszköz megismerésével a mikroservisz produkcióhoz való indításához: Kubernetes, Helm, — a belső TeamCity sajátosságainkkal, a kapcsolódás beállítása adatbázisokhoz és cache-hez hibamentes módon stb. Most mindez pár órát vesz igénybe — elolvasni a gyorsindítót és elkészíteni a szolgáltatást.
E témában tartottam előadást a HighLoad++ 2018 konferencián, meg lehet nézni. és .
Bónusz track azoknak, akik végigolvassák.
Az Aviton belül háromnapos belső tréninget szervezünk fejlesztőknek. , a mikroserviz-architektúra szakértője. Szeretnénk lehetőséget adni valakinek a poszt olvasói közül, hogy részt vegyen rajta. A tréning programja ki van téve.
A tréning augusztus 5-től 7-ig Moszkvában zajlik. Ezek munkanapok lesznek, amelyek teljes egészében elfoglaltak. Az ebéd és a tanulás az irodánkban lesz, a kiválasztott résztvevőnek pedig saját magának kell fedeznie az utazást és a szállást.
A részvételi kérelmet , lehet benyújtani. Tőled annyit kérünk, hogy válaszolj arra a kérdésre, miért éppen neked lenne szükséged a tréningre, és ad meg, hogyan lehet veled kapcsolatba lépni. Angolul válaszolj, mert Chris maga választja ki a tréningre jelentkezőt.
A tréning résztvevőjének nevét a poszt frissítésében és az Avito fejlesztőknek szóló közösségi médiájában (AvitoTech a , , ) legkésőbb július 19-ig be fogjuk jelenteni.
Forrás: habr.com
