

A elosztott számítások és nagy adatok piaca, ha hihetünk , évente 18-19%-kal növekszik. Ez azt jelenti, hogy a megfelelő szoftver kiválasztásának kérdése továbbra is aktuális. Ebben a bejegyzésben elkezdjük azzal, hogy miért van szükség elosztott számításokra, részletesebben megvizsgáljuk a szoftverek kiválasztását, beszélünk a Hadoop alkalmazásáról a Cloudera segítségével, és végül a hardver kiválasztásáról, valamint arról, hogy ez hogyan befolyásolja a teljesítményt különböző módokon.
Miért van szükség elosztott számításokra a hagyományos üzleti életben? Itt minden egyszerű és egyszerre bonyolult. Egyszerű — mert a legtöbb esetben viszonylag egyszerű számításokat végzünk egy információegységre. Bonyolult — mert ilyen információkból sok van. Nagyon sok. Ennek következtében Így a felhasználási forgatókönyvek meglehetősen univerzálisak: a számítások bárhol alkalmazhatók, ahol figyelembe kell venni a sok metrikát egy még nagyobb adathalmazon.
Egyik legutóbbi példa: a Dodo Pizza pizzéria lánc a vásárlói megrendelések adatainak elemzése alapján, miszerint a felhasználók általában hat alapvető hozzávalóval és néhány véletlenszerűvel dolgoznak, amikor bárminek az ízét választják. Ennek megfelelően a pizzéria a beszerzéseit ehhez igazította. Emellett jobban tudták ajánlani a felhasználóknak a rendelés során felajánlott kiegészítő termékeket, ami növelte a bevételeket.
Még egy példa: a termékek szempontjából lehetővé tette az H&M üzlet számára, hogy a választékot 40%-kal csökkentse egyes üzletekben, miközben a forgalmát megőrizte. Ezt úgy érték el, hogy kizárták a gyengén teljesítő termékeket, figyelembe véve a szezonális hatásokat.
A megfelelő eszköz kiválasztása
Az ilyen jellegű számítások iparági szabványa a Hadoop. Miért? Mert a Hadoop egy kiváló, jól dokumentált keretrendszer (ugyanaz a Habr számos részletes cikket ad ki erről), amely egy sor segédprogramot és könyvtárat tartalmaz. Óriási mennyiségű strukturált és strukturálatlan adatot is feldolgozhat, és a rendszer automatikusan elosztja azokat a számítási kapacitások között. Ráadásul ezeket a kapacitásokat bármikor növelheti vagy kikapcsolhatja — ez a tényleges vízszintes skálázhatóság működésben.
2017-ben a befolyásos Gartner tanácsadó cég , hogy a Hadoop hamarosan elavul. Az ok meglehetősen banális: az elemzők úgy vélik, hogy a vállalatok tömegesen fognak átköltözni a felhőbe, mivel ott csak a ténylegesen használt számítási kapacitásért kell fizetniük. A második fontos tényező, amely állítólag "eltemetheti" a Hadoopot, a működési sebesség. Mivel az olyan megoldások, mint az Apache Spark vagy a Google Cloud DataFlow, gyorsabbak, mint a Hadoop alapját képező MapReduce.
A Hadoop több pilléren nyugszik, a legszembetűnőbbek a MapReduce technológiák (adatok elosztási rendszere a számítógépek közötti számításokhoz) és a HDFS fájlrendszer. Az utóbbi kifejezetten a klaszter csomópontjai között elosztott információk tárolására szolgál: minden, rögzített méretű blokk több csomóponton is elhelyezkedhet, és a replikációnak köszönhetően a rendszer ellenáll az egyes csomópontok meghibásodásának. A fájltábla helyett egy speciális szerver, az úgynevezett NameNode használatos.
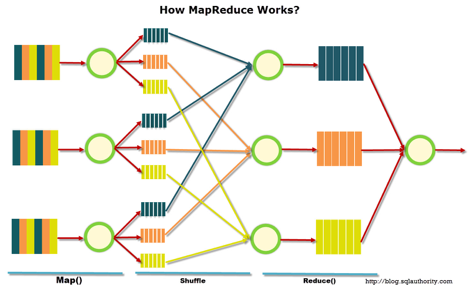
Az alábbi illusztráción a MapReduce működési sémája látható. Az első szakaszban az adatokat egy adott jelleg szerint felosztják, a másodikban elosztják a számítási kapacitások között, a harmadikban pedig a számítások zajlanak.
A MapReduce-t eredetileg a Google fejlesztette a saját keresője számára. Ezután a MapReduce nyílt forráskódú lett, és az Apache vette át a projektet. A Google pedig fokozatosan más megoldásokra tért át. Érdekes dolog, hogy jelenleg a Google fejleszt egy projektet, amely Google Cloud Dataflow néven ismert, és amelyet a Hadoop következő lépéseként pozicionálnak, mint gyors alternatíva.
Közelebbről megvizsgálva látható, hogy a Google Cloud Dataflow az Apache Beam egyik variantejára alapoz, miközben az Apache Beam jól dokumentált Apache Spark keretrendszert tartalmaz, ami lehetővé teszi, hogy gyakorlatilag azonos sebességgel hajtsák végre a megoldásokat. Az Apache Spark kiválóan működik a HDFS fájlrendszeren, ami lehetővé teszi, hogy a Hadoop szervereken telepítsék.
Ha ehhez hozzávesszük a Hadoop és Spark dokumentációs anyagának és kész megoldásainak mennyiségét a Google Cloud Dataflowhoz képest, a választás nyilvánvalóvá válik. Sőt, a mérnökök maguk dönthetik el, hogy milyen kódot futtatnak - Hadoop-ot vagy Spark-ot - az adott feladat, tapasztalat és szakképzettség függvényében.
Felhő vagy helyi szerver
A tendencia a uma migração generalizada para a nuvem gerou até mesmo um termo interessante, como Hadoop-as-a-service. Nesse cenário, a administração dos servidores conectados tornou-se muito importante. Infelizmente, apesar de sua popularidade, o Hadoop puro é uma ferramenta bastante complexa de configurar, pois muito precisa ser feito manualmente. Por exemplo, é necessário configurar servidores individualmente, monitorar seus indicadores e ajustar cuidadosamente diversas configurações. Enfim, é um trabalho para entusiastas, e há uma grande chance de cometer erros ou deixar algo passar.
Assim, diversas distribuições ganharam popularidade, sendo inicialmente equipadas com ferramentas convenientes para implantação e administração. Uma das distribuições mais populares que suportam o Spark e facilitam tudo é a Cloudera. Ela possui versões gratuitas e pagas, sendo que a última oferece toda a funcionalidade básica, sem restrição no número de nós.
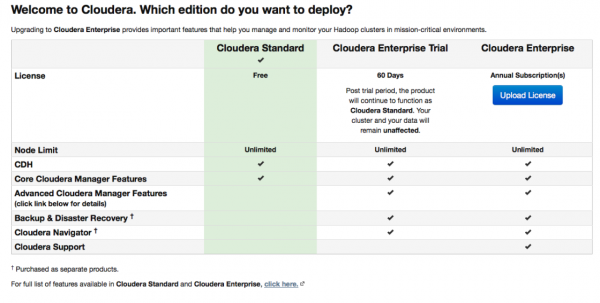
Durante a configuração, o Cloudera Manager se conectará aos seus servidores via SSH. Um ponto interessante: ao instalar, é melhor especificar que a instalação seja feita por meio de parcelas: pacotes especiais, cada um contendo todos os componentes necessários, configurados para trabalhar entre si. Por essência, é uma versão aprimorada de um gerenciador de pacotes.
Após a instalação, obtém-se um console de gerenciamento do cluster, onde é possível visualizar a telemetria dos clusters, os serviços instalados, além de poder adicionar/remover recursos e editar a configuração do cluster.
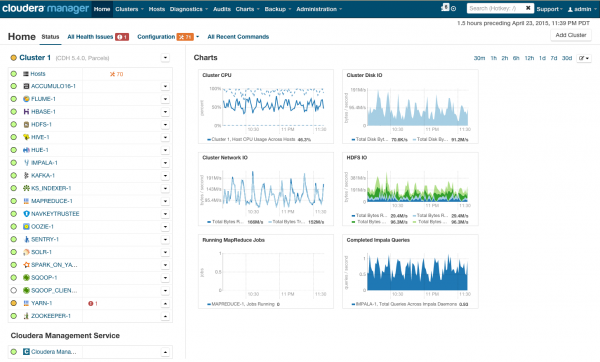
Como resultado, surge diante de você a seção daquela foguete que o levará ao brilhante futuro do Big Data. Mas antes de dizer 'vamos lá', vamos olhar sob o capô.
Requisitos de hardware
No seu site, a Cloudera menciona diferentes configurações possíveis. Os princípios gerais pelos quais elas são construídas estão ilustrados na imagem:
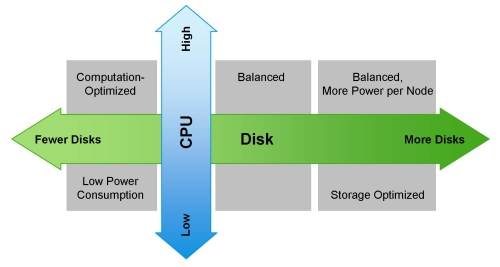
Ezt az optimista képet a MapReduce elhomályosíthatja. Ha ismét megnézzük az előző fejezetből származó diagramot, világossá válik, hogy a MapReduce feladat szinte minden esetben "készletbeli szűk keresztmetszettel" szembesülhet, amikor adatokat olvasnak le lemezről vagy hálózatról. Ezt a Cloudera blogjában is megjegyzik. Ennek eredményeként a gyors számításokhoz, beleértve a Spark használatát, amelyet gyakran valós idejű számításokhoz használnak, nagyon fontos a bemeneti/kimeneti sebesség. Ezért a Hadoop használata esetén rendkívül fontos, hogy a klaszterhez kiegyensúlyozott és gyors gépek kerüljenek, ami, enyhén szólva, nem mindig biztosított a felhőinfrastruktúrában.
A terhelések kiegyensúlyozottságát az Openstack virtualizációjának használatával érjük el a sokmagos CPU-val rendelkező szervereken. Az adatcsomópontok saját processzorfelhasználással és bizonyos lemezekkel rendelkeznek. A mi megoldásunkban Atos Codex Data Lake Engine széles körű virtualizációt valósítunk meg, aminek köszönhetően nyerünk a teljesítményben (minimalizáljuk a hálózati infrastruktúra hatását) és a TCO-ban (kizárjuk a felesleges fizikai szervereket).
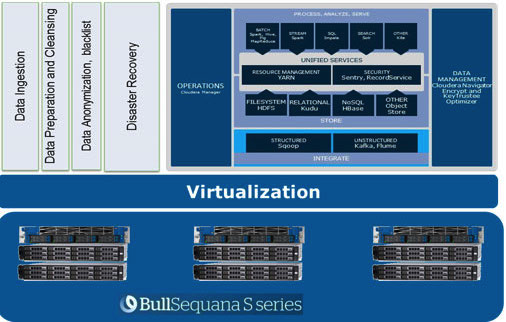
BullSequana S200 szerverek használata esetén egyenletes terhelést kapunk, amely mentes a szűk keresztmetszetek egy részétől. A minimális konfiguráció 3 BullSequana S200 szervert tartalmaz, mindegyik két JBOD-dal, plusz opcionálisan csatlakoztathatunk további S200-at, amelyek négy adatcsomópontot tárolnak. Íme egy példa a TeraGen teszt terhelésére:
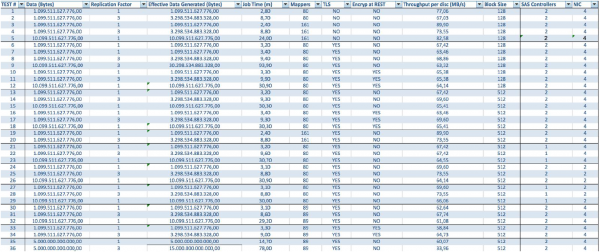
A különböző adatmennyiségekkel és replikációs értékekkel végzett tesztek ugyanolyan eredményeket mutatnak a klaszter csomópontjai közötti terhelés eloszlása szempontjából. Az alábbiakban a teljesítménytesztek során a lemezhozzáférés eloszlásának grafikonja látható.
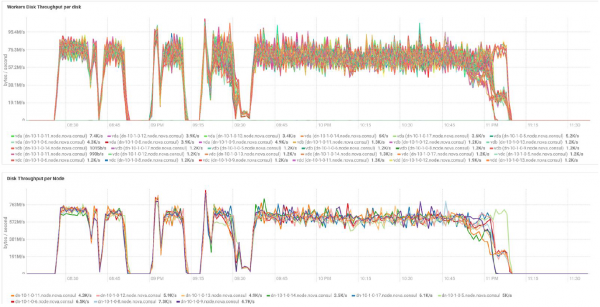
A tesztek a 3 BullSequana S200 szerverből álló minimális konfiguráción alapultak. Ez 9 adatcsomópontot és 3 fő csomópontot tartalmaz, valamint fenntartott virtuális gépeket a nyitott OpenStack Virtualization védelem telepítése esetére. A TeraSort teszt eredménye: 512 MB blokk méretű replikációs arány hárommal, titkosítással 23,1 perc.
Hogyan bővíthető a rendszer? A Data Lake Engine különböző típusú bővítéseket kínál:
- Adatátviteli csomópontok: minden 40 TB hasznos térhez
- Elemző csomópontok GPU-k telepítésének lehetőségével
- Más lehetőség a vállalkozás igényei szerint (például ha szükség van Kafka-ra és hasonlókra)
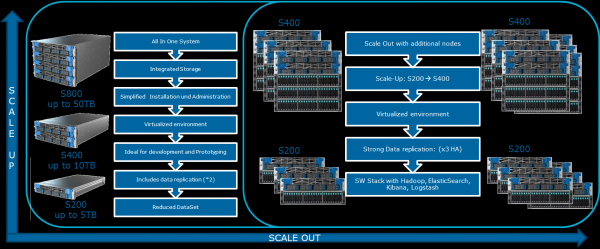
Az Atos Codex Data Lake Engine komplexuma tartalmazza a szervereket és a már előre telepített szoftvereket, beleértve a licenszelt Clouderát; magát a Hadoopot, az OpenStacket RedHat Enterprise Linux alapú virtuális gépekkel, adatreplikációs és biztonsági mentési rendszereket (beleértve a helyreállító csomópontot és a Cloudera BDR-t — Backup and Disaster Recovery). Az Atos Codex Data Lake Engine volt az első virtualizációra épülő megoldás, amelyet tanúsítottak. .
Ha többre kíváncsi, szívesen válaszolunk a kérdéseire a megjegyzésekben.
Forrás: habr.com
