

Augusztus 10-én kezdődött a Slurm-on , amelyben teljesen átbeszéljük, az alapvető absztrakcióktól a hálózati paraméterekig.
Ebben a cikkben beszélni fogunk a Docker megjelenésének történetéről és főbb absztrakcióiról: Image, Cli, Dockerfile. Az előadás kezdőknek szól, így valószínűleg nem lesz érdekes a tapasztalt felhasználók számára. Itt nem lesz vér, appendicitis és mélyreható merülés. Csak az alapok.
Mi a Docker
Nézzük meg a Docker definícióját a Wikipédiából.
A Docker egy olyan szoftver, amely automatizálja az alkalmazások telepítését és kezelését konténerizáló környezetekben.
Ebből a definícióból nem sok minden érthető. Különösen nem világos, mit jelent az, hogy „konténerizáló környezetekben”. Ahhoz, hogy megértsük, térjünk vissza a múltba. Kezdjük el a történelmet egy olyan korszakban, amelyet „Monolitikus korszaknak” nevezek.
Monolitikus korszak
A monolitikus korszak a kétezres évek eleje, amikor az összes alkalmazás monolitikus volt, rengeteg függőséggel. A fejlesztés hosszú ideig tartott. Emellett nem volt sok szerver, mindannyian ismertük őket névről és figyeltük őket. Van egy vicces összehasonlítás:
A háziállatok — ez a pet. A monolitikus korszakban a szervereinkhez úgy viszonyultunk, mint a háziállatokhoz, kényeztettük őket, a port is fújtuk róluk. A jobb erőforráskezelés érdekében virtualizációt használtunk: egy szervert több virtuális gépre osztottunk fel, ezáltal biztosítva a környezet elkülönítését.
Hypervisor alapú virtualizációs rendszerek
Mindenki hallott már a virtualizációs rendszerekről: VMware, VirtualBox, Hyper-V, Qemu KVM stb. Ezek biztosítják az alkalmazások elkülönítését és az erőforrások kezelését, de vannak hátrányaik is. A virtualizáláshoz hipervizorra van szükség. A hipervizor pedig erőforrás-többletet jelent. Ráadásul a virtuális gép általában hatalmas — nehéz kép, rajta az operációs rendszer, Nginx, Apache, esetleg MySQL. A kép nagy, a virtuális gépekkel nehéz bánni. Ennek következtében a virtualizáció gyakran lassú lehet. E problémák megoldására hozták létre a magszintű virtualizációs rendszereket.
Mag szintű virtualizációs rendszerek
A mag szintű virtualizációt az OpenVZ, Systemd-nspawn és LXC rendszerek támogatják. Az LXC (Linux Containers) egy élénk példa az ilyen típusú virtualizációra.
LXC — operációs rendszer szintű virtualizációs rendszer, amely lehetővé teszi több elszigetelt Linux operációs rendszer példány futtatását egyetlen csomóponton. Az LXC nem használ virtuális gépeket, hanem létrehoz egy virtuális környezetet saját folyamat térrel és hálózati veremmel.
Lényegében az LXC konténereket hoz létre. Mi a különbség a virtuális gépek és a konténerek között?
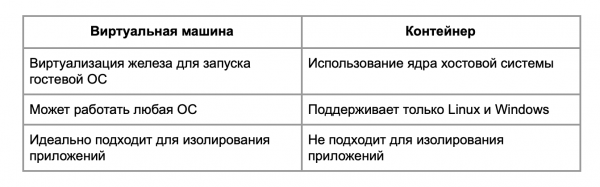
A konténer nem alkalmas a folyamatok elszigetelésére: a kernel szintű virtualizációs rendszerekben vannak olyan sebezhetőségek, amelyek lehetővé teszik, hogy a konténerből kilépjenek a gazda gépre. Tehát ha valamit elszigetelni kell, akkor jobb egy virtuális gépet használni.
A virtualizáció és a konténerizáció közötti különbségeket ábrán is meg lehet figyelni.
Léteznek hardveres hipervizorok, operációs rendszeren futó hipervizorok és konténerek.
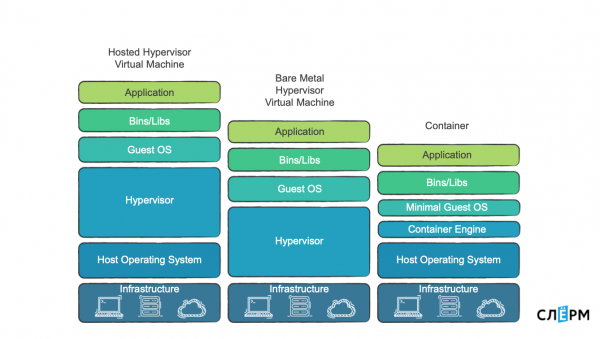
A "hardveres" hipervizorok nagyszerűek, ha valóban szeretnél valamit elszigetelni. Mert lehetőség van az elszigetelésre a memóriacélok és a processzorok szintjén.
Vannak hipervizorok program formájában, és léteznek konténerek, amelyeket a továbbiakban tárgyalunk. A konténerizáló rendszerekben nincs hipervizor, de van egy Container Engine, amely konténereket hoz létre és kezel. Ez a megoldás könnyebb, így a kernelre gyakorolt hatás kisebb, vagy szinte nincs is.
Mi használható a kernel szintű konténerizációhoz?
A legfontosabb technológiák, amelyek lehetővé teszik egy más folyamatoktól elszigetelt konténer létrehozását, a Namespaces és a Control Groups.
Namespaces: PID, Hálózat, Mount és Felhasználó. Vannak még mások is, de egyszerűség kedvéért maradjunk ennél a négynél.
A PID Namespace korlátozza a folyamatokat. Amikor például létrehozunk egy PID Namespace-t, és oda elhelyezünk egy folyamatot, akkor az PID 1-es lesz. Általában a PID 1 a systemd vagy az init rendszerekben. Tehát amikor egy folyamatot egy új namespace-be helyezünk, annak is PID 1-e lesz.
A Networking Namespace lehetővé teszi a hálózat korlátozását/elszigetelését, és már belül elhelyezhetjük a saját interfészeinket. A Mount a fájlrendszer korlátozása, a Felhasználó pedig a felhasználók korlátozása.
Control Groups: Memória, CPU, IOPS, Hálózat — összesen körülbelül 12 beállítás. Ezt Cgroups-nak (C-csoportok) is hívják.
A Control Groups kezelik a konténer erőforrásait. A Control Groups-on keresztül meg tudjuk mondani, hogy a konténer nem fogyaszthat el bizonyos mennyiségű erőforrásnál többet.
A konténerizáció teljes körű működéséhez további technológiákra van szükség: Capabilities, Copy-on-write és mások.
A Capabilities azt jelenti, hogy a folyamatnak megmondjuk, mit tehet és mit nem. Az operációs rendszer szintjén ez egyszerű bit térképek számos paraméterrel. Például a root felhasználó teljes jogkörrel rendelkezik, mindent megtehet. Az időszolgáltató módosíthatja a rendszeridőt: rendelkezik a Time Capsule jogosultságokkal, és ennyi. A jogosultságok segítségével rugalmasan beállíthatjuk a folyamatok korlátait, így védve magunkat.
A Copy-on-write rendszer lehetővé teszi számunkra, hogy a Docker képekkel hatékonyabban dolgozzunk.
Jelenleg a Docker összeférhetetlenségi problémákkal küzd a Cgroups v2-vel, ezért a cikk a Cgroups v1-re összpontosít.
De térjünk vissza a történethez.
Amikor a kernel szintű virtualizációs rendszerek megjelentek, aktívan kezdték alkalmazni őket. Az overhead a hypervisoron eltűnt, de néhány probléma megmaradt:
- nagy képek: ugyanabba az OpenVZ-be nyomják az operációs rendszert, könyvtárakat, rengeteg különböző szoftvert, és ennek következtében a kép még mindig elég nagy lesz;
- nincs normális csomagolási és szállítási szabvány, ezért fennáll a függőségek problémája. Előfordul, hogy két kódkészlet ugyanazt a könyvtárat használja, de különböző verziókkal. Közöttük konfliktus léphet fel.
Ezeknek a problémáknak a megoldására érkezett a következő korszak.
A konténerek kora
A konténerek korában megváltozott a velük való munka filozófiája:
- Egy folyamat — egy konténer.
- Minden szükséges függőséget a folyamat konténerébe szállítunk. Ez megköveteli a monolitok mikroszervizre bontását.
- Minél kisebb a kép, annál jobb — kevesebb lehetséges sebezhetőség, gyorsabb telepítés és így tovább.
- Az instanciák efemerikussá válnak.
Emlékszik, amikor a háziállatok és a jószág közötti különbségről beszéltem? Korábban az instanciák a háziállatokhoz hasonlítottak, most pedig a jószághoz — az állatokhoz. Régen egy monolit volt — egy alkalmazás. Most ez 100 mikroszolgáltatás, 100 konténer. Egyes konténereknek lehet 2-3 replikájuk. Már nem olyan fontos minden konténert ellenőrizni. Sokkal fontosabb, hogy a szolgáltatás, amit ez a konténersorozat végez, elérhető legyen. Ez megváltoztatja a megfigyelés megközelítését.
2014-2015-ben a Docker virágkora következett be — az a technológia, amiről most beszélni fogunk.
A Docker megváltoztatta a filozófiát és standardizálta az alkalmazáscsomagolást. A Docker segítségével csomagolhatjuk az alkalmazást, felküldhetjük egy tárolóba, onnan letölthetjük, és telepíthetjük.
A Docker-konténerbe mindent beleteszünk, amire szükség van, ezért megoldódik a függőségek problémája. A Docker garantálja a reprodukálhatóságot. Tudom, sokan találkoztak a reprodukálhatatlansággal: nálad minden működik, feltöltöd a termelési környezetbe, ott már nem működik. A Dockerrel ez a probléma megszűnik. Ha a Docker-konténered elindul és megcsinálja, amit kell, akkor nagy valószínűséggel el fog indulni a termelési környezetben is, és ott is ugyanazt fogja csinálni.
Kitekintés az overheadre
Az overheaddel kapcsolatban folyamatos viták folynak. Vannak, akik úgy vélik, hogy a Docker nem okoz extra terhelést, mivel a Linux kernelét és minden szükséges folyamatát használja a konténerizáláshoz. Azt mondják, hogy "ha azt mondod, hogy a Docker overhead, akkor a Linux kernel is overhead".
Másrészt, ha mélyebben megvizsgáljuk, a Dockerben valóban van néhány dolog, amit kicsit feltételesen overheadnek lehet nevezni.
Az első a PID névterület. Amikor egy folyamatot elhelyezünk egy névtérben, PID-t kap 1. Ugyanakkor ennek a folyamatnak van egy másik PID-je is, amely a gazda névtérben van, a konténeren kívül. Például, ha egy Nginxet indítunk el a konténerben, ő lesz a PID 1 (mesterfolyamat). A gazda rendszerben pedig a PID-je 12623. Nehéz megmondani, mennyi ez az overhead.
A második dolog a Cgroups. Vegyük a Cgroups-ot memória szempontjából, azaz a lehetőséget, hogy korlátozzuk a konténer memóriáját. Ha ezt aktiváljuk, aktívvá válnak a számlálók, memória elszámolás: a kernelnek meg kell értenie, mennyi oldalt osztottak ki, és mennyi szabad még a konténer számára. Ez lehet overhead, de pontos kutatások nem állnak rendelkezésre arról, hogyan befolyásolja a teljesítményt. Én sem tapasztaltam, hogy egy Dockerben futó alkalmazás váratlanul hirtelen teljesítménycsökkenést szenvedett volna el.
És még egy megjegyzés a teljesítményről. Néhány kernel paraméter átvitele történik a gazdától a konténerbe. Különösen néhány hálózati paraméter. Ezért, ha a Dockerben szeretnél valami nagy teljesítményűt indítani, például olyat, ami aktívan használja a hálózatot, akkor ezeket a paramétereket minimum módosítanod kell. Például a nf_conntrack.
A Docker koncepciójáról
A Docker több összetevőből áll:
- Docker Daemon — a Container Engine; it launches containers.
- Docker CII — a utility for managing Docker.
- Dockerfile — an instruction manual on how to build an image.
- Image — an image from which the container is rolled out.
- Container.
- Docker registry — a repository of images.
Schematic representation looks approximately like this:
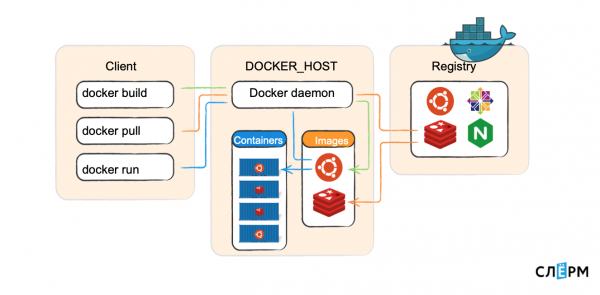
The Docker daemon runs on the Docker_host and launches containers. There is a Client that sends commands: build an image, download an image, start a container. The Docker daemon accesses the registry to execute them. The Docker client can connect both locally (to the Unix socket) and remotely via TCP.
Let's go through each component.
Docker daemon — is the server part, running on the host machine: it downloads images and starts containers from them, creates a network between containers, and collects logs. When we say "create an image", that is also handled by the daemon.
Docker CLI — is the client part of Docker, a console utility for working with the daemon. I emphasize that it can operate not only locally but also over the network.
Basic commands:
docker ps — shows the containers currently running on the Docker host.
docker images — shows the images downloaded locally.
docker search <> — searches for an image in the registry.
docker pull <> — downloads an image from the registry to the machine.
docker build <<\/path\/to\/dir>> — builds an image.
docker run <> — starts a container.
docker rm <> — removes a container.
docker logs <> — logs of the container.
docker start\/stop\/restart <> — manages the container.
If you master these commands and use them confidently, you can consider that you have mastered Docker at the user level by 70%.
Dockerfile — an instruction for creating an image. Almost every command in the instruction represents a new layer. Let's look at an example.
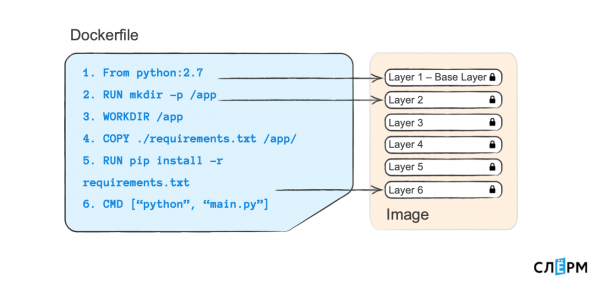
A Dockerfile looks something like this: commands on the left, arguments on the right. Each command present here (and generally written in Dockerfile) creates a new layer in the Image.
Even looking at the left side, you can roughly understand what is happening. We say: "create a folder for us" — this is one layer. "Set the folder as the working directory" — this is another layer, and so on. The layered cake simplifies life. If I create another Dockerfile and change something in the last line — say, run not "python" "main.py", but something else, or install dependencies from another file — then previous layers will be reused as cache.
Image — ez a konténer képe, amelyből konténerek indítódnak. Ha a Dockert csomagkezelőként nézzük (mintha deb vagy rpm csomagokkal dolgoznánk), akkor a kép lényegében egy rpm csomag. A yum install segítségével telepíthetjük az alkalmazást, eltávolíthatjuk, kereshetjük a tárolóban, letölthetjük. Itt nagyjából ugyanaz történik: a képből konténerek indulnak, amelyeket a Docker registry-ben tárolunk (a yum tároló analógiájára), és minden kép rendelkezik egy SHA-256 hash-sel, névvel és címkével.
A kép a Dockerfile utasításai alapján készül. Minden utasítás új réteget hoz létre. A rétegek újra felhasználhatók.
Docker registry — ez a Docker képek tárolója. Az operációs rendszerekkel analógiában a Dockernek van nyilvános standard regisztere — dockerhub. De létrehozhatunk saját tárolót, saját Docker registry-t.
Konténer — ez az, ami a képből elindul. A Dockerfile utasításai alapján összerakott képet indítjuk el. Ez a konténer izolálva van a többi konténertől, és mindennel el kell látnia az alkalmazás működéséhez szükséges dolgokkal. Ebben az esetben egy konténer — egy folyamat. Előfordulhat, hogy két folyamatot kell létrehoznunk, de ez ellentmond a Docker ideológiájának.
Az „egy konténer — egy folyamat” követelmény a PID Namespace-hez kapcsolódik. Amikor a Namespace-ben egy folyamatot PID 1-gyel indítanak, ha az hirtelen meghal, akkor az egész konténer is meghal. Ha viszont ott két folyamat fut: az egyik él, a másik pedig meghalt, akkor a konténer még mindig életben marad. De ez a legjobb gyakorlatok kérdése, azokról más anyagokban fogunk beszélni.
A kurzus részleteivel és teljes programjával kapcsolatos információk itt találhatók: «».
Szerző: Marcell Ibrajev, tanúsított Kubernetes adminisztrátor, gyakorló mérnök a Southbridge-nél, előadó és a Slyerm tanfolyamok fejlesztője.
Forrás: habr.com
