

Ebben a bejegyzésben egy érdekes megoldást szeretnénk megosztani az elosztott rendszer konfigurációjának kezelésére.
A konfiguráció közvetlenül a Scala nyelvben van megfogalmazva, típusbiztos módon. Egy példát részletesen ismertetünk. A javaslat különböző aspektusait tárgyaljuk, beleértve a hatását az általános fejlesztési folyamatra.
()
Bevezetés
Robusztus elosztott rendszerek építése megköveteli a helyes és összefüggő konfiguráció használatát minden csomóponton. Egy tipikus megoldás a szöveges telepítési leírás (terraform, ansible vagy hasonlók) használata és az automatikusan generált konfigurációs fájlok létrehozása (gyakran — mindegyik csomópontra / szerepkörre dedikált). Azt is szeretnénk, ha az azonos protokollok azonos verziói lennének minden kommunikáló csomóponton (különben inkompatibilitási problémákba ütközünk). A JVM világában ez azt jelenti, hogy legalább a üzenetküldő könyvtárnak azonos verzióban kell lennie minden kommunikáló csomóponton.
Mi a helyzet a rendszer tesztelésével? Természetesen egységtesztekkel kell rendelkeznünk minden komponenshez a rendszerintegrációs tesztek előtt. Annak érdekében, hogy a tesztelési eredmények kiterjeszthetők legyenek a futási idő alatt, biztosítani kell, hogy minden könyvtár verziója azonos maradjon mind a futási, mind a tesztelési környezetben.
Integrációs tesztek futtatásakor gyakran sokkal könnyebb azonos osztályú útvonalakat használni minden csomóponton. Egyszerűen csak gondoskodnunk kell arról, hogy telepítéskor ugyanazt a osztályú útvonalat használjuk. (Lehetséges, hogy különböző osztályú útvonalakat használjunk különböző csomópontokon, de nehezebb ezt a konfigurációt megjeleníteni és helyesen telepíteni.) Tehát a dolgok egyszerűsítése érdekében csak az azonos osztályú útvonalakat fogjuk figyelembe venni minden csomóponton.
A konfiguráció hajlamos együtt fejlődni a szoftverrel. Általában verziókat használunk a különböző szoftverfejlődési szakaszok azonosítására. Ésszerűnek tűnik, hogy a konfigurációkat verziókezelés alá vonjuk, és különböző konfigurációkat azonosító címkéket alkalmazzunk. Ha egyetlen konfiguráció van a gyártásban, használhatjuk az egyetlen verziót, mint azonosítót. Néha több gyártási környezetünk van. És minden környezethez külön konfigurációs ágra lehet szükségünk. Így a konfigurációkat ággal és verzióval címkézhetjük a különböző konfigurációk egyedi azonosításához. Minden ág címke és verzió egyetlen kombinációja a terjesztett csomópontoknak, portoknak, külső erőforrásoknak, osztályú könyvtár verzióknak felel meg minden csomóponton. Itt csak az egyes ágazatokat fogjuk figyelembe venni, és három komponensből álló tizedes verzióval (1.2.3) azonosítjuk a konfigurációkat, ugyanúgy, mint más artefaktumokat.
A modern környezetekben a konfigurációs fájlokat már nem módosítják kézzel. Általában telepítési időben generáljuk a konfigurációs fájlokat, és
soha nem érintjük meg őket
ezután. Tehát felmerülhet a kérdés, miért használunk még mindig szövegformátumot a konfigurációs fájlokhoz? Egy életképes megoldás az, hogy a konfigurációt egy fordítási egységbe helyezzük, és élvezzük a fordítási időbeli konfigurációs érvényesítést. Fordítható konfiguráció
Ebben a szakaszban egy statikus konfiguráció példáját fogjuk megvitatni. Két egyszerű szolgáltatás - egy echo szolgáltatás és az echo szolgáltatás kliensének konfigurálása és megvalósítása történik. Ezután két különböző elosztott rendszert hozunk létre mindkét szolgáltatásból. Az egyik egy egycsomópontos konfigurációra, a másik pedig két csomópontos konfigurációra vonatkozik.
Egy tipikus elosztott rendszer néhány csomópontból áll. A csomópontokat valamilyen típus szerint azonosíthatjuk:
sealed trait NodeId case object Backend extends NodeId case object Frontend extends NodeId
vagy csak
case class NodeId(hostName: String)vagy akár
object Singleton
type NodeId = Singleton.type
Ezek a csomópontok különböző szerepeket látnak el, szolgáltatásokat futtatnak, és képesek kommunikálni a többi csomóponttal TCP / HTTP kapcsolatokon keresztül.
object Singleton
type NodeId = Singleton.type
Ezek a csomópontok különböző szerepeket töltenek be, szolgáltatásokat futtatnak, és képesnek kell lenniük kommunikálni a többi csomóponttal TCP/HTTP kapcsolatokon keresztül.
A TCP kapcsolathoz legalább egy portszám szükséges. Azt is biztosítani szeretnénk, hogy az ügyfél és a szerver ugyanazt a protokollt használja. A csomópontok közötti kapcsolat modellezéséhez deklaráljuk a következő osztályt:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])where Port csak egy Int az engedélyezett tartományon belül:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined típusok
Lásd könyvtár. Röviden, lehetővé teszi, hogy fordítási időben megszorításokat adjunk más típusokhoz. Ebben az esetben Int csak 16 bites értékek megadását teszi lehetővé, amelyek képviselhetik a portszámot. Nincs követelmény arra, hogy ezt a könyvtárat használjuk a konfigurációs megközelítéshez. Csak úgy tűnik, hogy nagyon jól illeszkedik.
HTTP (REST) esetén szükség lehet a szolgáltatás útvonalára is:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantomm típus
A protokoll azonosításához a fordítás időpontjában a Scala típusargumentum deklarálásának funkcióját használjuk. Protocol amely nincs használva az osztályban. Ez egy úgynevezett fantom típus. Futásidőben ritkán szükséges a protokoll azonosító példányát tárolni, ezért nem tároljuk. A fordítás során ez a fantom típus extra típusbiztonságot nyújt. Nem adhatunk át portot helytelen protokollal.
Az egyik legszélesebb körben használt protokoll a REST API Json sorosítással:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]where RequestMessage az ügyfél által a szerverhez küldött üzenetek alapvető típusa, és ResponseMessage a szerver által küldött válaszmásolat. Természetesen létrehozhatunk más protokoll leírásokat is, amelyek a kívánt pontossággal határozzák meg a kommunikációs protokollt.
Ennek a bejegyzésnek a céljaira egy egyszerűsített változatot használunk a protokollból:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Ebben a protokollban a kérés üzenetét az url-hez fűzzük, és a válasz üzenete sima szövegként kerül visszaadásra.
A szolgáltatás konfigurációja a szolgáltatás nevével, portok gyűjteményével és néhány függőséggel leírható. Az összes elem ábrázolásának néhány lehetséges módja van Scalában (például, HList, algebraikus adattípusok). Ennek a bejegyzésnek a céljára a Cake Pattern-t használjuk, és a kombinálható darabokat (modulokat) traitként ábrázoljuk. (A Cake Pattern nem követelmény ennek a fordítható konfigurációs megközelítésnek. Csak egy lehetséges megvalósítása az ötletnek.)
A függőségek a Cake Pattern használatával ábrázolhatók más csomópontok végpontjaiként:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Az Echo szolgáltatásnak csak egy számított port szükséges. És kijelentjük, hogy ez a port támogatja az echo protokollt. Ne feledjük, hogy ezen a ponton nem kell konkrét portot megadnunk, mert a trait lehetővé teszi az absztrakt metódusok deklarálását. Ha absztrakt metódusokat használunk, a fordító egy megvalósítást fog igényelni egy konfigurációs példányban. Itt megadtuk a megvalósítást (8081) és ez lesz az alapértelmezett érték, ha kihagyjuk egy konkrét konfigurációban.
Deklarálhatunk egy függőséget az echo szolgáltatás ügyfél konfigurációjában:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
A függőség ugyanazzal a típussal rendelkezik, mint az echoService. Különösen ugyanezt a protokollt igényli. Ezért biztosak lehetünk abban, hogy ha ezeket a két függőséget összekapcsoljuk, akkor helyesen fognak működni.
Szolgáltatások megvalósítása
A szolgáltatásnak szüksége van egy funkcióra, amely elindítja és fokozatosan leállítja. (A szolgáltatás leállításának képessége kritikus a teszteléshez.) Ismét van néhány lehetőség egy ilyen funkció megadására egy adott konfigurációhoz (például használhatjuk a típosztályokat). Ebben a bejegyzésben ismét a Cake Pattern-t fogjuk használni. Egy szolgáltatást a következőképpen ábrázolhatunk cats.Resource amely már biztosítja a határolást és az erőforrások felszabadítását. Az erőforrás megszerzéséhez meg kell adnunk egy konfigurációt és némi futási kontextust. Így a szolgáltatás indító funkció a következőképpen nézhet ki:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
where
Konfiguráció— a konfiguráció típusa, amelyre a szolgáltatás indítójának szüksége vanAddressResolver— egy futási objektum, amely képes megszerezni más csomópontok valódi címét (további részletekért olvasson tovább).
a többi típust onnan kapjuk cats:
F[_]— hatás típus (a legegyszerűbb esetbenF[A]csak() => A. Ebben a bejegyzésben a következőt fogjuk használnicats.IO.)Reader[A,B]— többé-kevésbé egy szinonima egy funkcióraA => Bcats.Resource— lehetősége van megszerezni és felszabadítaniTimer— lehetővé teszi az alvást/idő mérésétContextShift— analógjaExecutionContextApplicative— a funkciók hatásainak csomagolója (majdnem monád) (végül helyettesíthetjük valami mással)
Ezzel a felülettel implementálhatunk néhány szolgáltatást. Például egy szolgáltatást, amely semmit sem csinál:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit]( ()) )
  }
(Lásd más szolgáltatás-implementációkhoz — ,
és .)
Egy csomópont egyetlen objektum, amely néhány szolgáltatást futtat (az erőforrások láncolásának indítása a Cake Pattern-en keresztül történik):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Ne feledje, hogy a csomópontban megadjuk a pontos konfigurációs típust, amelyre ennek a csomópontnak szüksége van. A fordító nem engedi meg, hogy az objektumot (Cake) elégtelen típussal építsük, mert minden szolgáltatás trait kijelent egy korlátozást a Konfiguráció típusra. Azt sem tudjuk elindítani a csomópontot, ha nem biztosítunk teljes konfigurációt.
Csomópont címzett megoldása
A kapcsolat létesítéséhez valódi gazdagépcímre van szükségünk minden csomóponthoz. Ez később lehet ismert, mint a konfiguráció többi része. Ezért szükségünk van egy módra, hogy leképezzük a csomópont azonosítóját és annak tényleges címét. Ez a leképezés egy funkció:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Van néhány lehetséges mód a funkció megvalósítására.
- Ha tudjuk a valódi címeket a telepítés előtt, a csomópont gazdagépeinek példányosítása során, akkor Scala kódot generálhatunk a valódi címekkel és a buildet a későbbiekben futtathatjuk (ami fordítási időellenőrzéseket végez, majd futtatja az integrációs tesztcsomagot). Ebben az esetben a leképző függvény statikusan ismert és egyszerűsíthető egy
Map[NodeId, NodeAddress]. - Néha csak később kapjuk meg a valódi címeket, amikor a csomópont valóban elindult, vagy nem rendelkezünk a címekkel azokhoz a csomópontokhoz, amelyek még nem indultak el. Ebben az esetben lehet egy felfedező szolgáltatás, amelyet az összes többi csomópont előtt indítanak el, és minden csomópont hirdetheti a címét abban a szolgáltatásban, és feliratkozhat a függőségekre.
- Ha módosíthatjuk
/etc/hosts, használhatunk előre definiált gazdagépneveket (mint példáulmy-project-main-nodeésecho-backend) és egyszerűen társítsuk ezt a nevet az IP-címmel a telepítés során.
Ebben a bejegyzésben nem térünk ki ezekre az esetekre részletesebben. Valójában a játékmintánkban az összes csomópontnak ugyanaz IP címe lesz — 127.0.0.1.
Ebben a bejegyzésben két elosztott rendszer elrendezést fogunk megvizsgálni:
- Egyetlen csomópontos elrendezés, ahol az összes szolgáltatás egyetlen csomóponton található.
- Két csomópontos elrendezés, ahol a szolgáltatás és az ügyfél különböző csomópontokon helyezkednek el.
A konfiguráció egy elrendezéshez a következőképpen alakul:
Egyetlen csomópont konfiguráció
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ az egyes csomópont azonosítója
  \/\/ szerver konfiguráció
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Típusbiztos szolgáltatásport-specifikáció. *\/
  override def portNumber: PortNumber = 8088

  \/\/ ügyfél konfiguráció

  \/** A szolgáltatást ugyanarról a hosztról fogjuk használni. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ életciklus-vezérlő konfiguráció
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ további 0,5 másodperc, hogy 10 kérést küldhessünk, ne 9-et.
}
Itt létrehozunk egyetlen konfigurációt, amely mind a szerver, mind az ügyfél konfigurációt kiterjeszti. Ezenkívül konfigurálunk egy életciklus-vezérlőt, amely normál esetben leállítja az ügyfelet és a szervert, miután elmúlik az élettartam intervallum.
Ugyanaz a szolgáltatás-implementációk és konfigurációk halmaza használható egy olyan rendszer elrendezés létrehozásához, amely két különálló csomópontot tartalmaz. Csak annyit kell tennünk, hogy létrehozunk a megfelelő szolgáltatásokkal:
Két csomópont konfiguráció
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! függőségi specifikáció
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ további 0,5 másodperc, hogy 10 kérést küldhessünk, ne 9-et.

    def testMessage: String = "dolly"
  }
Nézd meg, hogyan specifikáljuk a függőséget. Megemlítjük a másik csomópont által biztosított szolgáltatást a jelenlegi csomópont függőségeként. A függőség típusa ellenőrizve van, mivel fantom típust tartalmaz, amely leírja a protokollt. És a futásidő alatt a helyes csomópont azonosítót fogunk kapni. Ez a javasolt konfigurációs megközelítés egyik fontos aspektusa. Lehetővé teszi számunkra, hogy a portot csak egyszer állítsuk be, és biztosak legyünk abban, hogy a helyes portra hivatkozunk.
Két csomópont implementáció
Ehhez a konfigurációhoz pontosan ugyanazokat a szolgáltatás-implementációkat használjuk. Semmilyen változtatás nem történik. Azonban két különböző csomópont implementációt hozunk létre, amelyek különböző szolgáltatásokat tartalmaznak:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Az első csomópont implementálja a szervert, és csak a szerver oldali konfigurációra van szüksége. A második csomópont implementálja az ügyfelet, és egy másik konfigurációs részre van szüksége. Mindkét csomópontnak szüksége van egy élettartam-specifikációra. E bejegyzés céljából a szolgáltatás csomópont végtelen élettartammal rendelkezik, amelyet fel lehet függeszteni SIGTERM, míg az echo ügyfél a konfigurált véges időtartam után leáll. Nézd meg a a részletekért.
Összesített fejlesztési folyamat
Nézzük meg, hogyan változtatja meg ez a megközelítés a konfigurációval való munkát.
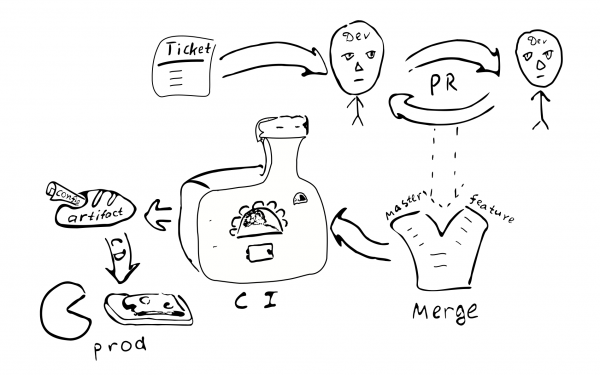
A kód konfigurációt lefordítják, és egy artefaktumot hoz létre. Ésszerűnek tűnik a konfigurációs artefaktumokat elválasztani más kódartefaktumoktól. Gyakran számos konfiguráció létezhet ugyanazon kódbázison. És természetesen több verzióval is rendelkezhetünk különböző konfigurációs ágakon. Egy konfigurációban kiválaszthatunk bizonyos könyvtárverziókat, és ezek állandóak maradnak, amikor ezt a konfigurációt telepítjük.
Egy konfigurációs változás kódváltozást eredményez. Így ugyanazt a minőségbiztosítási folyamatot kell lefednie:
Jegy -> PR -> felülvizsgálat -> egyesítés -> folyamatos integráció -> folyamatos telepítés
Az alábbi következményekkel jár a megközelítés:
- A konfiguráció összhangban van egy adott rendszer példányával. Úgy tűnik, hogy nincs mód a csomópontok közötti helytelen kapcsolatra.
- Nem könnyű a konfigurációt egyetlen csomópontban megváltoztatni. Ésszerűtlennek tűnik, hogy bejelentkezzünk és megváltoztassunk néhány szövegfájlt. Így a konfiguráció eltérése kevésbé valószínű.
- Kis konfigurációs változtatásokat nem könnyű végrehajtani.
- A legtöbb konfigurációs változtatás követni fogja ugyanazt a fejlesztési folyamatot, és át fog menni bizonyos felülvizsgálaton.
Szükségünk van külön tárolóra a gyártási konfigurációhoz? A gyártási konfiguráció érzékeny információkat tartalmazhat, amelyeket szeretnénk sok ember elől eltakarni. Így érdemes lehet egy külön tárolót fenntartani korlátozott hozzáféréssel, amely a gyártási konfigurációt tartalmazza. Feloszthatjuk a konfigurációt két részre: az egyik tartalmazza a gyártás legnyilvánosabb paramétereit, a másik pedig a konfiguráció titkos részét. Ez lehetővé teszi, hogy a legtöbb fejlesztő hozzáférhessen a többségi paraméterekhez, míg a valóban érzékeny adatokhoz való hozzáférést korlátozzuk. Ezt könnyedén elérhetjük köztes tulajdonságokkal, alapértelmezett paraméterértékekkel.
Változatok
Nézzük meg a javasolt megközelítés előnyeit és hátrányait más konfigurációs kezelési technikákhoz képest.
Elsősorban néhány alternatívát sorolunk fel a javasolt konfigurációs kezelés különböző aspektusaira:
- Szövegfájl a célgépen.
- Központosított kulcs-érték tároló (mint a
etcd/zookeeper). - Alprocesszus komponensek, amelyek újrakonfigurálhatók/újraindíthatók anélkül, hogy a folyamatot újra kellene indítani.
- Konfiguráció, amely kívül van az artefaktumon és a verziókezelésen.
A szövegfájl némi rugalmasságot biztosít a helyi javítások szempontjából. A rendszeradminisztrátor be tud jelentkezni a célcsomópontba, végrehajt egy változtatást, és egyszerűen újraindítja a szolgáltatást. Ez nem biztos, hogy ideális nagyobb rendszerek esetében. A változásról nem marad nyom, és nem ellenőrzi egy másik személy. Nehéz lehet kideríteni, hogy mi okozta a változást. Nem lett tesztelve. A disztribúciós rendszer szempontjából az adminisztrátor egyszerűen elfelejtheti frissíteni a konfigurációt a többi csomópontban.
(Egyébként, ha végül szükség lesz a szöveges konfigurációs fájlok használatára, csak egy parser + validátor hozzáadása szükséges, amely ugyanazt a Konfiguráció típust produkálja, és ez elegendő lenne a szöveges konfigurációk használatának megkezdéséhez. Ez azt is megmutatja, hogy a fordítási időben végzett konfiguráció összetettsége valamivel kisebb, mint a szöveg alapú konfigurációk összetettsége, mivel a szöveg alapú verzióban némi további kódra van szükség.)
A központosított kulcs-érték tároló jó mechanizmus az alkalmazás meta paramétereinek elosztására. Itt el kell gondolkodnunk, hogy mit tekintünk konfigurációs értékeknek és mi csak adat. Tekintettel egy funkcióra C => A => B általában ritkán változó értékeket hívunk C „konfigurációnak”, míg a gyakran változó adatokat A csak bemeneti adatnak nevezzük. A konfigurációt korábban kell biztosítani a funkciónál, mint az adatot. AEzek alapján elmondható, hogy a változások várható gyakorisága használható a konfigurációs adatok megkülönböztetésére a sima adatoktól. Az adatok általában egy forrástól (felhasználó) származnak, míg a konfiguráció egy másik forrásból (adminisztrátor) érkezik. Azokkal a paraméterekkel, amelyek a folyamat inicializálása után megváltoztathatók, a program összetettsége növekszik. Az ilyen paraméterekkel foglalkozni kell a kézbesítési mechanizmusukkal, a parszolással és az érvényesítéssel, valamint a helytelen értékek kezelésével. Ezért a program összetettségének csökkentéséhez jobban tennénk, ha minimalizálnánk a futásidőben megváltoztatható paraméterek számát (vagy akár teljesen megszüntetnénk őket).
E poszt szempontjából meg kell különböztetnünk a statikus és dinamikus paramétereket. Ha a szolgáltatás logikája ritka paraméterváltoztatást igényel futásidőben, akkor ezeket dinamikus paramétereknek hívhatjuk. Ellenkező esetben statikusak, és a felajánlott megközelítés szerint konfigurálhatók. Dinamikus újrakonfigurálás esetén más megközelítésekre lehet szükség. Például a rendszer egyes részeit újra kell indítani az új konfigurációs paraméterekkel, hasonlóan a disztribúlt rendszer különálló folyamataiba.
(Alázatos véleményem szerint érdemes elkerülni a futásidőbeli újrakonfigurálást, mivel ez növeli a rendszer összetettségét.
Talán egyszerűbb, ha egyszerűen az operációs rendszer folyamatainak újraindítási támogatására támaszkodunk. Bár ez nem mindig lehetséges.)
A statikus konfiguráció használatának egyik fontos szempontja, amely miatt egyesek a dinamikus konfigurációt fontolgatják (más okok nélkül), a szolgáltatás leállása a konfigurációfrissítés során. Valóban, ha statikus konfiguráción kell változtatnunk, újra kell indítanunk a rendszert, hogy az új értékek érvénybe lépjenek. A leállási követelmények eltérőek a különböző rendszerek esetében, így ez nem feltétlenül kritikus. Ha kritikus, akkor előre kell terveznünk a rendszer újraindítását. Például megvalósíthatjuk Ebben a forgatókönyvben, amikor újra kell indítanunk a rendszert, párhuzamosan elindítunk egy új rendszerpéldányt, majd átkapcsoljuk az ELB-t erre, miközben az öreg rendszer befejezi a meglévő kapcsolatok kiszolgálását.
Mi a helyzet a konfiguráció verziózott árucikkben vagy azon kívül való tárolásával? A konfiguráció árucikkbe való beillesztése legtöbb esetben azt jelenti, hogy ez a konfiguráció ugyanazon minőségellenőrzési folyamatot teljesítette, mint más árucikkek. Tehát biztosak lehetünk benne, hogy a konfiguráció jó minőségű és megbízható. Ezzel szemben a külön fájlban lévő konfiguráció azt jelenti, hogy nincsenek nyomok arra nézve, hogy ki és miért módosította azt a fájlt. Ez fontos? Úgy véljük, hogy a legtöbb termelési rendszernél jobb, ha stabil és magas minőségű konfigurációt használunk.
Az árucikk verziója lehetővé teszi, hogy kiderüljön, mikor készült, milyen értékeket tartalmaz, milyen funkciók vannak engedélyezve/letiltva, ki volt felelős az egyes konfigurációs módosításokért. Lehet, hogy némi erőfeszítést igényel a konfiguráció árucikkben tartása, és ez egy tervezési választás.
Előnyök & hátrányok
Itt szeretnénk kiemelni néhány előnyt és megvitatni néhány hátrányt az ajánlott megközelítés kapcsán.
Előnyök
A teljes disztribúlt rendszer kompilálható konfigurációjának jellemzői:
- A konfiguráció statikus ellenőrzése. Ez magas szintű bizalmat nyújt abban, hogy a konfiguráció helyes a megadott típuskorlátozások figyelembevételével.
- Gazdag konfigurációs nyelv. A többi konfigurációs megközelítés általában legfeljebb a változók helyettesítésére korlátozódik.
Scala használatával széles skálájú nyelvi jellemzőket alkalmazhatunk a konfiguráció javítása érdekében. Például használhatunk trait-eket alapértelmezett értékek megadására, objektumokat a különböző hatókör beállításához, hivatkozhatunkvala külső hatókörben csak egyszer definiált s változókra (DRY). Lehetőség van literális sorozatok vagy bizonyos osztályok példányainak használatára (Seq,Térkép, stb.). - DSL. A Scala megfelelő támogatást nyújt a DSL írók számára. Ezeket a funkciókat felhasználva létrehozhatunk egy konfigurációs nyelvet, amely kényelmesebb és felhasználóbarátabb, így a végső konfiguráció legalább olvasható a domain felhasználók számára.
- Integritás és összhang a csomópontok között. Az egyik előnye annak, hogy a teljes elosztott rendszer konfigurációja egy helyen áll rendelkezésre, az, hogy minden érték szigorúan egyszer van definiálva, majd újra felhasználva mindenhol, ahol szükség van rájuk. Az is típuskényszerített portnyilatkozatok biztosítják, hogy minden lehetséges helyes konfigurációban a rendszer csomópontjai ugyanazon a nyelven beszélnek. Vannak explicite függőségek a csomópontok között, ami megnehezíti a szolgáltatások figyelmen kívül hagyását.
- A változások magas minősége. Az a megközelítés, hogy a konfigurációs változásokat a normál PR folyamaton keresztül végezzük, magas minőségi standardokat állít fel a konfigurációval kapcsolatban is.
- Egyidejű konfigurációs változások. Amikor bármilyen változást végzünk a konfiguráción, az automatikus telepítés biztosítja, hogy minden csomópont frissüljön.
- Alkalmazás egyszerűsítése. Az alkalmazásnak nem kell elemeznie és érvényesítenie a konfigurációt, és foglalkoznia a helytelen konfigurációs értékekkel. Ez leegyszerűsíti az egész alkalmazást. (Néhány összetettség növekedés van a konfigurációban magában, de ez tudatos trade-off a biztonság érdekében.) Egyszerű visszatérni a hagyományos konfigurációhoz — csak hozzá kell adni a hiányzó elemeket. Könnyebb elkezdeni a lefordított konfigurációval, és elhalasztani a további elemek megvalósítását későbbi időkre.
- Verziózott konfiguráció. Azért, mert a konfigurációs változások ugyanazt a fejlesztési folyamatot követik, egy egyedi verzióval rendelkező artefaktumot kapunk. Ez lehetővé teszi a konfiguráció visszaváltását, ha szükséges. Sőt, egy évvel ezelőtt használt konfigurációt is telepíthetünk, és pontosan ugyanúgy fog működni. A stabil konfiguráció javítja az elosztott rendszer előreláthatóságát és megbízhatóságát. A konfiguráció fordítási időben fixálva van, és nem könnyen manipulálható egy termelési rendszerben.
- Modularitás. A javasolt keretrendszer moduláris, és a modulok különböző módokon kombinálhatók, hogy támogassák a különböző konfigurációkat (beállításokat/terveket). Különösen lehetséges egy kis méretű, egycsomópontos elrendezés és egy nagyméretű, többcsomópontos beállítás létrehozása. Ésszerű több termelési elrendezést alkalmazni.
Tesztelés. Tesztelési célokra valaki megvalósíthat egy hamis szolgáltatást, és típusbiztos módon használhatja függőségként. Néhány különböző tesztelési elrendezést lehet fenntartani, különböző részek hamisítványokkal történő helyettesítésével egyidejűleg. - Integrációs tesztelés. Néha elosztott rendszerekben nehéz integrációs teszteket futtatni. A teljes elosztott rendszer típusbiztos konfigurációs megközelítésének alkalmazásával minden elosztott részt egyetlen szerveren, ellenőrzött módon tudunk futtatni. Könnyű emulálni a helyzetet
- amikor az egyik szolgáltatás nem érhető el.
Hátrányok
A lefordított konfigurációs megközelítés eltér a „normális” konfigurációtól, és lehet, hogy nem felel meg minden igénynek. Íme néhány hátrány a lefordított konfigurációval kapcsolatban:
Statikus konfiguráció. Nem minden alkalmazás számára lehet megfelelő. Egyes esetekben szükség van a konfiguráció gyors javítására a termelésben, megkerülve minden biztonsági intézkedést. Ez a megközelítés nehezebbé teszi. A fordítás és újratelepítés szükséges minden konfigurációs módosítás után. Ez egyaránt jellemző és teher.
- Konfiguráció generálás. Amikor a konfigurációt valamely automatizált eszköz generálja, ez a megközelítés utólagos fordítást igényel (ami viszont hibás lehet). További erőfeszítéseket igényelhet, hogy ezt a további lépést integráljuk az építési rendszerbe.
- Eszközök. Ma rengeteg eszköz létezik, amelyek szövegalapú konfigurációkra támaszkodnak. Néhány közülük
- nem lesz alkalmazható, amikor a konfiguráció le van fordítva.
Mentális váltás szükséges. A fejlesztők és a DevOps ismerik a szöveges konfigurációs fájlokat. A konfiguráció lefordításának ötlete furcsának tűnhet számukra. - Elméletváltás szükséges. A fejlesztők és a DevOps ismerik a szöveges konfigurációs fájlokat. A konfiguráció fordításának gondolata furcsának tűnhet számukra.
- A fordítási konfiguráció bevezetése előtt egy magas színvonalú szoftverfejlesztési folyamatra van szükség.
Az implementált példa néhány korláttal rendelkezik:
- Ha extra konfigurációt adunk meg, amelyet a csomópont implementációja nem igényel, a fordító nem segít észlelni a hiányzó implementációt. Ezt a következő módon lehet kezelni:
HListvagy ADT-k (eset osztályok) használatával a csomópont konfigurációhoz a tulajdonságok és a Cake Pattern helyett. - Néhány alapvető kódot kell megadnunk a konfigurációs fájlban: (
csomag,importálás,objektumdeklárációk;
felülírja a defparaméterekhez, amelyeknek alapértelmezett értékei vannak). Ezt részben egy DSL használatával lehet kezelni. - Ebben a bejegyzésben nem tárgyaljuk a hasonló csomópontok klasztereinek dinamikus újrakonfigurálását.
Következtetés
Ebben a bejegyzésben a konfiguráció közvetlen forráskódban való reprezentálásának ötletét tárgyaltuk, típusbiztos módon. Ez a megközelítés sok alkalmazásban használható az XML és más szöveges alapú konfigurációk helyettesítésére. Annak ellenére, hogy a példa Scala nyelven lett implementálva, más fordítható nyelvekre (mint például Kotlin, C#, Swift stb.) is át lehet ültetni. Ezt a megközelítést egy új projekt során meg lehet próbálni, és ha nem illeszkedik jól, akkor vissza lehet térni a régi módszerhez.
Természetesen a fordítható konfiguráció magas színvonalú fejlesztési folyamatot igényel. Cserébe ígéri, hogy hasonlóan magas színvonalú robusztus konfigurációt biztosít.
Ez a megközelítés különféle módokon bővíthető:
- Makrók használhatók a konfiguráció érvényesítésére, és a fordítási időben hibázik, ha bármilyen üzleti logikai korlátozás nem teljesül.
- Egy DSL implementálható a konfiguráció domain-felhasználó barátságos bemutatására.
- Dinamikus erőforrás-kezelés automatikus konfigurációs módosításokkal. Például, amikor módosítjuk a klaszter csomópontok számát, azt szeretnénk, ha (1) a csomópontok kissé módosított konfigurációt kapnának; (2) a klaszter kezelője új csomópontinformációkat kapna.
Köszönöm
Szeretném megköszönni Andrey Saksonovnak, Pavel Popovnak és Anton Nehaevnek, hogy inspiráló visszajelzéseket adtak a bejegyzés tervezetéről, amely segített abban, hogy világosabbá tegyem.
Forrás: habr.com
