

Megjegyzés fordítás.: ez a tanulságos történet az Omioról — egy európai utazási aggregátorról — az alapelmélettől elvezet a Kubernetes konfigurálásának izgalmas gyakorlati részleteihez. Az ilyen esetek ismerete nemcsak a látókör bővítését segíti, hanem a nem trivális problémák megelőzését is.
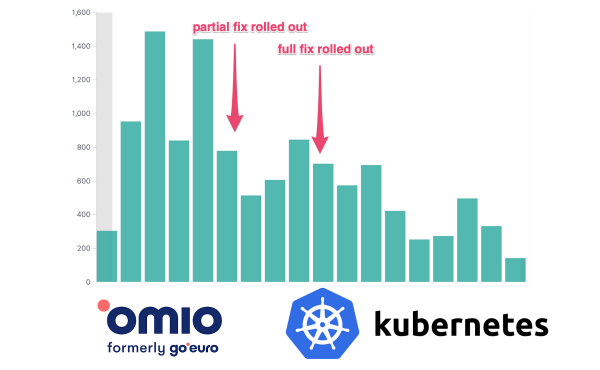
Összefutott már azzal, hogy egy alkalmazás "beragadt", és nem válaszolt a rendszerállapot-ellenőrzésekre (health check) és nem tudta megérteni ennek az okát? Az egyik lehetséges magyarázat a CPU-erőforrásokra vonatkozó kvótakorlátokkal kapcsolatos. Erről fog szólni ez a cikk.
TL;DR:
Határozottan javasoljuk a CPU-korlátok (vagy a CFS-kvóták letiltása a Kubeletben) elhagyását Kubernetes környezetben, ha a Linux kernel egy hibás CFS-kvótájú verzióját használják. A kernelben és hiba áll fenn, amely túlzott throttlinghoz és késlekedéshez vezet.
Az Omionál az egész infrastruktúra Kubernetes által van kezelve. Minden stateful- és stateless-terhelés kizárólag Kubernetesen fut (Google Kubernetes Engine-t használunk). Az utolsó hat hónapban véletlenszerű akadozásokat észleltünk. Az alkalmazások lefagynak vagy nem válaszolnak a health checkekre, elveszítik a kapcsolódást a hálózathoz stb. Az ilyen viselkedés hosszú ideig zűrzavart okozott számunkra, és végül úgy döntöttünk, hogy komolyan foglalkozunk a problémával.
A cikk összefoglalása:
- Néhány szó a konténerekről és a Kubernetesről;
- Hogyan valósulnak meg a CPU-requestok és limitációk;
- Hogyan működik a CPU-limit többmagos környezetekben;
- Hogyan lehet nyomon követni a CPU-throttlingot;
- A probléma megoldása és finomságai.
Néhány szó a konténerekről és a Kubernetesről
A Kubernetes alapvetően a modern szabvány az infrastruktúra világában. Fő feladata a konténerek orchestragálása.
Konténerek
A múltban olyan artefaktumokat kellett létrehoznunk, mint a Java JAR-ok/WAR-ok, Python Egg-ek vagy végrehajtható fájlok a szervereken való futtatáshoz. Ennek azonban voltak hátrányai: futtatási környezetet (Java/Python) kellett telepíteni, a szükséges fájlokat a megfelelő helyeken elhelyezni, a konkrét operációs rendszer verzióval való kompatibilitást biztosítani, stb. Más szóval, nagy figyelmet kellett fordítanunk a konfigurációkezelésre (ami gyakran vitákhoz vezetett a fejlesztők és a rendszergazdák között).
A konténerek mindent megváltoztattak. Most az artefaktum egy konténerképként jelenik meg. Ezt egyfajta kibővített végrehajtható fájlként lehet elképzelni, amely nemcsak a programot, hanem egy teljes futtatási környezetet (Java/Python/…) és a szükséges fájlokat/csomagokat is tartalmazza, amelyek előre telepítve és készen állnak a futtatásra. A konténereket bárhol telepíthetjük és futtathatjuk további lépések nélkül.
Ezen kívül a konténerek saját homokozó környezetben működnek. Van saját virtuális hálózati adapterük, saját fájlrendszerük korlátozott hozzáféréssel, saját folyamathierarchiájuk, CPU- és memória-korlátozásaik, stb. Mindezt a Linux kernel különleges alrendszere, a namespaces (névtér) teszi lehetővé.
Kubernetes
Ahogy korábban említettük, a Kubernetes egy konténer-orchestrátor. Úgy működik, hogy megad egy géppoolt, majd azt mondja: "Hé, Kubernetes, indíts el tíz példányt a konténeremből, 2 CPU-val és 3 GB RAM-mal mindegyiknek, és tartsd őket működő állapotban!" A Kubernetes minden további részlettel foglalkozik. Megkeresi a szabad kapacitásokat, elindítja a konténereket, és szükség esetén újraindítja őket, verzióváltáskor frissítést hajt végre stb. Lényegében a Kubernetes lehetővé teszi, hogy elvonatkoztassunk a hardveres összetevőktől, és alkalmassá teszi a különféle rendszereket alkalmazások telepítésére és működtetésére.
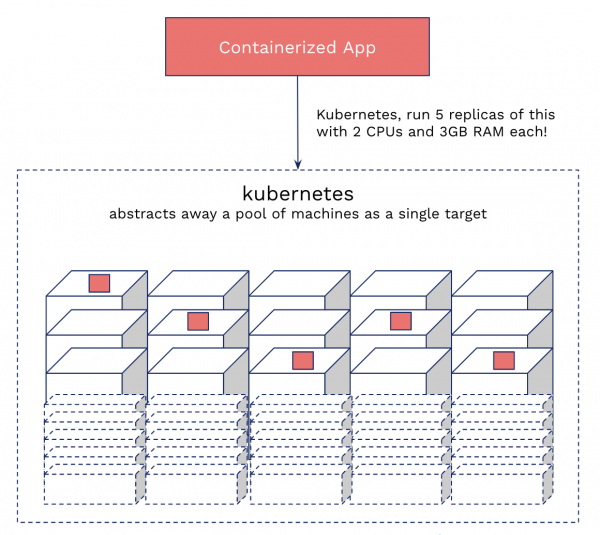
Kubernetes a laikus szemszögéből
Mik azok a request-ek és limit-ek a Kubernetesben?
Rendben, már tisztában vagyunk a konténerekkel és a Kubernetes-szel. Tudjuk azt is, hogy több konténer is lehet egy gépen.
Hasonlíthatjuk a közös bérleményhez. Van egy tágas helyiség (gépek/csomópontok), amelyet több bérlőnek (konténereknek) adunk bérbe. A Kubernetes a közvetítő szerepét tölti be. Felmerül a kérdés, hogyan tartsuk távol a bérlőket a konfliktusoktól? Mi van, ha az egyikük, mondjuk, úgy dönt, hogy a fürdőszobát fél napra elfoglalja?
Itt lépnek játékba a kérés (request) és a limit. CPU Kérés kizárólag a tervezéshez szükséges. Ez egyfajta „kívánságlista” a konténer számára, és arra használják, hogy megtalálják a legmegfelelőbb csomópontot. Ugyanakkor a CPU Limit összehasonlítható a bérleti szerződéssel — amint megtaláljuk a csomópontot a konténer számára, az nem tudja túllépni az előírt határokat. És itt merül fel a probléma…
Hogyan valósulnak meg a kérés és limit a Kubernetes-ben
A Kubernetes beépített magmechanizmust (throttling) alkalmaz a CPU limit megvalósításához. Ha az alkalmazás meghaladja a limitet, a throttling aktív lesz (azaz kevesebb CPU ciklust kap). A memória kérés és limit másképp működik, ezért könnyebben észlelhetők. Ehhez elegendő ellenőrizni a legutóbbi pod újraindításának állapotát: nem áll-e „OOMKilled” állapotban. A CPU throttling viszont nem olyan egyszerű, mivel a K8s csak a használati statisztikákat teszi elérhetővé, nem pedig a cgroups adatait.
CPU Kérés
Hogyan valósul meg a CPU kérés
Egyszerűség kedvéért nézzük meg a folyamatot egy 4 magos CPU-val rendelkező gép példáján.
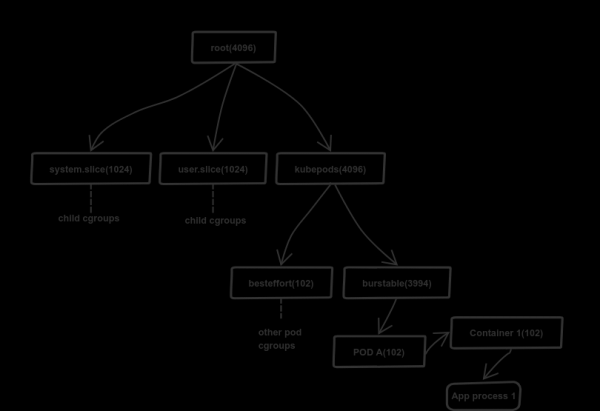
A K8s a kontrollcsoport-mechanizmust (cgroups) használja az erőforrások (memória és processzor) elosztásának kezelésére. Ehhez hierarchikus modell áll rendelkezésre: a gyermek örökli a szülőcsoport limitjeit. Az elosztási részletek a virtuális fájlrendszerben találhatók (/sys/fs/cgroup). A processzor esetében ez /sys/fs/cgroup/cpu,cpuacct/*.
A K8s a "cpu.share" fájlt használja a processzor erőforrásainak elosztására. A mi esetünkben a gyökér kontrollcsoport 4096 CPU részt kap — 100% elérhető CPU teljesítmény (1 mag = 1024; ez egy fix érték). A gyökércsoport az erőforrásokat arányosan osztja szét a gyermekek részeinek megfelelően, amelyeket , és azok, viszont szintén hasonló módon járnak el a saját gyermekeikkel, és így tovább. Egy tipikus Kubernetes csomópontban a gyökér kontrollcsoportnak három gyermeke van: system.slice , és azok, viszont szintén hasonló módon járnak el a saját gyermekeikkel, és így tovább. Egy tipikus Kubernetes csomópontban a gyökér kontrollcsoportnak három gyermeke van:user.slice kubepods, kubepods és kubepods. Az első két alsó csoport a kritikus rendszer terhelések és a felhasználói programok erőforrásainak elosztására szolgál a K8s-en kívül. A harmadik — kubepods — a Kubernetes által jön létre az erőforrások elosztására a pod-ok között.
A fenti ábrán látható, hogy az első és második alsó csoport egyenlő részesedést kapott, 1024 míg a kuberpod részére a 4096 részesedések kerültek meghatározásra. Hogyan lehetséges ez: hiszen a gyökércsoport számára összesen 4096 részesedés áll rendelkezésre, azonban az utódok részesedéseinek összege jelentősen meghaladja ezt a számot (6144)? Azért van így, mert a mennyiség logikai értelemmel bír, így a Linux ütemező (CFS) ezt az értéket használja az CPU erőforrások arányos elosztására. Ebben az esetben az első két csoport kapja az 680 valódi részesedéseket (16,6% a 4096-ból), míg a kubepod megkapja a fennmaradó 2736 részesedéseket. Leállás esetén az első két csoport nem használja a rendelt erőforrásokat.
Szerencsére az ütemező rendelkezik egy mechanizmussal, amely megakadályozza az el nem használt CPU erőforrások elvesztését. Ez az 'álló' teljesítményt egy globális poolba irányítja, ahonnan a szükséges csoportok számára további CPU teljesítmény kerül elosztásra (az átadás partiban történik, hogy elkerüljék a kerekítésből adódó veszteségeket). Ugyanazt a módszert alkalmazzák minden utódra is.
Ez a mechanizmus biztosítja a CPU teljesítmények méltányos elosztását, és figyelemmel kíséri, hogy egyetlen folyamat se 'lopjon' erőforrásokat másoktól.
CPU Limit
Bár a K8s limit- és kéréskonfigurációi hasonlónak tűnnek, a megvalósításuk gyökeresen eltér: ez a legzavaróbb és legkevésbé dokumentált rész.
A K8s alkalmazza a limitációk megvalósításához. Beállításaik a következő fájlokban érhetők el: cfs_period_us és cfs_quota_us a cgroup könyvtárban (itt található a fájl is, , és azok, viszont szintén hasonló módon járnak el a saját gyermekeikkel, és így tovább. Egy tipikus Kubernetes csomópontban a gyökér kontrollcsoportnak három gyermeke van:).
ellentétben a , és azok, viszont szintén hasonló módon járnak el a saját gyermekeikkel, és így tovább. Egy tipikus Kubernetes csomópontban a gyökér kontrollcsoportnak három gyermeke van:, a kvóta az időszakra, nem pedig a rendelkezésre álló CPU teljesítményre épül. cfs_period_us A periódus hossza (epoch) mindig 100000 µs (100 ms). A K8s-ban lehetőség van ennek az értéknek a megváltoztatására, azonban ez egyelőre csak alfa verzióban elérhető. Az ütemező az epoch-ot a felhasznált kvóták újraindítására használja. A második fájl, cfs_quota_us, az elérhető időt (kvótát) határozza meg minden epoch-ban. Ne feledje, hogy ez is mikrosekundumban van megadva. A kvóta meghaladhatja az epoch hosszát; más szavakkal élve, nagyobb lehet mint 100 ms.
Nézzük meg a két forgatókönyvet 16 magos gépeken (ez a legelterjedtebb számítógéptípus nálunk az Omio-nál):
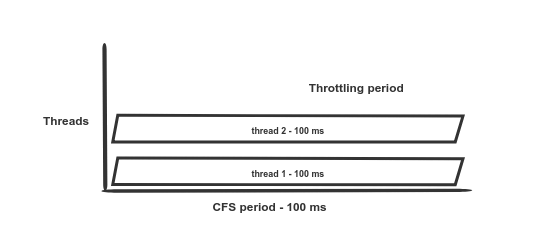
Forgatókönyv 1: 2 szál és 200 ms-os korlát. Throttling nélkül
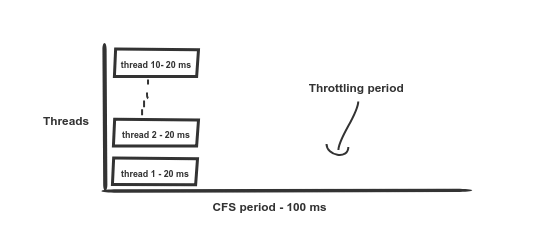
Forgatókönyv 2: 10 szál és 200 ms-os korlát. A throttling 20 ms után kezdődik, a CPU erőforrások 80 ms elteltével állnak ismét rendelkezésre.
Tegyük fel, hogy beállította a CPU korlátot erre 2 mag; a Kubernetes ezt az értéket 200 ms-ra fordítja. Ez azt jelenti, hogy a konténer maximálisan 200 ms CPU-időt használhat fel throttling nélkül.
Itt kezdődik a legérdekesebb rész. Ahogy korábban említettük, a rendelkezésre álló kvóta 200 ms. Ha párhuzamosan fut tíz szál a 12 magos gépen (lásd a 2. forgatókönyv illusztrációját), miközben a többi pod tétlenkedik, a kvóta mindössze 20 ms után kimerül (mivel 10 * 20 ms = 200 ms), és az adott pod minden szála "megtorpan" (throttle) a következő 80 ms-ra. A helyzetet súlyosbítja a már említett , amely miatt túlzott throttling lép fel és a konténer képtelen teljesíteni a rendelkezésére álló kvótát.
Hogyan értékeljük a throttlingot a podokban?
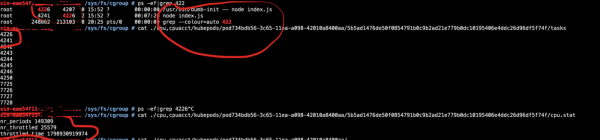
Egyszerűen lépjen be a podba és futtassa cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— a tervező periódusok összesített száma; -
nr_throttled— a throttled periódusok száma;nr_periods; -
throttled_time— a teljes throttled idő nanosekundákban.
Mi történik valójában?
Végül magas throttlingot tapasztalunk minden alkalmazásban. Néha ez másfél szoros több, mint a számított!
Ez különböző hibákhoz vezet - készenléti ellenőrzési hibákhoz (readiness), konténerek felfüggesztéséhez, hálózati kapcsolatok megszakadásához, szolgáltatás- illetve hívásokon belüli időtúllépésekhez. Végső soron ez megnövekedett késleltetést és hibák számának növekedését eredményezi.
Megoldás és következmények
Itt minden egyszerű. Lemondtunk a CPU korlátokról és az OS kernel frissítését kezdtük el a legújabb verzióra, amely megoldotta a hibát. A hibák száma (HTTP 5xx) a szolgáltatásainkban azonnal jelentősen csökkent:
HTTP 5xx hibák
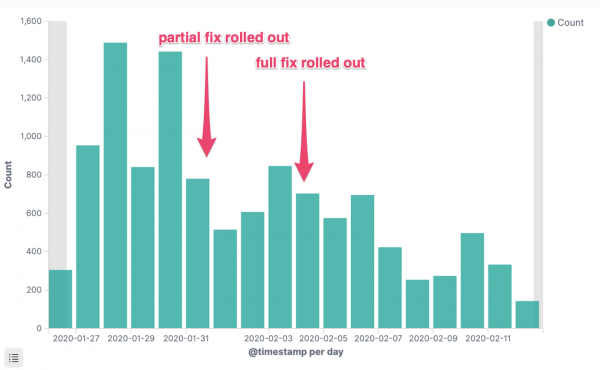
HTTP 5xx hibák egy kritikus fontosságú szolgáltatásban
p95 válaszidő
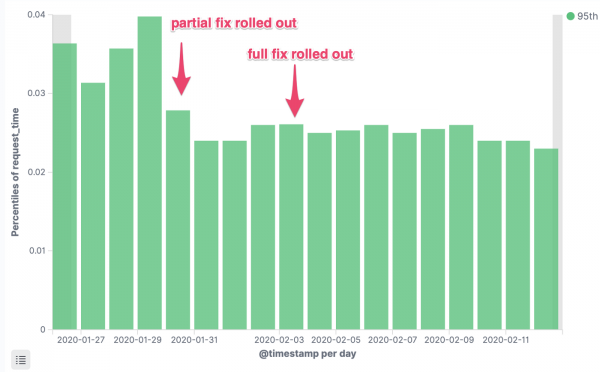
Kritikus fontosságú szolgáltatás kérésének késése, 95-ös percentilis
Üzemeltetési költségek
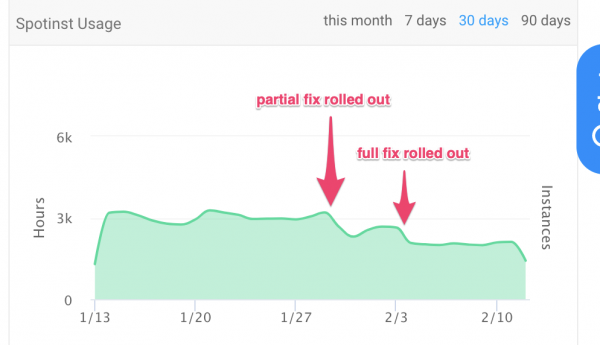
A felhasznált instance-órák száma
Mi a trükk?
Ahogy a cikk elején említettük:
Párhuzamot vonhatunk egy közös lakással… A Kubernetes társasházi ingatlanként működik. De hogyan akadályozzuk meg az alvállalkozókat, hogy konfliktusba kerüljenek egymással? Mi van, ha az egyikük, mondjuk, úgy dönt, hogy fél napra elfoglalja a fürdőszobát?
Íme a csapda. Egy hanyag konténer minden elérhető CPU erőforrást felhasználhat a gépen. Ha van egy jól megtervezett alkalmazáscsomagod (például megfelelően beállított JVM, Go, Node VM), akkor ez nem probléma: ilyen környezetekben hosszú ideig lehet működni. De ha az alkalmazások rosszul vannak optimalizálva vagy egyáltalán nem optimalizáltak (FROM java:latest), a helyzet kicsúszhat a kezünkből. Az Omio-nál automatizált alap Dockerfile-okat használunk ésszerű alapértelmezett beállításokkal a főbb nyelvek stack-jéhez, ezért ilyen probléma nem fordult elő.
Ajánljuk, hogy figyeljetek a metrikákra (használat, telítettség és hibák), API késésekre és hiba előfordulási gyakoriságra. Ügyeljetek arra, hogy az eredmények megfeleljenek az elvárásoknak.
Hivatkozások
Ez a mi történetünk. A következő anyagok nagyban segítettek megérteni, mi történik:
- ;
- ;
- ;
- ;
- — keressen „cpu throttling”-ot.
Kubernetes hibajelentések:
- ;
- ;
- .
Találkoztál hasonló problémákkal a gyakorlatodban, vagy tapasztalataid vannak a konténerizált production környezetek throttlingjával kapcsolatban? Oszd meg a történetedet a hozzászólásokban!
Fejlesztési eszközök, amelyek Kubernetesben futnak
Olvasson további információkat a blogunkban:
- «»;
- «»;
- «».
Forrás: habr.com
