

Pontosan ilyen panaszokat hallottam a fejlesztőinktől. A legérdekesebb, hogy ez igaznak bizonyult, ami egy hosszadalmas nyomozás kezdetét jelentette. A VMware-en futó SQL szervereinkről lesz szó.
Valójában könnyű elérni, hogy a production server reménytelenül lemaradjon a laptop mögött. Futassa a következő kódot (ne a tempdb-n, és ne a Delayed Durability-val rendelkező adatbázison):
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Milyen lassú!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
A desktopomon 5 másodperc alatt fut le, a production serveren viszont 28 másodperc alatt. Mert a SQL-nek várakoznia kell a tranzakciós napló fizikális írásának befejezésére, míg mi nagyon rövid tranzakciókat végzünk. Egyszerűen fogalmazva, egy nagy erős teherautót tereltünk a városi forgalomban, és azt figyeljük, ahogy a pizzafutárok motoros robogókkal kényelmesen megelőzik — itt nem a throughput a lényeg, hanem kizárólag a késlekedés. És egyetlen hálózati tároló, akármennyi nullát is ér, nem tud gyorsabb lenni késlekedésben, mint egy helyi SSD.
(a megjegyzésekben kiderült, hogy hazudtam — mindkét helyen zavartam a delayed durability-t. Delayed durability nélkül az eredmények a következők:
Desktop — 39 másodperc, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 másodperc, 1600 tr/sec, 0.6ms
Figyelnem kellett volna, hogy túl gyors volt)
A jelen esetben azonban a Riemann-függvény triviális nulláival van dolgunk, egy triviális példával. A fejlesztők által hozott példában viszont más volt. Meggyőződtem arról, hogy igazuk van, és elkezdtem eltávolítani a példából az üzleti logikával kapcsolatos specifikációikat. Egy idő után rájöttem, hogy teljesen kidobhatom a kódjukat, és írhatom a sajátomat — ami ugyanazt a problémát demonstrálja — a production-on 3-4-szer lassabban fut le:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- ellenőrizzük a páratlan számokat a sqrt-ig
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Ha minden rendben van, a prímszám ellenőrzés 6-7-8 másodpercet fog igénybe venni. Így volt ez több esetben szerverek. De néhány esetben a folyamat 25-40 másodpercet vett igénybe. Érdekes módon nem voltak olyan szerverek, ahol a végrehajtás 14 másodpercet tartott volna — a kód vagy nagyon gyorsan futott le, vagy teljesen lassan, tehát a probléma, mondhatni, fekete-fehér volt.
Mit csináltam? Belemásztam a VMware metrikákba. Ott minden rendben volt — a források többletben voltak, Ready time = 0, minden elegendő, a teszt során mind a gyors, mind a lassú szervereken a CPU=100 volt egy vCPU-n. Pi számítási tesztet végeztem — a teszt bármelyik szerveren azonos eredményeket mutatott. Egyre inkább fekete mágiára kezdett hasonlítani.
Miután a DEV farmra kerültem, elkezdtem a szerverekkel játszani. Kiderült, hogy a vMotion a gazdagépről gazdagépre „meggyógyíthat” egy szervert, de fordítva is igaz lehet: a „gyors” szerverből „lassú” is válhat. Úgy tűnik, itt van a baj — néhány gazdagép problémás… de… nem. Egy virtuális gép például lassan működött az A gazdagépen, de gyorsan B-n. Egy másik virtuális gép viszont éppen ellenkezőleg, gyorsan működött A-n, és lassan B-n! A gazdagépen gyakran futottak „gyors” és „lassú” gépek is!
Ettől a pillanattól kezdve a levegőben egyértelműen kén szaga terjengett. Hiszen a probléma nem lehetett kizárólag a virtuális gép hibája (például Windows frissítések) — hiszen vMotion alatt „gyors” géppé vált. De a probléma nem lehetett a gazdagépé sem — hiszen azon lehettek „gyors” és „lassú” gépek is. Ezenkívül nem volt terhelésfüggő — sikerült „lassú” gépet találnom azon a gazdagépen, ahol egyedül csak ő volt.
Kétségbeesésemben elindítottam a Process Explorert a Sysinternals-ból és megnéztem az SQL veremét. A lassú gépeken rögtön megláttam a következő sort:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… kihagyva
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Ez már valami volt. Így készült egy program:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Ez a program még drámaibb lassulást mutatott – a „gyors” gépeken 16-18 millió ciklust mutat másodpercenként, míg a lassú gépeken másfél millió, sőt 700 ezer. Ez tehát 10-20-szoros különbséget jelent (!!!). Ez már egy kis győzelem volt: legalábbis nem fenyegetett az a veszély, hogy megakadok a Microsoft és a VMware support között, hogy majd egymásra mutogatnak.
Ezután a fejlődés megállt – szabadság, fontos ügyek, vírus hisztéria és hirtelen megnövekedett terhelés. Gyakran említettem a varázslatos problémát a kollégáknak, de időnként úgy tűnt, hogy ők sem hisznek nekem – a VMware kód lassításáról tett állítás igazán rémisztő volt, 10-20-szoros lassulás.
Megpróbáltam magam kideríteni, mi is lassítja a dolgokat. Időnként úgy éreztem, hogy megtaláltam a megoldást – a Hot plug-ok ki- és bekapcsolása, a memória vagy a processzorok számának változtatása gyakran „gyors” géppé változtatta a virtuális gépet. De nem véglegesen. Ami viszont igaznak bizonyult – elég volt kilépni és megkopogtatni a kerekét – azaz változtatni a . Néhány kérdés teljesen elég jónak tűnik, mások pedig nem teljesítik a fent említett teszteket, különösen a "keresés egyszerűsége" ellenőrzését. virtuális gép beállításaiban.
Végül az amerikai kollégáim hirtelen megtalálták a gyökér okot.
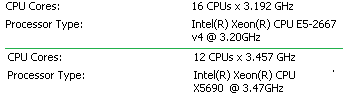
A hosztok eltértek a frekvenciájukkal!
- Általában ez nem megrázó. De: amikor a ‘helyi’ hosztból egy ‘másik’ frekvenciával rendelkező hosztra költözik, a VMware-nek ki kell javítania a GetTimePrecise eredményét.
- Általában ez nem probléma, hacsak nincs olyan alkalmazás, amely másodpercenként milliószor kéri a pontos időt, mint a SQL Server.
- De még ez sem probléma, hiszen a SQL Server ezt nem mindig teszi (lásd: Következtetés).
De vannak esetek, amikor ez a probléma súlyosan érint. És igen, amikor megkopogtattam a kerekét (változtattam valamit a VM beállításaiban), a VMware-t arra kényszerítettem, hogy ‘újraszámolja’ a konfigurációt, és a jelenlegi hoszt frekvenciája a ‘helyi’ frekvenciává vált.
Megoldás
Amikor letiltják a TSC virtualizációját, a TSC olvasása a virtuális gépből visszaadja a fizikai gép TSC értékét, és a TSC írása a virtuális gépből nem gyakorol hatást. A virtuális gép egy másik hosztra való migrálása, felfüggesztett állapotból való folytatása vagy egy pillanatkép visszaállítása hirtelen ugrást okoz a TSC-ben. Néhány vendég operációs rendszer nem tud elindulni, vagy egyéb időszinkronizációs problémák lépnek fel, amikor a TSC virtualizáció le van tiltva. A múltban ezt a funkciót néha ajánlották a TSC-t gyakran olvasó alkalmazások teljesítményének javítására., de a virtuális TSC teljesítménye jelentősen javult a jelenlegi termékekben. E funkciót is ajánlották precíz számmérésekhez, amelyek valós időre van szükség a virtuális gépben.
Röviden, hozzá kell adni egy beállítást.
monitor_control.virtual_rdtsc = FALSE
Zárás
Biztos Önben felmerült a kérdés: miért hívjuk meg annyiszor a GetTimePrecise-t SQL-ben?
Nincs SQL server forráskódomban, de a logika a következőképpen szól. Az SQL szinte egy operációs rendszer cooperatív párhuzamossággal, ahol minden szál időről időre «fel kell adnia». De hol a legjobb ezt megtenni? Ahol természetes várakozás van — zárolás vagy IO. Rendben, de mi van, ha számítási ciklusokat végzünk? Akkor a nyilvánvaló és szinte egyetlen hely — az interpreterben (ez nem teljesen interpreter), a következő utasítás végrehajtása után.
Általában az SQL szerver nem használatos tiszta számítások végzésére, és ez nem is probléma. De a különböző ideiglenes táblákkal végzett ciklusok (amelyek azonnal cache-elve vannak) a kódot nagyon gyorsan végrehajtható utasítások sorozatává alakítják.
Egyébként, ha a függvényt NATIVELY COMPILED módba csomagoljuk, akkor megállítja az időlekérést, és a sebessége tízszeresére nő. De mi van a cooperatív multitaskinggal? Nos, a natively compiled kódhoz SQL-ben ezért kellett bevezetni a PREEMPTIVE MULTITASKING-ot.
Forrás: habr.com
