

A Data Scientist és Data Engineer szakmák gyakran összekeverednek. Minden vállalatnak megvan a saját adatkezelési sajátossága, különböző elemzési céljai, és eltérő véleménye arról, hogy ki milyen részfeladatokat lát el, ezért mindegyik más követelményeket támaszt.
Nézzük meg, mi a különbség ezek között a szakemberek között, milyen üzleti feladatokat oldanak meg, milyen készségeik vannak, és mennyit keresnek. A cikk hosszúra sikerült, ezért két publikációra bontottuk.
Az első cikkben Elena Geraszimova, a "" szakfelelőse a Netology-nál elmondja, mi a különbség a Data Scientist és a Data Engineer között, és milyen eszközökkel dolgoznak.
Hogyan különböznek az alkalmazottak szerepei?
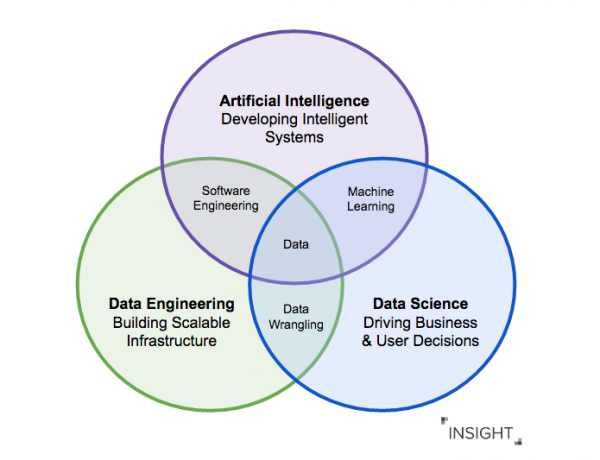
Az adatkutató mérnök olyan szakember, aki egyrészt megtervezi, teszteli és fenntartja az adatokkal kapcsolatos infrastruktúrát: adatbázisokat, adattárházakat és tömeges feldolgozási rendszereket. Másrészt ő az, aki megtisztítja és "megjavítja" az adatokat, hogy azokat az elemzők és adatkutatók használhassák, azaz adatfeldolgozási csatornákat hoz létre.
A Data Scientist prediktív (és nem csak) modelleket készít és tanít gépi tanulási algoritmusokkal és neurális hálózatokkal, segítve a vállalkozásokat rejtett összefüggések felfedezésében, események előrejelzésében és kulcsfontosságú üzleti folyamatok optimalizálásában.
A Data Scientist és Data Engineer közötti fő különbség az, hogy általában eltérő céljaik vannak. Mindketten azért dolgoznak, hogy az adatok elérhetőek és minőségiek legyenek. De a Data Scientist a saját kérdéseire keres válaszokat és teszteli a hipotéziseket az adatökoszisztémában (például Hadoop alapú), míg a Data Engineer létrehozza a gépi tanulási algoritmus támogatási folyamatát, amelyet a Data Scientist írt, a Spark klaszterén belül, ugyanabban az ökoszisztémában.
Az adatkutató mérnök értéket teremt a vállalkozás számára, csapatban dolgozva. Feladata, hogy fontos láncszem legyen a különböző résztvevők között: a fejlesztőktől a vállalati jelentésfelhasználókig, valamint növelni az elemzők hatékonyságát — a marketing és termékek, valamint a BI elemzők között.
A Data Scientist ezzel szemben aktívan részt vesz a vállalat stratégiájában, az insightok kiaknázásában, döntéshozatalban, automatizálási algoritmusok, modellezés és értékteremtés bevezetésében az adatokból.
Az adatok kezelése a GIGO (garbage in — garbage out) elvén alapul: ha az elemzők és adatszakértők felkészületlen és potenciálisan hibás adatokkal dolgoznak, akkor a legbonyolultabb elemző algoritmusok ellenére is téves eredmények születnek.
Az adatfeldolgozó mérnökök ezt a problémát úgy oldják meg, hogy adatfeldolgozási, tisztítási és transzformációs folyamatokat építenek ki, lehetővé téve az adatszakértő számára, hogy már minőségi adatokkal dolgozzon.
A piacon sok olyan eszköz található, amelyek lefedik az adatkezelési folyamat minden lépését: az adatok megjelenésétől a vezetőségi irányítópultra való kivetítésig. Fontos, hogy ezek használatáról az adatfeldolgozó mérnök döntsön — nem azért, mert ez divat, hanem mert valóban segíteni fog a folyamat többi résztvevőjének a munkájában.
Képletesen szólva: ha egy cégnek szüksége van a BI és az ETL (adatbetöltés és jelentések frissítése) összekapcsolására, akkor ez az a tipikus örökölt alap, amellyel a Data Engineer-nek dolga lesz (jó, ha csapatban van mellette egy Architekt is).
A Data Engineer feladatai
- Adatkezelési infrastruktúra tervezése, létrehozása és karbantartása.
- Hibakezelés és megbízható adatfeldolgozó folyamatok kialakítása.
- A struktúrálatlan adatok alakítása különböző dinamikus forrásokból a szakértők számára szükséges formába.
- Ajánlások megadása az adatok konzisztenciájának és minőségének javítására.
- Az adatszakértők és analitikusok által használt adatarchitektúra biztosítása és támogatása.
- Adatok feldolgozása és tárolása következetesen és hatékonyan egy elosztott klaszterben, tucatnyi vagy száz számítógépen.
- A különböző eszközök technikai kompromisszióinak értékelése az egyszerű, de megbízható architektúrák létrehozásához, amelyek képesek túlélni a leállásokat.
- Az adatfolyamok és a kapcsolódó rendszerek felügyelete és támogatása (monitoring és riasztások beállítása).
Van egy másik specializáció is a Data Engineer pályán belül — az ML engineer. Röviden, ezek a mérnökök a gépi tanulási modellek ipari bevezetésére és használatára szakosodnak. Gyakran a data scientist által szállított modell a kutatás része, és nem biztos, hogy gyártási körülmények között működik.
A Data Scientist feladatai
- Jellemzők kinyerése az adatokból a gépi tanulási algoritmusok alkalmazásához.
- Különböző gépi tanulási eszközök alkalmazása az adatok mintázatainak előrejelzésére és osztályozására.
- A gépi tanulási algoritmusok teljesítményének és pontosságának fokozása finomhangolás és optimalizálás révén.
- A cég stratégiájával összhangban 'erős' hipotézisek kialakítása, amelyeket tesztelni kell.
A Data Engineer és a Data Scientist közösen járulnak hozzá az adatkezelési kultúra fejlesztéséhez, amely lehetővé teszi a cég számára, hogy többletbevételt érjen el vagy csökkentse a költségeket.
Milyen nyelvekkel és eszközökkel dolgoznak az mérnökök és tudósok?
Ma a data science szakemberekkel szembeni elvárások megváltoztak. Korábban az mérnökök nagy SQL lekérdezéseket készítettek, manuálisan írtak MapReduce-t és olyan eszközökkel dolgoztak, mint az Informatica ETL, Pentaho ETL, Talend.
2020-ban a szakemberek számára elengedhetetlen a Python ismerete és a modern számítási eszközök (például Airflow), valamint a felhőplatformok használatának megértése (az 'hardver' költségeinek csökkentése érdekében, a biztonsági elvek betartásával).
A SAP, Oracle, MySQL, Redis a nagy cégek számára hagyományos adatmérnöki eszközök. Jók, de a licencdíjak olyan magasak, hogy csak ipari projektekben érdemes velük dolgozni. Ezzel szemben van ingyenes alternatíva, a Postgres - ingyenes és nemcsak tanulásra alkalmas.
Történelmileg gyakran találkozunk Java és Scala iránti kereslettel, bár a technológiák és megközelítések fejlődésével ezek a nyelvek háttérbe szorulnak.
Ugyanakkor a hardcore Big Data eszközök: Hadoop, Spark és a többi már nem kötelező feltétel az adatmérnökök számára, hanem olyan eszközök, amelyek bizonyos feladatok megoldására szolgálnak, amelyeket a hagyományos ETL nem tud kezelni.
Trendi az olyan szolgáltatások használata, amelyek lehetővé teszik az eszközök használatát anélkül, hogy ismerni kellene a rajtuk írt nyelvet (például Hadoop Java nélkül), valamint az előre elkészített szolgáltatások nyújtása a folyamatos adatok feldolgozásához (például hang vagy kép azonosítása videón).
Népszerűek a SAS és SPSS ipari megoldások, miközben a Tableau, Rapidminer, Stata és Julia is széles körben használtak a data science szakemberek által helyi feladatokra.
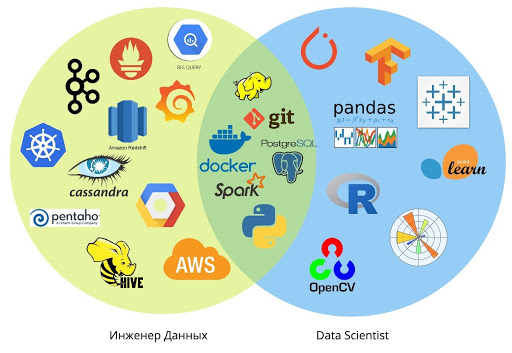
Analitikusok és adatkutatók számára mindössze néhány évvel ezelőtt vált lehetővé, hogy saját maguk építsenek adatfolyamatokat: például már viszonylag egyszerű script-ekkel lehet adatokat irányítani a PostgreSQL alapú tárolókba.
Általában az adatfolyamatok és integrált adatszerkezetek használata az adat mérnökök hatáskörébe tartozik. De ma, mint soha, erős tendencia van a T-alakú szakemberek iránt – akik széleskörű kompetenciákkal rendelkeznek a kapcsolódó területeken, hiszen az eszközök folyamatosan egyszerűsödnek.
Miért dolgoznak együtt a Data Engineer és a Data Scientist?
Az adatkutatók szoros együttműködésben dolgozva az mérnökökkel, a kutatási részre koncentrálhatnak, és elkészíthetik a működésre kész gépi tanulási algoritmusokat.
A mérnökök pedig a skálázhatóságra, az adatok újrafelhasználására összpontosíthatnak, és garantálhatják, hogy az adatbeviteli és -kimeneti folyamatok minden egyes projekt esetében megfelelnek a globális architektúrának.
Ez a feladatmegosztás biztosítja a szakemberek közötti együttműködést, akik különböző gépi tanulási projekteken dolgoznak.
Az együttműködés hatékonyan segít új termékek létrehozásában. A sebesség és a minőség az egyensúly révén érhető el, ami a mindenki számára szolgáltatás készítése (globális tároló vagy irányítópultok integrálása) és minden egyes konkrét igény vagy projekt megvalósítása (szakosodott adatfolyamat, külső források csatlakoztatása) között valósul meg.
A szoros munka az adatkutatókkal és analitikusokkal segíti a mérnököket abban, hogy fejlődjenek az analitikai és kutatási készségeikben, így minőségesebb kódot írhatnak. Javul a tudásmegosztás a tárolók és adatfolyók felhasználói között, ami rugalmasabb projekteket és fenntarthatóbb, hosszú távú eredményeket eredményez.
Azokban a vállalatokban, amelyek célul tűzik ki a data-oriented kultúra fejlesztését és üzleti folyamatok kialakítását az adatok alapjain, a Data Scientist és Data Engineer kölcsönösen kiegészítik egymást, teljes körű adat-analitikai rendszert alkotnak.
A következő anyagban arról fogunk beszámolni, hogy milyen képzésen kell részt vennie a Data Engineer és Data Scientist szakembereknek, milyen készségeket kell fejleszteniük és hogyan alakul a piac.
A Netology szerkesztőségétől
Ha érdeklődik a Data Engineer vagy Data Scientist szakma iránt, invitáljuk, hogy ismerje meg tanfolyamaink programját:
- Szakma „».
- Szakma „».
Forrás: habr.com
