

SQL, mi lehetne egyszerűbb? Mindannyian tudunk írni egy egyszerű lekérdezést – beírjuk select, felsoroljuk a szükséges oszlopokat, majd a, a táblázat nevét, egy kis feltételeket a where és ennyi – a hasznos adatok a zsebünkben vannak, ráadásul (szinte) függetlenül attól, hogy éppen melyik DBMS működik a háttérben (vagy talán ). Ennek eredményeként gyakorlatilag bármilyen adatforrással (relációs és nem relációs) a szokásos kód szempontjából foglalkozhatunk (minden következménnyel – verziókezelés, kódellenőrzés, statikus elemzés, automatikus tesztek és így tovább). Ez nemcsak az adatokra, sémákra és migrációkra vonatkozik, hanem a tároló teljes működésére is. Ebben a cikkben a különböző adatbázisokkal kapcsolatos hétköznapi feladatokról és problémákról fogunk beszélni, a "database as code" szemszögéből.
És kezdjünk az . Az "SQL vs ORM" típusú első csaták még a .
Objektum-relációs leképezés
Az ORM hívei hagyományosan értékelik a fejlesztés sebességét és egyszerűségét, a DBMS-függetlenséget és a kód tisztaságát. Számosunk számára a DB-vel való munka kódja (és sok esetben maga az adatbázis is)
általában így néz ki…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
A modell tele van okos annotációkkal, és valahol a háttérben a hősies ORM tonnányi SQL-kódot generál és futtat. Érdemes megjegyezni, hogy a fejlesztők mindent elkövetnek, hogy kilométerekkel távol tartsák magukat az adatbázistól, ami bizonyos .
A másik oldalon a tiszta "kézi" SQL hívei kiemelik, hogy az adatbázisukból minden csepp levet ki lehet préselni további rétegek és absztrakciók nélkül. Ennek eredményeként "adatközpontú" projektek születnek, ahol az adatbázissal kifejezetten képzett emberek (ők a "bázistudók", "bázisfejlesztők", "bázisépítők" stb.) foglalkoznak, míg a fejlesztőknek csak annyi a dolguk, hogy "húzzák" az elkészült nézeteket és tárolt eljárásokat, anélkül, hogy a részletekbe mélyednének.
De mi van, ha a két világ legjobbjait ötvözzük? Ahogyan azt a csodálatos eszköz teszi, amelynek életesítő nevén . Bemutatok pár sorát a koncepcióról szabad fordításomban, egyéb részleteket pedig ott találhatunk. .
A Clojure egy nagyszerű nyelv DSL-ek létrehozásához, de a SQL már önállóan is nagyszerű DSL, és nincs szükségünk egy másikra. Az S-kifejezések szépek, de itt nem adnak hozzá semmi újat. Végül csak zárójelek maradnak a zárójelekért. Nem ért egyet? Akkor várja meg azt a pillanatot, amikor az adatbázis feletti absztrakció szivárogni kezd, és elkezdi a harcot a funkcióval. (raw-sql)
És mi legyen? Hagyjuk a SQL-t sima SQL-nek — egy fájl egy lekérdezésért:
-- név: users-by-country
select *
  from users
 where country_code = :country_code
… majd olvassa el ezt a fájlt, és alakítsa át egy sima Clojure funkcióvá:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Létrejött egy `users-by-country` nevű funkció.
;;; Használjuk:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
A "SQL külön, Clojure külön" elv alapján kapja:
- Nincsenek szintaktikai meglepetések. Az adatbázisa (mint bármely más) nem felel meg 100%-ban a SQL szabványnak — de a Yesql számára ez nem lényeges. Soha nem fog időt tölteni a SQL-nek megfelelő szintaxisú funkciók keresésével. Soha nem kell visszatérnie a funkcióhoz. (raw-sql "some (‘funky’ :: SYNTAX)")).
- A legjobb szerkesztői támogatás. Az Ön szerkesztője már nagyszerű támogatást nyújt SQL-hez. Ha a SQL-t SQL-ként tartja meg, egyszerűen használhatja.
- Csapatkompatibilitás. Az Ön DBA-i tudják olvasni és írni a SQL-t, amit a Clojure projektjében használ.
- Egyszerűbb teljesítménybeállítás. Egy problémás lekérdezéshez tervet kell készíteni? Ez nem probléma, amikor a lekérdezése sima SQL.
- Lekérdezések újrahasználhatósága. Húzza át ezeket az SQL-fájlokat más projektekbe, mert ez csak a régi jó SQL — egyszerűen ossza meg őket.
Szerintem az ötlet nagyon menő és egyben nagyon egyszerű, ami miatt a projekt sok követőt szerzett. IDE & DB-manageerek
IDE és DB-kezelők
Kezdjük egy egyszerű, mindennapi feladattal. Gyakran előfordul, hogy keresnünk kell valamilyen objektumot az adatbázisban, például táblázatot keresünk egy sémában, és meg akarjuk vizsgálni annak szerkezetét (milyen oszlopok, kulcsok, indexek, megszorítások stb. találhatók benne). Bármely grafikus IDE-től vagy egy minimális DB-menedzsertől elsősorban ezt a képességet várjuk el. Az lenne a legjobb, ha gyorsan megkaphatnánk az információt, és nem kellene fél órát várnunk, míg megjelenik a szükséges információkat tartalmazó ablak (különösen, ha lassú a kapcsolat a távoli adatbázissal), ráadásul az információnak frissnek és aktuálisnak kell lennie, nem pedig egy régi, gyorsítótárazott adatnak. Minél bonyolultabb és nagyobb az adatbázis, annál nehezebb ezt megvalósítani.
De általában csak félreteszem az egeret, és egyszerűen írom a kódot. Tegyük fel, hogy meg szeretnénk tudni, mely táblázatok (és milyen jellemzőkkel) találhatók az "HR" sémában. A legtöbb DBMS esetében a kívánt eredmény eléréséhez elég egy ilyen egyszerű lekérdezés az information_schema-ból:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Adatbázisról adatbázisra a referencia táblázatok tartalma változik a különböző DBMS-ek képességei szerint. Például a MySQL esetében a referencia táblázatokból kaphatjuk meg a DBMS-specifikus szempontokat is:
select table_name
     , storage_engine -- A használt "motor" ("MyISAM", "InnoDB" stb.)
     , row_format     -- A sor formátuma ("Fixed", "Dynamic" stb.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Az Oracle nem támogatja az information_schema-t, viszont van neki , és komolyabb problémák nem merülnek fel:
select table_name
     , pct_free       -- A minimum szabad hely a blokkban (%)
     , pct_used       -- A minimum használt hely az adatblokkokon (%)
     , last_analyzed  -- Az utolsó statisztikai gyűjtés dátuma
     , ...
  from all_tables
 where owner = 'HR'
A ClickHouse sem kivétel:
select name
     , engine -- A használt "motor" ("MergeTree", "Dictionary" stb.)
     , ...
  from system.tables
 where database = 'HR'
Hasonló dolgot lehet végrehajtani a Cassandrban is (ahol columnfamilies vannak a táblázatok helyett és keyspace-ek a sémák helyett):
select columnfamily_name
     , compaction_strategy_class  -- A törlési stratégia
     , gc_grace_seconds           -- A szemetelés időtartama
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
A többi adatbázis esetében is hasonló lekérdezések állíthatók össze (még a MongoDB-ben is van , amely tartalmazza az összes gyűjtemény információját a rendszerben).
Természetesen, ezen a módon nemcsak a táblák információihoz juthatunk hozzá, hanem bármely más objektumhoz is. Időről időre jó szándékú emberek megosztanak ilyen kódokat különböző adatbázisokhoz, mint például a "PostgreSQL adatbázisok dokumentálására szolgáló függvények" című Habr cikkek sorozatában., , ). Természetesen, az összes ilyen lekérdezést a fejünkben tartani és folyamatosan megadni – ez "nem éppen ideális" öröm, ezért a kedvenc IDE/munkakörnyezetemben van egy előre megírt snippet gyűjteményem a gyakran használt lekérdezésekhez, és csak az objektumok neveit kell beírni a sablonba.
Végül is, az ilyen navigálási és objektumkeresési módszer sokkal rugalmasabb, rengeteg időt spórol, és lehetővé teszi, hogy pontosan azt az információt és olyan formában kapjuk meg, amire éppen szükség van (ahogyan azt a ).
Műveletek objektumokkal
Miután megtaláltuk és megvizsgáltuk a szükséges objektumokat, itt az ideje, hogy valami hasznosat csináljunk velük. Természetesen, anélkül, hogy a kezeinket a billentyűzetről felemelnénk.
Nem titok, hogy egy tábla egyszerű törlése szinte minden adatbázisban egyformán néz ki:
drop table hr.personsDe a tábla létrehozása már érdekesebb. Gyakorlatilag bármely RDBMS (beleértve sok NoSQL-t is) valamilyen formában támogatja a "create table"-t, és ennek a fő része alig fog eltérni (név, az oszlopok listája, adatformátumok), de a többi részlet drámai módon eltérhet, és függ a konkrét RDBMS belső működésétől és lehetőségeitől. Az én kedvenc példám – az Oracle dokumentációjában csak a "meztelen" BNF-ek a "create table" szintaxisról Más RDBMS-ek szerényebb lehetőségekkel rendelkeznek, de mindegyik sok érdekes és egyedi funkcióval bír a táblák létrehozásához (, , , ). Valószínűtlen, hogy egy grafikus "varázsló" a következő IDE-ből (különösen, ha univerzális) teljes mértékben lefedné ezeket a képességeket, és ha mégis, akkor az nem lenne a gyengébb idegzetűek számára látványos. Ugyanakkor a pontosan és időben megírt "create table" utasítás lehetővé teszi, hogy könnyedén kihasználjuk mindezeket, és biztosítsuk az adatok tárolását és hozzáférését megbízhatóan, optimálisan és maximálisan kényelmesen. create table megkönnyíti, hogy minden képességet kihasználhassunk, és biztosítsuk az adatok tárolását és elérését megbízhatóan, optimálisan és maximálisan kényelmesen.
Sok adatbázis-kezelő rendszernek vannak saját specifikus objektumtípusai, amelyek más adatbázis-kezelő rendszerekben nem találhatók meg. Ráadásul nemcsak az adatbázis objektumain hajthatunk végre műveleteket, hanem magán az adatbázis-kezelő rendszeren is, például "megölhetjük" a folyamatot, felszabadíthatunk egy memória területet, aktiválhatjuk a nyomkövetést, átkapcsolhatunk "csak olvasás" módra, és még sok mást is tehetünk.
Most pedig rajzolhatunk egy kicsit
Az egyik legelterjedtebb feladat az adatbázis objektumait ábrázoló diagramok készítése, hogy a szép képen láthatóak legyenek az objektumok és a közöttük lévő kapcsolatok. Ezt szinte bármely grafikus IDE, különböző parancssori segédprogramok, valamint szakosodott grafikai eszközök és modellezők el tudják végezni. Ezek megrajzolnak valamit "ahogy tudnak", és a folyamatra csak néhány paraméter konfigurálásával vagy a felületen található jelölőnégyzetek segítségével van lehetőségünk hatással lenni.
De ezt a problémát sokkal egyszerűbben, rugalmasabban és elegánsabban lehet megoldani, természetesen kód segítségével. Bármilyen bonyolultságú diagramokhoz azonnal rendelkezésünkre áll több speciális jelölőnyelv (DOT, GraphML stb.), és ezekhez egy rakás alkalmazás (GraphViz, PlantUML, Mermaid) tartozik, amelyek képesek olvasni az ilyen utasításokat és vizualizálni különböző formátumokban. Az objektumokról és a közöttük lévő kapcsolatokról pedig már tudjuk, hogyan szerezzük be az információt.
Mutatunk egy kis példát arról, hogy ez hogyan nézhetne ki a PlantUML használatával és (bal oldalon az SQL-lekérdezés, amely generálja a szükséges utasítást a PlantUML-hez, jobb oldalon pedig az eredmény):
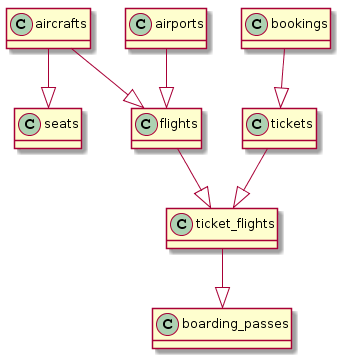
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Ha kicsit jobban megszorítjuk magunkat, akkor a valami nagyon hasonlót nyerhetünk egy igazi ER-diagramhoz:
Egy kicsit bonyolultabb SQL-lekérdezés
-- Fejléc
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Táblák
select format('Table(%s, "%s n információ %s-ról") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Kapcsolatok a táblák között
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s sok %s-el rendelkezhet"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Lábléc
select '@enduml' 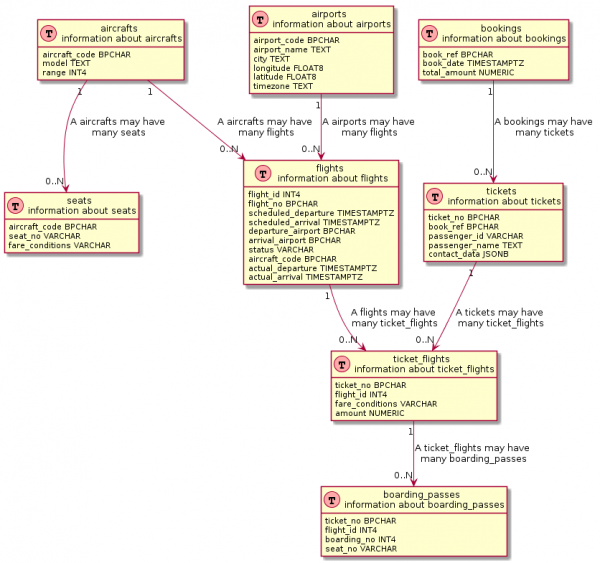
Ha alaposan megnézzük, akkor sok vizuális eszköz is hasonló lekérdezéseket használ a háttérben. Az igazság az, hogy ezek a lekérdezések általában mélyen , nem is beszélve a módosításukról.
Metrikák és monitorozás
Beszéljünk a hagyományosan nehéz témáról — az adatbázisok teljesítményének monitorozásáról. Emlékszem egy kis igaz történetre, amelyet "egy barátom" mesélt nekem. Egy projekt során élt egy hatalmas DBA, akit alig ismertek a fejlesztők, és aki valóban sosem látta senki (még a pletykák szerint is a szomszédos épületben dolgozott). A "X" órában, amikor a nagy kiskereskedő produkciós rendszere ismét "rosszul érezte magát", némán küldte el az Oracle Enterprise Managerből készült grafikonok képernyőképeit, amelyeken piros filctollal kihúzta a kritikus részeket a "érthetőség" érdekében (ez, finoman szólva, kevéssé segített). És ezen a "fotóképen" kellett orvosolni a problémákat. Ezenkívül senkinek sem volt hozzáférése az értékes (mindkét értelemben) Enterprise Managerhez, mivel a rendszer bonyolult és drága volt, mi van, ha a "fejlesztők valamit rontanak el és minden tönkremegy". Ezért a fejlesztők "empirikus" módszerekkel találják meg a lassulás okait és adnak ki javítást. Ha a DBA-tól érkező fenyegető levél nem érkezett meg újra a közeljövőben, akkor mindenki megkönnyebbülten fújta ki a levegőt, és visszatértek a jelenlegi feladataikhoz (a következő levél előtt).
De a monitorozási folyamat sokkal szórakoztatóbb és barátságosabb is lehet, és ami a legfontosabb — elérhető és átlátható mindenki számára. Legalább az alapvető részét, mint kiegészítést az alapvető monitorozó rendszerekhez (amelyek kétségtelenül hasznosak és sok esetben pótolhatatlanok). Bármelyik DBMS szabadon és teljesen ingyen hajlandó megosztani információt a jelenlegi állapotáról és teljesítményéről. Ugyanabban a "véres" Oracle DB-ben gyakorlatilag bármilyen információt a teljesítményről megszerezhetünk a rendszerszintű nézetekből, kezdve a folyamatoktól és munkamenetektől, egészen a puffer cache állapotáig (például, , "Monitorozás" rész. , különösen olyan nélkülözhetetlen szempontokra, mint , , . A MySQL számára van egy külön séma, amely erre készült . A MongoDB esetében beépített aggregálja a teljesítményadatokat a rendszerszintű gyűjteménybe .
Tehát, felvértezve magunkat valamilyen metrikagyűjtővel (Telegraf, Metricbeat, Collectd), amely képes egyedi SQL-lekérdezések végrehajtására, a metrikák tárolóval (InfluxDB, Elasticsearch, Timescaledb) és vizualizálóval (Grafana, Kibana), létrehozhatunk egy viszonylag egyszerű és rugalmas megfigyelőrendszert, amely szorosan integrálódik más általános rendszer mérőszámokkal (amelyeket például az alkalmazásszervertől, az operációs rendszertől stb. nyerünk). Ahogyan azt például a pgwatch2-ben is megvalósították, ahol az InfluxDB + Grafana párosítást és a rendszerszemélyzetekhez készült lekérdezéseket használják. .
Összesen
És ez csak egy hozzávetőleges felsorolás arról, hogy mit lehet tenni az adatbázisunkkal a hagyományos SQL-kód segítségével. Biztos vagyok benne, hogy még számos alkalmazást találhatunk, írja meg a megjegyzésekben. Arról, hogy hogyan (és ami a legfontosabb, miért) automatizáljuk ezt az egészet, és hogyan illesszük be a CI/CD folyamatunkba, legközelebb beszélünk.
Forrás: habr.com
