

Hogyan érti a backend-fejlesztő, hogy az SQL-lekérdezés jól fog működni a „prod”-on? Nagyobb vagy gyorsan növekvő cégeknél a hozzáférés a „prod”-hoz nem mindenki számára elérhető. Ráadásul, még ha van is hozzáférés, nem minden lekérdezést lehet fájdalommentesen tesztelni, és egy adatbázis másolatának elkészítése gyakran órákba telik. Ezeknek a problémáknak a megoldására létrehoztuk a mesterséges DBA-t – Joe-t. Ő már sikeresen bevezetésre került több cégnél, és segít több fejlesztőnek.
Videó:
Helló mindenkinek! A nevem Anatolij Stanisler. A cégben dolgozom . Mi azon dolgozunk, hogy felgyorsítsuk a fejlesztési folyamatot azáltal, hogy megszüntetjük a Postgres-ra vonatkozó késéseket a fejlesztők, DBA-k és QA számára.
Kiváló ügyfeleink vannak, és ma a prezentációnk egy részét azoknak az eseteknek szenteljük, amelyeket a velük végzett munka során tapasztaltunk. Elmondom, hogyan segítettünk nekik komoly problémák megoldásában.
Amikor fejlesztést folytatunk és bonyolult, nagy terhelésű migrációkat végzünk, felmerül a kérdés: „Sikerülni fog ez a migráció?”. Használunk review-t, és támaszkodunk tapasztaltabb kollégákra, DBA-szakértőkre. Ők meg tudják mondani – sikerül vagy sem.
De lehet, hogy jobb lenne, ha mi magunk tesztelhetnénk ezt teljes méretű másolatokon. Ma éppen arról fogunk beszélni, hogy milyen megközelítések léteznek jelenleg a teszteléshez, hogyan lehet a legjobban csinálni, és milyen eszközökkel. Arról is beszélünk, hogy milyen előnyök és hátrányok vannak ezekben a megközelítésekben, és mit tudunk itt javítani.
Ki készített valaha indexeket vagy végzett változtatásokat közvetlenül a prod-on? Viszonylag sokan. És kinek okozott ez adatvesztést vagy leállásokat? Akkor ismerős ez a fájdalom. Hála az égnek, van backup.
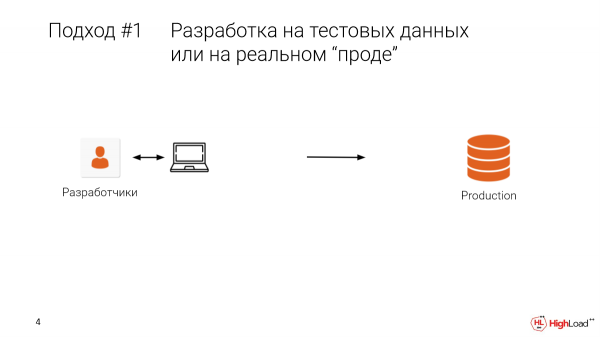
Az első megközelítés a tesztelés a prod-on. Vagyis amikor a fejlesztő a helyi gépen ül, tesztadatokkal, van egy korlátozott minta. És kiadjuk a prod-ra, és ilyen szituációt kapunk.
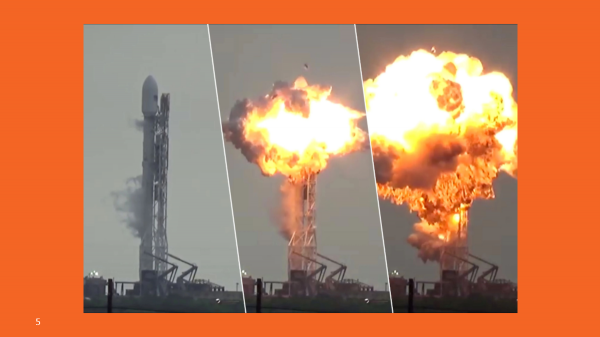
Ez fájdalmas, ez drága. Valószínűleg így nem lenne szabad csinálni.
De hogyan lenne a legjobb ezt megtenni?
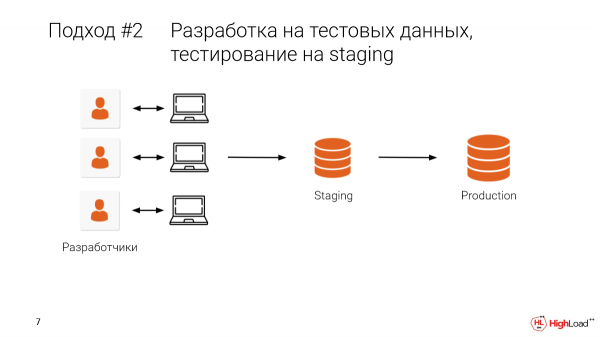
Nézzük meg a stagingot, és különítsünk el oda a prod egy részét. Vagy a legjobb esetben használjuk a valódi prod-ot, minden adatával. Miután helyben fejlesztettünk, további ellenőrzéseket végzünk a stagingon is.
Ez lehetővé teszi, hogy néhány hibát eltávolítsunk, tehát ne engedjük meg, hogy a prod-ra kerüljön.
Mik a problémák?
- A probléma az, hogy ezt a staginget megosztjuk a kollégákkal. És gyakran előfordul, hogy csinálsz egy módosítást, bum – és nincsenek adatok, a munka kárba veszett. A staging több terabyte nagyságú volt. Hosszú ideig kell várni, amíg újra elindul. Ezért úgy döntünk, hogy ezt holnap csináljuk tovább. Most minden fejlesztés megállt.
- És természetesen sok kolléga, sok csapat dolgozik ott. És ezt manuálisan kell egyeztetni. Ez pedig kényelmetlen.
Azt is érdemes megemlíteni, hogy csak egy próbálkozásunk van, egy lövés, ha adatbázisba szeretnénk bármilyen módosítást végezni, megérinteni az adatokat, megváltoztatni a struktúrát. És ha valami rosszul sikerül, ha a migráció során hiba történt, akkor már nem tudunk gyorsan visszatérni.
Ez jobb, mint a korábbi megközelítés, de még mindig nagy a valószínűsége annak, hogy valamilyen hiba kerül a productionra.
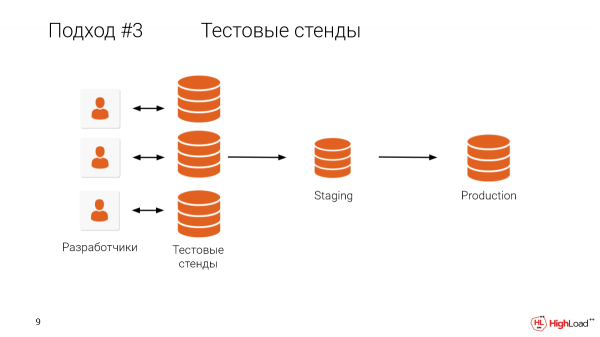
Mi akadályoz meg minket abban, hogy minden fejlesztőnek tesztkörnyezetet adjunk, egy teljes méretű másolatot? Azt hiszem, világos, hogy mi akadályozza ezt.
Kinek van az adatbázisa nagyobb, mint egy terabyte? Nagyobb, mint a terem fele.
És világos, hogy fenntartani a gépeket minden egyes fejlesztő számára, amikor ekkora production van, nagyon drága, ráadásul időigényes is.
Vannak ügyfeleink, akik megértették, hogy nagyon fontos, hogy minden változtatást teljes méretű másolatokon teszteljünk, de nekik az adatbázisuk kisebb, mint egy terabyte, és nincsenek erőforrásaik, hogy minden egyes fejlesztőnek tesztkörnyezetet tartsanak fenn. Ezért nekik le kell tölteniük a dumpokat a helyi gépre, és így kell tesztelniük. Ez rengeteg időt vesz igénybe.
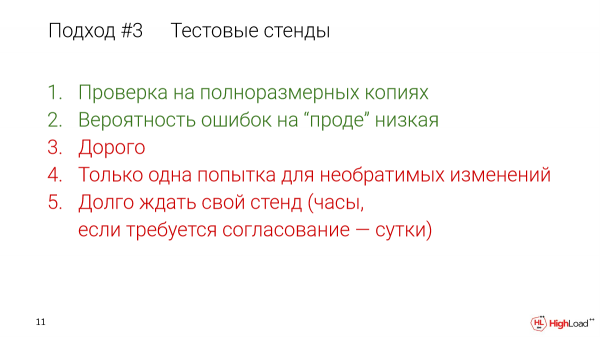
Még ha a saját infrastruktúrán belül is csinálják, egy terabyte adat letöltése egy óra alatt – ez már nagyon jónak számít. De ők logikai dumpokat használnak, lokálisan töltik le a felhőből. Számukra a sebesség körülbelül 200 gigabyte óránként. És még idő szükséges a logikai dumpból való kinyeréshez, indexek felrakásához stb.
De ők ezt a megközelítést használják, mert ez lehetővé teszi a prod megbízhatóságának megőrzését.
Mit tehetünk itt? Csináljuk úgy, hogy a tesztkörnyezetek olcsóak legyenek, és adjunk minden fejlesztőnek saját tesztkörnyezetet.
Ez lehetséges.
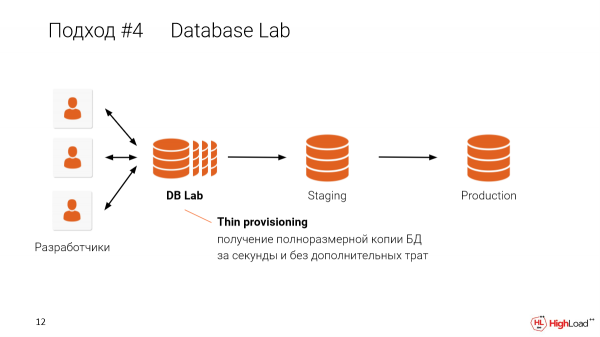
Ebben a megközelítésben, amikor vékony klónokat készítünk minden fejlesztő számára, ezeket megoszthatjuk egy gépen. Például, ha van egy négy terabyte-os adatbázisod, és ezt 10 fejlesztőnek szeretnéd átadni, nem kell 10 x négy terabyte-os adatbázis. Elég egy gép, hogy vékony, izolált másolatokat készítsünk minden fejlesztő számára, egy gép használatával. Hogyan működik, arról később mesélek.
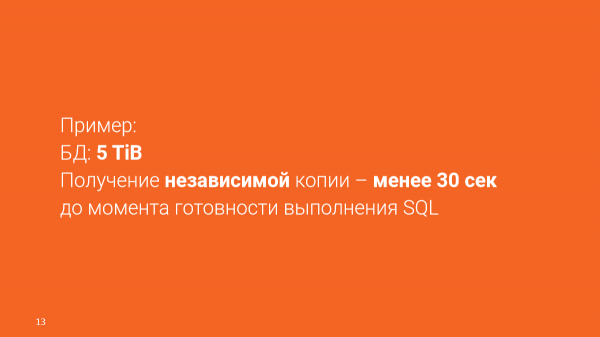
Valódi példa:
Az adatbázis – 4,5 terabyte.
Független másolatokat 30 másodperc alatt kaphatunk.
Nem kell várnod a tesztkörnyezetre, és nem kell attól függned, hogy mekkora. Másodpercek alatt megszerezheted. Ezek teljesen izolált környezetek lesznek, de amelyek megosztják az adatokat egymással.
Ez szuper. Itt a varázslatról és a párhuzamos univerzumból beszélünk.
A mi esetünkben ez az OpenZFS rendszer segítségével működik.
Az OpenZFS egy copy-on-write fájlrendszer, amely alapértelmezetten támogatja a pillanatfelvételeket és klónokat. Megbízható és skálázható. Nagyon egyszerű kezelni. Szó szerint két parancs alatt telepíthető.
Vannak más lehetőségek is:
LVM,
TÁRHELY (például Pure Storage).
A Database Lab, amiről beszélek, moduláris. Lehet megvalósítani az ilyen lehetőségek használatával. De egyelőre az OpenZFS-re összpontosítottunk, mert konkrétan az LVM-nél voltak problémák.
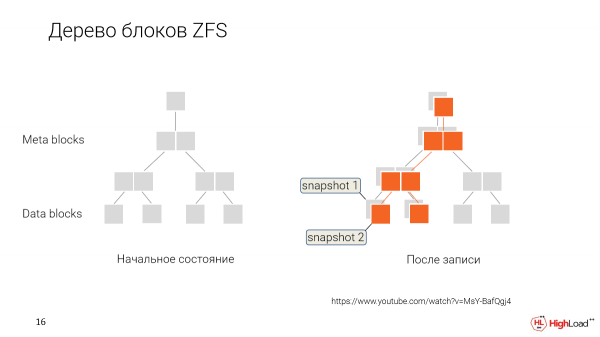
Hogyan működik? Ahelyett, hogy minden alkalommal újraírnánk az adatokat, amikor megváltoztatjuk őket, egyszerűen elmentjük őket, csak megjelölve, hogy ezek az új adatok egy új időponthoz, egy új pillanatfelvételhez tartoznak.
És később, amikor vissza akarunk lépni, vagy amikor egy új klónt akarunk készíteni valamilyen régebbi verzióból, egyszerűen csak annyit mondunk: «Oké, adjátok nekünk ezeket az adatblokkokat, amelyek így vannak megjelölve».
Ez a felhasználó így fog dolgozni ezzel az adathalmozattal. Fokozatosan változtatni fogja, készítve a saját pillanatfelvételeit.
Így elágazásra kerül sor. Minden fejlesztőnknek lehetősége lesz saját klónját beszerezni, amelyet szerkeszt, míg a közös adatok mindenki között megoszlanak.
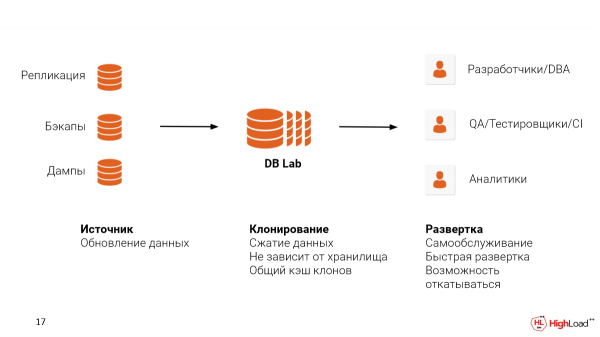
Egy ilyen rendszer telepítéséhez két problémát kell megoldani:
Az első az adatforrás, ahonnan el fogja őket venni. Beállíthatja a replikációt a production-ból. Használhatja a már létrehozott biztonsági mentéseket is, remélem, van ilyen. WAL-E, WAL-G vagy Barman. És még ha valamilyen felhőmegoldást használ is, például RDS vagy Cloud SQL, akkor logikai dumpokat is használhat. De mindenesetre azt javasoljuk, hogy használjon biztonsági mentéseket, mert ezzel a megközelítéssel a fájlok fizikai szerkezete is megmarad, ami lehetővé teszi, hogy közelebb kerüljön azokhoz a metrikákhoz, amelyeket a production-ban láthatna, hogy észlelje a létező problémákat.
A második az a hely, ahol a Database Lab-ot szeretné hosztolni. Ez lehet Felhő, lehet On-premise. Itt fontos megemlíteni, hogy a ZFS támogatja az adatok tömörítését. És ezt meglehetősen jól végzi.
Képzelje el, hogy minden egyes klónnál, attól függően, hogy milyen műveleteket végezünk az adatbázissal, egyfajta dev fog növekedni. Ehhez a dev-hez is szükség lesz helyre. De mivel egy 4,5 terabájtos adatbázist vettünk, a ZFS 3,5 terabájtra tömöríti. A beállításoktól függően ezt lehet variálni. És marad helyünk a dev számára is.
Ilyen rendszert különböző esetekhez lehet használni.
Ez fejlesztők, DBA-k számára van, hogy ellenőrizzék a lekérdezéseket, optimalizáljanak.
Használható QA-teszteléshez konkrét migrációk tesztelésére, mielőtt azt a prod-ra kiadnánk. Ezen kívül speciális környezeteket is létrehozhatunk QA számára valós adatokkal, ahol tesztelhetik az új funkcionalitást. És ez másodpercek alatt megtörténik, ahelyett, hogy órákig vagy akár napokig kellene várni, különböző esetekben, amikor vékony másolatokat nem használnak.
És van egy külön eset is. Ha a cégnél nincs beállítva analitikai rendszer, akkor kiemelhetünk egy vékony klónt a termék adatbázisból, és átadhatjuk hosszú lekérdezésekhez vagy speciális indexekhez, amelyek az analitikában használhatók.
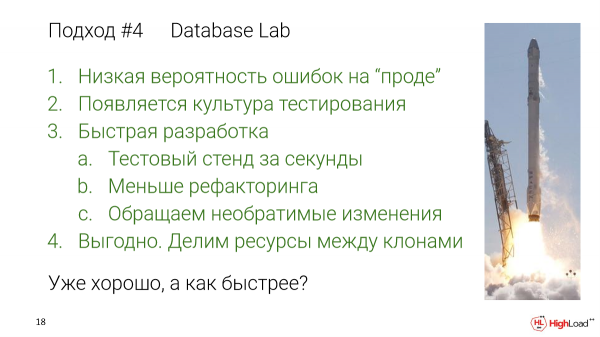
Ezzel a megközelítéssel:
Alacsony a hibák valószínűsége a 'prod'-on, mert minden változást teljes méretű adatokkal teszteltünk.
Megjelenik a tesztelési kultúra, mivel már nem kell órákig várni a saját standjára.
Nincs akadály, nincs várakozás a tesztelések között. Valóban elmehetsz és ellenőrizheted. És ez így jobb lesz, mivel felgyorsítjuk a fejlesztést.
Kevesebb refaktorálásra lesz szükség. Kevesebb hiba kerül a prod környezetbe. Kevesebb dolgot kell utólag refaktorálnunk.
Visszavonhatatlan változtatásokat is tudunk vállalni. Ez a standard megközelítésekben nincs benne.
- Ez előnyös, mert megosztjuk a tesztkörnyezetek erőforrásait.
Ez már jó, de mit lehetne még gyorsítani?
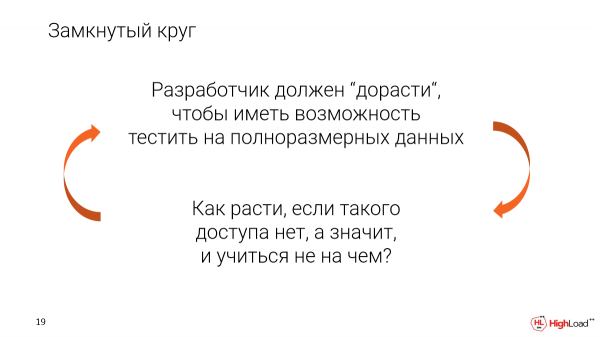
Ennek a rendszernek köszönhetően jelentősen csökkenthetjük a teszteléshez való belépési küszöböt.
Most van egy zárt kör, ahol a fejlesztőnek ahhoz, hogy hozzáférjen a valódi nagyméretű adatokhoz, szakértővé kell válnia. Meg kell bíznunk benne, hogy megkapja ezt a hozzáférést.
De hogyan lehet így fejlődni, ha ez nem áll rendelkezésre? Mi van, ha csupán egy nagyon kicsi teszteset adathalmazon tudsz dolgozni? Akkor nem tudod megkapni a valódi tapasztalatot.
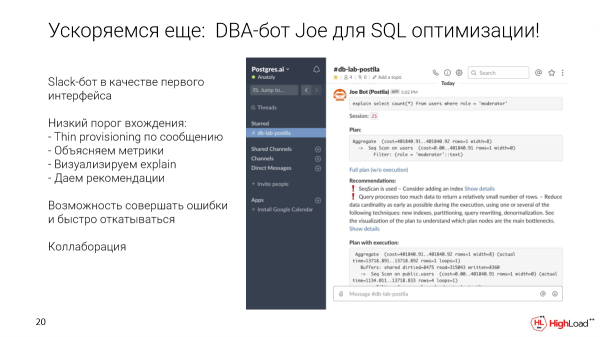
Hogyan lépjünk ki ebből a körből? Az első interface-ként, ami kényelmes a fejlesztők bármilyen szintjén, a Slack-bot-ot választottuk. De bármilyen más interface is lehet.
Mit tesz lehetővé? Lehetőség van egy adott lekérdezést elküldeni egy speciális csatornába az adatbázis számára. Automatikusan néhány másodperc alatt kifejlesztjük a vékony klónt. Futtatni fogjuk ezt a lekérdezést. Mérjük és ajánlásokat készítünk. Megmutatjuk a vizualizációt. Ezután ez a klón marad, hogy a lekérdezést optimalizálhassuk, indexeket adhassunk hozzá stb.
A Slack ezen kívül lehetőségeket ad számunkra a kollaborációra is. Mivel ez egyszerűen csak egy csatorna, közvetlenül ott egy thread-ben megkezdhetjük a lekérdezés megbeszélését, pingelhetjük kollégáinkat, DBA-kat, akik a cégen belül vannak.
De természetesen vannak problémák is. Mivel ez a valós világ, és egy olyan szervert használunk, amelyen sok klónt hosztolunk, korlátoznunk kell a memória és a processzor kapacitását, amelyeket a klónok használhatnak.
De ahhoz, hogy ezek a tesztek hihetőek legyenek, meg kell oldanunk ezt a problémát.
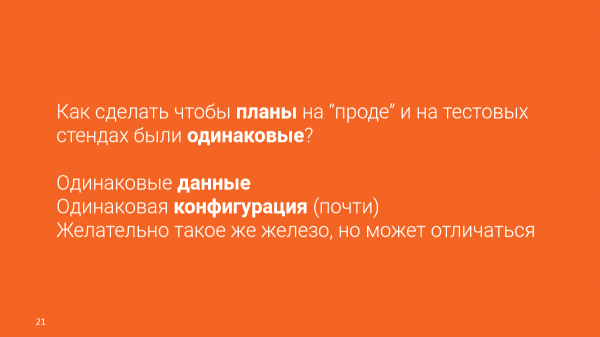
Nyilvánvaló, hogy a következetes adatok fontosak. De ezt már megvan. Arra törekszünk, hogy azonos konfigurációt érjünk el. Szinte azonos konfigurációt tudunk biztosítani.
Jól lenne ugyanazt a hardware-t használni, mint ami a termelési környezetben van, de eltérhet.
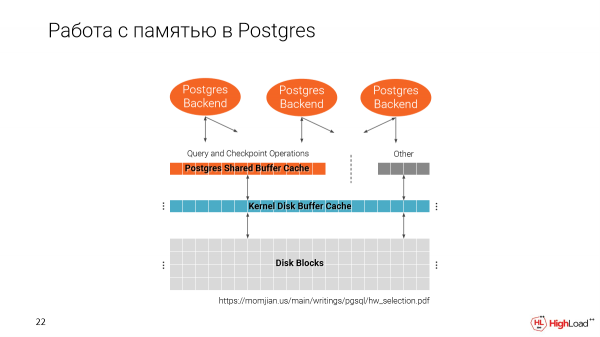
Emlékezzünk csak arra, hogyan működik a Postgres a memóriával. Két cache-ünk van. Az egyik a fájlrendszertől és a másik a saját Postgres-ünktől, azaz a Shared Buffer Cache.
Fontos megjegyezni, hogy a Shared Buffer Cache a Postgres indításakor allokálódik attól függően, hogy mekkora méretet állítunk be a konfigurációban.
A második cache pedig a rendelkezésre álló teret használja fel.
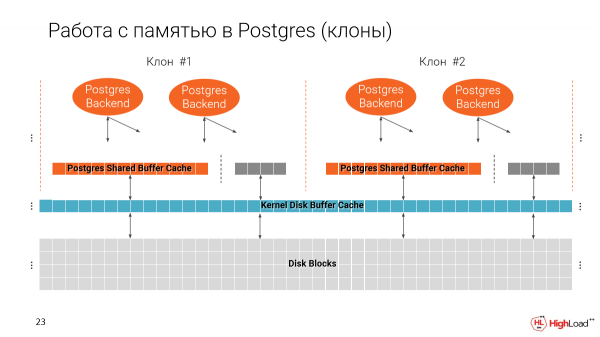
És amikor több klónt hozunk létre egy gépen, akkor fokozatosan megtöltjük a memóriát. Ideális esetben a Shared Buffer Cache a memória 25%-ának kell lennie, amely a gépen rendelkezésre áll.
Ezért, ha nem változtatunk ezen a paraméteren, akkor mindössze 4 instance-t tudunk futtatni egy gépen, tehát összesen 4 ilyen vékony klónt. Ez természetesen hátrányos, mert szeretnénk sokkal többet birtokolni.
Másrészről azonban a Buffer Cache-t a lekérdezések végrehajtásához, az indexekhez használják, tehát a terv attól függ, hogy mekkora méretűek a cache-eink. Ha egyszerűen csak csökkentjük ezt a paramétert, akkor a terveink jelentősen megváltozhatnak.
Például, ha a prod környezetünkben nagy a cache, akkor a Postgres inkább az indexet preferálja. Ha pedig nem, akkor SeqScan lesz. Mi értelme lenne, ha ezek a tervek nem egyeznének meg?
Itt arra a megállapításra jutunk, hogy a terv a Postgres-ben valójában nem függ a Shared Buffer méretétől, amit megadunk, hanem az effective_cache_size-tól függ.
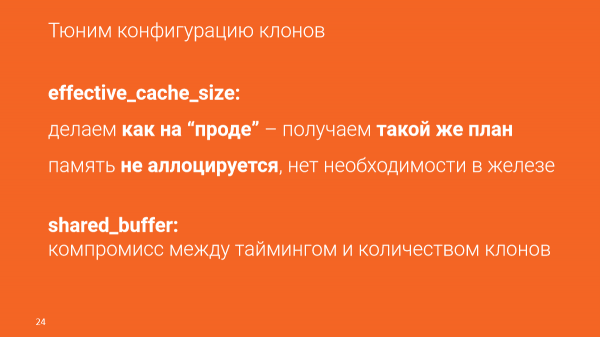
Kibővített_cache_size – ez a feltételezett cache méret, amely számunkra elérhető, tehát a Buffer Cache és a fájlrendszer cache-jének összegét jelenti. Ezt a konfiguráció határozza meg. Ez a memória nem allokálódik.
Ezzel a paraméterrel gyakorlatilag átverhetjük a Postgres-t, mondván, hogy sok adat érhető el számunkra, még akkor is, ha nincs is ilyen mennyiségű adatunk. Így a tervek teljesen egybeesnek a produkciós környezettel.
De ez befolyásolhatja az időzítést. A lekérdezéseket időzítés szerint optimalizáljuk, de fontos, hogy az időzítés számos tényezőtől függ:
Függ attól a terheléstől, amely éppen a prod környezetben van.
Függ magának a gépnek a jellemzőitől.
Ez ugyan közvetett paraméter, de valójában az adatmennyiség alapján optimalizálhatunk, amelyet ez a lekérdezés elolvas, hogy eredményt kapjunk.
Ha azt szeretnénk, hogy az időzítés közel álljon ahhoz, amit a termelési környezetben látunk, akkor a lehető legjobb hardvert kell választanunk, és lehet, hogy többre van szükség ahhoz, hogy minden klón elférjen. Ez azonban kompromisszumot jelent, azaz ugyanolyan terveket kapunk, látni fogjuk, hogy egy adott lekérdezés mennyi adatot olvas el, és levonhatjuk a következtetést – ez a lekérdezés jó (vagy migráció) vagy rossz, és további optimalizálásra van szükség.
Nézzük meg, hogyan zajlik az optimalizálás Joe esetében.
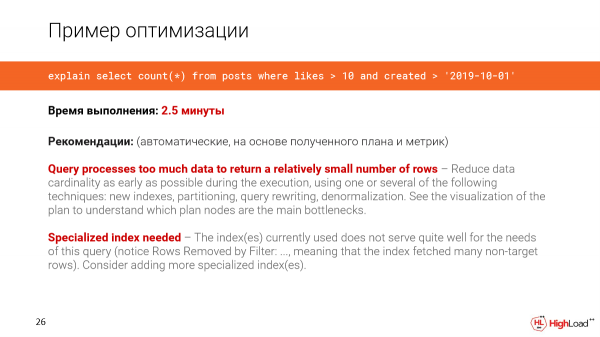
Vegyünk egy lekérdezést egy valós rendszerből. Ebben az esetben az adatbázis 1 terabyte. Azt akarjuk kiszámolni, hány friss bejegyzés van, amelyeknek több mint 10 lájkjuk volt.
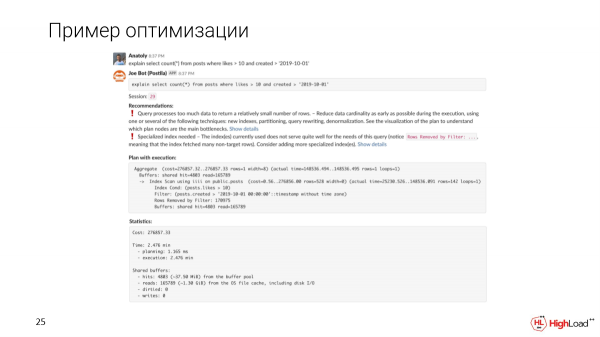
Üzenetet küldünk a csatornára, és elindul egy klón számunkra. Látni fogjuk, hogy ez a lekérdezés 2,5 perc alatt fog végrehajtódni. Ez az első, amit észre fogunk venni.
A Joe automatikus ajánlásokat fog mutatni, amelyek a terven és a metrikákon alapulnak.
Látni fogjuk, hogy a lekérdezés túl sok adatot dolgoz fel ahhoz, hogy viszonylag kevés sorhoz jusson. Szükség van egy speciális indexre, mivel észrevettük, hogy túl sok szűrt sor van a lekérdezésben.
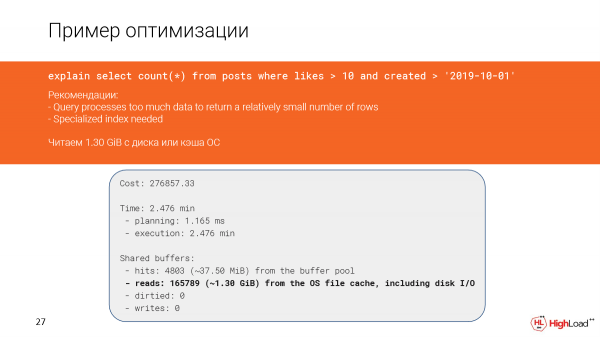
Nézzük meg közelebbről, mi történt. Valóban látjuk, hogy csaknem másfél gigabájt adatot olvastunk be a fájlcachéból vagy akár a lemezről. Ez nem jó, mivel csak 142 sort kaptunk.
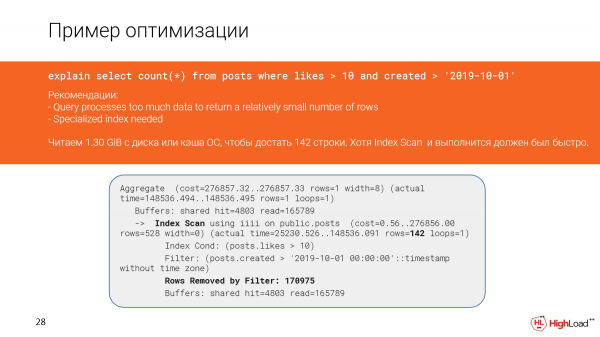
És úgy tűnik, hogy itt index scan van, és gyorsan kellene végrehajtani, de mivel túl sok sort szűrtünk le (számolnunk kellett őket), ezért a lekérdezés lassan futott le.
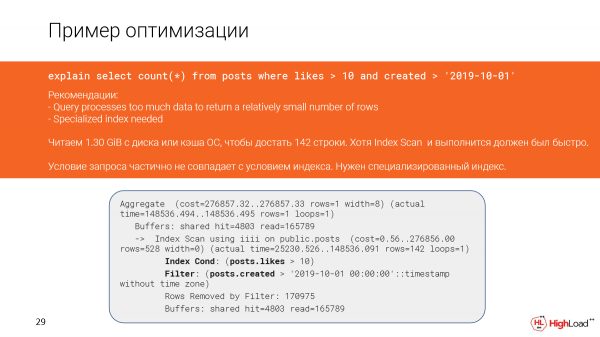
Ez a terv miatt történt, mivel részben nem egyeznek a lekérdezés és az index feltételei.
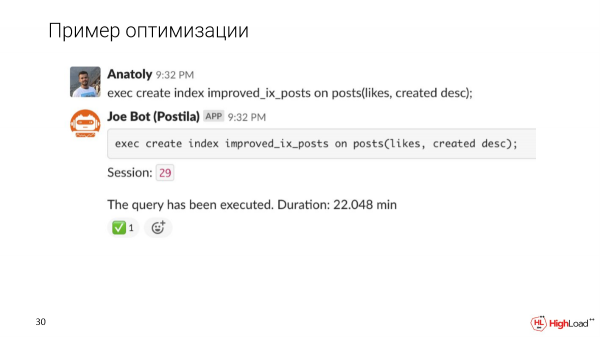
Próbáljuk meg pontosítani az indexet, és nézzük meg, hogyan változik a lekérdezés végrehajtása ezután.
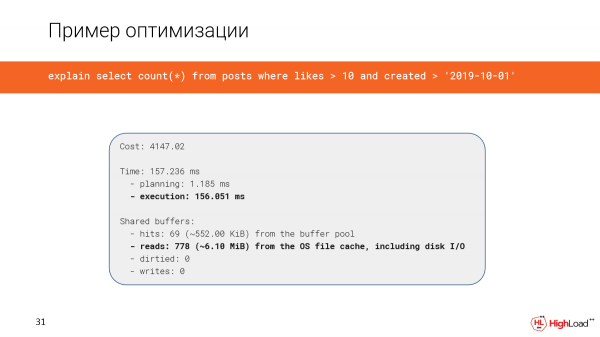
Az index létrehozása elég sok időt vett igénybe, de most ellenőrizzük a lekérdezést, és látjuk, hogy az idő 2,5 percről mindössze 156 milliszekundumra csökkent, ami elég jó. Csak 6 megabájt adatot olvasunk be.
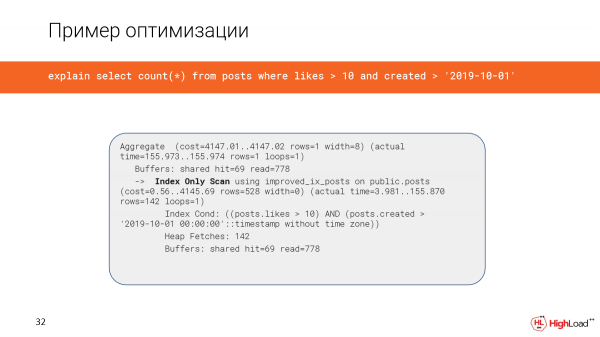
Most már index only scan-t használunk.
Egy másik fontos dolog az, hogy szeretnénk a tervet érthetőbb módon bemutatni. Mi bevezettük a vizualizációt Flame Graphs segítségével.
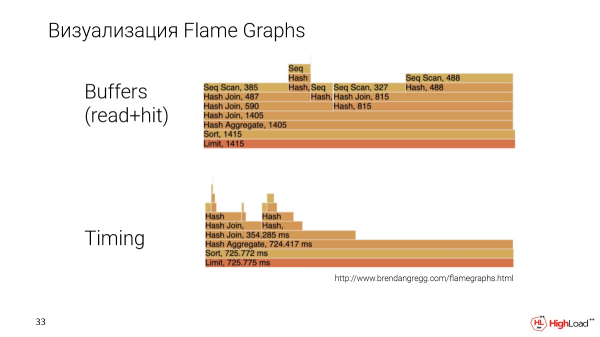
Ez egy másik lekérdezés, gazdagabb. A Flame Graphs-ot két paraméter alapján építjük fel: az adatok mennyisége, amelyet egy adott csomópont a tervben olvasott, és az időzítés, azaz a csomópont végrehajtásának ideje.
Itt pontosan összehasonlíthatjuk a csomópontokat egymással. Így világos, hogy melyik foglal el több vagy kevesebb helyet, ami általában nehéz más vizualizálási módszereknél.
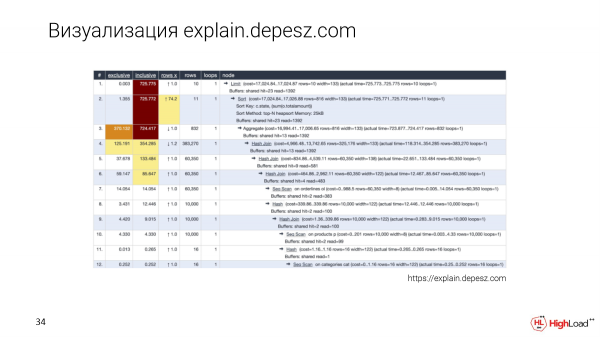
Természetesen mindenki ismeri az explain.depesz.com-ot. Ennek a vizualizációnak az egyik hasznos funkciója, hogy megőrzi a szöveges tervet és kiemel néhány fontos paramétert egy táblázatban, lehetővé téve a rendezést.
Azok a fejlesztők is, akik még nem mélyedtek el ebben a témában, használják az explain.depesz.com-ot, mivel számukra egyszerűbb megérteni, hogy mely metrikák fontosak és melyek nem.
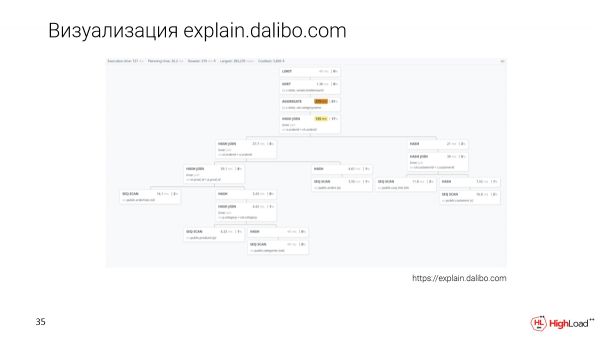
Van egy új megközelítés a vizualizációra – ez az explain.dalibo.com. Ők fa-szerű vizualizációt készítenek, de itt nagyon nehéz összehasonlítani a csomópontokat egymással. Itt jól lehet érteni a struktúrát, viszont ha nagy a lekérdezés, akkor görgetni kell ide-oda, de ez is egy lehetőség.
Együttműködés
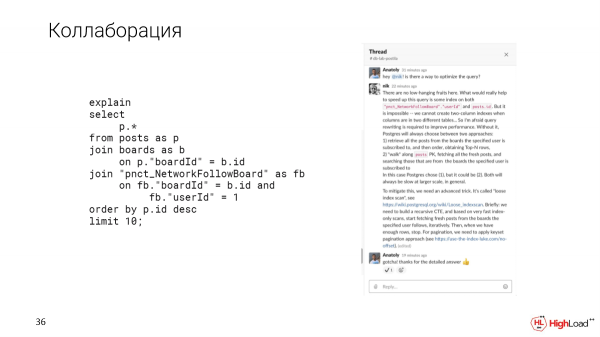
Ahogy már mondtam, a Slack lehetőséget ad az együttműködésre. Például, ha egy bonyolult lekérdezéssel találkozunk, aminek az optimalizálása nem egyértelmű, a Slack thread-ben tisztázhatjuk ezt a kérdést a kollégáinkkal.
Fontosnak tartjuk, hogy teljes méretű adatokkal teszteljünk. Ehhez létrehoztuk az Update Database Lab eszközt, amely nyílt forráskódú. A Joe botot is használhatja. Most azonnal átveheti és beépítheti a saját rendszerébe. Minden útmutató ott elérhető.
Fontos megjegyezni, hogy magában a megoldásban nincs semmi forradalmi, mert létezik a Delphix, de ez egy enterprise megoldás. Teljesen zárt, nagyon drága. Mi a Postgres-re specializálódtunk. Ezek mind nyílt forráskódú termékek. Csatlakozzon hozzánk!
Ezzel befejezem. Köszönöm!
Kérdések
Üdvözlöm! Köszönöm az előadást! Nagyon érdekes, különösen nekem, mert körülbelül hasonló feladatot megoldottam egy ideje. Ezért rengeteg kérdésem van. Remélem, legalább egy részét fel tudom tenni.
Érdekes, hogyan számítják ki a helyet ehhez a környezethez? A technológia úgy van kialakítva, hogy bizonyos körülmények között a klónok maximális méretre nőhetnek. Durván fogalmazva, ha tíz terabájtos az adatbázisa és 10 klónja van, akkor könnyen szimulálhat olyan helyzetet, amikor minden klón 10 egyedi adatot tartalmaz. Hogyan számítják ki ezt a helyet, azaz azt a különbséget, amiről beszélt, amelyben ezek a klónok fognak élni?
Jó kérdés. Itt fontos figyelni a konkrét klónokra. Ha egy klónban túl nagy változás történik, és elkezd nőni, akkor először figyelmeztethetjük a felhasználót erről, vagy azonnal leállíthatjuk ezt a klónt, hogy elkerüljük a hibás helyzetet.
Igen, van egy további kérdésem. Tehát hogyan biztosítják ezeknek a moduloknak az életciklusát? Nálunk ez probléma és egy teljesen külön történet. Hogyan történik ez?
Minden klónnak van egy TTL-je. Alapvetően fix TTL-ünk van.
Micsoda, ha nem titok?
1 óra, tehát inaktív – 1 óra. Ha nem használják, akkor eltüntetjük. De ebben nincs semmi meglepő, hiszen klónt másodpercek alatt fel tudunk emelni. És ha újra szükség van rá, csak kérjük.
Az is érdekes számomra, hogy milyen technológiákat választanak, mert például mi párhuzamosan használunk több módszert különböző okok miatt. Miért éppen a ZFS? Miért nem használták az LVM-t? Említette, hogy az LVM-nél problémák voltak. Milyenek voltak azok a problémák? Véleményem szerint a legoptimálisabb a tárolórendszer választása a teljesítmény szempontjából.
Mi a legfőbb probléma a ZFS-sel? Az, hogy mindent egy hoszton kell futtatni, tehát az összes példány egy operációs rendszer keretein belül él. A tárolórendszer esetében viszont különféle hardvereket csatlakoztathatsz. Az egyetlen szűk keresztmetszet a tárolórendszer blokkjai.
Az LVM-ről konkrétan a meetup-on tudunk beszélni. A tárolórendszer – az egyszerűen drágább. A ZFS rendszert bármikor bevezethetjük. Meg tudja telepíteni a saját gépére. Egyszerűen letöltheti a repót és telepítheti. A ZFS szinte mindenhova telepíthető, ha Linuxról beszélünk. Tehát nagyon rugalmas megoldásokat kapunk. Maga a ZFS rengeteg mindent kínál. Akár végtelen mennyiségű adatot is feltölthet, és sok lemezt csatlakoztathat, snapshotok is vannak. És, ahogy már említettem, egyszerűen adminisztrálható. Tehát használni nagyon kellemes. Megbízható, sok éves tapasztalattal rendelkezik, és egy hatalmas, növekvő közösség áll mögötte. A ZFS egy nagyon megbízható megoldás.
Nyikolaj Szamohvalov: Hozzáfűzhetek még valamit? Nyikolajnak hívnak, együtt dolgozom Anatolijjal. Egyetértek azzal, hogy a tárolórendszer nagyszerű. Néhány ügyfelünknek van Pure Storage és hasonló.
Anatolij helyesen megjegyezte, hogy a modularitásra összpontosítunk. A jövőben egyetlen felületet lehetne megvalósítani – készíts egy pillanatképet, készíts egy klónt, töröld a klónt. Ez mind könnyű. És a tároló is nagyszerű, ha van.
De a ZFS mindenki számára elérhető. Elegünk van a DelPhix-ből, 300 ügyfelük van. Ezek közül a Fortune 100-ban 50 ügyfél található, tehát ők a NASA-ra és hasonlókra összpontosítanak. Itt az ideje, hogy ezt a technológiát mindenki megkapja. Ezért van az open source magunk. Van egy felületi rész, ami nem open source. Ez az a platform, amelyet bemutatunk. De szeretnénk, ha ez mindenki számára elérhető lenne. Forradalmat akarunk elérni, hogy a tesztelők abbahagyták a találgatást a laptopokon. Írnunk kell a SELECT-ot, és azonnal látnunk kell, hogy lassú. Elég volt várni, amíg a DBA erről beszél. Ez a fő cél. És úgy gondolom, hogy el fogunk idejutni mindannyian. Ezt a dolgot azért csináljuk, hogy mindenkinek legyen. Ezért a ZFS, mert mindenhol elérhető lesz. Köszönjük a közösségnek a problémák megoldásáért és azért, hogy nyílt forráskódú licencük van stb.
Üdvözlöm! Köszönöm a bemutatót! Maximnak hívnak. Olyan problémákat oldottunk meg, mint amilyeneket ti. Mi nálunk megoldottuk. Hogyan osztjátok meg az erőforrásokat ezek között a klónok között? Minden klón a saját feladatával foglalkozhat egy adott pillanatban: az egyik valamit tesztel, a másik mást, valakinél index épül, valakinek nehéz folyamat fut. Ha a CPU-t még el lehet osztani, akkor IO-ban hogyan osztjátok meg? Ez az első kérdés.
A második kérdésem a tesztkörnyezetek eltérőségéről szól. Tegyük fel, hogy itt ZFS van, és minden szuper, de a kliensnél a termelési környezet nem ZFS, hanem például ext4. Mi történik ebben az esetben?
Nagyon jó kérdések. Kicsit említettem ezt a problémát, hogy hogyan osztjuk meg az erőforrásokat. A megoldás a következő. Képzeljétek el, hogy a staging-en teszteltek. Az is előfordulhat, hogy egyszerre valaki egy terhelést ad, valaki más meg egy másikat. És végül nem világos metrikákat láttok. Ugyanez a probléma lehet a termelésben is. Amikor szeretnétek leellenőrizni egy lekérdezést, és látjátok, hogy valamilyen probléma van vele – lassan fut, akkor valójában nem a lekérdezéssel van a probléma, hanem azzal, hogy valamilyen párhuzamos terhelés van.
Ezért fontos, hogy fókuszáljunk arra, milyen tervet követünk, és hány lépést teszünk a terv keretében, valamint mennyi adatot emelünk fel ehhez. Az, hogy a lemezeink például valamivel leterheltek lesznek, konkrétan befolyásolja az időzítést. De az adatmennyiség alapján fel tudjuk mérni, mennyire terhelt ez a kérés. Nem olyan lényeges, hogy ezzel egyszerre végrehajtunk egy másik feladatot is.
Két kérdésem van. Ez tényleg nagyon klassz dolog. Volt-e olyan eset, amikor a termelési adatok kritikus fontosságúak voltak, például bankkártyaszámok? Van-e már valami kész, vagy ez egy külön feladat? A második kérdésem – van-e valami hasonló a MySQL-hez?
Az adatokkal kapcsolatban. Mi obfuszkálást fogunk végezni, de jelenleg ezt nem tesszük. De ha Joe-t telepíted, és nem engedélyezed a fejlesztőknek a hozzáférést, akkor az adatokhoz nincs hozzáférés. Miért? Mert Joe nem mutatja az adatokat. Csak a metrikákat és a terveket mutatja, és ennyi. Ezt kifejezetten így alakították ki, mivel ez a kliensünk egyike a követelményeinek. Ők azt akarták, hogy legyen lehetőségük optimalizálni, de ne adjanak bárkinek hozzáférést.
A MySQL-ről. Ezt a rendszert bármire használhatjuk, ami állapotot tárol a lemezen. Mivel Postgresszel foglalkozunk, most a teljes automatizálást végezzük a Postgres számára. Az adatok automatizált megszerzésére a háttérből törekszünk. helyesen konfiguráljuk a Postgres-t. Tudjuk, hogyan kell úgy beállítani a terveket, hogy ezek összhangban legyenek, stb.
De mivel a rendszer bővíthető, a MySQL-re is használható lesz. Ilyen példák léteznek. Hasonló dolgot használ a Yandex, de ezt sehol nem publikálják. Belsőleg a Yandex.Metrikában használják ezt. Ott pontosan a MySQL-történet van. De a technológiák ugyanazok, ZFS.
Köszönöm az előadást! Nekem is van pár kérdésem. Megemlítetted, hogy a klónozást lehet használni az elemzéshez, például további indexek létrehozására. Mesélnél egy kicsit bővebben, hogyan működik ez?
És azonnal felteszem a második kérdést a standok egységességéről, a tervek egységességéről. A terv részben függ a Postgres által összegyűjtött statisztikától. Hogyan oldjátok meg ezt a problémát?
Nincsenek konkrét esettanulmányok az elemzésekről, mert még nem használtuk így, de van lehetőség rá. Ha az indekszekről beszélünk, képzeljük el, hogy egy kérdés fut egy számos millió rekordból álló táblán, olyan oszlopban, amelyet általában nem indexelnek a prod környezetben. És szeretnénk néhány adatot kiszámítani. Ha ezt a kérdést a prod-on futtatjuk, van esély arra, hogy a prod-on leállás lesz, mert a kérdés ott egy percig fog futni.
Rendben, csináljunk egy vékony klónt, amelyet nem félek néhány percre megállítani. A kényelmesebb analitika érdekében adjunk hozzá indexeket azokhoz az oszlopokhoz, amelyekben az adatok érdekelnek minket.
Az index minden alkalommal létrejön?
Lehet úgy is csinálni, hogy megérintjük az adatokat, készítünk pillanatfelvételeket, majd ezekből a pillanatfelvételekből állunk helyre és futtatunk új kérdéseket. Tehát lehet úgy csinálni, hogy új klónokat emeljünk fel, már előre beállított indexekkel.
A statisztikai kérdéssel kapcsolatban, ha helyreállunk egy biztonsági másolatból, ha replikálunk, akkor a statisztikánk pontosan ugyanaz lesz. Mert teljesen megőrizzük az adatok fizikai struktúráját, ahogy vannak, az összes statisztikai metrikával együtt.
Itt egy másik probléma merül fel. Ha felhőmegoldás használatban van, akkor csak logikai mentések hozzáférhetők, mert a Google és az Amazon nem ad lehetőséget fizikai másolat készítésére. Ott ilyen probléma lesz.
Köszönöm az előadást. Itt két jó kérdés merült fel a MySQL-ről és az erőforrások elosztásáról. De lényegében minden arra redukálódik, hogy ez nem konkrét DBMS-ek kérdése, hanem általában a fájlrendszerről van szó. Ennek megfelelően az erőforrások elosztásának kérdéseit is onnan kell megoldani, nem azzal, hogy ez Postgres, hanem a fájlrendszeren belül. szerveren, az instance-en.
A kérdésem egy kicsit másról szól. Ez inkább a több rétegből álló adatbázis rétegződésére vonatkozik, ahol több réteg van. Például beállítottunk egy tíz terabájtos kép frissítését, folyik a replikáció. És kifejezetten ezt a megoldást használjuk adatbázisokhoz. A replikáció zajlik, az adatok frissülnek. Itt párhuzamosan 100 dolgozó dolgozik, akik folyamatosan futtatják ezeket a különböző pillanatfelvételeket. Mi a teendő? Hogyan lehet úgy megoldani, hogy ne legyen konfliktus, hogy ők elindítottak egyet, aztán a fájlrendszer megváltozott, és ezek a pillanatfelvételek elcsúsztak?
Nem fognak menni, mert így működik a ZFS. Külön tudjuk tartani egy szálban a fájlrendszer változásait, amelyeket a replikáció hoz. És az régi adatok verzióin klónokat tarthatunk, amelyeket a fejlesztők használnak. És ez nálunk működik, ezzel minden rendben van.
Tehát az aggiornamento egy plusz rétekként fog történni, és az összes új pillanatkép ennek a rétegnek az alapján fog készülni, ugye?
Az előző rétegekből, amelyek a korábbi replikációkból származtak.
A korábbi rétegek eltűnnek, de hivatkozni fognak a régi rétegre, míg az új képek az utolsó rétegből fognak származni, amit az aggiornamento során nyertünk?
Összességében igen.
Akkor ennek következményeként sok rétegünk lesz. Idővel ezeket tömöríteni kell, igaz?
Igen, pontosan. Van egy időablak. Heti pillanatképeket tárolunk. Ez attól függ, hogy mennyi erőforrásod van. Ha van lehetőséged sok adatot tárolni, hosszú ideig tárolhatod a pillanatképeket. Ezek maguktól nem fognak eltűnni. Adatkárosodás nem lesz. Ha a pillanatképek elavultnak tűnnek számunkra, azaz a cég politikájától függ, akkor egyszerűen törölhetjük őket, és felszabadíthatunk helyet.
Üdvözlöm, köszönöm a prezentációt! A Joe kérdésével kapcsolatban. Azt mondta, hogy az ügyfél nem akarta, hogy bárkinek hozzáférése legyen az adatokhoz. Szigorúan véve, ha valakinek van Explain Analyze eredménye, akkor be tud kukkantani az adatokba.
Igen, pontosan. Például ezt írhatjuk: „SELECT FROM WHERE email = valaki”. Tehát nem látjuk magukat az adatokat, de néhány közvetett jelet nézhetünk. Ezt fontos megérteni. De más oldalról ez mind látható. Van auditlogunk, van más kollégák felügyelete, akik szintén látják, mivel foglalkoznak a fejlesztők. És ha valaki megpróbálja ezt tenni, akkor a biztonsági szolgálat el fog menni hozzájuk, és foglalkozik a problémával.
Jó napot! Köszönöm a prezentációt! Van egy rövid kérdésem. Ha a cégnél a Slack nem használatos, van valamilyen kötés hozzá most, vagy a fejlesztők számára létrehozhatók példányok, hogy csatlakozzanak egy tesztalkalmazáshoz az adatbázisokhoz?
Jelenleg csak Slack integráció létezik, tehát nincs más üzenetküldő, de szeretnénk támogatni más üzenetküldőket is. Mit tehet? Telepíthet egy saját DB Labot Joe nélkül, használhatja a REST API-t vagy a platformunkat, és klónokat hozhat létre, valamint csatlakozhat PSQL-lel. De ezt csak akkor teheti meg, ha hajlandó hozzáférést adni a fejlesztőinek az adatokhoz, mert itt már nem lesz semmilyen képernyő.
Erre a rétegre nincs szükségem, viszont szükségem lenne egy ilyen lehetőségre.
Akkor igen, ezt meg lehet csinálni.
Forrás: habr.com
