

Nagy adathalmazok bonyolult feldolgozása során (különböző : importálások, átalakítások és szinkronizálások külső forrással) gyakran felmerül az igény ideiglenesen „memorizálni”, majd gyorsan feldolgozni valami nagyméretűt.
Az ilyen típusú feladatok általában a következőképpen hangzanak: „Itt van, hogy a legutóbbi beérkezett kifizetéseket, ezeket gyorsan fel kell tölteni a weboldalra és hozzá kell rendelni a számlákhoz”
De amikor ennek a „valaminek” a mérete száz megabájtokban mérhető, és a szolgáltatásnak továbbra is 24×7 üzemmódban kell működnie, számos mellékhatás lép fel, amelyek megnehezítik az életét.
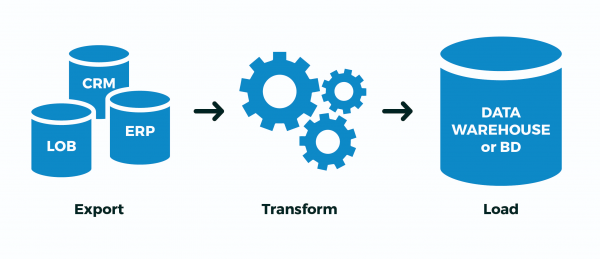
A PostgreSQL-ben (és nem csak benne) ezek kezelésére használhatunk bizonyos optimalizálási lehetőségeket, amelyek lehetővé teszik a gyorsabb feldolgozást, kevesebb erőforrás-felhasználással.
1. Hová töltsük?
Először is, határozzuk meg, hová tölthetjük fel azokat az adatokat, amelyeket „feldolgozni” szeretnénk.
1.1. Ideiglenes táblák (TEMPORARY TABLE)
Alapvetően a PostgreSQL-ben az ideiglenes táblák ugyanolyan táblák, mint bármely más. Ezért tévhit, hogy „minden csak a memóriában tárolódik, és az elfogyhat”. De van néhány lényeges különbség is.
Saját „névtér” minden adatbázis-kapcsolathoz
Ha két kapcsolat egyszerre próbálja végrehajtani CREATE TABLE x, akkor valamelyikük biztosan kapni fog egy egyediségsértési hibát az adatbázisobjektumokkal kapcsolatban.
De ha mindketten megpróbálják végrehajtani CREATE ÁTMENETI TÁBLA x, akkor mindketten normálisan végrehajthatják, és mindkettő megkapja a saját példányát a táblából. És semmi közös nem lesz közöttük.
Öngyilkosság disconnect esetén
A kapcsolat lezárásakor minden ideiglenes tábla automatikusan törlődik, így „kézzel” végrehajtani DROP TABLE x nincs értelme, kivéve…
Ha a pgbouncer-t tranzakciós módban használja, akkor az adatbázis továbbra is úgy gondolja, hogy ez a kapcsolat még mindig aktív, és ebben az ideiglenes táblának továbbra is léteznie kell.
Ezért a tábla második alkalommal való létrehozásának megkísérlése egy másik pgbouncer kapcsolatról hibát fog eredményezni. De ezt meg lehet kerülni, ha igénybe vesszük IDEIGLENES TÁBLÁZAT LÉTREHOZÁSA HA NEM LÉTEZIK x.
Azt viszont jobb elkerülni, mert így „váratlanul” felfedezhetjük, hogy ott maradtak a „korábbi tulajdonos” adatai. Ehelyett sokkal jobb lenne elolvasni a kézikönyvet, és megnézni, hogy a tábla létrehozásakor van lehetőség a kiegészítésére KÖTELEZETTSÉG ALAPJÁN DROP — azaz a tranzakció befejezésekor a táblázat automatikusan törlésre kerül.
Nem-replikáció
Csak egy bizonyos kapcsolathoz való tartozás miatt a ideiglenes táblák nem replikálódnak. Viszont ez megszabadít a kettős adatrögzítés szükségességétől heap + WAL, ezért az INSERT/UPDATE/DELETE jelentősen gyorsabb benne.
De mivel az ideiglenes táblázat, ha úgy tetszik, "majdnem egyszerű" táblázat, így a replikán sem hozható létre. Legalábbis most, bár a megfelelő patch már régóta kering.
1.2. Nemsorolt táblák (UNLOGGED TABLE)
De mi a helyzet, ha van egy terjedelmes ETL-folyamata, amit nem lehet megvalósítani egy tranzáción belül, és van pgbouncer-t tranzakciós módban használja?..
Vagy az adatfolyam olyan nagy, hogy egy kapcsolat sávszélessége nem elegendő az adatbázissal (értsd: egy CPU-n lévő folyamat)?..
Vagy egyes műveletek aszinkron módon különböző kapcsolatokban zajlanak?..
Itt csak egy lehetőség van — ideiglenes nem-ideiglenes táblát létrehozni. Szóvicc, igen. Azaz:
- létrehoztam „saját” tábláimat a lehető legesetlegesebb nevekkel, hogy senkivel ne találkozzak
- Extract: adatokat töltöttem fel belső forrásokból
- Transform: átalakítottam, kitöltöttem a kulcsmeghatározó mezőket
- Betöltés: az előkészített adatokat átmásoltam a cél táblázatokba
- töröltem a „saját” tábláimat
És most — egy kanál kátrány. Valójában az összes rögzítés a PostgreSQL-ben kétszer történik — , majd a táblázatok/testekbe. Mindez az ACID támogatása és az adatok helyes láthatósága érdekében készült COMMITa folyamatok között és a ROLLBACKfolyamatok között.
De nekünk erre nincs szükségünk! A folyamatunk vagy teljes egészében sikeresen véget ért, vagy nem. Nem számít, hány közbenső tranzakció lesz benne — minket nem érdekel a „folytatás a folyamat közepétől”, különösen, ha nem világos, hol tartott.
Erre a PostgreSQL fejlesztői már a 9.1-es verzióban bevezettek egy dolgot, mint :
Ezzel a megjelöléssel a táblázat nem naplózottként jön létre. A nem naplózott táblákba írt adatok nem mennek át a naplózott írás (lásd 29. fejezet) révén, ami miatt ezek a táblák jóval gyorsabban működnek, mint a normál. Azonban nem védettek a hibákkal szemben; áramkimaradás vagy vészhelyzeti leállás esetén a nem naplózott táblázat automatikusan eltűnik.. Ezen kívül a nem naplózott táblázat tartalma nem replikálódik. a vezére serverekre. Bármilyen index, amely a nem naplózott táblához létrejön, automatikusan nem naplózottá válik.
Röviden, nagyon sokkal gyorsabb lesz, de ha az adatbázis szerver "összeomlik" - kellemetlen lesz. De gyakran előfordul ez, és képes-e az ETL folyamatod helyesen kezelni a dolgokat "a közepéből" az adatbázis "újjáélesztése" után?..
Ha mégsem, és a fenti eset hasonlít a tiédre - használj UNLOGGED, de soha ne használd ezt a tulajdonságot valódi táblákra, melyek adatai fontosak számodra.
1.3. ON COMMIT { DELETE ROWS | DROP }
Ez a konstrukció lehetővé teszi, hogy a tábla létrehozásakor automatikus viselkedést adjunk meg a tranzakció befejezésekor.
A KÖTELEZETTSÉG ALAPJÁN DROP már írtam fent, ezt generálja DROP TABLE, de itt a KÖTELEZETTSÉG ALAPJÁN SOROZAT TÖRLÉSE helyzet érdekesebb - itt generálódik TRUNCATE TABLE.
Mivel a meta-adattároló ideiglenes táblája pontosan ugyanolyan infrastruktúrával rendelkezik, mint a normál táblák, ezért az ideiglenes táblák folyamatos létrehozása és törlése a rendszer táblák "megbővülését" eredményezi pg_class, pg_attribute, pg_attrdef, pg_depend,…
Most képzeld el, hogy van egy munkás, aki közvetlen kapcsolatban van az adatbázissal, és másodpercenként új tranzakciót nyit, létrehoz, feltölt, feldolgoz és töröl egy ideiglenes táblát... A szemét a rendszer táblákban bőségesen felhalmozódik, ez pedig felesleges lassításhoz vezet minden művelet során.
Összességében, ne csináld ezt! Ebben az esetben sokkal hatékonyabb CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS kivinni a tranzakciós cikluson kívül - akkor az új tranzakció kezdete előtt a táblák már létezni fognak (megtakarítjuk a hívást CREATE), de üres lesz, hála TRUNCATE (ennek a hívása is megtakarítottuk) a korábbi tranzakció befejezésekor.
1.4. LIKE… INCLUDING …
Az elején említettem, hogy az ideiglenes táblák tipikus felhasználási esete - különböző importok - és a fejlesztő fáradtan másolja a cél tábla mezőlistáját az ideiglenes tábla deklarációjába...
De a lustaság a fejlődés mozgatórugója! Ezért egy új táblát "mint minta" sokkal egyszerűbben létrehozhatsz:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Mivel ebbe a táblába később nagyon sok adatot be lehet generálni, a keresés benne nem lesz éppen gyors. De erre van egy hagyományos megoldás - indexek! Igen, az ideiglenes táblának is lehetnek indexei.
Mivel gyakran a szükséges indexek megegyeznek a cél tábla indexeivel, egyszerűen megírhatod HASONLÓ target_table TARTALMAZZA AZ INDEXEKET.
Ha további DEFAULT-értékek (például a primer kulcs értékeinek kitöltéséhez) használhatók HASONLÓ target_table TARTALMAZZA AZ ALAPÉRTÉKEKET. Vagy csak — HASONLÓ target_table MINDEN BELEÉRTVE — másolja az alapértelmezett értékeket, indexeket, kényszereket,…
De itt már meg kell érteni, hogy ha létrehoztál import táblát az indexekkel, akkor az adatok betöltése hosszabb ideig tart, mint ha először minden adatot betöltesz, és csak később alkalmazod az indexeket — nézd meg példaként, hogyan csinálja .
Összességében, !
2. Hogyan írjunk?
Egyszerűen mondom — használj -folyamot a "csomag" helyett INSERT, . Akár közvetlenül a előre elkészített fájlból is.
3. Hogyan dolgozzunk fel?
Tegyük fel, hogy a bevezetőnk körülbelül így néz ki:
- a rendszeredben van egy tábla az ügyféladatokkal 1M rekorddal
- minden nap az ügyfél új teljes "képét"
- tapasztalataid alapján tudod, hogy az esetek többségében maximálisan 10K rekord változik
A klasszikus példa egy ilyen helyzetre a — rengeteg cím található, de minden heti kiadásban a változások között (településnevek átnevezése, utcák egyesítése, új házak megjelenése) nagyon kevés van az egész ország méretéhez képest.
3.1. Teljes szinkronizálási algoritmus
Egyszerűség kedvéért tegyük fel, hogy még az adatok átalakítására sincs szükség — egyszerűen csak a táblázatot kell a kívánt formára hozni, így:
- törölni minden, ami már nincs
- a rendszert a p9 ágon a "Sisyphus" tartományból. Az új vállalati felhasználók számára lehetőség van tesztverziók beszerzésére, míg a magánszemélyek számára a "Basalt SPO" weboldaláról vagy az új letöltő oldalról a "getalt.ru" webhelyről hagyományosan ingyenesen letölthető a szükséges "Alt" operációs rendszer verzió. minden, ami már megvolt, és frissíteni kell
- beszúrni minden, ami még nem volt
Miért éppen ilyen sorrendben kell a műveleteket végezni? Mert így növekszik a táblázat mérete minimálisan ().
TÖRÖLD FROM dst
Nem, természetesen át lehet ugrani két műveletet:
- törölni (
DELETE) tényleg minden - beszúrni minden a új képben
De ezzel együtt, a MVCC-nek köszönhetően, a táblázat mérete pontosan duplájára nő! Kapni +1M rekordot a táblázatban a 10K frissítése miatt nem éppen optimális redundancia...
TRUNCATE dst
A tapasztalt fejlesztők tudják, hogy az egész táblázat elég olcsón tisztítható:
- clear (
TRUNCATE) Az egész táblát - beszúrni minden a új képben
Hatékony módszer, , de van egy probléma… 1M rekord bevitele sok időt vesz igénybe, ezért nem engedhetjük meg magunknak, hogy a táblázat üres maradjon az összes ebben az időben (ahogy történne, ha nem csomagolnánk egy tranzakcióba).
Ezért:
- kezdődik egy hosszú tranzakció
TRUNCATErávonatkozik Kizáró hozzáférés-zárolás- hosszú ideig tárolunk, miközben minden más még azt sem tudja
SELECT
Valami nem áll jól…
ALTER TABLE… RENAME… / DROP TABLE …
Egy alternatíva, hogy mindent feltöltenénk egy új táblába, majd egyszerűen átnevezzük a régit. Néhány kellemetlen apróság:
- ez is Kizáró hozzáférés, bár időben lényegesen kevesebb
- minden lekérdezési terv/tiltott táblázati statisztika nullázódik,
- megszakadnak az összes külső kulcs (FK) a táblára
Volt egy WIP-patch Simon Riggs-től, amely azt javasolta, hogy ALTER-művelet a tábla fájlszintű felcserélésére, anélkül, hogy a statisztikát és a FK-t megérintené, de nem gyűjtötte össze a szükséges szavazati kört.
DELETE, UPDATE, INSERT
Így a három művelet blokkolás nélküli változatánál maradunk. Szinte hármat… Hogyan tudjuk ezt a leghatékonyabban megtenni?
-- mindent tranzakciókon belül végzünk, hogy senki ne láthassa a "köztes" állapotokat
BEGIN;

-- létrehozunk egy ideiglenes táblát a betöltött adatokkal
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- hasonlóan a régi táblához, indexekkel együtt
) ON COMMIT DROP; -- a tranzakción kívül már nincs szükségünkre

-- gyorsan betöltjük az új képet a COPY segítségével
COPY tmp FROM STDIN;
-- ...
-- .

-- eltávolítjuk a hiányzókat
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- elsődleges kulcs mezők
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "anti join"

-- frissítjük a megmaradtakat
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- nincs értelme frissíteni a megegyezőket

-- beszúrjuk a hiányzókat
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Az import utófeldolgozása
Ugyanabban a KML-ben minden megváltozott rekordot további post-processzálásnak kell alávetni – normalizálni, kiemelni a kulcsszavakat, megfelelő struktúrákba hozni. De hogyan lehet megtudni— mi változott, anélkül, hogy bonyolítanánk a szinkronizálási kódot, lényegében ne is értsünk hozzá?
Ha a szinkronizálás alatt csak az Ön folyamata rendelkezik írási jogosultsággal, akkor egy trigger segítségével összegyűjthetjük az összes változást:
-- céltáblák
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- történeti változások táblái
CREATE TABLE kladr$log(
  ro kladr, -- itt állnak az állandó rekordok régi/új másolatai
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- általános változásnaplózó függvény
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- ellenőrizzük a naplózás szükségességét a rekord frissítésekor
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- létrehozzuk a naplóbejegyzést
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Most már a szinkronizálás megkezdése előtt trigger-eket alkalmazhatunk (vagy bekapcsolhatjuk azokat ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Aztán nyugodtan kivonhatunk az log táblákból minden szükséges változást, és átvezethetjük azokat a további feldolgozókra.
3.3. Kapcsolódó készletek importálása
Fent azt a helyzetet vizsgáltuk, amikor a forrás és a céladatok szerkezete megegyezik. De mi történik, ha a külső rendszertől való exportálás formátuma eltér a nálunk tárolt struktúrától?
Vegyünk példaként egy ügyfél és a hozzájuk kapcsolódó számlák tárolását, klasszikus «sok-az-egyhez» esetként:
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Azonban a külső forrástól érkező export «minden egyben» formában érkezik:
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Nyilvánvaló, hogy az ügyfelek adatai duplázódhatnak ilyen formátumban, és a fő bejegyzés a «számla»:
0123456789;Vasya;A-01;2020-03-16;1000.00
9876543210;Petya;A-02;2020-03-16;666.00
0123456789;Vasya;B-03;2020-03-16;9999.00
A modellhez egyszerűen beszúrjuk a tesztadatainkat, de emlékezzünk — COPY hatékonyabban!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasya', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petya', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasya', 'B-03', '2020-03-16', 9999.00);
Először kiemeljük azokat a «szeleteket», amelyekre a mi «tények» hivatkoznak. Ebben az esetben a számlák az ügyfelekre hivatkoznak:
Hozzunk létre egy ideiglenes táblázatot az ügyfélimporthoz
Kiválasztva az ügyfél-inn-ek egyedi rekordjait
-- egyszerűen használhatjuk a SELECT DISTINCT-ot, ha az adatok biztosan nem ellentmondásosak
  client_inn inn
, client_name "name"
FROM
  invoice_import;
Ahhoz, hogy a számlákat helyesen összekapcsoljuk az ügyfél-azonosítókkal, először meg kell ismernünk vagy generálnunk ezeket az azonosítókat. Adjunk hozzá mezőket hozzájuk:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
A fent leírt táblázat-szinkronizálási módszert fogjuk alkalmazni egy kis változtatással — nem frissítünk és nem távolítunk el semmit a cél táblázatban, hiszen az ügyfelek importja számunkra „csak hozzáadás”:
-- megadjuk az import táblázatban a már létező rekordok ID-ját
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  client D
WHERE
  T.inn = D.inn; -- egyedi kulcs

-- beszúrjuk a hiányzó rekordokat és megadjuk az ID-jukat
WITH ins AS (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  FROM
    client_import
  WHERE
    client_id IS NULL -- ha az ID nem lett megadva
  RETURNING *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  ins D
WHERE
  T.inn = D.inn; -- egyedi kulcs

-- megadjuk az ügyfél ID-ját a számla rekordoknál
UPDATE
  invoice_import T
SET
  client_id = D.client_id
FROM
  client_import D
WHERE
  T.client_inn = D.inn; -- alkalmazási kulcs
Tulajdonképpen ennyi — a invoice_import most már ki van töltve a kapcsolat mező client_id, amellyel be fogjuk illeszteni a számlát.
Forrás: habr.com
