

Az új kurzus elindulása előtt Elkészítettük egy érdekes anyag fordítását.
Áttekintés
Beszélni fogunk egy elég népszerű mintáról, amellyel az alkalmazások több adatbázist használnak, ahol minden adatbázis saját célokra szolgál, például a canonikus adatformák tárolására (MySQL stb.), a fejlett keresési lehetőségek biztosítására (ElasticSearch stb.), gyorsítótárazásra (Memcached stb.) és egyéb célokra. Általában, ha több adatbázist használnak, az egyik a fő tárolóként működik, míg a többi származékos tárolóként funkcionál. Az egyetlen problémát az jelenti, hogy hogyan lehet szinkronizálni ezeket az adatbázisokat.
Számos különböző mintát átvizsgáltunk, amelyek próbálták megoldani a több adatbázis szinkronizálásának problémáját, például a dupla írást, az elosztott tranzakciókat stb. Azonban ezeknek a megközelítéseknek lényeges korlátai vannak a való életbeli használat, megbízhatóság és karbantartás szempontjából. Az adatok szinkronizálásán kívül egyes alkalmazásoknak az adatok gazdagítására is szükségük van, külső szolgáltatások meghívásával.
Ezeknek a problémáknak a megoldására jött létre a Delta. A Delta végül egy koherens, események által vezérelt platformot képvisel az adatok szinkronizálására és gazdagítására.
Meglévő megoldások
Dupla írás
Ahhoz, hogy szinkronizáljunk két adatbázist, használhatunk dupla írást, amely egy írást végez egy adatbázisba, majd ezt követően azonnal egy másikba is. Az első írás megismételhető, a második pedig leállítható, ha az első írás sikertelenül zárul a kísérletek számának kimerülése után. Azonban a két adatbázis szinkronizálása megszakadhat, ha a második adatbázisba történő írás sikertelen. Ezt a problémát általában egy helyreállítási eljárás létrehozásával oldják meg, amely időszakosan újra átkonvertálja az adatokat az elsőből a másodikba, vagy csak akkor, ha eltéréseket észlelnek az adatokban.
Problémák:
A helyreállítási eljárás végrehajtása specifikus feladat, amelyet nem lehet újrahasznosítani. Ezenkívül az adatok a tárolók között szinkronizálatlanok maradnak, amíg a helyreállítási eljárás le nem zárul. A probléma bonyolódik, ha több mint két adatforrást használnak. Végül a helyreállítási eljárás terhet jelenthet az eredeti adatforrásra.
Változási napló táblázat
Amikor a táblázat halmazban változások történnek (például egy rekord beszúrása, frissítése vagy törlése), a változások a változási napló táblázathoz kerülnek hozzáadásra, mint a tranzakció része. Más folyamat vagy szál folyamatosan kérdezi a változási napló táblázatot, és szükség szerint egy vagy több adatforrásba rögzíti az eseményeket, eltávolítva azokat a naplóból, miután azok minden tárolóval visszaigazolásra kerültek.
Problémák:
Ezt a mintát könyvtárként kell megvalósítani, és ideálisan az alkalmazás kódjának megváltoztatása nélkül kell használnia. Poliglot környezetben ennek a könyvtárnak bármely szükséges nyelven léteznie kell, de a funkciók és viselkedés közötti összhang biztosítása nyelvek között nagyon nehéz.
Egy másik probléma a séma változások beszerzésével kapcsolatos, abban a rendszerekben, amelyek nem támogatják a tranzakcionális séma változásokat [1][2], mint például a MySQL. Ezért a változás végrehajtásának mintázata (például a séma módosítása) és annak tranzakcionális rögzítése a változási napló táblázatba nem mindig működik megfelelően.
Elosztott Tranzakciók
Az elosztott tranzakciók használhatók arra, hogy egy tranzakciót több eltérő adatforráson osszanak meg, amelynek során a művelet vagy mindegyik használt tárolóban rögzítve van, vagy egyikben sem.
Problémák:
A elosztott tranzakciók jelentős problémát jelentenek a heterogén adatbázisok számára. Természetüknél fogva csak a részt vevő rendszerek legkisebb közös többszörösére támaszkodhatnak. Például XA-tranzakciók felfüggesztik a végrehajtást, ha az alkalmazás folyamatában hiba lép fel a felkészülés során. Ezen kívül az XA nem biztosít holtpont-észlelést, és nem támogatja az optimista párhuzamkezelési sémákat. Továbbá, egyes rendszerek, mint például az ElasticSearch, nem támogatják az XA-t vagy bármilyen más heterogén tranzakciós modellt. Így az adatok atomitásának biztosítása különböző tárolási technológiákban a felhasználások számára nagyon összetett feladatot jelent [3].
Delta
A Delta megoldásokat kínál a meglévő adat-szinkronizáló megoldások korlátainak eltávolítására, és lehetővé teszi az adatok valós idejű gazdagítását. Célunk az volt, hogy az összes bonyolult szempontot elvonjuk az alkalmazásfejlesztőktől, hogy teljes mértékben a üzleti funkciók megvalósítására összpontosíthassanak. Továbbá bemutatjuk a 'Movie Search'-t, a Delta tényleges használatát a Netflix-től.
A Netflix széles körben alkalmaz mikroszolgáltatás-architektúrát, és minden mikroszolgáltatás általában egyféle adatot szolgál ki. A filmek alapadatai egy Movie Service nevű mikroszolgáltatásba kerültek, míg a kapcsolódó adatok, mint például a producerek, színészek, beszállítók információi, számos más mikroszolgáltatás (nevezetesen Deal Service, Talent Service és Vendor Service) által kerülnek kezelésre.
A Netflix Studios üzleti felhasználói gyakran keresnek filmeket különféle kritériumok alapján, ezért fontos számukra, hogy képesek legyenek keresni az összes filmhez kapcsolódó adat között.
A Delta megjelenése előtt a filmes keresőcsapatnak adatokat kellett gyűjtenie több mikroszolgáltatásból, mielőtt azokat a filmszolgáltatás adatbázisába indexelték volna. Ezen kívül a csapatnak ki kellett dolgoznia egy rendszert, amely időszakosan frissítette a keresési indexet, lekérdezve a változásokat más mikroszolgáltatásoktól, még akkor is, ha nem történt változás. Ez a rendszer rendkívül bonyolulttá vált, és nehezen volt fenntartható.
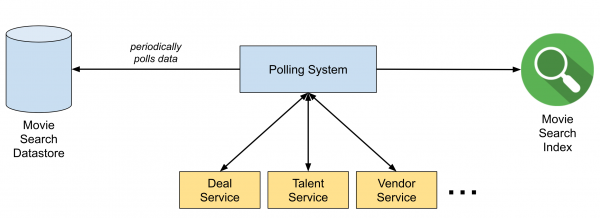
1. ábra. Polling rendszer a Delta előtt
A Delta használatának megkezdése után a rendszer eseményvezérelt rendszerre egyszerűsödött, ahogyan az alábbi ábrán látható. A CDC (Change-Data-Capture) eseményeket Delta-Connector segítségével küldik el a Keystone Kafka témákba. A Delta alkalmazás, amely a Delta Stream Processing Framework (Flink alapú) felhasználásával készült, a témából CDC eseményeket kap, dúsítja azokat, más mikroszolgáltatásokat hívva meg, és végül az obogott adatokat továbbítja a keresési indexbe az Elasticsearch-ben. Az egész folyamat szinte valós időben zajlik, azaz amint a változások rögzítve vannak az adatbázisban, a keresési indexek frissülnek.
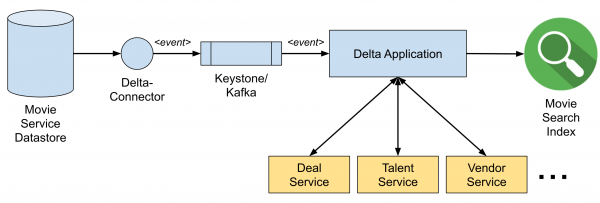
2. ábra. A Delta használatával készült adatpipeline
A következő részekben leírjuk a Delta-Connector működését, amely csatlakozik a tárolóhoz, és publikálja a CDC eseményeket a transport szinten, amely a valós idejű adatátviteli infrastruktúrát képviseli, irányítva a CDC eseményeket a Kafka témákba. Végül beszélni fogunk a Delta folyamfeldolgozás struktúrájáról, amelyet az alkalmazásfejlesztők a feldolgozási logikához és az adatok dúsításához használhatnak.
CDC (Change-Data-Capture)
Kifejlesztettük a CDC szolgáltatást, amely Delta-Connector néven ismert, és amely valós időben képes rögzíteni az adatbázisban elkövetett elkötelezett változásokat, és azokat egy folyamba írni. A valós idejű változások a tranzakciós naplóból és a tárolók dump-jából származnak. A dumpokat használjuk, mivel a tranzakciós naplók általában nem tárolják a változások teljes történetét. A változásokat általában Delta eseményekként sorozatosítják, így a címzettnek nem kell aggódnia afelől, hogy honnan származik a változás.
A Delta-Connector számos további funkciót támogat, mint például:
- A képesség, hogy személyre szabott kimeneteket írja a Kafka elkerülésével.
- A lehetőség, hogy bármikor manuális dumpokat aktiváljunk minden táblára, egyes táblákra, vagy meghatározott elsődleges kulcsokra.
- A dumpokat chunk-okban lehet lekérni, tehát nincs szükség arra, hogy mindent az elejéről kezdjünk, ha hiba lépne fel.
- Nincs szükség zárolni a táblákat, ami nagyon fontos ahhoz, hogy az adatbázisba történő írási forgalmat soha ne korlátozza a szolgáltatásunk.
- Magas rendelkezésre állás az AWS Availability Zone-okban található tartalék példányok miatt.
Jelenleg MySQL és Postgres támogatásával, beleértve az AWS RDS és Aurora telepítést is. Emellett támogatjuk a Cassandrát (multi-master). További részleteket a Delta-Connectorról a következő linkben találhat. .
Kafka és a szállítási szint
A Delta eseményszállító szint a platform üzenetküldő szolgáltatásán alapul .
Történelmileg a Netflixben a szövegek közzététele a magasabb rendelkezésre állásra lett optimalizálva, nem pedig a tartósságra (lásd ). A kompromisszumnak az lett a következménye, hogy a broker adatai a különböző határhelyzetekben nem feltétlenül egyeznek. Például, tisztátalan vezető választás felelős azért, hogy a vevő potenciálisan duplázza vagy elveszítse az eseményeket.
A Delta segítségével nagyobb garanciákat szerettünk volna a tartósságra, hogy biztosítsuk a CDC események szállítását a származtatott tárolókba. Ennek érdekében javasoltunk egy külön tervezett Kafka klasztert első osztályú objektumként. Néhány brokerbeállítást az alábbi táblázatban találhat.
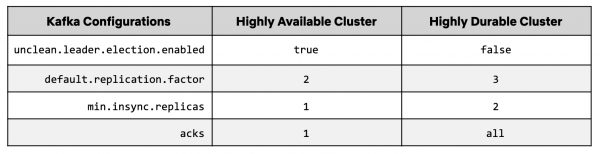
A Keystone Kafka klaszterekben, tisztátalan vezető választás általában be van kapcsolva a kiadó elérhetőségének biztosítására. Ez üzenetek elvesztéséhez vezethet, ha egy szinkronizálatlan replikát választanak vezetőnek. Egy új, nagyon megbízható Kafka klaszternél az tisztátalan vezető választás ki van kapcsolva, hogy megakadályozza az üzenetek elvesztését.
Emellett növeltük a replikálási tényezőt 2-ről 3-ra és minimum szinkronizált replikák számát 1-ről 2-re. Azok a kiadók, akik ebbe a klaszterbe írnak, megkövetelik az összes többi replikától a megerősítést, biztosítva, hogy a 2-ből 3 replikán a kiadó által elküldött legfrissebb üzenetek legyenek.
Amikor a broker példány leáll, egy új példány váltja fel a régit. Azonban az új brokernek be kell hoznia a szinkronizálatlan replikákat, ami több órát is igénybe vehet. A helyreállítási idő csökkentése érdekében elkezdtük használni az Amazon Elastic Block Store-t, mint adatblokkok tárolását a broker helyi lemezei helyett. Amikor az új példány helyettesíti a leállt broker példányt, csatlakozik a leállt példány EBS kötetéhez, és elkezdi behozni az új üzeneteket. Ez a folyamat csökkenti a lemaradás felszámolásának idejét több óráról néhány percre, mivel az új példánynak nem kell üres állapotból replikálnia. Összességében a tárolók és a broker külön életciklusa jelentősen csökkenti a broker váltásának hatását.
A data delivery guarantee további növelése érdekében használtunk bármilyen üzenetvesztés észlelésére szélsőséges körülmények között (például a partíció vezetőjében lévő órák deszinkronizálása).
Stream Processing Framework
A Delta feldolgozási szintje a Netflix SPaaS platformján alapul, amely integrálja az Apache Flink-et a Netflix ökoszisztémájába. A platform egy felhasználói felületet biztosít, amely kezeli a Flink feladatok telepítését és a Flink klaszterek orkestrálását a Titus konténerkezelő platformunkon. A felület emellett kezeli a feladatkonfigurációkat, és lehetővé teszi a felhasználók számára, hogy dinamikusan változtatásokat végezzenek a konfiguráción anélkül, hogy újra kellene fordítaniuk a Flink feladatokat.
A Delta egy Flink alapú és SPaaS rendszerű adatfeldolgozó keretrendszert biztosít, amely annotation-based DSL (Domain Specific Language) segítségével elvonatkoztatja a technikai részletektől. Például, hogy meghatározzuk a lépést, amellyel az események kiegészítésre kerülnek, külső szolgáltatásokat hívva, a felhasználóknak a következő DSL-t kell írniuk, és a keretrendszer ennek alapján létrehoz egy modellt, amelyet a Flink végrehajt.
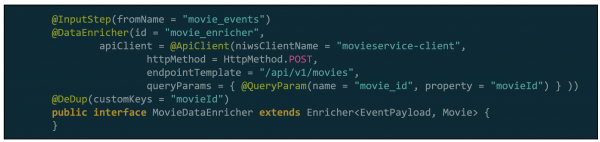
3. ábra. Példa a Delta DSL-en alapuló kiegészítésére
A keretrendszer nemcsak csökkenti a tanulási görbét, hanem általános adatfeldolgozási funkciókat is biztosít, mint például a deduplikáció, a sémáztatás, valamint rugalmasságot és hibatűrést nyújt a gyakori problémák megoldásához.
A Delta Stream Processing Framework két kulcsfontosságú komponensből áll: DSL & API modul és Runtime modul. A DSL & API modul olyan DSL-t és UDF (User-Defined Function) API-t biztosít, amelyen keresztül a felhasználók saját feldolgozási logikájukat írhatják meg (például szűrések vagy átalakítások). A Runtime modul a DSL parser implementációját nyújtja, amely belső reprezentációt épít az feldolgozási lépésekről DAG modellekben. Az Execution komponens értelmezi a DAG modelleket, hogy inicializálja a valódi Flink operátorokat, és végül elindítsa a Flink alkalmazást. A keretrendszer architektúrája az alábbi ábrán látható.
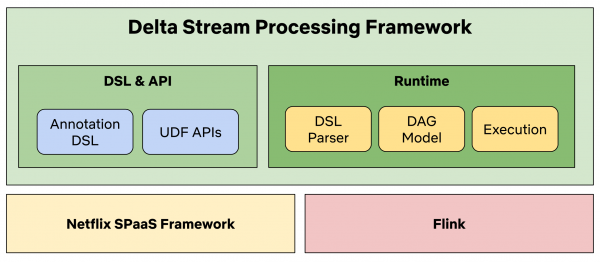
4. ábra. A Delta Stream Processing Framework architektúrája
Ennek a megközelítésnek számos előnye van:
- A felhasználók a saját üzleti logikájukra összpontosíthatnak anélkül, hogy elmélyülnének a Flink részleteiben vagy az SPaaS struktúrájában.
- Az optimalizálás a felhasználók számára átlátható módon végezhető, és a hibák javíthatók anélkül, hogy bármilyen változtatást kellene eszközölni a felhasználói kódban (UDF).
- A Delta alkalmazások használata a felhasználóknak egyszerűbb, mivel a platform dobozból kivéve rugalmasságot és hibamentességet kínál, és számos részletes metrikát gyűjt, amelyeket figyelmeztetésekhez használhatnak.
A termelési használat
A Delta már több mint egy éve fut a termelésben, és kulcsszerepet játszik sok Netflix Studio alkalmazásban. Segített a csapatoknak olyan felhasználási esetek megvalósításában, mint a keresési indexelés, adattárolás és eseményvezérelt munkaáramok. Az alábbiakban a Delta platform magas szintű architektúrájának áttekintése látható.
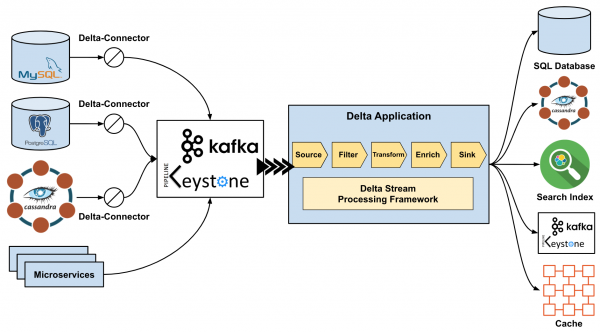
5. ábra. A Delta magas szintű architektúrája.
Köszönetnyilvánítások
Szeretnénk megköszönni a következő személyeknek, akik részt vettek a Delta létrehozásában és fejlődésében a Netflixnél: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang és Zhenzhong Xu.
Források
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Online eseményfeldolgozás. Commun. ACM 62(5): 43–49 (2019). DOI:
: "Data Build Tool az Amazon Redshift tárházhoz."
Forrás: habr.com
