

Sziasztok! A nevem Oleg Sidorenkov, a DomClicknél dolgozom az infrastrukturális csapat vezetőjeként. Több mint három éve használjuk a Kubikot a gyártásban, és ezalatt sok érdekes pillanatot éltünk át vele. Ma elmondom, hogyan préselhet ki még nagyobb teljesítményt a megfelelő megközelítéssel a vaníliás Kubernetes-ből a fürtje számára. Indulásra készen!
Mindannyian jól tudják, hogy a Kubernetes egy méretezhető, nyílt forráskódú rendszer konténerhangszereléshez; nos, vagy 5 bináris, amelyek varázslatosan működnek azáltal, hogy szerverkörnyezetben kezelik a mikroszolgáltatások életciklusát. Ráadásul ez egy meglehetősen rugalmas eszköz, amely Lego-hoz hasonlóan összeszerelhető a különböző feladatok maximális testreszabása érdekében.
És úgy tűnik, minden rendben van: dobd a szervereket a klaszterbe, mint a tűzifát a tűztérbe, és nem fogsz tudni semmi bánatról. De ha Ön a környezetért, azt fogja gondolni: „Hogyan tarthatnám égve a tüzet és kímélhetném meg az erdőt?” Más szóval, hogyan lehet módot találni az infrastruktúra fejlesztésére és a költségek csökkentésére.
1. Figyelje a csapat- és alkalmazásforrásokat
Az egyik legelterjedtebb, de hatékony módszer a kérések/korlátok bevezetése. Ossza fel az alkalmazásokat névterekre, a névtereket pedig fejlesztőcsapatok szerint. Üzembe helyezés előtt állítsa be az alkalmazás értékeit a processzoridő, a memória és az átmeneti tárhely fogyasztásához.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
A tapasztalatok alapján arra a következtetésre jutottunk, hogy a kéréseket nem szabad kétszeresére növelni a korlátoktól. A fürt mennyiségét a kérések alapján számítják ki, és ha például 5-10-szeres erőforrás-különbséget ad az alkalmazásoknak, akkor képzelje el, mi történik a csomóponttal, ha megtelik podokkal és hirtelen terhelést kap. Semmi jó. Minimálisan fojtással, maximumon pedig búcsút vesz a dolgozótól, és ciklikus terhelést kap a maradék csomópontokon, miután a hüvelyek elkezdenek mozogni.
Ráadásul a segítséggel limitranges Kezdetben beállíthatja a tároló erőforrásértékeit - minimum, maximum és alapértelmezett:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Ne felejtse el korlátozni a névtér erőforrásait, hogy egy csapat ne tudja átvenni a fürt összes erőforrását:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Ahogy a leírásból is látszik resourcequotas, ha az operatív csapat további 10 CPU-t fogyasztó podokat akar telepíteni, az ütemező ezt nem engedi, és hibát fog kiadni:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10Egy ilyen probléma megoldásához írhat egy eszközt, például tetszik , képes tárolni és lekötni a parancs állapotú erőforrásait.
2. Válassza ki az optimális fájltárolót
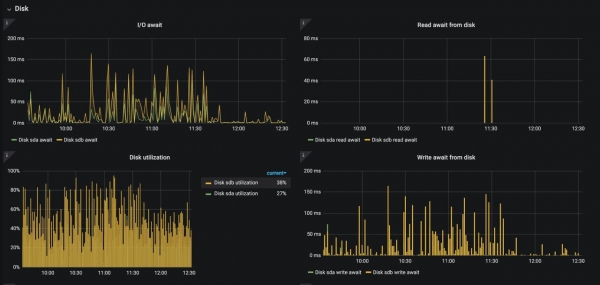
Itt szeretném érinteni a perzisztens kötetek témáját és a Kubernetes worker csomópontok lemezes alrendszerét. Remélem, hogy a gyártás során senki sem használja a HDD-n lévő „Kockát”, de néha már nem elég egy normál SSD. Olyan problémába ütköztünk, hogy a naplók megölték a lemezt az I/O műveletek miatt, és nincs sok megoldás:
Használjon nagy teljesítményű SSD-ket, vagy váltson NVMe-re (ha saját hardverét kezeli).
Csökkentse a naplózási szintet.
Végezzen „okos” kiegyensúlyozást a lemezt feltörő hüvelyeknél (
podAntiAffinity).
A fenti képernyőn látható, hogy mi történik az nginx-ingress-controller alatt a lemezzel, ha az access_logs naplózás engedélyezve van (~12 ezer napló/mp). Ez a feltétel természetesen az összes alkalmazás leromlásához vezethet ezen a csomóponton.
Ami a PV-t illeti, sajnos nem próbáltam ki mindent Állandó kötetek. Használja az Önnek legmegfelelőbb lehetőséget. Történelmileg hazánkban előfordult, hogy a szolgáltatások egy kis része igényel RWX-kötetet, és nagyon régen elkezdték NFS-tárolót használni erre a feladatra. Olcsó és... elég. Természetesen ő és én szart ettünk – áldjuk meg, de megtanultuk kihangolni, és már nem fáj a fejem. És ha lehetséges, lépjen át az S3 objektumtárolóra.
3. Gyűjtse össze az optimalizált képeket
A legjobb, ha tárolóra optimalizált képeket használ, hogy a Kubernetes gyorsabban lekérhesse és hatékonyabban végrehajthassa azokat.
Az optimalizált azt jelenti, hogy a képek:
csak egy alkalmazást tartalmazzon, vagy csak egy funkciót hajtson végre;
kis méretű, mert a nagy képeket rosszabbul továbbítják a hálózaton;
olyan állapot- és készenléti végpontokkal kell rendelkeznie, amelyek lehetővé teszik a Kubernetesnek, hogy leállás esetén intézkedjen;
használjon konténerbarát operációs rendszereket (például Alpine vagy CoreOS), amelyek jobban ellenállnak a konfigurációs hibáknak;
használjon többlépcsős összeállításokat, így csak a lefordított alkalmazásokat telepítheti, a kapcsolódó forrásokat nem.
Számos eszköz és szolgáltatás lehetővé teszi a képek menet közbeni ellenőrzését és optimalizálását. Fontos, hogy ezeket mindig naprakészen tartsa és a biztonság érdekében tesztelje. Ennek eredményeként a következőket kapja:
Csökkentett hálózati terhelés a teljes fürtön.
A konténer indítási idejének csökkentése.
A teljes Docker-nyilvántartás kisebb mérete.
4. Használja a DNS-gyorsítótárat
Ha nagy terhelésről beszélünk, akkor az élet elég silány a fürt DNS-rendszerének hangolása nélkül. Egyszer régen a Kubernetes fejlesztők támogatták a kube-dns megoldásukat. Itt is implementálták, de ez a szoftver nem volt különösebben tuningolva és nem produkálta a kellő teljesítményt, pedig egyszerű feladatnak tűnt. Aztán megjelent a coredns, amelyre áttértünk, és nem volt bánat, később ez lett az alapértelmezett DNS szolgáltatás a K8s-ban. Valamikor 40 ezer rps-re nőttünk a DNS rendszerhez, és ez a megoldás is elégtelenné vált. De szerencsére kijött a Nodelocaldns, más néven csomóponti helyi gyorsítótár, más néven .
Miért használjuk ezt? A lényegben Linux Van egy hiba, amely akkor okozza a Conntrack NAT-on keresztül UDP-n keresztül indított több kérés versenyhelyzetet a Conntrack táblák bejegyzéseinél, és a NAT-on keresztüli forgalom egy része elveszik (a szolgáltatáson keresztüli minden ugrás NAT). A Nodelocaldns ezt a problémát úgy oldja meg, hogy kiküszöböli a NAT-ot, és TCP-re frissíti a kapcsolatot az upstream DNS-hez, valamint helyi gyorsítótárazással tárolja a DNS-kérések adatait az upstream DNS-hez (beleértve egy rövid, 5 másodperces negatív gyorsítótárat is).
5. Vízszintes és függőleges skálázása automatikusan
Biztosan állíthatja, hogy minden mikroszolgáltatása készen áll a terhelés két-háromszoros növekedésére? Hogyan lehet megfelelően hozzárendelni az erőforrásokat az alkalmazásokhoz? A munkaterhelésen túlmenően néhány pod futása felesleges lehet, de ezek egymás mellett tartása leállás kockázatával jár a szolgáltatás felé irányuló forgalom hirtelen megnövekedése miatt. Szolgáltatások, mint pl и .
VPA lehetővé teszi a podban lévő tárolók kérésének/korlátainak automatikus emelését a tényleges használattól függően. Hogyan lehet hasznos? Ha vannak olyan podjai, amelyek valamilyen oknál fogva nem skálázhatók vízszintesen (ami nem teljesen megbízható), akkor megpróbálhatja erőforrásainak módosítását a VPA-ra bízni. Jellemzője a metrika-szerver előzmény- és aktuális adatain alapuló ajánlási rendszer, így ha nem szeretné automatikusan megváltoztatni a kéréseket/korlátokat, egyszerűen figyelheti a konténerekhez ajánlott erőforrásokat, és optimalizálhatja a beállításokat a CPU és a CPU megtakarítása érdekében. memória a klaszterben.
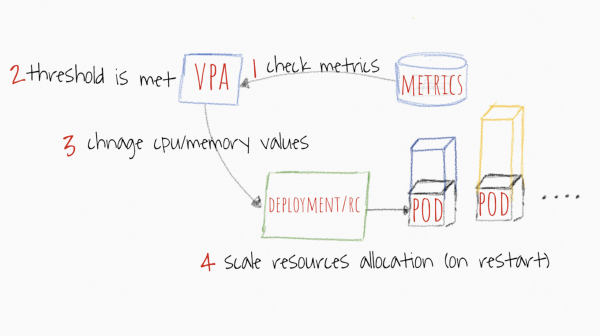 A kép innen származott: https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
A Kubernetes ütemezője mindig a kéréseken alapul. Bármilyen értéket adsz meg, az ütemező ez alapján keres egy megfelelő csomópontot. A határértékekre azért van szükség, hogy a kocka megértse, mikor kell fojtani vagy megölni a hüvelyt. És mivel az egyetlen fontos paraméter a kérések értéke, a VPA működik vele. Amikor egy alkalmazást függőlegesen méretez, meg kell határoznia, hogy melyek legyenek a kérések. Mi lesz akkor a korlátokkal? Ez a paraméter is arányosan lesz skálázva.
Például itt vannak a szokásos pod-beállítások:
resources:
   requests:
     memory: 250Mi
     cpu: 200m
   limits:
     memory: 500Mi
     cpu: 350m
Az ajánlómotor megállapítja, hogy az alkalmazásnak 300 m CPU-ra és 500 Mi-re van szüksége a megfelelő működéshez. A következő beállításokat kapja:
resources:
   requests:
     memory: 500Mi
     cpu: 300m
   limits:
     memory: 1000Mi
     cpu: 525m
Amint fentebb említettük, ez arányos skálázás a jegyzékben szereplő kérések/korlátok arányon alapul:
CPU: 200m → 300m: arány 1:1.75;
Memória: 250Mi → 500Mi: 1:2 arány.
vonatkozóan HPA, akkor átláthatóbb a működési mechanizmus. Az olyan metrikák, mint a CPU és a memória, küszöbértéket kapnak, és ha az összes replika átlaga meghaladja a küszöbértéket, az alkalmazás +1 alértékkel skálázódik, amíg az érték a küszöb alá nem esik, vagy amíg el nem éri a replikák maximális számát.
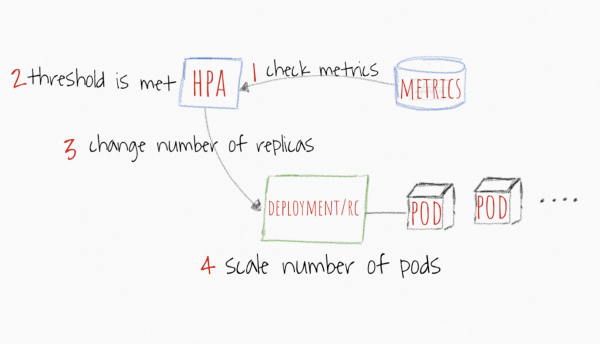 A kép innen származott: https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
A szokásos mérőszámokon, például a CPU-n és a memórián kívül beállíthat küszöbértékeket a Prometheus egyéni mérőszámaihoz, és együttműködhet velük, ha úgy gondolja, hogy ez a legpontosabb jelzés arra vonatkozóan, hogy mikor méretezheti az alkalmazást. Amint az alkalmazás a megadott metrikai küszöb alatt stabilizálódik, a HPA megkezdi a sorba rendezések leskálázását a replikák minimális számára, vagy amíg a betöltés el nem éri a megadott küszöbértéket.
6. Ne feledkezzünk meg a csomópont-affinitásról és a pod-affinitásról sem
Nem minden csomópont fut ugyanazon a hardveren, és nem minden podnak kell számításigényes alkalmazásokat futtatnia. A Kubernetes segítségével beállíthatja a csomópontok és pod-ok specializációját Csomópont-affinitás и Pod Affinity.
Ha olyan csomópontjai vannak, amelyek alkalmasak a számításigényes műveletekre, akkor a maximális hatékonyság érdekében jobb, ha az alkalmazásokat a megfelelő csomópontokhoz köti. Ehhez használja nodeSelector csomóponti címkével.
Tegyük fel, hogy két csomópontja van: az egyik CPUType=HIGHFREQ és nagyszámú gyors mag, egy másik MemoryType=HIGHMEMORY több memória és gyorsabb teljesítmény. A legegyszerűbb módja a központi telepítés hozzárendelése egy csomóponthoz HIGHFREQszakaszhoz való hozzáadásával spec ez a választó:
…
nodeSelector:
	CPUType: HIGHFREQ
Ennek drágább és specifikusabb módja a használata nodeAffinity mezőben affinity razdela spec. Két lehetőség van:
requiredDuringSchedulingIgnoredDuringExecution: kemény beállítás (az ütemező csak meghatározott csomópontokra telepíti a podokat (és sehol máshol));preferredDuringSchedulingIgnoredDuringExecution: soft beállítás (az ütemező megpróbálja a telepítést meghatározott csomópontokra, és ha ez nem sikerül, akkor megpróbálja a következő elérhető csomópontra telepíteni).
Megadhat egy adott szintaxist a csomópontcímkék kezeléséhez, mint pl In, NotIn, Exists, DoesNotExist, Gt vagy Lt. Ne feledje azonban, hogy a címkék hosszú listáiban alkalmazott összetett módszerek lelassítják a döntéshozatalt kritikus helyzetekben. Más szóval, legyen egyszerű.
Mint fentebb említettük, a Kubernetes lehetővé teszi az aktuális podok affinitásának beállítását. Ez azt jelenti, hogy bizonyos podokat együttműködhet más, ugyanabban a rendelkezésre állási zónában (felhőkre vonatkozó) vagy csomópontokkal.
В podAffinity mezők affinity razdela spec ugyanazok a mezők állnak rendelkezésre, mint a esetén nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution и preferredDuringSchedulingIgnoredDuringExecution. Az egyetlen különbség az matchExpressions egy olyan csomóponthoz köti a podokat, amelyen már fut az adott címkével ellátott pod.
A Kubernetes teret is kínál podAntiAffinity, amely éppen ellenkezőleg, nem köti a hüvelyt egy adott hüvelyekkel rendelkező csomóponthoz.
A kifejezésekről nodeAffinity Ugyanez a tanács adható: próbálja meg a szabályokat egyszerűnek és logikusnak tartani, ne próbálja túlterhelni a pod specifikációt összetett szabályokkal. Nagyon könnyű olyan szabályt létrehozni, amely nem egyezik a fürt feltételeivel, ami szükségtelen terhelést jelent az ütemezőre, és csökkenti az általános teljesítményt.
7. Tűrések és tűrések
Van egy másik módja az ütemező kezelésének. Ha egy nagy fürttel rendelkezik több száz csomóponttal és több ezer mikroszolgáltatással, akkor nagyon nehéz nem engedélyezni, hogy bizonyos podokat bizonyos csomópontokon hosztoljanak.
A szennyeződések mechanizmusa – a tiltó szabályok – segít ebben. Például bizonyos forgatókönyvek esetén megtilthatja bizonyos csomópontok sorba rendezését. Ha szennyeződést szeretne alkalmazni egy adott csomópontra, akkor ezt az opciót kell használnia taint in kubectl. Adja meg a kulcsot és az értéket, majd a szennyeződést NoSchedule vagy NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleAzt is érdemes megjegyezni, hogy a szennyeződési mechanizmus három fő hatást támogat: NoSchedule, NoExecute и PreferNoSchedule.
NoScheduleazt jelenti, hogy egyelőre nem lesz megfelelő bejegyzés a pod specifikációbantolerations, nem lesz telepíthető a csomóponton (ebben a példábannode10).PreferNoSchedule- egyszerűsített változatNoSchedule. Ebben az esetben az ütemező megpróbálja nem lefoglalni azokat a sorba rendezéseket, amelyeknek nincs egyező bejegyzésetolerationscsomópontonként, de ez nem szigorú korlátozás. Ha nincsenek erőforrások a fürtben, a sorba rendezések megkezdik a telepítést ezen a csomóponton.NoExecute- ez a hatás a megfelelő bejegyzéssel nem rendelkező hüvelyek azonnali evakuálását váltja kitolerations.
Érdekes módon ez a viselkedés megszüntethető a tolerancia mechanizmussal. Ez akkor kényelmes, ha van egy „tiltott” csomópont, és csak infrastrukturális szolgáltatásokat kell elhelyeznie rajta. Hogyan kell csinálni? Csak azokat a hüvelyeket engedje meg, amelyeknél megfelelő a tűréshatár.
Így nézne ki a pod specifikációja:
spec:
   tolerations:
     - key: "node-role.kubernetes.io/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Ez nem jelenti azt, hogy a következő újratelepítés erre az adott csomópontra esik, ez nem a csomóponti affinitási mechanizmus és nodeSelector. De több funkció kombinálásával nagyon rugalmas ütemezési beállításokat érhet el.
8. Állítsa be a pod telepítési prioritást
Csak azért, mert a csomópontokhoz sorba rendezések vannak hozzárendelve, még nem jelenti azt, hogy az összes sorba rendezést azonos prioritással kell kezelni. Előfordulhat például, hogy egyes podokat a többi előtt telepíthet.
A Kubernetes különböző módokat kínál a pod prioritás és az elővásárlás konfigurálására. A beállítás több részből áll: objektum PriorityClass és mezőleírások priorityClassName a pod specifikációjában. Nézzünk egy példát:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "This priority class should be used for very important pods only"
Mi alkotunk PriorityClass, adjon neki nevet, leírást és értéket. A magasabb value, annál magasabb a prioritás. Az érték bármely 32 bites egész szám lehet, amely kisebb vagy egyenlő, mint 1 000 000 000. A magasabb értékek a kritikus rendszerelemek számára vannak fenntartva, amelyeket általában nem lehet megelőzni. Az elmozdulás csak akkor következik be, ha egy magas prioritású podnak nincs helye megfordulni, akkor egy bizonyos csomópontból néhány pod kiürül. Ha ez a mechanizmus túl merev az Ön számára, hozzáadhatja a lehetőséget preemptionPolicy: Never, és akkor nem lesz elővásárlás, a pod először áll a sorban, és várja, hogy az ütemező találjon hozzá szabad erőforrásokat.
Ezután létrehozunk egy pod-ot, amelyben feltüntetjük a nevet priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Annyi prioritási osztályt hozhat létre, amennyit csak akar, bár ajánlott, hogy ezzel ne ragadjon el (mondjuk, korlátozza magát alacsony, közepes és magas prioritásúra).
Így szükség esetén növelheti a kritikus szolgáltatások, például az nginx-ingress-controller, a coredns stb. telepítésének hatékonyságát.
9. Optimalizálja az ETCD-fürtöt
Az ETCD-t az egész klaszter agyának nevezhetjük. Nagyon fontos ennek az adatbázisnak a működését magas szinten tartani, hiszen ettől függ a Cube-ban a műveletek sebessége. Meglehetősen szabványos és egyben jó megoldás az ETCD-fürt megtartása a fő csomópontokon, hogy minimális késleltetést érjen el a kube-apiserver. Ha ezt nem tudja megtenni, helyezze az ETCD-t a lehető legközelebb, jó sávszélességgel a résztvevők között. Ügyeljen arra is, hogy az ETCD-ből hány csomópont eshet ki anélkül, hogy kárt tenne a fürtben
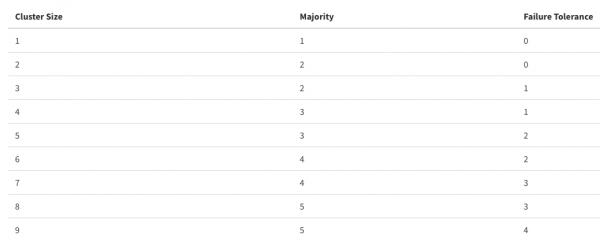
Ne feledje, hogy a klaszter taglétszámának túlzott növelése növelheti a hibatűrést a teljesítmény rovására, mindennek mérsékelten kell lennie.
Ha a szolgáltatás beállításáról beszélünk, néhány javaslat van:
Legyen jó hardvered a fürt mérete alapján (elolvashatod ).
Módosítson néhány paramétert, ha egy klasztert osztott ki pár DC vagy a hálózat között, és a lemezek sok kívánnivalót hagynak maguk után (olvashatja ).
Következtetés
Ez a cikk azokat a pontokat ismerteti, amelyeknek csapatunk megpróbál megfelelni. Ez nem a műveletek lépésenkénti leírása, hanem olyan lehetőségek, amelyek hasznosak lehetnek a fürt többletterhelésének optimalizálásához. Nyilvánvaló, hogy minden fürt egyedi a maga módján, és a konfigurációs megoldások nagyon eltérőek lehetnek, ezért érdekes lenne visszajelzést kapni arról, hogyan figyeli a Kubernetes-fürtöt és hogyan javítja a teljesítményét. Ossza meg tapasztalatait a megjegyzésekben, érdekes lesz tudni.
Forrás: will.com
