

Folytatom a történetem arról, hogyan barátkoztassuk össze az Exchange-t és az ELK-t (kezdete ). Emlékeztetnék, hogy ez a kombináció képes habozás nélkül kezelni nagyon nagy mennyiségű naplót. Ezúttal arról fogunk beszélni, hogyan állítsuk be az Exchange működését a Logstash és Kibana komponensekkel.
A Logstash az ELK stackben intelligens naplófeldolgozásra és az Elasticbe való dokumentumok formájában történő tárolásra szolgál, amely alapján különböző vizualizációk kényelmesen létrehozhatók a Kibana-ban.
Telepítés
Két szakaszból áll:
- Az OpenJDK csomag telepítése és konfigurálása.
- A Logstash csomag telepítése és konfigurálása.
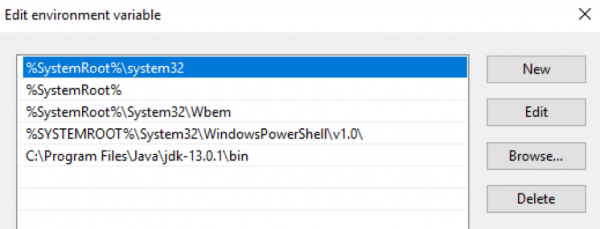
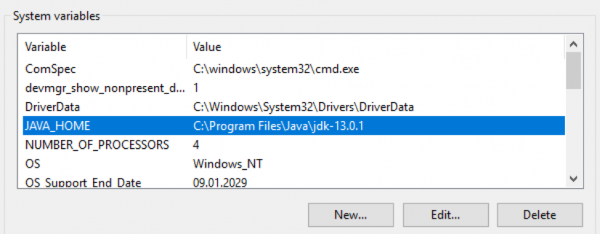
Az OpenJDK csomagot le kell tölteni és ki kell csomagolni egy meghatározott könyvtárba. Ezután az ehhez a könyvtárhoz való elérési utat fel kell venni a Windows operációs rendszer $env:Path és $env:JAVA_HOME környezeti változói közé:
Ellenőrizzük a Java verziót:
PS C: java -version openjdk version "13.0.1" 2019-10-15 OpenJDK Runtime Environment (build 13.0.1+9) OpenJDK 64-Bit Server VM (build 13.0.1+9, mixed mode, sharing)
A Logstash csomag telepítése és konfigurálása
A Logstash disztribúcióval rendelkező archív fájlt töltse le
. Az archívumot a meghajtó gyökerébe kell kicsomagolni. Nem ajánlott a kicsomagolás egy mappába C:Program Files , Logstash nem fog normálisan elindulni. Ezután módosítani kell a fájlt jvm.options , amely a Java folyamat számára a memóriakiosztást határozza meg. Azt javaslom, hogy a szerver RAM-jának felét állítsa be. Ha 16 GB RAM van a gépen, akkor az alapértelmezett kulcsok: -Xms1g -Xmx1g
helyett a következőre kell cserélni:
-Xms8g -Xmx8g
Ezen kívül érdemes kikapcsolni a következő sort:
-XX:+UseConcMarkSweepGC . Bővebb információ erről. A következő lépés a logstash.conf fájlban a default konfiguráció létrehozása: input { stdin{} } filter { } output { stdout { codec = "rubydebug" } }
Ezekkel a konfigurációkkal a Logstash adatokat olvas a konzolból, átengedi egy üres szűrőn, és visszaadja a konzolnak. Ennek a konfigurációnak a alkalmazása lehetővé teszi a Logstash működésének tesztelését. Ehhez indítsuk el interaktív módban:
PS C:...bin .logstash.bat -f .logstash.conf ... [2019-12-19T11:15:27,769][INFO ][logstash.javapipeline ][main] Pipeline started {"pipeline.id"="main"} A stdin plugin már várja a bemenetet: [2019-12-19T11:15:27,847][INFO ][logstash.agent ] Pipelines running {:count=1, :running_pipelines=[:main], :non_running_pipelines=[]} [2019-12-19T11:15:28,113][INFO ][logstash.agent ] A Logstash API végpont sikeresen elindult {:port=9600}
A Logstash sikeresen elindult a 9600-as porton.
A telepítés utolsó lépése: a Logstash indítása Windows szolgáltatásként. Ezt például a
NSSM :
PS C:...bin> .nssm.exe install logstash
A "logstash" szolgáltatás sikeresen telepítve!
Hibatűrés
A naplók megőrzése az eredeti szerverről történő átvitel során a Persistent Queues mechanizmus által biztosított.
Hogyan működik
A naplók feldolgozási folyamatában a sorok elhelyezkedésének sémája: input → queue → filter + output.
Az input plugin adatokat kap a naplók forrásából, amelyek egy sorba íródnak, és visszaigazolást küldenek a forrásnak az adatok átvételéről.
A sorból származó üzeneteket a Logstash dolgozza fel, átmennek a szűrőn és az output pluginen. Amikor az output-tól megkapja a napló elküldésének visszaigazolását, a Logstash eltávolítja a feldolgozott naplót a sorból. Ha a Logstash leáll, minden feldolgozatlan üzenet és olyan üzenet, amire nem érkezett visszaigazolás az elküldésről, a sorban marad, és a Logstash a következő indításkor folytatja a feldolgozásukat.
Beállítás
A fájlban megadott kulcsokkal szabályozható C:Logstashconfiglogstash.yml:
queue.type: (lehetséges értékek —persistedésmemory (alapértelmezett)).path.queue: (a sor fájljainak mappájához vezető út, amely alapértelmezetten a C:Logstashqueue-ban tárolódik).queue.page_capacity: (a sor maximális oldalmérete, az alapértelmezett érték — 64mb).queue.drain: (true/false — a Logstash leállítása előtti sorfeldolgozás leállítását engedélyezi/tiltja. Nem ajánlom bekapcsolni, mert ez közvetlen hatással van a szerver leállításának sebességére).queue.max_events: (a sorban legfeljebb lévő események száma, az alapértelmezett — 0 (nincs korlátozva)).queue.max_bytes: (a sor legnagyobb mérete byte-ban, az alapértelmezett érték — 1024mb (1gb)).
Ha be van állítva queue.max_events és queue.max_bytes, akkor a sorba való üzenetfogadás leáll, amint bármelyik ezek közül a beállítások közül elérik az értéket. Részletesebben a Persistent Queues-ról van szó .
A logstash.yml egy részének példája, amely a sor beállításáért felelős:
queue.type: persisted
queue.max_bytes: 10gb
Beállítás
A Logstash konfigurációja általában három részből áll, amelyek a bejövő naplók feldolgozásának különböző fázisaiért felelősek: fogadás (input szekció), elemzés (filter szekció) és elküldés az Elastic-be (output szekció). Lent részletesebben megnézzük mindegyiket.
Bemeneti
A nyers naplók bejövő áramlását a filebeat ügynökök fogadják. Ezt a plugint jelöljük meg az input szekcióban:
input {
  beats {
    port => 5044
  }
}
Ezeket a beállításokat követően a Logstash elkezdi figyelni az 5044-es portot, és az érkező naplókat a filter szekció beállításai szerint dolgozza fel. Szükség esetén a filebeat-től érkező naplók átvitelét SSL-be burkolhatjuk. Részletesebb információ a beats plugin beállításairól .
Filter
Minden érdekes szöveges napló, amelyet az Exchange generál, CSV formátumban van, aznapló fájlban leírt mezőkkel. A CSV bejegyzések feldolgozásához a Logstash három plugint kínál: , csv és grok. Az első a leg , de csak a legegyszerűbb naplók feldolgozására képes.
Például a következő bejegyzést két részre bontja (mivel a mezőn belül vessző található), ami miatt a napló helytelenül kerül feldolgozásra:
…,"MDB:GUID1, Mailbox:GUID2, Event:526545791, MessageClass:IPM.Note, CreationTime:2020-05-15T12:01:56.457Z, ClientType:MOMT, SubmissionAssistant:MailboxTransportSubmissionEmailAssistant",…
Használható IIS naplók feldolgozásához is. Ebben az esetben a filter szekció így nézhet ki:
filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
    }
  }
}
A Logstash konfiguráció lehetővé teszi , ezért a dissect pluginba csak azokat a naplókat irányíthatjuk, amelyeket a filebeat "IIS" címkével jelöltek meg. IIS. A plugin belsejében a mezők értékeit a nevükhöz rendeljük, eltávolítjuk az eredeti mezőt, üzenet, amely a naplóbejegyzést tartalmazta, és hozzáadhatunk egy szabadon választott mezőt, amely például a gyűjtéshez használt alkalmazás nevét tartalmazhatja.
A követés naplóinál jobb a csv plugin használata, mivel az képes helyesen kezelni a bonyolult mezőket:
filter {
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
}
A plugin belsejében a mezők értékeit a nevükhöz rendeljük, eltávolítjuk az eredeti mezőt üzenet (és a tenant-id és schema-version), amely a naplóbejegyzést tartalmazta, és hozzáadhatunk egy szabadon választott mezőt, amely például a gyűjtéshez használt alkalmazás nevét tartalmazhatja.
A szűrési szakaszból kilépve az első közelítésben dokumentumokat kapunk, amelyek készen állnak a Kibana vizualizációjára. A következőkre lesz szükségünk:
- A numerikus mezők szövegként lesznek értelmezve, ami megakadályozza a velük való műveletek végrehajtását. Nevezetesen, a mezők
time-takenaz IIS naplóból, valamint a mezőkrecipient-countéstotal-bitesa Tracking naplóból. - A dokumentum standard időbélyege a napló feldolgozási idejét fogja tartalmazni, nem pedig a szerveroldali írás idejét.
- Mező
recipient-addressegy sorozatnak tűnik, ami megnehezíti a címzettek számának elemzését.
Itt az ideje, hogy egy kis varázslatot vigyünk a naplófeldolgozásba.
A numerikus mezők konvertálása
A dissect plugin rendelkezik egy opcióval convert_datatype, amelyet szöveges mező számformátumra való konvertálására használhatunk. Például így:
dissect {
  …
  convert_datatype => { "time-taken" => "int" }
  …
}
Fontos megjegyezni, hogy ez a módszer csak akkor alkalmazható, ha a mező biztosan egy sztringet tartalmaz. A null értékeket a mezők nem dolgozza fel, és kivételt vált ki.
A tracking naplók esetében nem ajánlott a hasonló convert módszer használata, mivel a mezők recipient-count és total-bites üresen maradhatnak. Az ilyen mezők konvertálásához jobban a :
mutate {
  convert => [ "total-bytes", "integer" ]
  convert => [ "recipient-count", "integer" ]
}
A recipient_address címzettekre bontása
Ezt a feladatot a mutate plugin segítségével is megoldhatjuk:
mutate {
  split => ["recipient_address", ";"]
}
Az időbélyeg módosítása
A tracking naplók esetében a feladat nagyon egyszerűen megoldható a , amely segít a timestamp dátum és idő megfelelő formátumában való rögzítésében a date-time:
date {
  match => [ "date-time", "ISO8601" ]
  timezone => "Europe/Moscow"
  remove_field => [ "date-time" ]
}
A IIS naplók esetében szükségünk lesz a mezők adatainak összekapcsolására date és time a mutate plugin segítségével, a szükséges időzóna megadására, és az időbélyeg a következő módon történő elhelyezésére: timestamp a date plugin segítségével:
mutate {
  add_field => { "data-time" => "%{date} %{time}" }
  remove_field => [ "date", "time" ]
}
date {
  match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
  timezone => "UTC"
  remove_field => [ "data-time" ]
}
Kimeneti
A kimeneti szakasz a feldolgozott naplók logfogadóba történő küldésére szolgál. Ha közvetlenül az Elasticbe küldjük, akkor a plugin használata szükséges, , ahol meg kell adni a szerver címét és az index név sablonját a létrehozott dokumentum küldéséhez:
output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Végső konfiguráció
A végső konfiguráció a következőképpen fog kinézni:
input {
  beats {
    port => 5044
  }
}

filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
      convert_datatype => { "time-taken" => "int" }
    }
    mutate {
      add_field => { "data-time" => "%{date} %{time}" }
      remove_field => [ "date", "time" ]
    }
    date {
      match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
      timezone => "UTC"
      remove_field => [ "data-time" ]
    }
  }
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
    mutate {
      convert => [ "total-bytes", "integer" ]
      convert => [ "recipient-count", "integer" ]
      split => ["recipient_address", ";"]
    }
    date {
      match => [ "date-time", "ISO8601" ]
      timezone => "Europe/Moscow"
      remove_field => [ "date-time" ]
    }
  }
}

output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Hasznos linkek:
Forrás: habr.com
