

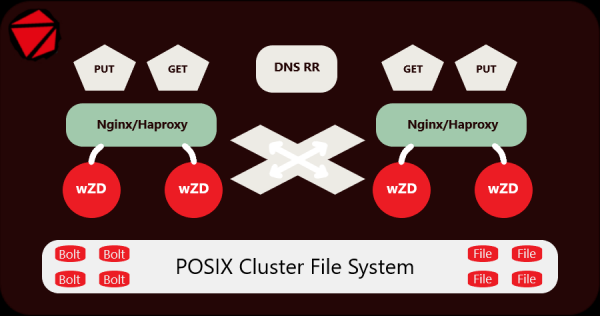
Tisztelt közösség, ez a cikk a több százmillió kis fájl hatékony tárolására és kiadására összpontosít. Ezen a ponton egy végső megoldás javasolt a POSIX kompatibilis fájlrendszerekhez, teljes blokkolási támogatással, beleértve a klaszteres megoldásokat is, és úgy tűnik, már csúsztatások nélkül.
Ezért erre a célra írtam egy saját speciális szervert.
A feladat megvalósítása során sikerült megoldani a fő problémát, miközben elértük a lemezterület és a RAM megtakarítást is, amit a klaszteres fájlrendszerünk kegyetlenül igényelt. Valójában ekkora számú fájl káros bármilyen klaszteres fájlrendszer számára.
Az ötlet a következő:
Egyszerűen fogalmazva, a szerveren keresztül kicsi fájlokat töltenek fel, amelyek közvetlenül archívumba kerülnek, és onnan olvassák ki őket, míg a nagy fájlok mellett helyezkednek el. Sémánk: 1 mappa = 1 archívum, így egymilliók vannak archívumokkal kicsi fájlokkal, nem pedig több százmillió fájllal. Ráadásul mindez teljes mértékben megvalósított, mindenféle szkript és fájlok tar/zip archívumokba helyezése nélkül.
Megpróbálom röviden összefoglalni, előre is elnézést, ha a poszt terjedelmes lesz.
Minden azzal kezdődött, hogy nem találtam megfelelő szervert a világban, amely közvetlenül az archívumokba tudná tárolni a HTTP protokollon keresztül érkező adatokat, anélkül, hogy a hagyományos archívumok és objektumtárolók hiányosságait tapasztaltam volna. A keresés oka a 10 szerverből álló Origin klaszter volt, amely már 250,000,000 kis fájlt halmozott fel, és a növekedés tendenciája sem akarta megszakítani.
Annál, aki nem szereti a cikkeket, és akinek a rövid dokumentáció egyszerűbb:
és .
És a docker is, most van egy lehetőség csak nginx-szel együtt, minden esetre:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Tovább:
Ha sok fájl van, jelentős erőforrásokra van szükség, ami a legrosszabb, hogy ezek egy része hasztalanul elveszik. Például egy klaszteres fájlrendszer (ebben az esetben a MooseFS) használatakor a fájl, függetlenül a tényleges méretétől, mindig legalább 64 KB-ot foglal el. Ez azt jelenti, hogy 3, 10 vagy 30 KB méretű fájlok esetén a merevlemezen 64 KB-ot igényelnek. Ha a fájlok száma negyed milliárd, akkor 2-10 terabájtot veszítünk el. Az új fájlok végtelenségig történő létrehozása nem lehetséges, mert a MooseFS-ben korlátozás van: nem lehet több mint 1 milliárd példánya minden fájlnak.
A fájlok számának növekedésével nagy mennyiségű RAM-ra van szükség a metaadatokhoz. A gyakori nagy metaadat dumpok is hozzájárulnak az SSD meghajtók elhasználódásához.
wZD szerver. Rendet rakunk a merevlemezeken.
A szerver Go nyelven készült. Először is, csökkenteni kellett a fájlok számát. Hogyan tehetem ezt? Archíválással, de ebben az esetben tömörítés nélkül, mert a fájljaim tömörített képek. A BoltDB segített, amit még a hátrányaitól meg kellett szabadítani, ez a dokumentációban szerepel.
Így a negyed milliárd fájl helyett az én esetemben csak 10 millió Bolt archívum maradt. Ha lehetőségem lett volna megváltoztatni a könyvtárak fájlokkal történő jelenlegi struktúráját, akkor körülbelül 1 millió fájlra tudtam volna csökkenteni.
Minden apró fájl Bolt archívumokba kerül, automatikusan felvéve a könyvtárak neveit, amelyekben találhatók, míg minden nagy fájl közvetlenül az archívumok mellett marad, nincs értelme őket becsomagolni, ez testre szabható. A kicsiket archiváljuk, a nagyokat változatlanul hagyjuk. A szerver átláthatóan működik mindkettővel.
A wZD szerver architektúrája és jellemzői.
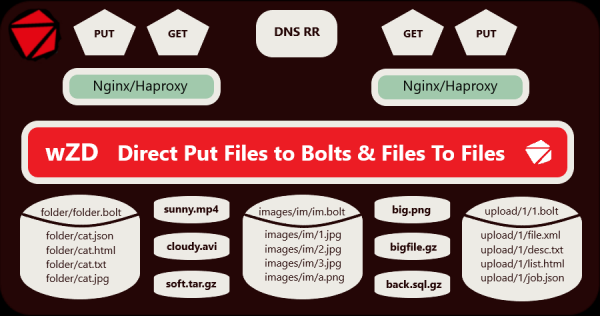
A szerver Linux, BSD, Solaris és OSX operációs rendszerek alatt működik. Én csak AMD64 architektúrával teszteltem Linux alatt, de ARM64, PPC64, MIPS64 rendszerekhez is megfelelőnek kell lennie.
Főbb jellemzők:
- Többszálúság;
- Több szerver támogatása, amely biztosítja a hibatűrést és a terhelés egyensúlyozását;
- Maximális átláthatóság a felhasználó vagy fejlesztő számára;
- Támogatott HTTP-módszerek: GET, HEAD, PUT és DELETE;
- A viselkedés vezérlése olvasás és írás során kliensfejlécek által;
- Rugalmasan konfigurálható virtuális hostok támogatása;
- CRC adatintegritás támogatás írásnál/olvasásnál;
- Fél-dinamikus pufferek a memória minimális fogyasztásához és az optimális hálózati teljesítmény beállításához;
- Késleltetett adatok tömörítése;
- Továbbá a wZA több szálon futó archiváló is felajánlásra kerül, amely lehetővé teszi a fájlok migrálását a szolgáltatás leállítása nélkül.
Valós tapasztalat:
Hosszú ideig fejlesztettem és teszteltem a szervert és az archiválót élő adatokkal, most már sikeresen működik egy 250,000,000 kis fájlt (képeket) tartalmazó klaszterben, amely 15,000,000 könyvtárban van elhelyezve, külön SATA meghajtókon. A 10 szerverből álló klaszter egy Origin-szerver, amely a CDN-hálózat mögött található. A karbantartására 2 Nginx szerver + 2 wZD szerver használatos.
Annál, aki ezt a szervert használni kívánja, érdemes megterveznie a könyvtárszerkezetet, ha ez alkalmazható. Azonnal megjegyzem, hogy a szerver nem arra lett kitalálva, hogy mindent egy Bolt archívumba tömörítsünk.
Teljesítménytesztelés:
Minél kisebb a tömörített fájl mérete, annál gyorsabban valósulnak meg a GET és PUT műveletek. Összehasonlítjuk a HTTP kliens által a szokásos fájlokba és a Bolt archívumokba írt teljes időt, valamint az olvasást. A 32 KB, 256 KB, 1024 KB, 4096 KB és 32768 KB méretű fájlokkal végzett munka összehasonlítása zajlik.
Bolt archívumok használatakor minden fájl adatainak integritását (CRC-t használva) ellenőrizzük, írás előtt és után pedig azonnali olvasásra és újraszámításra kerül sor. Ez természetesen késleltetéseket eredményez, de a lényeg a biztonság.
Teljesítményteszteket SSD-meghajtókon végeztem, mivel a SATA-meghajtókon végzett tesztek nem mutatnak egyértelmű különbséget.
A tesztelési eredmények grafikonjai:
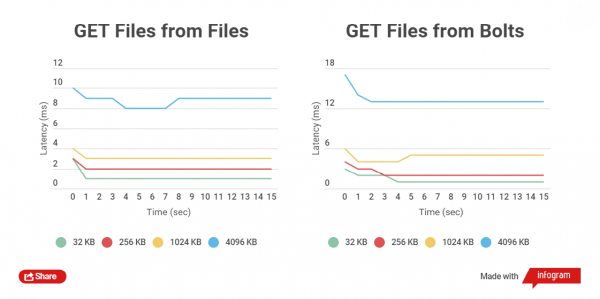
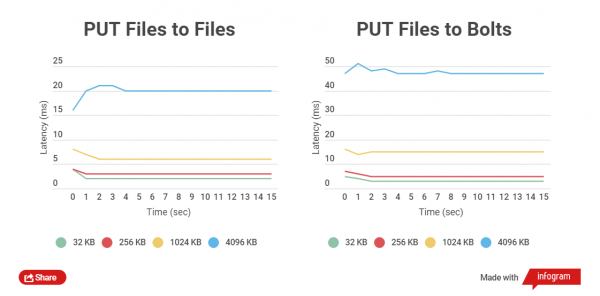
Ahogy látható, a kis fájlok esetében az archív és nem archív fájlok közötti olvasási és írási idő különbsége csekély.
Teljesen más képet kapunk, ha 32 MB méretű fájlok olvasásának és írásának tesztelésére kerül sor:
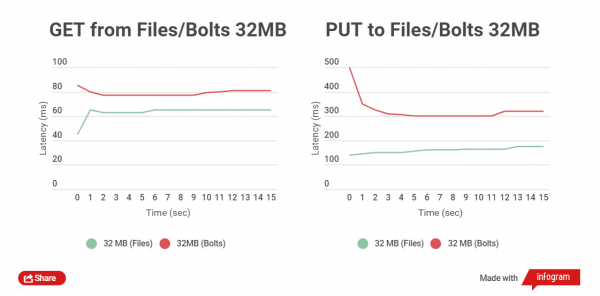
Az olvasási idő különbsége a fájlok között 5-25 ms között van. Az írással viszont rosszabb a helyzet, a különbség körülbelül 150 ms. De ebben az esetben nem szükséges nagy fájlokat feltölteni, ennek egyszerűen nincs értelme, külön élhetnek az archívumoktól.
*Technikailag ez a szerver NoSQL feladatokhoz is használható.
A wZD szerverrel való munka fő módszerei:
Standard fájl feltöltése:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgFájl feltöltése a Bolt archívumba (ha nem lépi túl a szerver beállításait, ami meghatározza a fájl maximális méretét, ami az archívumba kerülhet; ha túllépi, a fájl a megszokott módon, az archívum mellett tölthető fel):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgFájl letöltése (ha a lemezen és az archívumban azonos nevű fájlok találhatók, a letöltés során az alapértelmezett prioritás az archívumon kívüli fájlra esik):
curl -o test.jpg http://localhost/test/test.jpgFájl letöltése a Bolt archívumból (kényszerített módon):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgA többi módszer leírása a dokumentációban található.
A szerver jelenleg csak HTTP protokollt támogat, HTTPS nem működik. POST módszert sem támogatunk (még nem döntöttük el, hogy szükséges-e).
Aki belemerül a forráskódba, megtalálja benne a karamellt, amit nem mindenki szeret, de én nem kötöttem az alap kódot a webkeretrendszer funkcióira, kivéve a megszakításkezelőt, így később bármilyen motorra gyorsan át tudom írni.
Teendők:
- Saját replikátor és disztribútor fejlesztése + geó lehetőségek nagy rendszerek használatához, klaszteralapú fájlrendszerek nélkül (Mindez komoly módon)
- Teljes visszanyerési lehetőség a metaadatok teljes elvesztése esetén (disztribútor használata esetén)
- Natív protokoll a tartós hálózati kapcsolatok lehetősége érdekében és meghajtók különböző programozási nyelvekhez
- Kibővített lehetőségek NoSQL összetevő használatára
- Különböző típusú tömörítések (gzip, zstd, snappy) fájlok vagy Bolt archívumokban lévő értékek, valamint a normál fájlok esetében
- Különböző típusú titkosítások fájlok vagy értékek számára Bolt archívumokban és normál fájlokban
- Késleltetett szerveroldali videókonverzió, beleértve a GPU-t is
Nálam ennyi, remélem, ez a szerver hasznos lesz valakinek, BSD-3 licenc, duplázott szerzői jog, mivel ha nem lett volna a cég, ahol dolgozom, nem írtam volna meg a szervert. Én vagyok az egyetlen fejlesztő. Hálás lennék a felfedezett hibákért és a funkciónyújtási kérelmekért.
Forrás: habr.com
