

Amikor a steganográfiáról beszélünk, az emberek terroristákat, pedofileket, kémeket, legjobb esetben kripto-anarchistákat és más tudósokat képzelnek el. És valóban, kinek lehet még szüksége elrejteni valamit a külső szemek elől? Milyen haszna lehet ebből egy átlagembernek?
Kiderül, hogy van valami haszongal. Éppen ezért ma a steganográfia módszereivel fogunk adatokat tömöríteni. A végén pedig az olvasó akár a saját értékes JPEG archívumait is felhasználhatja a fájlrendszer szabad gigabájtjainak növelésére.
Mi?
Ha az olvasó emlékszik, a steganográfia olyan furcsa algoritmusokat jelöl, amelyek lehetővé teszik egy információ meglétének elrejtését egy másikban. Más szóval: kép + fájl == körülbelül ugyanaz a kép, de nem egészen (a képek helyett bármi lehet, de szokás szerint ezeken jobban érthető). Nem szabadna egyszerű módot találni arra, hogy megállapítsuk, van-e valami belül vagy sem.
De ha nem lehet megkülönböztetni egyet a másiktól, van-e egyáltalán különbség? A fogyasztó, felhasználó szempontjából a matematikai precizitás (amely egy adott bitkészlettel tükröződik) nem számít, csak az, amit észlel.
Például nézzünk meg három képet egy aranyos kutyáról:
Vigyázz, JPEG!
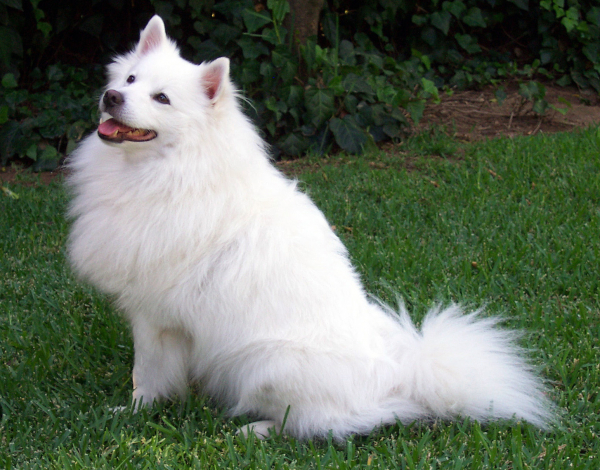
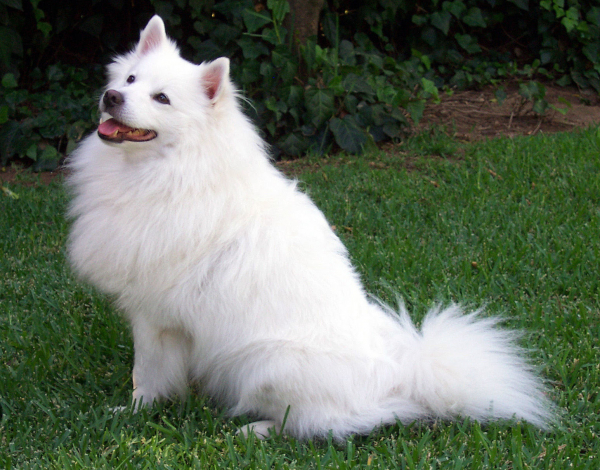
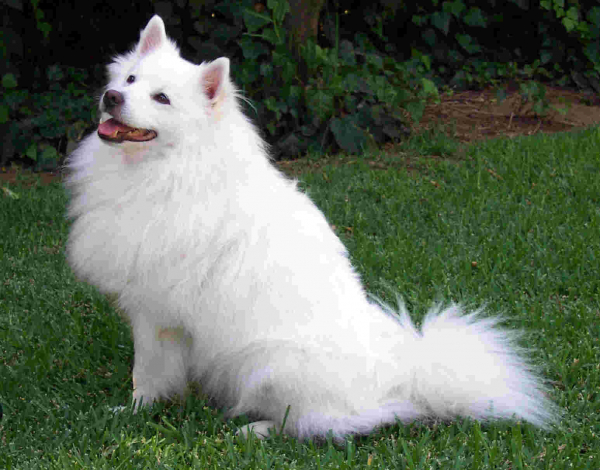
Mal nagy eltérés van a méret között, kevesen választanák a harmadik változatot. Másrészt az első két fénykép között a különbség nem annyira észlelhető, és az információ mennyiségét (személyes véleményem szerint) egyenlőnek lehet tekinteni.
Ez az elv önmagában már régi és éveken át aktívan kihasználják a veszteséges tömörítési módszerekkel. De rombolni könnyebb, mint építeni, minket a kérdés fejlettebb oldala érdekel. Be lehet-e ágyazni kiegészítő információt egy fájlba úgy, hogy annak mérete N növekedjen M < N, és a változások a felhasználó számára ne legyenek észlelhetők?
Természetesen lehetséges. De érdemes azonnal néhány fenntartást tenni:
- Elsősorban a módszernek univerzálisnak kell lennie, és a legtöbb bemeneten pozitív eredményt kell adnia. Ez azt jelenti, hogy átlagosan, véletlenszerű bemenetek esetén a tárolt információ mennyisége ténylegesen csökken. Az 'átlagosan' azt jelenti, hogy ellentétes esetek előfordulhatnak, de nem szabad dominálniuk.
- Másodszor, a tömörített konténer méretének a beágyazás előtt nagyobbnak kell lennie, mint az ennek megfelelően tömörített módosítása. Csak annyi bitet beleágyazni a BMP képekbe LSB módszerrel – nem számít steganográfiai tömörítésnek, mivel, ha egy DEFLATE-en átfuttatják, az eredeti kép valószínűleg észlelhetően kisebb lesz.
- Harmadszor, az eredményeket a klasszikus módszerekkel már tömörített adatokhoz viszonyítva kell végezni és összehasonlítani. Ez lehetővé teszi a redundancia valószínűségi hatásának kiküszöbölését és a tömörítés hatékonyabb elvégzését általánosan.
Hol?
A steganográfia használata azt jelenti, hogy a tömörítendő információn kívül szükségünk lesz olyan konténerekre, amelyekbe beágyazzuk azt. A beágyazható információ maximális mennyisége nagymértékben függ az egyes tulajdonságoktól, de sokkal egyszerűbben skálázható a számukkal. Ezért a konténerformátumnak elterjedtnek kell lennie, hogy a felhasználónak elegendő mennyiség álljon rendelkezésére a „tömörítési” folyamat valamiféle haszna érdekében.
Ebben a kontextusban a grafikai, audio- és videofájlok lesznek a legjobb jelöltek. Azonban a különböző formátumok, kodekek stb. változatossága miatt a gyakorlatban a lehetőségek száma nem olyan nagy.
Mindezeket figyelembe véve, az én választásom a JPEG-re esett. Szinte mindenkinek van ilyen, széles körben használják a személyes és üzleti célokra egyaránt, és szinte de facto formátum a legtöbb kép számára.
K̶o̶g̶d̶a̶ Hogyan?
Ezután körüli és technikai schemák és leírások következnek különösebb magyarázat nélkül, ezért akik szeretnék, átugorhatják őket a „Magas technológia” szakaszhoz való gurulásával.
Általános jellemzők
Az adatok beágyazásához először is meg kell határozni, hová. A fájlrendszeren számtalan különböző fénykép lehet, amelyek közül a felhasználó csak néhányat szeretne használni. Ezt a kívánt konténer halmazt nevezzük könyvtárnak.
Ez két esetben fordul elő: tömörítés előtt és kibővítés előtt. Az első esetben elegendő egy fájlnevek halmazának használata (vagy még jobb, ezekhez egy reguláris kifejezés), de a második esetben megbízhatóbb megoldásra van szükség: a felhasználó áthelyezheti és másolhatja azokat a fájlrendszeren belül, így nehéz őket pontosan meghatározni. Ezért szükséges tárolni a hasheket (az md5 elegendő) minden módosítás elvégzése után.
A reguláris kifejezéssel végzett kezdeti keresést nem érdemes az egész fájlrendszeren végezni, elegendő egy alapértelmezett könyvtár megadása. Ide fog eltárolódni egy speciális archív fájl, amely tartalmazza azokat a hasheket, valamint egyéb meta-információkat, amelyek szükségesek a tömörített információ későbbi visszaállításához.
Mindez egyaránt alkalmazható bármely alkalmazására bármely steganográfiai tömörítő algoritmusnak. A tömörítési és visszaállítási folyamatokat nevezhetjük csomagolásnak és kibővítésnek.
F5
Most, hogy világosvá vált, hogy mit csinálunk és miért, le kell írni az algoritmust a cél eléréséhez. Emlékezzünk a JPEG-fájl kódolásához kapcsolódó folyamatra (köszönet a Bauman Könyvtári Wikipédiának):
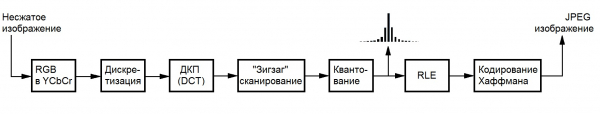
Rátekintve, érdemes néhány megjegyzést azonnal tenni:
- A JPEG-fájl mérete optimálisnak tekinthető, még a WinRAR-féle tömörítés megpróbálása nélkül is;
- Csak az tárolt információt (azt, ami a diszkrét koszinusz-transzformációnál (DCT) a kimeneten van) lehet módosítani, hogy bármilyen elfogadható teljesítményt biztosítsunk.
- Az adatok zajos felhasználói szintű elvesztésének elkerülése érdekében minimális módosításokat kell végrehajtani minden egyes képen;
Ezekhez a körülményekhez egy egész algoritmuscsalád illeszkedik, amelyről részletesen tájékozódhat . A legfejlettebb közülük a Andreas Westfeld által kifejlesztett algoritmus, amely a fényerő DCT-koefficienseivel dolgozik (az emberi szem a legkevésbé érzékeny ennek a változásaira). A meglévő JPEG-fájlokkal végzett munkájának általános sémája a következőképpen jelenik meg:
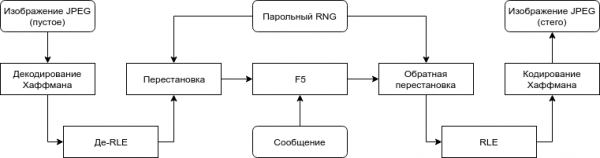
Az F5 blokk egy fejlett beágyazási módszert alkalmaz, amely a mátrix kódolásán alapul. A részletekkel és a maga algoritmussal a fenti linken ismerkedhet meg a kedves olvasó, minket pedig elsősorban az érdekel, hogy e segítségével annál kevesebb módosítást lehet végrehajtani egy és ugyanannyi információ beágyazásakor, minél nagyobb a használt konténer mérete, és az algoritmus végrehajtásához mindössze egyszerű (de)kódolási műveleteket kell végezni, beleértve a Huffman kódolást és az RLE-t.
A módosításokat a természetes számok koefficiensekkel végzik, és az értékük abszolút nagyságának csökkentésére korlátozódnak, ami lehetővé teszi, hogy a F5-öt adatok tömörítésére használjuk. Az a helyzet, hogy az abszolút nagyságban csökkentett koefficiens valószínűleg kevesebb bitet foglal majd el a Huffman kódolás után a JPEG értékek statisztikai eloszlása miatt.
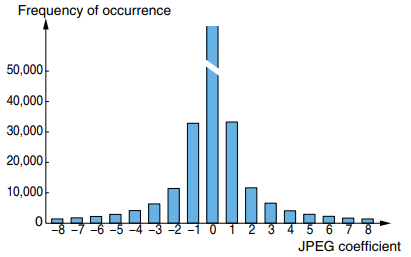
Ha nullás érték keletkezik (úgynevezett redukció), az eltárolt információ mennyisége a létrejött érték méretét csökkenti, mivel a korábban önálló koefficiens a kódolt RLE nullasorozat részévé válik:
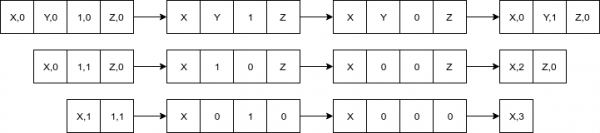
Módosítások
Az adatok védelme és tömörítése ortogonális feladatok, ezért figyelmen kívül hagyható az eredeti algoritmus titkos jelszavas permutációja. Sőt, tudnunk kell, hogyan lehet az adatokat visszaemelni, ezért minden szükséges információt (milyen konténereket használtak, milyen sorrendben stb.) külön fájlba kell rögzíteni, amely szabadon olvasható az archíváló program számára.
Az eredeti algoritmus titkos üzenetek átvitelére lett tervezve, ezért egyszerre csak egy konténerrel működik, feltételezve, hogy a felhasználónak magának kell majd részekre bontania azt, ha szükséges, ha egyáltalán felmerül. Továbbá, független beágyazás során minden konténerhez előre tudni kell, hogyan hány bit adata fér el benne. Ezért érdemes egyesíteni a könyvtár minden elemének koefficienseit egy nagy absztraktba, és azzal dolgozni az eredeti algoritmus szerint.
Mivel az eredeti F5 lehetővé teszi a tartály méretének akár 12%-át is használni, ez a módosítás szintén növeli a maximális kapacitást: az egész könyvtár méretének "akár 12%"-a nagyobb vagy egyenlő minden elemének "akár 12%"-nak az összegével.
A kódolt általános séma a következőképpen néz ki:
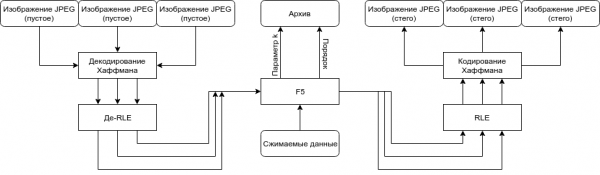
A algoritmus
Most le kell írni az algoritmust a kezdetektől a végéig, hogy ne tartsuk a kedves olvasót sötétben:
- A felhasználó a bináris tömöríthető M adatokat és az L könyvtárat egy reguláris kifejezés és a keresési gyökérkönyvtár segítségével határozza meg;
- A fájl rendszerén a könyvtár elemei alkotják az MC-t:
- A fájlból egy sor C koefficiens dekódolása történik;
- MC <- MC | C;
- A k paramétert a rémisztő egyenlőtlenség alapján határozzuk meg:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Soronként
n = (1 << k) - 1a nem-null elemek legkisebb bitejét az MC-ből és beírjuk a következőbe:a:- Számítjuk a varázslatos hash-funkciót
f, amely n-bites szótak-bitesres; - Ha
s == 0, akkor nincs szükség módosításra, és az algoritmus átmegy a következő koefficiensekhez; - Csökkenteni kell a koefficiens abszolút értékét, amely a
s-edik bit a szóbana; - Ha a csökkentés eredményeként a koefficiens 0-ra csökkent, akkor ismételjük meg a lépést az elejétől;
- Számítjuk a varázslatos hash-funkciót
- Minden koefficienst RLE és Huffman módszerrel kódolunk, és az eredeti fájlokba írjuk;
- A tömörített fájlba a k paraméter kerül beírásra;
- Minden L fájból az eredeti helyük sorrendjében MD5 hash-t számítanak, és ezt a tömörített fájlba írják.
Magas technológia
Az algoritmus naiv formája és más magas szintű (különösen a szemétgyűjtéssel rendelkező) nyelveken való megvalósítása szörnyű teljesítményt adna, ezért minden bonyolultságot tiszta C nyelven valósítottam meg, és számos optimalizálást hajtottam végre a végrehajtási sebesség és a memória terén (nem is tudja, mennyit nyomnak ezek a képek tömörítés nélkül még DCT-ig is). De így is, eleinte a végrehajtási sebesség nagyon kívánnivalót hagyott, ezért nem fogom leírni az egész folyamatot és a felhasznált módszereket.
A keresztplatformosság a libjpeg, pcre és tinydir könyvtárak kombinációjának felhasználásával valósult meg, ezért köszönet nekik. Alapértelmezés szerint minden a szokásos módon van fordítva, makeezért a Windows felhasználóknak szükségük van valamilyen Cygwin telepítésére, vagy saját Visual Studio és könyvtárak kezelésére.
A megvalósítás elérhető konzolos eszközként és könyvtárként. A legutóbbi használatával kapcsolatos részletekért a GitHub repóban található readme-t lehet megnézni, aminek a linkjét a poszt végén mellékelem. Most pedig térjünk rá a működés leírására és bemutatására.
Hogyan használható?
Óvatosan. A felhasznált képek szabadon áthelyezhetők, átnevezhetők és másolhatók. Azonban rendkívül óvatosnak kell lenni, és semmiképpen sem szabad megváltoztatni a tartalmukat. Egy bit megváltoztatása megsérti a hash-t, és lehetetlenné teszi az információ helyreállítását.
Tegyük fel, hogy a fordítás után kaptunk egy végrehajtható fájlt, f5ar. Elemezhetjük a könyvtár méretét a használati lehetőségek kiszámításához a zászló segítségével. -a: .\/f5ar -a [keresési mappa] [Perl-kompatibilis reguláris kifejezés]. A tömörítést a következő parancs végzi: .\/f5ar -p [keresési mappa] [Perl-kompatibilis reguláris kifejezés] [tömörített fájl] [archívum neve], míg a kicsomagolást a következőképpen végzi: .\/f5ar -u [archívum fájl] [helyreállított fájl neve].
A bemutató működése
A módszer hatékonyságának bemutatásához feltöltöttem egy 225 darab, teljesen ingyenes kutyás fényképből álló gyűjteményt a szolgáltatásból. Mindegyik kissé jobb minőségű, mint a szokásos felhasználói fényképek, de mégis. Mindegyiket a libjpeg segítségével reenkódolták, hogy ellensúlyozzák a könyvtár kódolási sajátosságainak hatását a teljes méretre. A legrosszabb példához a tömöríthető adatokkal dd-vel generáltak egy véletlenszerű 36 megás (kicsit több mint 5% az összes méretből) egyenletesen elosztott fájlt.
A tesztelési folyamat meglehetősen egyszerű:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ .\/f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Fájl tömörítése... rendben
Az archívum inicializálása... rendben
A könyvtár kapacitásának elemzése... kész 16.8s alatt
Megállapított valamilyen garantált kapacitás: 48439359 byte
Megállapított lehetséges kapacitás: legfeljebb 102618787 byte
Tömörítés... kész 32.6s alatt
Az archívum mentése... rendben

$ .\/f5ar -u dogs/dogs.f5ar unpacked
Az archívum inicializálása... rendben
Az archív fájl olvasása... rendben
Az archív fájlokkal való feltöltése... kész 1.2s alatt
Kicsomagolás... kész 17.5s alatt
Kivont adatok írása... rendben

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Vagy egy képernyőképpel azok számára, akik szeretik.
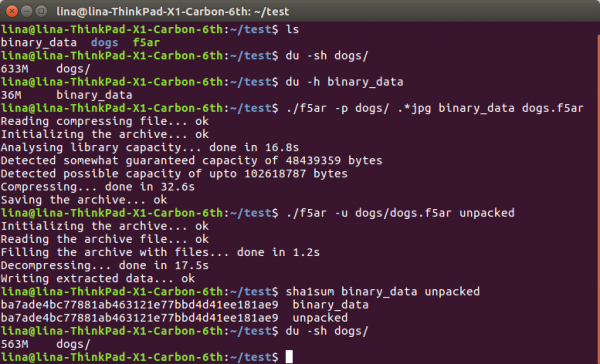
Ahogy látható, az eredeti 633 + 36 == 669 megabájt adathordozónkból 563 megabájt szabad helyre jutottunk, ami ~1,188 arányú tömörítést jelent. Ez a radikális különbség minimális veszteségekkel magyarázható, hasonlóan ahhoz, amit hagyományos JPEG-fájlok optimalizálása során érhetünk el (például tinyjpg által). Természetesen, a steganográfiai tömörítés során az információ nem egyszerűen „elveszik”, hanem más adatok kódolásához használják fel. Ráadásul az „optimalizált” koefficiens mennyisége az F5 használatával lényegesen kisebb, mint a hagyományos optimalizálás esetében.
Bármilyen módosítás is történik, a szem számára ezek egyáltalán nem észlelhetők. Az alábbi spoiler alatt az olvasó megítélheti a különbséget akár szemmértékkel, akár a módosított komponens értékeinek az eredetiből való levonásával (minél tompább a szín, annál kisebb a különbség):
Linkek a habrastorage-ra nem férő képekhez
Eredeti —
Módosított —
Különbség —
Összegzésként
Remélem, sikerült meggyőznöm az olvasót, hogy ezek a módszerek lehetségesek és helyük van az életben. Ugyanakkor egy merevlemez megvásárlása vagy egy további csatorna (hálózati átvitelhez) beszerzése sokkal egyszerűbb megoldásnak tűnhet, mint ilyen módon spórolni. Egyrészt valóban így van, a kiterjedt fejlődés gyakran könnyebb és megbízhatóbb. De másrészt ne feledkezzünk meg az intenzív fejlődésről sem. Végül is nincs garancia arra, hogy holnap bemehetünk a boltba, és vásárolhatunk egy újabb ezer terabájtos merevlemezt, míg a már otthon lévőket mindig fel lehet használni.
->
Forrás: habr.com
