

A cikk fordítása a kurzus megkezdése előtt készült .
Hogyan takaríthatunk meg a felhő költségeken a Kubernetes használata során? Nincs egyetlen helyes megoldás, de ebben a cikkben több eszköz kerül bemutatásra, amelyek segíthetnek hatékonyabban kezelni az erőforrásokat és csökkenteni a felhőalapú számítástechnikai költségeket.
Ezt a cikket az AWS-re vonatkozó Kubernetes szempontjából írtam, de szinte ugyanolyan módon alkalmazható más felhő szolgáltatókra is. Feltételezem, hogy a cluster(ek) már rendelkezik beállított automatikus skálázással (). Az erőforrások eltávolítása és a telepítés csökkentése csak akkor takarít meg költségeket, ha ez egyúttal csökkenti a munkacsomópontok (EC2 példányok) számát is.
A cikkben a következők kerülnek bemutatásra:
- a nem használt erőforrások tisztítása ()
- ), nem munkaidőben történő skálázás csökkentése ()
- ), horizontális automatikus skálázás (HPA),
- erőforrások fölösleges tartalékolásának csökkentése (, VPA)
- Spot példányok használata
A nem használt erőforrások tisztítása
Gyorsan változó környezetben dolgozni nagyszerű. Szeretnénk, ha a technikai szervezetek A gyorsabb szoftverszállítás nagyobb számú PR-telepítést, előzetes környezeteket, prototípusokat és analitikai megoldásokat is jelent. Minden Kubernetesre telepítve. Ki nézi a kézi tisztítást a teszttelepítésekhez? Könnyen el lehet felejteni egy hetes kísérlet eltávolítását. Az összeszerelési számlánk végül növekedni fog, mivel elfelejtettük bezárni:
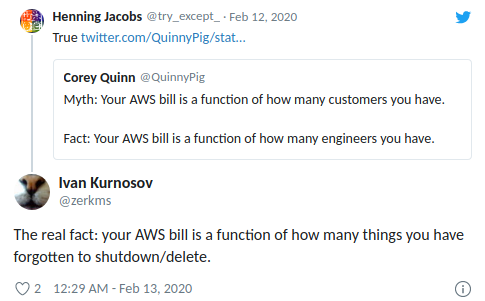
(Henning Jacobs:
Ez így van:
(idézi) Corey Quinn:
Mítosz: Az AWS számlád a felhasználóid számának függvényében alakul.
Tény: Az AWS számlád a mérnökeid számának függvényében alakul.
Ivan Kurnosov (válasz):
Valódi tény: Az AWS számlád a dolgok számának függvényében alakul, amelyeket elfelejtettél kikapcsolni/eltávolítani.)
(kube-janitor) segít kitisztítani a klaszteredet. A janitor konfiguráció rugalmas globális és helyi használatra is:
- A klaszterre vonatkozó általános szabályok meghatározhatják a maximális élettartamot (TTL – time-to-live) a PR/tesztelepítések számára.
- Különböző erőforrások annotálhatók janitor/ttl segítségével, például a spike/prototípus automatikus eltávolítására 7 nap múlva.
Az általános szabályokat egy YAML fájl határozza meg. Az útvonalát a paraméteren keresztül kell megadni --rules-file a kube-janitorban. Íme egy példa arra a szabályra, amely eltávolítja az összes névtér, amelyben -pr- a névben két nap múlva:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
A következő példa előírja az application címke használatát a Deployment és StatefulSet podoknál az összes új Deployment/StatefulSet esetében 2020-ban, ugyanakkor lehetővé teszi a címke nélküli tesztelések végrehajtását egy hétig:
- id: require-application-label
  # törölni a deployments és statefulsets címke nélkül "application"
  resources:
    - deployments
    - statefulsets
  # lásd: http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Korlátozott idejű demo futtatása 30 percig azon a klaszteren, ahol a kube-janitor működik:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Az állandó tárolók (AWS EBS) szintén egy másik forrása a növekvő költségeknek. A Kubernetes StatefulSet eltávolításakor nem törlődnek az állandó tárolók (PVC – PersistentVolumeClaim). A nem használt EBS kötetek könnyen havi több száz dolláros költségekhez vezethetnek. A Kubernetes Janitor funkcióval rendelkezik a nem használt PVC-k tisztítására. Például ez a szabály eltávolít minden PVC-t, amelyet nem szereltek fel és amelyre nem hivatkozik StatefulSet vagy CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
A Kubernetes Janitor segíthet abban, hogy a klasztered „tisztán” maradjon, és megakadályozza a lassan felhalmozódó felhőszolgáltatási költségeket. Az üzemeltetésre és a beállításra vonatkozó utasításokat a következő címen találod: .
Kicsinyítés munkaidőn kívül
A teszt- és köztes rendszerek általában csak munkaidőben szükségesek. Néhány termelési alkalmazás, mint például a back-office/adminisztrációs eszközök, szintén csak korlátozott elérhetőséget igényelnek, és éjszaka lekapcsolhatók.
(kube-downscaler) lehetővé teszi a felhasználók és üzemeltetők számára, hogy a rendszert a nem működési időszakokban lecsökkentsék. A Deployments és StatefulSets nullás példányokra skálázhatók. A CronJobs felfüggeszthetők. A Kubernetes Downscaler az egész klaszterre, egy vagy több névtérre vagy külön erőforrásokra konfigurálható. Beállítható vagy a „leállási idő”, vagy épp ellenkezőleg, a „működési idő”. Például a skálázás maximális csökkentése érdekében éjszaka és hétvégén:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # ne deaktiváld az infrastruktúra komponenseit
  - --exclude-namespaces=kube-system,infra
  # ne deaktiváld a kube-downscalert, hagyd meg a Postgres Operatort, hogy a kizárt adatbázisokkal lehessen kezelni
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Itt van a klaszter munkacsomópontjainak skálázási grafikonja a hétvégéken:
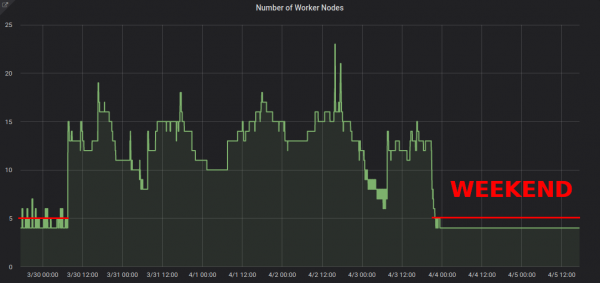
A skálázás ~13-ról 4 munkacsomóponttal, mindenképpen érezhető különbséget jelent az AWS számlán.
De mi van, ha a klaszter "leállási idő" alatt kell dolgoznom? Bizonyos telepítések véglegesen kizárhatók a skálázásból a downscaler/exclude: true annotáció hozzáadásával. A telepítések ideiglenesen kizárhatók a downscaler/exclude-until annotációval, az abszolút időbélyeg formátumban: ÉÉÉÉ-HH-NN ÓÓ:PP (UTC). Szükség esetén az egész klaszter vissza is skálázható egy annotációval rendelkező pod telepítése által. downscaler/force-uptime, például egy nginx sablon futtatásával:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # töröld a telepítést egy óra múlva
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Lásd , ha érdeklik az implementálási útmutatók és további lehetőségek.
Használj horizontális automatikus skálázást
Sok alkalmazás/szolgáltatás dinamikus terhelés-eloszlással bír: néha az elemek tétlenek, néha pedig teljes kapacitáson működnek. A fix számú pod fenntartása a maximális csúcsidőszak kezelésére nem gazdaságos. A Kubernetes támogatja a horizontális automatikus skálázást a következő erőforrás által: (HPA). A CPU használat gyakran jó mutató a skálázáshoz:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
A Zalando létrehozott egy komponenst a felhasználói metrikák könnyű integrálására a skálázáshoz: (kube-metrics-adapter) egy általános metrika adapter a Kubernetes számára, amely képes gyűjteni és szolgáltatni a felhasználói és külső metrikákat a podok horizontális automatikus skálázásához. Támogatja a Prometheus alapú metrikák, SQS sorok és más beállítások szerinti skálázást. Például, hogy a felhasználói metrikát a saját alkalmazás által JSON formátumban a /metrics útvonalon bemutatott mérés szerint skálázhassa:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
A HPA használatával történő horizontális skálázás beállítása az alapértelmezett műveletek közé kell hogy tartozzon a hatékonyság növeléséhez állapotfüggetlen szolgáltatások esetén. A Spotify rendelkezik egy bemutatóval a tapasztalataikról és ajánlásaikról az HPA-val kapcsolatban: .
A felesleges erőforrás-igénylés csökkentése
A Kubernetes munkaterhelések határozzák meg a CPU/memória igényeiket a "resource requests" (erőforrás kérések) révén. A CPU erőforrásokat virtuális magokban vagy gyakrabban "millicores"-ban mérik, például 500m azt jelenti, hogy a vCPU 50%-át foglalja el. A memória erőforrások byte-ban mérhetők, és hagyományos utótagokat lehet használni, például 500Mi, ami 500 megabájtot jelent. Az erőforrás-kérések "lekötik" a kapacitást a munkacsomópontokon, azaz egy 1000m CPU kéréssel rendelkező modul egy 4 virtuális CPU-val rendelkező csomóponton csak 3 virtuális CPU-t hagy szabadon más modulok számára.
Slack (felesleges tartalék) — ez a különbség a kért erőforrások és a valós felhasználás között. Például egy pod, amely 2 GiB memóriát kér, de csak 200 MiB-ot használ, körülbelül 1,8 GiB „felesleges” memóriát jelent. A felesleg pénzbe kerül. Durván becsülhető, hogy 1 GiB felesleges memória körülbelül 10 dollárba kerül havonta.
(kube-resource-report) megjeleníti a felesleges tartalékokat, és segíthet meghatározni a megtakarítások potenciálját:
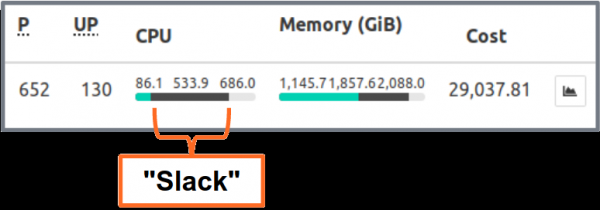
megmutatja az alkalmazás és a csapat által aggregált felesleget. Ez lehetővé teszi, hogy megtalálja azokat a területeket, ahol a erőforráskérések csökkenthetők. A generált HTML jelentés csupán az erőforrás-felhasználás pillanatképét adja. Az erőforrások megfelelő kérésének meghatározásához az időbeli CPU/memória felhasználást kell figyelembe venni. Íme egy Grafana diagram egy „tipikus” CPU-intenzív szolgáltatásként: minden pod jelentősen kevesebb, mint a három kért CPU-mag:
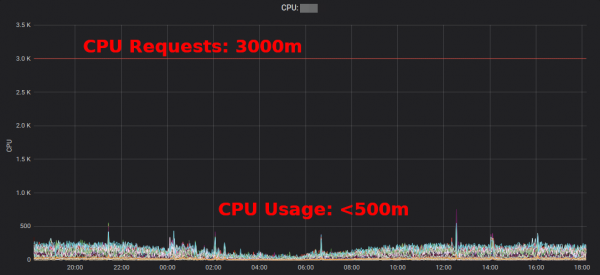
A CPU kérésének 3000m-ről körülbelül 400m-ra csökkentése erőforrásokat szabadít fel más munkaterhelések számára, és lehetővé teszi a klaszter csökkentését.
„Az EC2 példányok átlagos CPU-használata gyakran egyjegyű százalékok között ingadozik” — . Míg az EC2 a Kubernetes erőforráskérések néhány YAML fájlban történő módosítása könnyen elvégezhető, és hatalmas megtakarítást eredményezhet.
De valóban akarjuk, hogy az emberek a YAML fájlok értékeit módosítsák? Nem, a gépek ezt sokkal jobban tudják! A Kubernetes (VPA) pontosan ezt csinálja: alkalmazkodik az erőforráskérésekhez és korlátozásokhoz a munkaterhelésnek megfelelően. Íme egy példa a Prometheus CPU kérési grafikájára (vékony kék vonal), amelyet a VPA alkalmazkodott idővel:
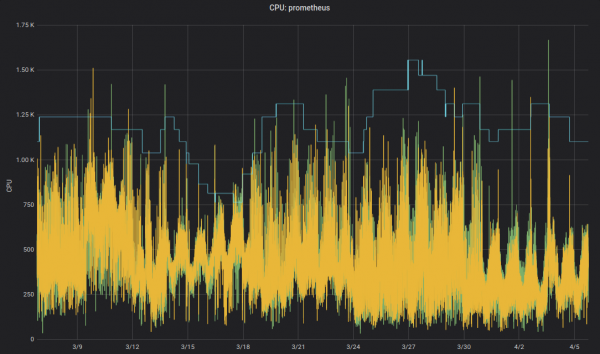
az infrastruktúra komponensekhez. Nem kritikus alkalmazások is használhatják a VPAt.
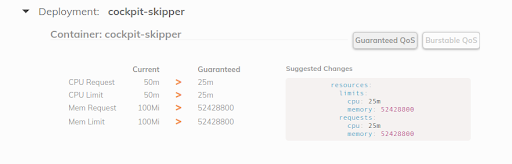
a Fairwindtől — egy eszköz, amely VPÁ-t generál minden telepítéshez a névtérben, majd megjeleníti a VPA ajánlást az irányítópultján. Segíthet a fejlesztőknek a megfelelő CPU/memória kérések beállításában az alkalmazásaikhoz:
Írtam egy kis 2019-ben, és nemrégiben a .
EC2 Spot példányok használata
Végül, ami nem moinsé fontos, az AWS EC2 költségeit csökkenteni lehet Spot példányok használatával a Kubernetes munkaköreiben. . A Spot példányok akár 90%-os kedvezménnyel is elérhetők a normál árakhoz képest. A Kubernetes EC2 Spot-on való futtatása jó kombináció: különböző példánytípusokat kell megadnia a magasabb rendelkezésre állás érdekében, ezáltal nagyobb csomópontokat kaphat ugyanakkora vagy alacsonyabb áron, a megnövelt kapacitás pedig a Kubernetes konténeres terheléseihez használható.
Hogyan indítsuk el a Kubernetes-t az EC2 Spot-on? Számos lehetőség van: használhat különg szolgáltatást, mint például a SpotInst (most „Spot”-nak hívják, ne kérdezze, miért), vagy egyszerűen hozzáadhat egy Spot AutoScalingGroup-ot (ASG) a klaszteréhez. Például itt van egy CloudFormation részlet egy "kapacitás-optimalizált" Spot ASG-hez, többféle példánytípussal:
MySpotAutoScalingGroup:
 Tulajdonságok:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Néhány megjegyzés a Spot Kubernetes-szel való használatáról:
- Meg kell kezelnie a Spot leállításokat, például a csomópont leürítésével az példány leállításakor.
- A Zalando használja a hivatalos klaszter automatikus méretezését csomópont prioritásokkal.
- A Spot csomópontok a munkaterhelések "regisztrációit" Spotban való induláshoz.
Összefoglaló
Remélem, hogy hasznosnak találja az itt bemutatott eszközöket a felhőszolgáltatási költségek csökkentésében. A cikk tartalmának nagy részét megtalálja a .
Mik a legjobb gyakorlatai a Kubernetes felhőköltségek csökkentésére? Kérem, tudassa velem a .
Valójában kevesebb mint 3 virtuális CPU marad használható, mivel a csomópont sávszélessége csökken a fenntartott rendszererőforrások miatt. A Kubernetes megkülönbözteti a csomópont fizikai kapacitását és a "kiosztott" erőforrásokat ().
Példa számításra: egy m5.large példány 8 GiB memóriával ~84 USD havonta (eu-central-1, On-Demand), vagyis 1/8 csomópont lefoglalása körülbelül ~10 USD havonta.
Még sok módja van az EC2 számla csökkentésének, például a fenntartott példányok, takarékossági tervek stb. – ezeket itt nem fogom tárgyalni, de feltétlenül érdemes utánanézni!
Forrás: habr.com
