

Helló mindenkinek. Olyan terméket fejlesztünk, amely offline forgalom elemzésére szolgál. A projektben egy feladat kapcsolódik a látogatók mozgásának statisztikai elemzéséhez a területeken.
E feladat keretében a felhasználók a következő típusú kérdéseket tehetik fel a rendszernek:
- Hány látogató haladt át az "A" területről a "B" területre?
- Hány látogató haladt át az "A" területről a "B" területre a "C" területen keresztül, majd a "D" területen keresztül?
- Mennyi időt vett igénybe egy adott típusú látogató áthaladása az "A" területről a "B" területre?
és még számos hasonló elemző kérdés.
A látogatók mozgása a területeken irányított gráfot képvisel. Olvasva az interneten, felfedeztem, hogy a gráf adatbázisok elemző jelentésekhez is használatosak. Kíváncsivá tett, hogyan birkózik meg a gráf adatbázis a hasonló kérdésekkel (Összefoglaló; rosszul).
Az adatbázis kezelésére választottam: , amely a gráf open-source adatbázisok kiemelkedő képviselője, és érett technológiai stackre épít, amely (véleményem szerint) megfelelő teljesítményt kellene, hogy biztosítson:
- BerkeleyDB tároló backend, Apache Cassandra, Scylla;
- bonyolult indexek tárolhatók a Lucene, Elasticsearch, Solr rendszerekben.
A JanusGraph szerzői azt állítják, hogy alkalmas mind OLTP, mind OLAP feladatokhoz.
Dolgoztam BerkeleyDB-vel, Apache Cassandraval, Scylla-val és ES-sel, sőt, ezek a termékek gyakran szerepelnek a rendszereinkben, ezért optimistán tekintettem a gráf adatbázis tesztelésére. Furcsa volt számomra a BerkeleyDB választása a RocksDB helyett, de valószínűleg ez a tranzakciós követelményekkel függ össze. Mindenesetre, skálázható, termék használatra a Cassandra vagy Scylla backend javasolt.
A Neo4j-t nem fontolgattam, mivel a klaszterezéshez kereskedelmi verzió szükséges, tehát a termék nem nyílt forráskódú.
A gráf adatbázisok azt mondják: "Ha valami gráfnak tűnik – kezeljük úgy, mint gráfot!" – gyönyörű!
Először egy gráfot rajzoltam, amely éppen a gráf adatbázisok kanonikus elvei szerint készült:
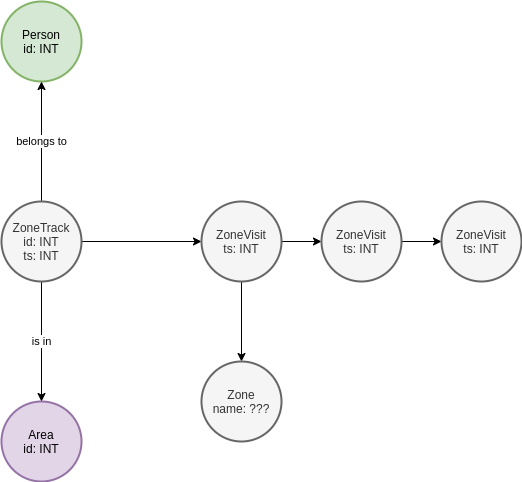
Van egy entitás, Zone, amely a területért felelős. Ha a ZoneStep ehhez tartozik, akkor hivatkozik rá. Az ZoneArea ZoneTrack, Person, entitásokra ne figyeljetek, azok a domainhez tartoznak és a teszt keretében nem kerülnek figyelembe vételre. Tehát, egy ilyen gráf struktúrához a láncok keresési kérdése így nézne ki: Figyelem, ne vegyétek figyelembe, ezek a domainhez tartoznak, és a teszt keretein belül nem kerülnek megfontolásra. Így a gráf struktúrához a láncok keresési lekérdezése így nézne ki:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
Ez körülbelül így van magyarul: keresd meg a Zone-t ID=0-val, vedd el az összes csúcsot, ahonnan az él (ZoneStep) indul, haladj vissza nem nézve, amíg meg nem találod azokat a ZoneStep-eket, ahonnan él vezet a Zone-hoz ID=19, számold meg az ilyen láncok számát.
Nem állítom, hogy ismerem a gráfkeresés minden finomságát, de ez a lekérdezés ennek a könyvnek a alapján készült ().
50 ezer számot töltöttem fel, melyek hossza 3 és 20 pont között van a JanusGraph gráf adatbázisba, ami BerkeleyDB backend-et használ, indexeket hoztam létre a .
A Python betöltő szkript:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
4 magprocesszoros és 16 GB RAM-mal rendelkező SSD-n futó VM-et használtam. A JanusGraph-ot a következő parancs segítségével telepítettem:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestEbben az esetben azok az adatok és indexek, amelyeket a pontos egyezés keresésére használnak, a BerkeleyDB-ben tárolódnak. A korábban megadott lekérdezés végrehajtása után az időtartam néhány tíz másodperc volt.
A fenti 4 szkript párhuzamos futtatásával sikerült az adatbázist tök üzemmódba állítani, miközben kedves Java stack trace folyamokat láthattunk a Docker naplókban (mert mindannyian szeretjük olvasni a Java stack trace-eket).
Gondolkodva úgy döntöttem, hogy egyszerűsítem a gráf sémát a következőre:
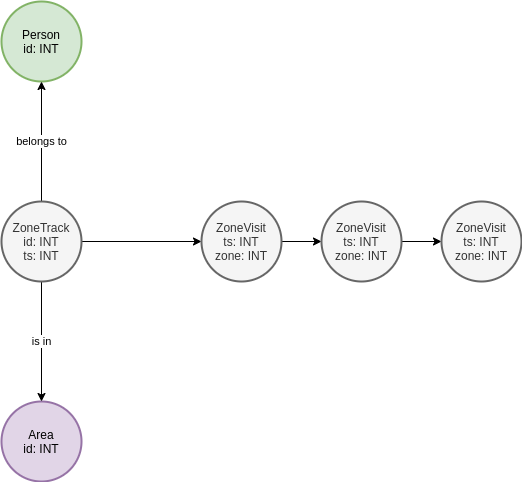
Úgy vélem, hogy az entitás attribútumainak keresése gyorsabb lesz, mint az éleken való keresés. Ennek eredményeképpen a lekérdezésem a következőre alakult:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()Ez körülbelül így van magyarul: keresd meg a ZoneStep-et ID=0-val, haladj vissza nem nézve, amíg meg nem találod a ZoneStep-et ID=19, számold meg az ilyen láncok számát.
A fenti betöltő szkriptet is leegyszerűsítettem, hogy ne hozzak létre felesleges kapcsolatokat, csupán az attribútumokkal korlátozva.
A lekérdezés még mindig néhány másodpercig futott, ami teljesen elfogadhatatlan volt a feladatunk szempontjából, mivel az AdHoc jellegű lekérdezésekhez ez egyáltalán nem volt megfelelő.
Megpróbáltam telepíteni a JanusGraph-t a Scylla segítségével, mint a Cassandra leggyorsabb megvalósítását, de ez sem hozott lényeges teljesítménybeli változásokat.
Ezért, bár "ez grafikusnak tűnik", nem sikerült gyorsan feldolgozni a grafikus adatbázis kezelőt. Teljesen valószínűnek tartom, hogy valamit nem tudok, és lehetne a JanusGraph-t arra késztetni, hogy ezt a keresést másodpercek töredéke alatt végezze el, azonban nekem ez nem sikerült.
Mivel a feladatot mindenképpen meg kellett oldani, elkezdtem gondolkodni a JOIN-okról és a táblázatok Pivot-ról, ami nem keltett bizalmat eleganciája szempontjából, de praktikusan kivitelezhető megoldás lehetett.
A projektünkben már használjuk az Apache ClickHouse-t, ezért eldöntöttem, hogy az általam végzett kutatásokat ezen az analitikai adatbázison fogom tesztelni.
Egyszerű recepttel telepítettem a ClickHouse-t:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Létrehoztam benne egy adatbázist és egy táblát a következő formában:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Ezt az adatokat a következő szkripttel töltöttem fel:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Mivel a beszúrások kötegekben történnek, a feltöltés sokkal gyorsabb volt, mint a JanusGraph esetében.
Két lekérdezést állítottam össze JOIN-ok segítségével. Az A pontból B pontba való átmenethez:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
A három ponton át történő átkeléshez:
SELECT s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FROM
  (SELECT s1.person AS person,
          s1.zone AS s1z,
          s1.when AS s1w,
          s2.zone AS s2z,
          s2.when AS s2w
   FROM
     (SELECT *
      FROM steps
      WHERE (area = 0)
        AND (zone = 0)) AS s1 ANY INNER JOIN
     (SELECT *
      FROM steps AS s2
      WHERE (area = 0)
        AND (zone = 3)) AS s2 USING person
   WHERE s1.when <= s2.when) p ANY INNER JOIN
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 19)) AS s3 USING person
WHERE p.s2w <= s3.when
A lekérdezések természetesen meglehetősen ijesztően néznek ki, valós használathoz programozási keretre van szükség - generátorra. Azonban működnek és gyorsan futnak. Az első és a második lekérdezés kevesebb mint 0,1 másodperc alatt végrehajtódik. Itt van egy példa a count(*) lekérdezés futási idejére 3 ponton:
SELECT count(*)
FROM
(
    SELECT
        s1.person AS person,
        s1.zone AS s1z,
        s1.when AS s1w,
        s2.zone AS s2z,
        s2.when AS s2w
    FROM
    (
        SELECT *
        FROM steps
        WHERE (area = 0) AND (zone = 0)
    ) AS s1
    ANY INNER JOIN
    (
        SELECT *
        FROM steps AS s2
        WHERE (area = 0) AND (zone = 3)
    ) AS s2 USING (person)
    WHERE s1.when <= s2.when
) AS p
ANY INNER JOIN
(
    SELECT *
    FROM steps
    WHERE (area = 0) AND (zone = 19)
) AS s3 USING (person)
WHERE p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 sor a készletben. Eltelt: 0.068 sec. Feldolgozott 250.03 ezer sor, 8.00 MB (3.69 millió sor/s., 117.98 MB/s.)Megjegyzés az IOPS-ról. Az adatok kitöltésekor a JanusGraph meglehetősen magas IOPS-t generált (1000-1300 négy adatbetöltő szál esetén), és az IOWAIT meglehetősen magas volt. Ezzel szemben a ClickHouse minimális terhelést generált a lemezes alrendszeren.
Zárás
A ClickHouse-t választottuk az ilyen típusú lekérdezések kiszolgálására. Mindig tovább optimalizálhatjuk a lekérdezéseket anyagilag kijelölt nézetek használatával és párhuzamosítással, a eseményfolyam előfeldolgozásával Apache Flink segítségével, mielőtt betöltenénk őket a ClickHouse-ba.
A teljesítmény annyira jó, hogy valószínűleg még a programozott pivotokkal sem kell foglalkoznunk. Korábban adatfeldolgozási pivotokat kellett végrehajtanunk a Vertica-ból való kivitelen keresztül Apache Parquet-be.
Sajnos a grafikus DBMS újabb próbálkozása nem bizonyult sikeresnek. Nem találtam, hogy a JanusGraph barátságos ökoszisztémája lehetővé tenné a termék gyors elsajátítását. Ugyanakkor a szerver konfigurálása a hagyományos Java-módot követi, ami a Java-hoz nem értő embereket véres könnyekre készteti:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary is here to replace Gryo and Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo and Graphson, latest versions
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Older serialization versions for backwards compatibility:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Sikerült véletlenül "lerakni" a BerkeleyDB JanusGraph verzióját.
A dokumentáció meglehetősen hiányos az indexek kezelésében, mivel az indexek kezelésekor meglehetősen furcsa varázslatokra van szükség Groovy-ban. Például az index létrehozása a Gremlin konzolban írt kód segítségével kell, hogy történjen (amely egyébként nem működik dobozból kivéve). Az hivatalos JanusGraph dokumentációból:
graph.tx().rollback() \/\/ Soha ne hozz létre új indexeket aktív tranzakció során
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()
\n\/\/ Várj, amíg az index elérhetővé válik
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
\/\/ Az adatokat újraindexeljük
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Utószó
Bizonyos értelemben a fenti kísérlet egyfajta összehasonlítás a meleg és a puha között. Ha jobban végiggondoljuk, a gráfos adatbázis más műveleteket végez ugyanazoknak az eredményeknek az eléréséhez. Azonban a tesztjeim keretében végeztem egy kísérletet egy ilyen lekérdezéssel:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
, amely a lépcsős elérhetőséget tükrözi. Azonban még ilyen adatok esetén is a gráfos adatbázis olyan eredményeket produkált, amelyek meghaladták a néhány másodpercet... Ez természetesen összefügg azzal, hogy voltak olyan útvonalak, mint 0 -> X -> Y ... -> 1, amelyeket a gráf motor is ellenőrzött.
Még egy ilyen lekérdezés esetén is:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()nem tudtam olyan eredményt kapni, amelynek a feldolgozási ideje egy másodpercnél kevesebb lett volna.
A tanulság tehát az, hogy egy szép ötlet és a paradigmális modellezés nem vezet kívánt eredményhez, amely sokkal nagyobb hatékonysággal demonstrálható a ClickHouse példáján. A cikkben bemutatott felhasználási eset nyilvánvaló antipattern a gráfos adatbázisok számára, bár úgy tűnik, hogy megfelelő a modellezésük paradigmáiban.
Forrás: habr.com
