

Ahogy az ismert, a SAP cég teljes spektrumú szoftvermegoldásokat kínál a tranzakciós adatok kezelésére, valamint ezen adatok analitikai és jelentési rendszerekben való feldolgozására. Különösen a SAP Business Warehouse (SAP BW) platform egy adatok tárolására és elemzésére szolgáló eszközkészlet, amely széles körű technikai lehetőségekkel rendelkezik. Az összes objektív előnyével a SAP BW rendszernek van egy jelentős hátránya is: az adatok tárolásának és feldolgozásának magas költsége, amely különösen észlelhető a felhőalapú SAP BW on Hana használatakor.
Mi lenne, ha valamilyen nem-SAP, és lehetőleg OpenSource terméket kezdenénk használni tárolóként? Mi, az X5 Retail Group-ban, a GreenPlum-ra esett a választásunk. Ez természetesen megoldja a költségek kérdését, de ezzel együtt azonnal felmerülnek olyan kérdések, amelyeket a SAP BW használata szinte automatikusan megoldott.
Különösen, hogy hogyan lehet adatokat begyűjteni a forrásszámítógépekből, amelyek többsége SAP megoldás.
Az «HR-metrikák» volt az első projekt, ahol ezt a problémát meg kellett oldani. Célunk volt egy HR-adattár létrehozása és az alkalmazottakkal kapcsolatos analitikai jelentések kidolgozása. A fő adatforrás a SAP HCM tranzakciós rendszer, ahol minden személyzeti, szervezeti és bérszámfejtési eseményt nyilvántartanak.
Adatkinyerés
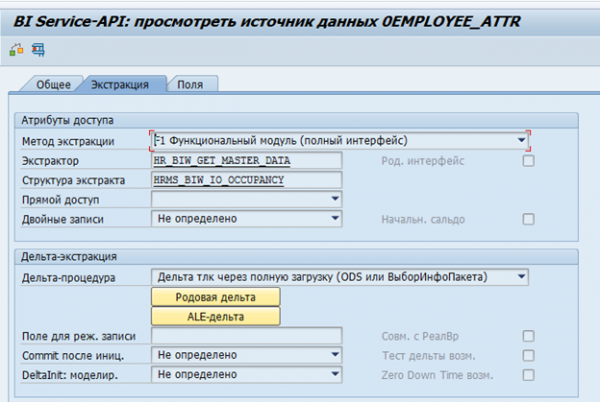
A SAP BW rendszerben a SAP rendszerekhez léteznek standard adatkinyerők. Ezek a kinyerők automatikusan gyűjtik össze a szükséges adatokat, nyomon követik azok épségét, és meghatározzák a változások delta értékeit. Például itt van egy standard adatforrás a dolgozói attribútumokhoz: 0EMPLOYEE_ATTR:
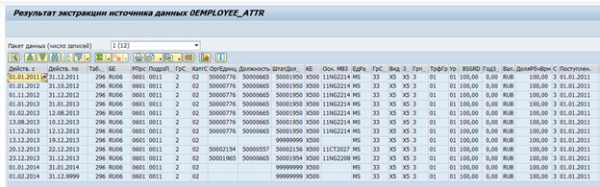
Az adatkinyerés eredménye egy dolgozóra vonatkozóan:
Szükség esetén ilyen kinyerőt lehet módosítani a saját követelményeknek megfelelően, vagy létre lehet hozni egy saját kinyerőt.
Elsőként felmerült az ötlet a továbbhasználhatóság lehetőségéről. Sajnos ez megvalósíthatatlan feladatnak bizonyult. A logika nagy része a SAP BW oldalán van megvalósítva, és fájdalommentesen nem lehetett a kinyerőt a forrástól elválasztani a SAP BW-tól.
Nyilvánvalóvá vált, hogy saját adatkinyerési mechanizmus kidolgozására lesz szükség a SAP rendszerekből.
Az adatok tárolásának struktúrája a SAP HCM-ben.
A követelmények megértéséhez először is meg kell határoznunk, hogy pontosan milyen adatokra van szükségünk.
A legtöbb adat a SAP HCM-ben sík SQL táblákban tárolódik. Ezen adatok alapján a SAP alkalmazások vizualizálják a felhasználók számára a szervezeti struktúrákat, alkalmazottakat és egyéb HR információkat. Például így néz ki a szervezeti struktúra a SAP HCM-ben:
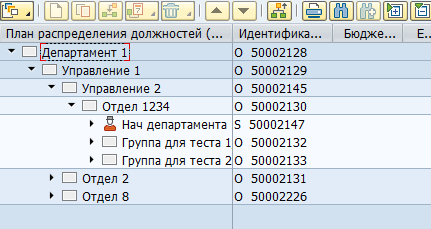
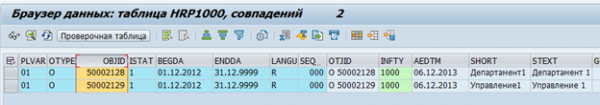
F Physikailag ez a fa két táblázatban tárolódik: az hrp1000 objektumok és az hrp1001 a kapcsolatok ezek között az objektumok között.
A '1. osztály' és az '1. menedzsment' objektumok:
Kapcsolat az objektumok között:
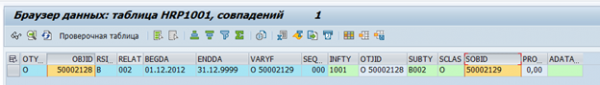
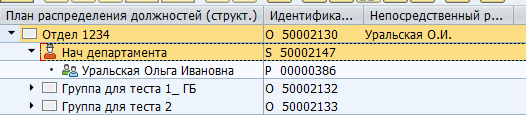
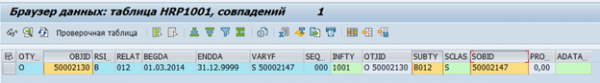
Az objektumtípusok, valamint a közöttük lévő kapcsolattípusok száma óriási lehet. Léteznek standard kapcsolatok az objektumok között, valamint testreszabottak is a saját specifikus igényekhez. Például a B012 standard kapcsolat az szervezeti egység és a státusz között a részleg vezetőjére mutat.
A vezető megjelenítése a SAP-ban:
Tárolás az adatbázis táblázatában:
Az alkalmazottak adatainak tárolása a pa* táblákban történik. Például az alkalmazott munkaviszony eseményei a pa0000 táblázatban tárolódnak.
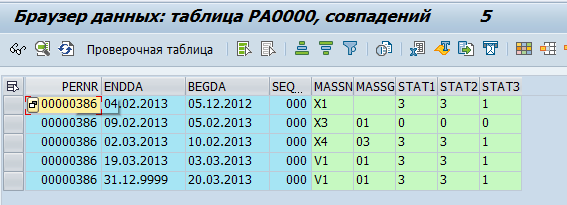
Döntöttünk arról, hogy a GreenPlum a 'nyers' adatokat fogja átvenni, azaz egyszerűen átmásolja őket a SAP táblákból. Ezeket a GreenPlumban dolgozzák fel, és alakítják át fizikális objektumokká (például Osztály vagy Alkalmazott) és metrikákká (például átlagos létszám).
Körülbelül 70 táblázatot határoztunk meg, melyek adatait át kell adni a GreenPlumnak. Ezt követően elkezdtük dolgozni az adatok átadásának módján.
A SAP meglehetősen sok integrációs mechanizmust kínál. De a legegyszerűbb mód – a közvetlen adatbázis elérhetőség – az engedélyezési korlátozások miatt tilos. Így minden integrációs folyamatnak a szintjén kell megvalósulnia a szerver alkalmazások.
A következő probléma a SAP adatbázisban törölt rekordok adatainak hiánya volt. Amikor egy sort eltávolítanak az adatbázisból, az fizikailag törlődik. Azaz a módosítások időbeli különbségének a kialakítása lehetetlennek tűnt.
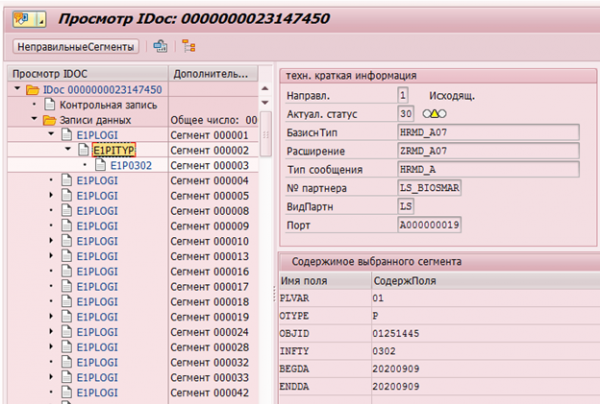
Természetesen a SAP HCM-ben vannak a adatváltozások rögzítésének mechanizmusai. Például a rendszerbe továbbításra kerülő adatok számára léteznek változásmutatók (change pointer), amelyek rögzítik az összes módosítást, és amely alapján az Idoc-ok (objektumok külső rendszerekhez való továbbításához) létrejönnek.
A 0302 infotype IDoc modification example for an employee with personnel number 1251445:
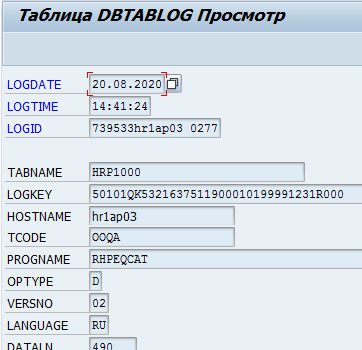
Or maintaining logs of data changes in the DBTABLOG table.
An example of a log for deleting an entry with key QK53216375 from the hrp1000 table:
However, these mechanisms are not available for all necessary data, and their processing at the application server level can consume a significant amount of resources. Therefore, mass enabling of logging for all necessary tables can lead to noticeable degradation in system performance.
Another serious issue was clustered tables. Data for time evaluation and payroll calculation in SAP HCM RDBMS version is stored as a set of logical tables for each employee for each calculation. These logical tables are stored as binary data in the pcl2 table.
Payroll Calculation Cluster:
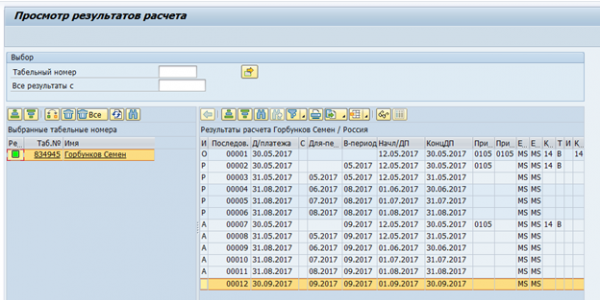
Data from clustered tables cannot be read with a SQL command; it requires the use of SAP HCM macro commands or special function modules. Accordingly, the read speed for such tables will be relatively low. On the other hand, such clusters store data needed only once a month – the final payroll calculation and time evaluation. Therefore, the speed in this case is not critical.
Evaluating options for generating data change deltas, we also decided to consider the option of full data extraction. The option of transferring gigabytes of unchanged data between systems daily does not seem attractive. However, it has several advantages – there is no need to implement deltas on the source side, nor to integrate these deltas on the receiver's side. As a result, the cost and time of implementation are reduced and the reliability of integration is increased. It was determined that almost all changes in SAP HR occur within a three-month horizon up to the current date. Thus, it was decided to proceed with a daily full data extraction from SAP HR for N months prior to the current date and a monthly full extraction. The parameter N depends on the specific table.
and ranges from 1 to 15.
The following scheme was proposed for data extraction:
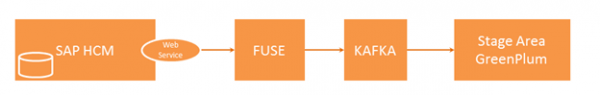
A külső rendszer kérést alakít ki és küldi el az SAP HCM-nek, ahol a kérés ellenőrzésre kerül az adatok teljessége és a táblákhoz való hozzáférési jogosultság szempontjából. Sikeres ellenőrzés esetén az SAP HCM végrehajtja a szükséges adatokat összegyűjtő programot, amely az információkat továbbítja a Fuse integrációs megoldás felé. A Fuse meghatározza a szükséges témát a Kafka rendszerében és ott továbbítja az adatokat. Ezt követően az adatok a Kafka-ból a Stage Area GP-be kerülnek.
A kérdést, amely a SAP HCM-ből történő adatkihozatalra vonatkozik, részletesebben fogjuk elemezni.
A SAP HCM-FUSE közötti interakciós séma.
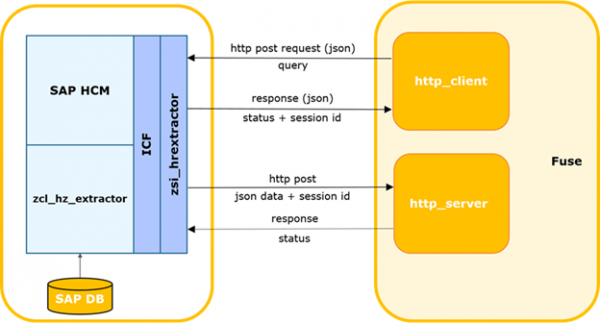
A külső rendszer meghatározza az SAP-ban végrehajtott utolsó sikeres kérés időpontját.
A folyamat időzítő alapján vagy más esemény hatására indítható, és beállítható válaszidő-túllépés is SAP-tól kapott adatokra. Ezt követően delta kérést alakít ki és küldi el az SAP-nak.
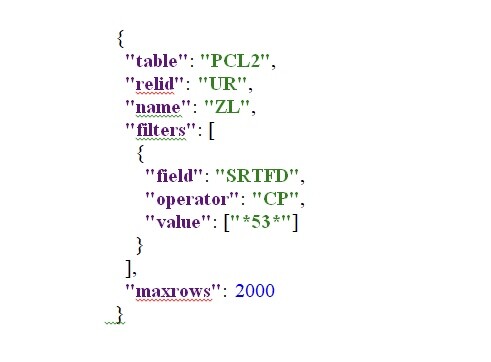
A kérés adatai a body-ban json formátumban kerülnek átadásra.
HTTP módszer: POST.
Példa kérés:
Az SAP szolgáltatás ellenőrzi a kérés teljességét, az aktuális SAP struktúrával való megfelelőségét, valamint a kért táblához való hozzáférés engedélyét.
Hibák esetén a szolgáltatás választ ad a megfelelő kód és leírás kíséretében. Sikeres ellenőrzés esetén a kérés egy háttérfolyamat létrehozását indítja el a mintavételhez, generál és szinkron módon visszaadja az egyedi munkamenet azonosítót.
A külső rendszer hibás válasz esetén nyilvántartást készít erről. Sikeres válasz esetén továbbítja a munkamenet azonosítót és a kért tábla nevét.
A külső rendszer jelenlegi munkamenetét nyitottnak regisztrálja. Ha van más munkamenet a megadott táblához, ezek lezárásra kerülnek, és figyelmeztetés kerül rögzítésre a naplóban.
A SAP háttérfeladatot hozzárendel a megadott paraméterekhez, és egy adott méretű adatcsomagot hoz létre. Az adatcsomag mérete – a maximális feljegyzések száma, amelyet a folyamat a DB-ből olvas. Alapértelmezés szerint 2000-re van beállítva. Ha a DB mintájában több feljegyzés található, mint a használt adatcsomag mérete, az első csomag átadása után a következő blokk létrehozásra kerül a megfelelő offset-tel és a növekvő csomagszámmal. A számok 1-gyel növekednek és szigorúan sorrendben küldik el.
Ezután a SAP átadja a csomagot a külső rendszer webszolgáltatásának. A rendszer pedig ellenőrzi a bejövő csomagot. A rendszerben regisztrált sessziónak a kapott azonosítóval kell rendelkeznie, és nyitott állapotban kell lennie. Ha a csomag száma > 1, a rendszerben sikeresen kell regisztrálni az előző csomag (package_id-1) kézbesítését.
Sikeres ellenőrzés esetén a külső rendszer elemzi és menti az adatok táblázatát.
Továbbá, ha a csomagban található a final jelző, és a sorosítás sikeresen lezajlott, a rendszer értesíti az integrációs modult a sessionszolgáltatás sikeres befejezéséről, és a modul frissíti a sesszió állapotát.
Hiba esetén az ellenőrzés/elemzés során a hiba naplózásra kerül, és a külső rendszer elutasítja a csomagokat ezen a sessziótörténeten.
Viszont ha a külső rendszer hibát jelez, azt is naplózzák, és megáll a csomagok továbbítása.
A SAP HCM oldalán adatlekérdezési integrációs szolgáltatás került megvalósításra. A szolgáltatás az ICF (SAP Internet Communication Framework) keretrendszerén alapul, ). Ez lehetőséget biztosít a SAP HCM rendszerből származó adatok lekérdezésére meghatározott táblákon keresztül. Az adatkérdezés elkészítésekor lehetőség van a konkrét mezők és szűrési paraméterek megadására az szükséges adatok megszerzése érdekében. A szolgáltatás megvalósítása nem feltételez semmiféle üzleti logikát. A delta számítások, a lekérdezési paraméterek, az integritás ellenőrzése és hasonlók algoritmusait is a külső rendszer végzi.
Ez a mechanizmus lehetővé teszi az összes szükséges adat összegyűjtését és átadását néhány óra alatt. Ez a sebesség a megengedett határ közelében van, ezért ezt a megoldást átmenetinek tekintjük, amely lehetővé tette az extrakciós eszköz iránti igény kielégítését a projektben.
A célképen az adatok extrakciós feladataira az CDC rendszerek, mint az Oracle Golden Gate vagy az ETL eszközök, mint a SAP DS felhasználásának lehetőségeit dolgozzák ki.
Forrás: habr.com
