

Bár a technológia folyamatosan fejlődik, a fejlődés mögött mindig ott állnak elavult megközelítések. Ez lehet a fokozatos átmenet, az emberi tényező, a technológiai szükségletek vagy valami más következménye. Az adatok feldolgozása terén a legszembetűnőbbek a források. Bármennyire is szeretnénk megszabadulni tőlük, amíg egy rész adatot üzenetküldőkben és e-mailekben továbbítanak, nem is beszélve a régebbi formátumokról. Meghívom, hogy nézzük meg az Apache Airflow egyik lehetőségét, amely illusztrálja, hogyan lehet adatokat kinyerni e-mailekből.
Háttér
Sok adat továbbra is e-mailen keresztül érkezik, kezdve az interperszonális kommunikációktól, egészen a vállalatok közötti interakciós szabványokig. Jó, ha lehetőséget találunk az adatok beszerzésére egy interfész megírásával vagy azzal, hogy emberek ülnek az irodában, hogy az információt kényelmesebb forrásokba vigyék, de gyakran előfordulhat, hogy ez nem lehetséges. Az általam megoldott konkrét feladat az volt, hogy egy jól ismert CRM rendszert kapcsoljak a tárolási megoldáshoz, majd az OLAP rendszerhez. Történelmileg úgy alakult, hogy a cégünknek ez a rendszer kényelmes volt egy adott üzleti területen. Ezért mindenki szeretett volna lehetőséget kapni az adatok kezelésére ebből a külső rendszerből is. Elsősorban természetesen az nyílt API-ból történő adatgyűjtés lehetőségét vizsgáltuk. Sajnos az API nem fedte le az összes szükséges adat beszerzését, ráadásul, kifejezve egyszerű nyelven, sok szempontból hiányos volt, és a műszaki támogatás nem akarta vagy nem tudta megadni a kielégítőbb funkciókat. Viszont ez a rendszer lehetőséget biztosított a hiányzó adatok időszakos beszerzésére e-mailben, archiválás letöltésére szolgáló link formájában.
Meg kell jegyezni, hogy ez nem volt az egyetlen eset, amikor a vállalat adatokat akart összegyűjteni e-mailekből vagy üzenetküldőkből. Azonban ebben az esetben nem tudtunk hatást gyakorolni arra a külső cégre, amely a szükséges adatokat kizárólag ilyen módon szolgáltatta.
Apache Airflow
ETL folyamatok létrehozásához leggyakrabban az Apache Airflow-t használjuk. Annak érdekében, hogy az olvasó, aki nem ismeri ezt a technológiát, jobban megértse, hogyan néz ki ez a gyakorlatban, leírok pár bevezetőt.
Az Apache Airflow egy nyílt forráskódú platform, amely az ETL (Extract-Transform-Loading) folyamatok Python nyelven történő létrehozására, végrehajtására és monitorozására szolgál. Az Airflow alapvető fogalma az irányított ciklikus graf, ahol a graf csúcsai konkrét folyamatok, a graf élei pedig a vezérlés vagy az információ áramlása. A folyamat egyszerűen meghívhat bármilyen Python funkciót, vagy bonyolultabb logikát is tartalmazhat, amely számos funkció sorozatos meghívását jelenti egy osztály kontextusában. A leggyakoribb műveletekhez már számos kész megoldás áll rendelkezésre, amelyeket folyamatokként használhatunk. Ilyen megoldások közé tartoznak:
- operátorok — adatok átmozgatására egyik helyről a másikra, például egy adatbázis táblájából az adattárházba;
- szenzorok — egy adott esemény bekövetkeztére várakoznak, és irányítják a vezérlést a graf következő csúcsaira;
- hook-ok — alacsonyabb szintű műveletekhez, például az adatok lekérésére egy adatbázis táblából (az operátorokban használják);
- stb.
Az Apache Airflow részletes leírása nem lenne célszerű ebben a cikkben. Rövid bevezetőkért tekintse meg vagy .
Adatok lekérő hook
Elsősorban a feladat megoldásához írni kell egy hook-ot, amellyel képesek vagyunk:
- csatlakozni az e-mailhez;
- megtalálni a szükséges levelet;
- lekérni az adatokat a levélből.
from airflow.hooks.base_hook import BaseHook
import imaplib
import logging

class IMAPHook(BaseHook):
    def __init__(self, imap_conn_id):
        """
           IMAP hook az e-mailből származó adatok lekérésére

           :param imap_conn_id:       E-mail kapcsolati azonosító
           :type imap_conn_id:        string
        """
        self.connection = self.get_connection(imap_conn_id)
        self.mail = None

    def authenticate(self):
        """
            Csatlakozás az e-mailhez
        """
        mail = imaplib.IMAP4_SSL(self.connection.host)
        response, detail = mail.login(user=self.connection.login, password=self.connection.password)
        if response != "OK":
            raise AirflowException("Bejelentkezés nem sikerült")
        else:
            self.mail = mail

    def get_last_mail(self, check_seen=True, box="INBOX", condition="(UNSEEN)"):
        """
            A legutolsó e-mail azonosítójának lekérése,
            amely megfelel a keresési feltételeknek

            :param check_seen:      A legutolsó e-mail megjelölése olvasottként
            :type check_seen:       bool
            :param box:             A fiók neve
            :type box:              string
            :param condition:       Az e-mailek keresési feltételei
            :type condition:        string
        """
        self.authenticate()
        self.mail.select(mailbox=box)
        response, data = self.mail.search(None, condition)
        mail_ids = data[0].split()
        logging.info("A fiókban a következő e-mailek találhatók: " + str(mail_ids))

        if not mail_ids:
            logging.info("Nincsenek új e-mailek")
            return None

        mail_id = mail_ids[0]

        # ha több e-mail is van
        if len(mail_ids) > 1:
            # a többit olvasottként megjelöljük
            for id in mail_ids:
                self.mail.store(id, "+FLAGS", "\Seen")

            # az utolsót adjuk vissza
            mail_id = mail_ids[-1]

        # szükséges-e az utolsót olvasottként megjelölni
        if not check_seen:
            self.mail.store(mail_id, "-FLAGS", "\Seen")

        return mail_id
A logika a következő: csatlakozunk, megtaláljuk a legutolsó legfrissebb e-mailt, ha vannak mások — figyelmen kívül hagyjuk őket. Ezért van szükség ilyen funkcióra, mert a későbbi e-mailek minden korábbi adatot tartalmaznak. Ha ez nem így van, akkor vissza lehet térni az összes e-mail tömbjéhez, vagy kezelni az elsőt, a többit pedig a következő áthaladáskor. Összességében, minden a feladattól függ.
Két segédfunkciót adunk a hookhoz: egy fájl letöltésére és egy fájl letöltésére a levélből származó hivatkozás alapján. Érdemes megjegyezni, hogy ezeket operátorba is ki lehet emelni, attól függően, hogy milyen gyakran használják ezt a funkciót. Hogy mit kell még hozzáadni a hookhoz, ismét a feladattól függ: ha a levélben azonnal fájlok érkeznek, akkor letölthetjük a levélhez tartozó mellékleteket; ha az adatok a levélben érkeznek, akkor ki kell bontanunk a levelet, és így tovább. Az én esetemben a levél egy hivatkozással érkezik egy archívumra, amelyet egy meghatározott helyre kell elhelyeznem, és elindítanom a további feldolgozást.
    def download_from_url(self, url, path, chunk_size=128):
        """
            Fájl letöltésére szolgáló módszer

            :param url:              Letöltési cím
            :type url:               string
            :param path:             Hova helyezzük a fájlt
            :type path:              string
            :param chunk_size:       Hány byte-ot írunk egyszerre
            :type chunk_size:        int
        """
        r = requests.get(url, stream=True)
        with open(path, "wb") as fd:
            for chunk in r.iter_content(chunk_size=chunk_size):
                fd.write(chunk)

    def download_mail_href_attachment(self, mail_id, path):
        """
            Fájl letöltésére szolgáló módszer a levélből származó hivatkozás alapján

            :param mail_id:         A levél azonosítója
            :type mail_id:          string
            :param path:            Hova helyezzük a fájlt
            :type path:             string
        """
        response, data = self.mail.fetch(mail_id, "(RFC822)")
        raw_email = data[0][1]
        raw_soup = raw_email.decode().replace("r", "").replace("n", "")
        parse_soup = BeautifulSoup(raw_soup, "html.parser")
        link_text = ""

        for a in parse_soup.find_all("a", href=True, text=True):
            link_text = a["href"]

        self.download_from_url(link_text, path)
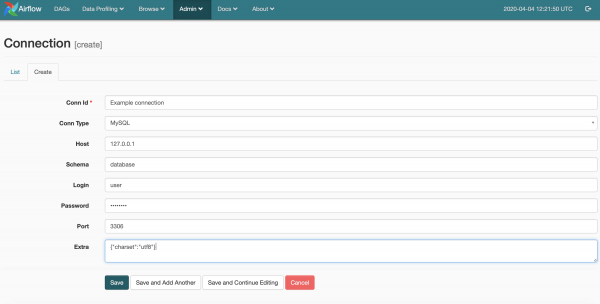
A kód egyszerű, így valószínűleg nem igényel további magyarázatot. Csak a varázslatos imap_conn_id sorra szeretnék utalni. Az Apache Airflow tárolja a csatlakozási paramétereket (felhasználónév, jelszó, cím és más paraméterek), amelyekhez karakterlánc-azonosítóval lehet hozzáférni. A csatlakozások kezelése vizuálisan így néz ki:
Várakozó érzékelő az adatokra
Mivel már tudjuk csatlakoztatni és adatokat kapni az e-mailből, most írhatunk egy érzékelőt, hogy várakozzon ezekre az adatokra. Azonnal egy operátort írni, amely feldolgozza az adatokat, ha azok rendelkezésre állnak, nem sikerült, mivel az e-mailből kapott adatok alapján más folyamatok is működnek, beleértve a más forrásokból (API, telefon, webes méretezés stb.) származó kapcsolódó adatok beszerzését is. Példaként említem. A CRM rendszereben új felhasználó jelent meg, és még nem tudjuk az UUID-ját. Így tehát, amikor megpróbáljuk lekérni az adatokat a SIP-telefonból, kapni fogunk hívásokat, amelyek az ő UUID-jához vannak rendelve, de korrekt módon nem tudjuk őket megőrizni és felhasználni. Ezekben a kérdésekben fontos figyelembe venni az adatok függőségét, különösen, ha azok különböző forrásokból származnak. Ez persze nem elegendő intézkedések az adatok integritásának megőrzésére, de bizonyos esetekben szükségesek. Ráadásul haszontalanul foglalni az erőforrásokat is ésszerűtlen.
Így tehát az érzékelőnk elindítja a gráf következő csúcsait, ha friss információ van az e-mailben, és megjelöli az előző információt, mint érvénytelen.
from airflow.sensors.base_sensor_operator import BaseSensorOperator
from airflow.utils.decorators import apply_defaults
from my_plugin.hooks.imap_hook import IMAPHook

class MailSensor(BaseSensorOperator):
    @apply_defaults
    def __init__(self, conn_id, check_seen=True, box="Inbox", condition="(UNSEEN)", *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.conn_id = conn_id
        self.check_seen = check_seen
        self.box = box
        self.condition = condition

    def poke(self, context):
        conn = IMAPHook(self.conn_id)
        mail_id = conn.get_last_mail(check_seen=self.check_seen, box=self.box, condition=self.condition)

        if mail_id is None:
            return False
        else:
            return True
Adatokat kapunk és használunk fel
Az adatok megszerzésére és feldolgozására külön operátort lehet írni, vagy kész megoldásokat is használhatunk. Mivel a logika egyelőre banális - az adatokat az e-mailből kell kivenni, ezért példaként ajánlom a standard PythonOperator-t.
from airflow.models import DAG

from airflow.operators.python_operator import PythonOperator
from airflow.sensors.my_plugin import MailSensor
from my_plugin.hooks.imap_hook import IMAPHook

start_date = datetime(2020, 4, 4)

# Standard konfigurációja a gráfnak
args = {
    "owner": "example",
    "start_date": start_date,
    "email": ["home@home.ru"],
    "email_on_failure": False,
    "email_on_retry": False,
    "retry_delay": timedelta(minutes=15),
    "provide_context": False,
}

dag = DAG(
    dag_id="test_etl",
    default_args=args,
    schedule_interval="@hourly",
)

# Szenzor definiálása
mail_check_sensor = MailSensor(
    task_id="check_new_emails",
    poke_interval=10,
    conn_id="mail_conn_id",
    timeout=10,
    soft_fail=True,
    box="my_box",
    dag=dag,
    mode="poke",
)

# Funkció az e-mailekből származó adatok lekérésére
def prepare_mail():
    imap_hook = IMAPHook("mail_conn_id")
    mail_id = imap_hook.get_last_mail(check_seen=True, box="my_box")
    if mail_id is None:
        raise AirflowException("Üres postaláda")

    conn.download_mail_href_attachment(mail_id, ".\/path.zip")

prepare_mail_data = PythonOperator(task_id="prepare_mail_data", default_args=args, dag=dag, python_callable= prepare_mail)

# A gráf többi csúcsának leírása
...

# Kapcsolat beállítása a gráfban
mail_check_sensor >> prepare_mail_data
prepare_data >> ...
# A vezérlési folyamatok további leírása
Egyébként, ha a céges levelezésed is a mail.ru-n van, akkor nem lesz elérhető a levelek keresése téma, feladó stb. szerint. Még 2016-ban ígérték, hogy bevezetik, de úgy látszik, meggondolták magukat. Én ezt a problémát azzal oldottam meg, hogy a szükséges leveleknek külön mappát hoztam létre, és a levelezés webes felületén beállítottam egy szűrőt a szükséges levelekhez. Így ebbe a mappába csak a szükséges levelek kerülnek, és az én esetemben a keresési feltételek egyszerűen (UNSEEN).
Összefoglalva, a következő sorrendet követjük: ellenőrizzük, hogy vannak-e új levelek, amelyek megfelelnek a feltételeknek, ha vannak, letöltjük az archívumot az utolsó levélből származó linken.
A legutolsó három pont alatt elhallgattam, hogy ez az archívum ki lesz csomagolva, az archívumból származó adatokat megtisztítják és feldolgozzák, és végül mindez tovább kerül az ETL folyamat konveijerére, de ez már túlmutat a cikk témáján. Ha érdekesnek és hasznosnak találtad, örömmel folytatom az ETL megoldások és azok részeinek bemutatását az Apache Airflow számára.
Forrás: habr.com
