

Nyáron hagyományosan csökkent a vásárlói aktivitás és a webprojekt-infrastruktúrák változásainak intenzitása, mondja nekünk a Nyilvánvaló Kapitány. Csak azért, mert még az IT-sek is, néha, nyaralni mennek. És a CTO-k is. Annál nehezebb azoknak, akik a posztjukon maradnak, de most nem erről van szó: talán éppen ezért a nyár a legjobb időszak arra, hogy nyugodtan átgondoljuk a meglévő tartalékos rendszert és összeállítsunk egy tervet a javítására. Ezen a téren hasznos lehet Egor Andrejev tapasztalata , amit ő a konferencián említett .
Tartalékhelyek kialakításakor, a rezerválás során több csapda is van, amelyekbe beleeshetünk. Ezekbe belesni teljesen tilos. És ebben, mint sok másban is, a tökéletesség és... a lustaság öl meg minket. Mindenképpen igyekszünk mindent tökéletesen megcsinálni, de nem kell mindent tökéletesen csinálni! Csak bizonyos dolgokat kell jól megcsinálni, és végigvinni őket, hogy rendesen működjenek.
A failover nem egy vidám szórakoztató dolog, hogy legyen; ennek egy dolgot kell tennie - csökkenteni a leállási időt, hogy a szolgáltatás, a cég kevesebb pénzt veszítsen. És minden rezerválási módszer esetén azt javaslom, hogy a következő kontextusban gondolkodjunk: hol van a pénz?
Az első csapda: amikor nagy megbízható rendszereket építünk és rezerválással foglalkozunk - csökkentjük a balesetek számát. Ez egy szörnyű tévhit. Amikor rezerválással foglalkozunk, a balesetek számát valószínűleg növeljük. És ha mindent jól csinálunk, összességében csökkenteni fogjuk a leállási időt. Lesznek balesetek, de kisebb költségekkel fognak bekövetkezni. Mi is a rezerválás? - a rendszer bonyolítása. Bármely bonyolítás - rossz: több alkatrészt, több fogaskereket, szóval több elemet kapunk - és ezáltal magasabb a meghibásodás esélye. És valóban el fognak törni. Gyakrabban fognak törni. Például: mondjuk, van egy weboldalunk, PHP-val, MySQL-lal. És sürgősen rezerválnunk kell.
Nos, második platformot veszünk, egy az egyben felépítjük a rendszert... A bonyolultság kétszeresére nő — két entitásunk van. Ezen kívül felépítünk egy adatátviteli logikát az egyik platformról a másikra — azaz adatreplicálás, statikus másolatok és így tovább. Nos, a replikálási logika általában nagyon bonyolult, ami azt jelenti, hogy a rendszer összesített bonyolultsága nem kétszer, hanem akár háromszor, ötször, sőt tízszer több lehet.
A második csapda: amikor igazán nagy, bonyolult rendszereket építünk, fantáziálunk arról, mit szeretnénk elérni. Ám ezúttal: egy szupermegbízható rendszert szeretnénk, amely teljesen leállás nélkül működik, fél másodperc alatt átvált (vagy még inkább azonnal), és elkezdjük a vágyainkat valóra váltani. De itt is van egy kis csavar: minél rövidebb az átváltási idő, annál bonyolultabbá válik a rendszer logikája. Minél bonyolultabbá kell tennünk ezt a logikát, annál gyakrabban fog a rendszer meghibásodni. És egy nagyon kellemetlen helyzetbe kerülhetünk: minden erőnkkel próbáljuk a leállási időt csökkenteni, de valójában mindent megnehezítünk, és amikor valami nem úgy megy, ahogy kell, végül a leállási idő hosszabb lesz. Itt sokszor azon kapod magad, hogy: oh... jobban tettük volna, ha nem tartalékolunk. Jobb lett volna, ha az egyetlen működik, és világos leállási idővel rendelkezik.
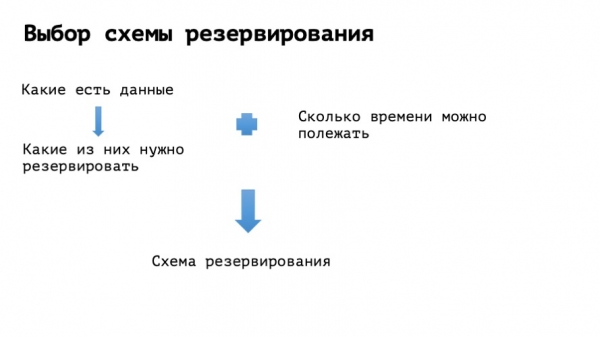
Hogyan lehet ezzel harcolni? Meg kell szabadulnunk a hazugságoktól, abba kell hagynunk, hogy hitegetjük magunkat, hogy most űrhajót építünk, hanem reálisan kell vállalnunk, mennyi ideig tarthat a projekt. Erre a maximális időre kell választanunk, hogy milyen módszerekkel fogjuk növelni a rendszer megbízhatóságát.
Itt az ideje az "életemből származó történeteknek"... természetesen az életből.
Első példa
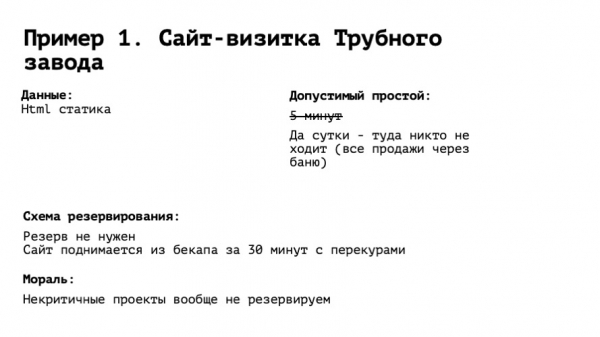
Képzelj el egy névjegykártya weboldalt az N város legjobb csőgyártó üzeméről. Rajta hatalmas betűkkel — LEGJOBB CSŐGYÁRTÓ ÜZEM NÉVEN. Kicsit lejjebb — egy szlogen: „A mi csöveink a legkerekebb csövek N-ben”. Alul pedig a vezérigazgató telefonszáma és neve. Tudjuk, hogy szükséges a rezerválás — ez nagyon fontos dolog! Kezdjük elérteni, miből áll. Html statika — azaz pár képecske, ahol a vezérigazgató, a tulajdonos, a partnereivel együtt ül a fürdőszobában és beszélget valami üzletről. Elkezdünk gondolkodni a leállás idején. Eszünkbe jut: öt percet kellene ott feküdni, nem többet. És itt a kérdés: ebből a weboldalunkból volt eladás egyáltalán? Hány? Mit jelent az, hogy „nulla”? Sőt, annyit jelent: mert az összes négy üzletet tavaly a vezérigazgató ugyanazon az asztalnál kötötte, ugyanazokkal az emberekkel, akikkel a fürdőben ült. És megértjük, hogy még ha egy napig is alszik az oldal — semmi félelmetes nem fog történni.
A kiindulópontok alapján van egy napunk ennek a történetnek a felépítésére. Elkezdünk gondolkodni a rezerválási rendszeren. És kiválasztjuk a legideálisabb reserválási rendszert ebben a példában: nem használunk rezerválást. Ez az egész dolog bármelyik adminisztrátor által fél óra alatt összehozható, akár egy cigarettaszünettel is. Fel kell állítani a webkiszolgálót, elhelyezni a fájlokat — ennyi. Az működni fog. Nincs mit figyelni, semmire nem kell különös figyelmet fordítani. Tehát az első példából a következtetés meglehetősen nyilvánvaló: azokat a szolgáltatásokat, amelyeket nem kell rezerválni — nem is szükséges rezerválni.
Második példa
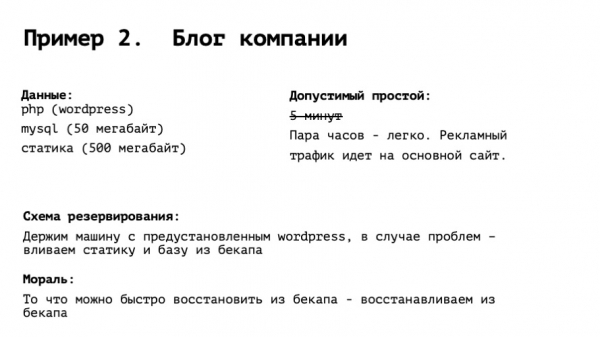
A vállalat blogja: speciálisan képzett emberek írják a híreket, részt vettünk egy kiállításon, és bemutattuk az új termékünket, és így tovább. Tegyük fel, hogy ez egy normál PHP alapú WordPress, egy kis adatbázissal és egy kis statikus tartalommal. Persze, az ugrik be, hogy nem szabad egyáltalán leállni – „ne több mint öt perc!” és hasonlók. De gondoljunk egy kicsit tovább. Mit csinál ez a blog? A Yandexből és a Google-ból jönnek látogatók keresések alapján, organikusan. Klassz. De valahogyan kapcsolódik ez az eladásokhoz? Megvilágosodás: nem igazán. A hirdetési forgalom a főoldalra irányul, ami egy másik gépen van. Elkezdünk gondolkodni a blog biztonsági másolatának a mentési tervén. Valójában pár órán belül fel kellene állítani, és jó lenne erre előre felkészülni. Ésszerű lenne egy másik adatközpontból beszerezni egy gépet, arra telepíteni a környezetet, tehát web szervert, PHP-t, WordPress-t, MySQL-t, és ezt kihúzva tárolni. Abban a pillanatban, amikor rájövünk, hogy minden összeomlott, két dolgot kell tenni – futtassuk a mysql dump-ot, ami 50 megabájt, ez egy perc alatt végigmegy, és töltsünk fel egy csomó képet a biztonsági másolatból. Ez is nem nagy ügy. Így fél óra alatt feláll ez az egész dolog. Nincsenek replikációk, vagy isten ments, automatikus failover. Következtetés: amit gyorsan vissza tudunk állítani a biztonsági másolatból, azt nem szükséges biztonságosítani.
Harmadik példa, bonyolultabb
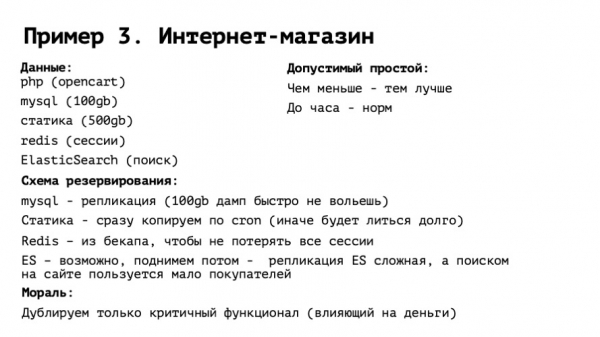
Webáruház. Kicsit testreszabott PHP open heart, jelentős MySQL adatbázissal. Elég sok statikus tartalom (hiszen a webáruházban vannak szépen megjelenített HD képek és minden egyéb), Redis a sessionhöz és Elasticsearch a kereséshez. Elkezdünk gondolkodni az állásidőről. És itt nyilvánvaló, hogy a webáruház nem maradhat napokig leállítva. Hiszen minél tovább van leállva, annál több pénzt veszítünk. Itt az ideje sietni. De mennyire? Úgy gondolom, ha egy órát leállunk, senki sem fog megőrülni. Igen, fogunk valamit veszíteni, de ha elkezdjük erőltetni, csak rosszabb lesz. Meghatározzuk az állásidő mértékét, ami egy órán belül megengedett.
Hogyan lehet mindezt lefoglalni? Az autóra mindenképpen szükség van: egy órás időtartam elég kevés. Mysql: itt már szükség van replikációra, élő replikációra, mert egy óra alatt 100 GB dump valószínűleg nem fog elférni. Statikus fájlok, képek: megint csak, egy óra alatt 500 GB valószínűleg nem fog beérkezni. Tehát jobb lenne azonnal másolni a képeket. Redis: itt érdekesebb a helyzet. A Redis-ben tárolódnak a session-ök — egyszerűen nem tudjuk eltemetni, mert az nem lenne túl jó: minden felhasználó kijelentkezne, a kosarak kiürülnének stb. Az emberek kénytelenek lennének újra megadni a bejelentkezési nevüket és jelszavukat, és sokan elbúcsúzhatnak, nem fejeznek be vásárlást. Ismét, a konverzió csökkenne. Másrészt a Redis pontosan aktuális, az utolsó bejelentkezett felhasználókkal, talán az sem szükséges. Jó kompromisszum lehet a Redis felvétele és a legutóbbi, vagy ha óránként készül, az óra előtti visszaállítása. Szerencsére a visszaállítása egy fájl másolását jelenti. A legérdekesebb történet pedig az Elasticsearch. Ki állított már be MySQL replikációt? Ki állított már be Elasticsearch replikációt? És kinek működött az rendesen? Amit mondani akarok: a rendszerünkben látunk egy bizonyos entitást. Úgy tűnik, hogy hasznos — de bonyolult.
Nehéz abban az értelemben, hogy mérnök kollégáinknak nincs tapasztalatuk vele. Vagy van negatív tapasztalatuk. Vagy azt értjük, hogy ez egy viszonylag új technológia, tele kisebb problémákkal vagy gyerekbetegségekkel. Gondolkodunk... Hűha, az elastic is elég nagy, a mentésből is sokáig helyre kell állítani, mit tegyünk? Értjük, hogy az elastic ebben az esetben a keresésre szolgál. De hogyan működik az online boltunk? Elmegyünk a marketingesekhez, megkérdezzük, honnan érkeznek az emberek. Ők azt válaszolják: "A látogatók 90%-a közvetlenül a Yandex Piacból jön a termékoldalra." És vagy vásárolnak, vagy nem. Tehát a keresésre csak a felhasználók 10%-ának van szüksége. Az elastic másolatának fenntartása, különösen különböző adatközpontok között, valóban sok bonyolultsággal jár. Mi a megoldás? Az elasticot fogjuk beállítani egy rezervált helyen, és nem csinálunk vele semmit. Ha az ügy elhúzódik, talán valamikor majd emeljük, de ez nem biztos. A lényeg, hogy a régi megállapításunk még mindig áll: azokat a szolgáltatásokat, amik nem befolyásolják a bevételeket, ismét nem rezerváljuk. Hogy a séma egyszerű maradjon.
Negyedik példa, még bonyolultabb.
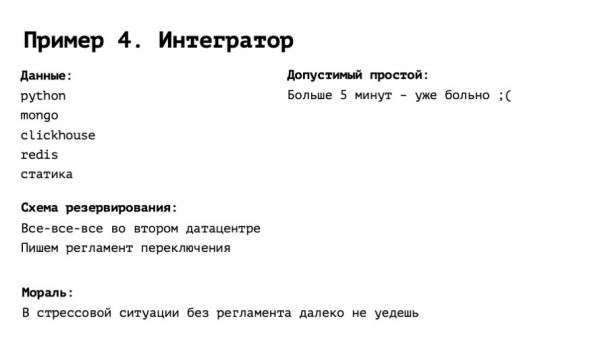
Integrátor: virágok értékesítése, taxis hívás, árucikkek értékesítése, összességében bármi. Komoly dolog, ami 24/7 működik, nagy számú felhasználó számára. Teljes értékű érdekes technológiai háttér, érdekes adatbázisokkal, megoldásokkal, magas terhelésre tervezve, és ami a legfontosabb, ha 5 percnél tovább nem működik, az fájdalmas. Nem csak azért, mert az emberek nem vásárolnak, hanem mert látják, hogy ez a dolog nem működik, csalódnak és lehet, hogy soha többé nem térnek vissza.
Rendben. Öt perc. Mit fogunk ezzel csinálni? Ebben az esetben érett módon, minden pénzt befektetve, valós rezervált területet építünk, mindenre és mindenkire replikálva, és lehet, hogy a lehető legjobban automatizáljuk az erre való áttérést. Ezen kívül ne felejtsük el megtenni egy fontos dolgot: tényleg megírni az átállási szabályzatot. A szabályzat, még ha minden automatizálva is van, lehet nagyon egyszerű. Olyan dolgokból állhat, mint "elindítani ezt a bizonyos ansible szkriptet", "a Route 53-ban bejelölni ezt a megoldást" és hasonlók – de ez egy pontos cselekvési lista kell legyen.
Úgy tűnik, minden világos. A replikáció átkapcsolása egy triviális feladat, vagy magától kapcsolódik át. A domain név átírása a dns-ben is hasonló. A probléma az, hogy amikor egy ilyen projekt összeomlik, pánik kezdődik, és még a legtapasztaltabb, szakállas adminisztrátorok is elérhetik ezt. Egy világos utasítás nélkül: „nyisd meg a terminált, lépj ide, a szerverünk címe továbbra is ez” — nehéz egy 5 perces újraélesztési időkeretet betartani. Ráadásul, amikor ezt a szabályozást alkalmazzuk, könnyen dokumentálhatunk valamilyen infrastruktúrában végbement változást, például — és ennek megfelelően módosíthatjuk a szabályozást.
De ha a biztonsági rendszer nagyon összetett, és egy pillanatban hibát követünk el, akkor a tartalékhelyünket is letehetjük, és ráadásul az adatokat is tök-fenékkel változtathatjuk meg mindkét helyszínen — ez nagyon szomorú lesz.
Ötödik példa, teljes hardcore
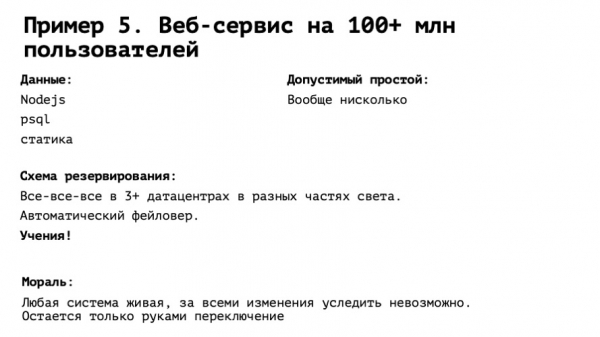
Nemzetközi szolgáltatás, több százmillió felhasználóval a világ minden táján. Minden időzóna, ami létezik, highload a maximumon, semmiképp sem lehet leállni. Egy perc — és szomorú lesz. Mit tegyünk? Teljes körűen tartalékolni. Mindent megcsináltunk, amit az előző példában mondtam, és még egy kicsit többet is. Ideális világ, a mi infrastruktúránk minden szempontból DevOps IaaC. Tehát minden a git-ben van, és csak a gombot kell megnyomni.
Mi hiányzik? Egy dolog — gyakorlatok. Ezek nélkül nem lehet. Úgy tűnik, hogy minden tökéletes, minden a kontrollunk alatt áll. Megnyomjuk a gombot, minden történik. Még ha így is van — amit tudunk, hogy ez nem így van — a rendszerünk kapcsolatban áll más rendszerekkel. Például, ez a dns a route 53-ból, s3 tárolók, integráció valamilyen api-val. Minden rendelkezésre állni nem tudunk ebben a tudományos kísérletben. És amíg valóban nem kapcsoljuk ki a kapcsolót — nem fogjuk tudni, hogy működik-e vagy sem.
Itt talán ennyi. Ne légy lusta és ne túlozz. És legyen veled az uptime!
Forrás: habr.com
