

A parancs ajánlatot tesz Rahul Bhatia, a Clairvoyant mérnöke arról beszél, hogy milyen fájlformátumok léteznek a big data-ban, milyen legelterjedtebb Hadoop formátumfunkciók vannak, és melyik formátumot érdemes használni.
Miért szükségesek a különböző fájlformátumok?
A HDFS-t támogató alkalmazások, mint a MapReduce és a Spark teljesítménye szempontjából komoly szűk keresztmetszet a keresési, olvasási és írási idők. Ezek a problémák súlyosbodnak, ha nem rögzített, hanem fejlődő sémával rendelkező, vagy valamilyen tárolási korlátozásokkal bíró nagy adathalmazok kezeléséről van szó.
A nagy adatok feldolgozása megnöveli a tároló alrendszer terhelését - a Hadoop redundáns módon tárolja az adatokat a megbízhatóság érdekében. A lemezek mellett a processzor, a hálózat, a bemeneti-kimeneti rendszer stb. is terhelődnek. Az adatok mennyiségének növekedésével az eltárolásuk és feldolgozásuk költségei is nőnek.
A különböző fájlformátumok pontosan ezeknek a problémáknak a megoldására lettek kifejlesztve. A megfelelő fájlformátum kiválasztása jelentős előnyöket hozhat:
- Gyorsabb olvasási idő.
- Gyorsabb írási idő.
- Megosztott fájlok.
- Sémák evolúciójának támogatása.
- Javított tömörítési támogatás.
Egyes fájlformátumokat általános használatra terveztek, míg mások specifikus variációkra készültek, és egyesek kifejezetten az adatok egyedi jellemzőiről szólnak. Tehát a választék valóban elég nagy.
Az Avro fájlformátum
A az adatok sorosítására széles körben használt – ez egy sorok alapú, más szóval text alapú, adatfájl-tárolási formátum a Hadoopban. A séma JSON formátumban van tárolva, megkönnyítve annak olvasását és értelmezését bármely program által. Maguk az adatok bináris formátumban, tömören és hatékonyan vannak elhelyezve.
Az Avro sorosítási rendszere nyelvsemleges. A fájlokat különböző programozási nyelvekkel lehet feldolgozni, jelenleg a C, C++, C#, Java, Python és Ruby támogatott.
Az Avro kulcsfontosságú jellemzője a megbízható séma támogatás, amely idővel változik, azaz fejlődik. Az Avro megérti a sémák változását — mezők eltávolítását, hozzáadását vagy módosítását.
Az Avro támogatja a változatos adattípusokat. Például létrehozhatunk egy rekordot, amely tartalmaz egy tömböt, egy felsorolható típust és egy alkotott rekordot.
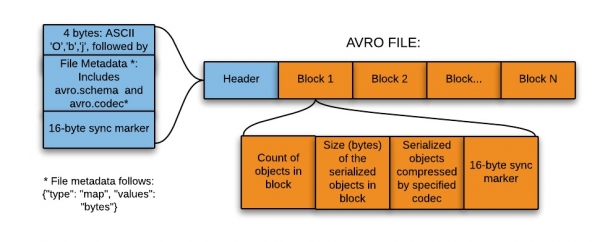
Ez a formátum ideális a data lake átmeneti zónájába való írásra (, vagyis data lake – különböző típusú adatok tárolására szolgáló példányok gyűjteménye az adatforrások mellett.
Tehát az adatlátóbevonati zónába való íráshoz ez a formátum a következő okok miatt a legmegfelelőbb:
- Az ebből a zónából származó adatokat általában teljes egészében olvassák be a további feldolgozás érdekében, így a sorokra alapozott formátum ebben az esetben hatékonyabb.
- Az alsóbb rendszerek könnyen kinyerhetik a sématáblákat a fájlokból – nem szükséges a sémák külön külső meta-tárolóban való tárolása.
- Bármely változás az alapértelmezett sémában könnyen kezelhető (séma evolúció).
A Parquet fájlformátum
A Parquet egy nyílt forráskódú fájlformátum a Hadoop számára, amely tárolja a beágyazott adatstruktúrákat lapos oszlopos formátumban..
A hagyományos soralapú megközelítéssel összehasonlítva a Parquet tárolási és teljesítmény szempontjából hatékonyabb.
Ez különösen hasznos olyan lekérdezések esetén, amelyek széles (sok oszlopos) táblázatból csak bizonyos oszlopokat olvasnak be. A fájlformátum lehetővé teszi, hogy csak a szükséges oszlopok olvashatók, így minimalizálva a bemeneti-kimeneti műveleteket.
Kis eltérés - magyarázat: ahhoz, hogy jobban megértsük a Parquet fájlformátumot a Hadoopban, nézzük meg, mi az az oszlopokra alapozott, azaz oszlopos formátum. Ebben a formátumban az egyes oszlopok azonos típusú értékei együtt kerülnek tárolásra.
, a bejegyzés tartalmazza az ID, név és osztály mezőket. Ebben az esetben az ID oszlop összes értéke együtt kerül tárolásra, ahogy a név oszlop értékei is, és így tovább. A tábla körülbelül így fog kinézni:
) és
Név
Osztály
1
emp1
d1
2
emp2
d2
3
emp3
d3
A soros formátumban az adatok így lesznek tárolva:
1
emp1
d1
2
emp2
d2
3
emp3
d3
A fájlok oszlopos formátumában ugyanazok az adatok így lesznek tárolva:
1
2
3
emp1
emp2
emp3
d1
d2
d3
Az oszlopos formátum hatékonyabb, amikor néhány oszlopot kell lekérdezni a táblázatból. Csak a szükséges oszlopokat olvassa be, mert ezek szomszédosak. Így minimalizálva a bemeneti-kimeneti műveleteket.
Például csak a NAME oszlopra van szüksége. A minden bejegyzést a készletből be kell tölteni, mezőkre kell bontani, majd ki kell nyerni a NAME adatokat. Az oszlopos formátum lehetővé teszi, hogy közvetlenül a Name oszlophoz lépjen, mivel az összes érték ehhez az oszlophoz együtt van tárolva. Nem kell végigszkennelni az egész bejegyzést.
Ezért az oszlopos formátum javítja a lekérdezések teljesítményét, mivel kevesebb keresési idő szükséges a szükséges oszlopokhoz való hozzáféréshez és csökken az I/O műveletek száma, mivel csak a szükséges oszlopokat olvassuk.
Egyedi jellemzője az, hogy ebben a formátumban képes beágyazott struktúrák tárolására. Ez azt jelenti, hogy a Parquet fájlban még a beágyazott mezőket is külön olvashatjuk, anélkül hogy az összes mezőt el kellene olvasnunk a beágyazott struktúrában. A Parquet beágyazott struktúrák tárolására darabolási és összesítési algoritmust használ.
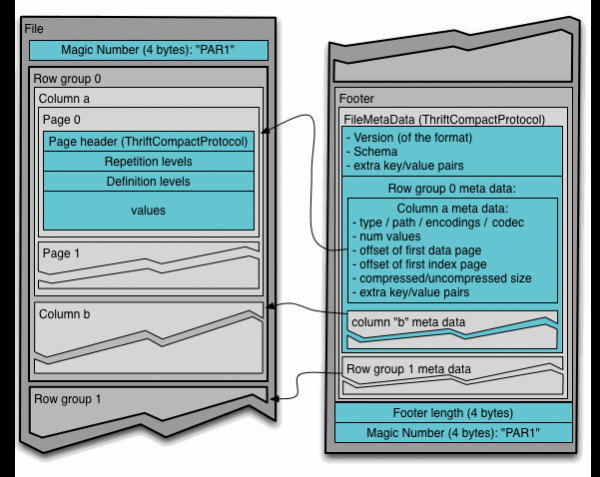
A Hadoop Parquet fájlformátumának megértéséhez meg kell ismernünk a következő kifejezéseket:
- Sorcsoport (row group): a sorok logikai vízszintes felosztása. A sorcsoport egy töredéket tartalmaz minden oszlopból az adathalmozaton.
- Oszloptöredék (column chunk): egy adott oszlop töredéke. Ezek az oszloptöredékek egy adott sorcsoportban találhatók, és garantáltan szomszédosak lesznek a fájlban.
- Oldal (page): az oszloptöredékek oldalakra vannak felosztva, amelyek egymás után lettek rögzítve. Az oldalak közös fejlécet tartalmaznak, így olvasáskor kihagyhatjuk a feleslegeseket.
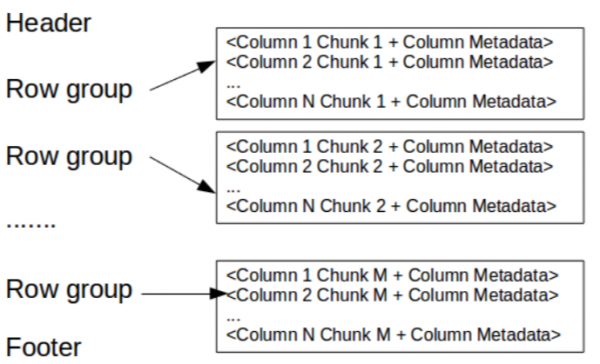
Itt a fejléc egyszerűen egy varázsszámot tartalmaz PAR1 (4 bájt), amely az fájlt az Parquet formátumú fájlként azonosítja.
A láblécben a következő található:
- A fájl metaadatai, amelyek tartalmazzák minden oszlop metaadatainak kezdő koordinátáit. Olvasáskor először a fájl metaadatait kell elolvasni, hogy megtaláljuk az összes szükséges oszloptöredéket. Ezután az oszlop töredékeket egymás után kell olvasni. A metaadatok közé tartozik a formátum verziója, a séma és bármilyen további kulcs-érték pár.
- A metaadatok hossza (4 bájt).
- A varázslatos szám PAR1 (4 bájt).
Az ORC fájlformátum
Optimális soros-oszlopos fájlformátum (Optimized Row Columnar, ) nagyon hatékony módot kínál az adatok tárolására, és úgy alakították ki, hogy áthidalja más formátumok korlátait. Az adatokat tökéletesen kompakt formában tárolja, lehetővé téve a felesleges részletek kihagyását — ezzel nem igényel nagy, bonyolult vagy manuálisan karbantartott indexek létrehozását.
Az ORC formátum előnyei:
- Minden feladat egy kimeneti fájlja, ami csökkenti a terhelést a NameNode-on (névcsomópont).
- A Hive adat típusok támogatása, beleértve a DateTime-ot, a tizedes és összetett adatokat (struktúra, lista, térkép és egyesülés).
- Ugyanazon fájl egyidejű olvasása különböző RecordReader folyamatok által.
- Fájlok szétszedésének lehetősége jelölők keresése nélkül.
- A legnagyobb lehetséges memóriaallokációs becslés a heap számára olvasási/írási folyamatokhoz az állomány láblécében található információk alapján.
- A metaadatokat a Protocol Buffers bináris formátumában tárolják, amely lehetővé teszi mezők hozzáadását és eltávolítását.
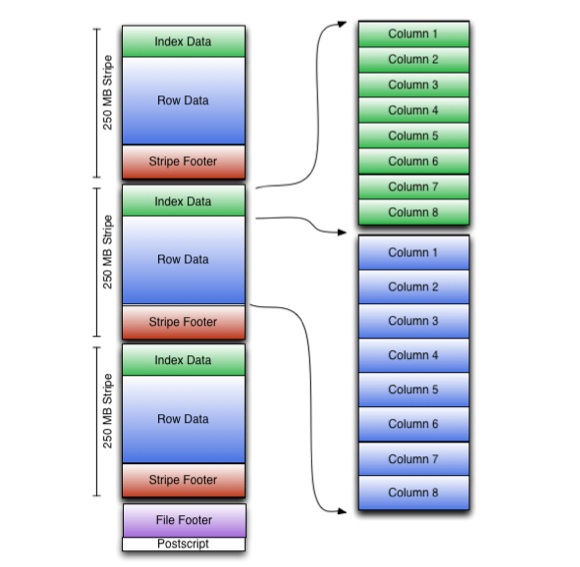
Az ORC egy fájlban tárolja a karakterlánc gyűjteményeket, míg a gyűjteményeken belül a soros adatok oszlopos formátumban tárolódnak.
Az ORC fájl csoportokat tárol, amelyek csíkoknak (stripes) nevezett elemek, és kiegészítő információkat a fájl láblécében. A fájl végén található postscript a tömörítési paramétereket és a tömörített lábléc méretét tartalmazza.
Alapértelmezés szerint a csík mérete 250 MB. A nagy méretű csíkok révén a HDFS-ből való olvasás hatékonyabb: nagy, folyamatos blokkokban történik.
A fájl láblécében a fájl csíkjainak listája, a sorok száma csíkonként és az egyes oszlopok adat típusa található. Itt található a count, min, max és sum végső értéke is minden oszlophoz.
A csík láblécében a stream helyeinek katalógusa található.
A soros adatokat a táblák beolvasásakor használják.
Az indexadatok az egyes oszlopok minimális és maximális értékeit, valamint a sorok helyét tartalmazzák az egyes oszlopokban. Az ORC indexek csak a csíkok és a sorcsoportok kiválasztására használhatók, nem pedig a lekérdezések megválaszolására.
Különböző fájlformátumok összehasonlítása
Avro a Parquet-hoz képest
- Az Avro soralapú tárolási formátum, míg a Parquet oszlopalapú módon tárolja az adatokat.
- A Parquet jobban illeszkedik az elemző lekérdezésekhez, tehát az olvasási és adatlekérdezési műveletek sokkal hatékonyabbak, mint az írás.
- Az írási műveletek az Avro-ban hatékonyabbak, mint a Parquet-ban.
- Az Avro érettebb az sémák evolúciójával. A Parquet csak a séma hozzáadását támogatja, míg az Avro multifunkcionális evolúciós megoldást tartalmaz, azaz mezők hozzáadását vagy módosítását.
- A Parquet ideális a több oszlopos táblában lévő oszlopok alhalmazának lekérdezésére. Az Avro megfelelő az ETL műveletekhez, ahol minden oszlopot kérdezünk.
ORC a Parquet-hoz képest
- A Parquet jobban tárolja a beágyazott adatokat.
- Az ORC jobban támogatja a predikátumok előtolását (predicate pushdown).
- Az ORC támogatja az ACID tulajdonságokat.
- Az ORC jobban tömöríti az adatokat.
Mit érdemes még olvasni a témában:
- .
- .
- .
Forrás: habr.com
