

Helló, Habr olvasók. Ezzel a cikkkel indítjuk el azt a ciklust, amely bemutatja általunk kifejlesztett hiper-konvergens rendszert, az AERODISK vAIR-t. Eredetileg azt terveztük, hogy az első cikkünkben mindent elmondunk, de a rendszer elég bonyolult, ezért fokozatosan haladunk.
A történet egy részének bemutatásával kezdjük, mélyebben belemerülünk az ARDFS fájlrendszerbe, amely a vAIR alapját képezi, és egy kicsit elmélkedünk a megoldás orosz piacon való pozicionálásáról.
A következő cikkekben részletesebben beszélünk különféle architektúra-összetevőkről (cluster, hypervisor, terheléselosztó, monitoring rendszer stb.), a beállítási folyamatról, érintjük a licencelési kérdéseket, külön bemutatjuk a stresszteszteket és természetesen írni fogunk a terhelési tesztelésről és a méretezésről. Egy külön cikket szentelünk a vAIR közösségi verziójának.
Az AERODISK egyfajta történet a tároló rendszerről? Vagy miért kezdtünk egyáltalán hiper-konvergenssel foglalkozni?
Eredetileg az ötlet, hogy saját hiper-konvergens rendszert hozzunk létre, 2010 környékén merült fel bennünk. Akkoriban még nem volt AERODISK, és hasonló, kereskedelmi hyperkonvergens rendszerek sem voltak a piacon. A feladatunk a következő volt: a helyi lemezekkel rendelkező szerverek halmazából, Ethernet protokollal összekapcsolva, kiterjesztett tárolót kellett létrehoznunk, ahol virtuális gépeket és szoftveres hálózatot is futtathattunk. Mindezt tulajdonképpen tároló rendszer (storage) nélkül kellett megvalósítani (mert a tárolókra és azok környezetére egyszerűen nem volt pénzünk, a saját tárolónkat pedig akkor még nem találtuk fel).
Sok open source megoldást kipróbáltunk, és végül megoldottuk ezt a feladatot, de a megoldás nagyon bonyolult volt, és nehezen reprodukálható. Ezenkívül a megoldás a "Müködik? Ne nyúlj hozzá!" kategóriájú volt. Így a feladat megoldása után nem folytattuk az ötletünk teljes termékké formálását.
Ezután eltávolodtunk ettől az ötlettől, de a gondolat, hogy ez a feladat megoldható, nem hagyott el minket, és a haszna egy ilyen megoldásnak több mint nyilvánvaló volt. Később a külföldi cégek által kiadott hiper-konvergens termékek csak megerősítették ezt az érzést.
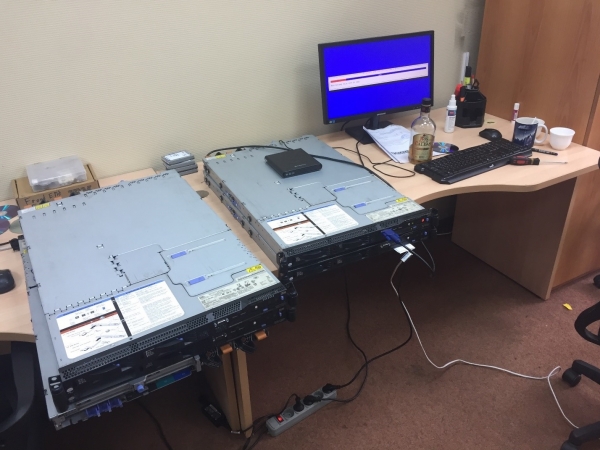
Ezért 2016 közepén visszatértünk ehhez a feladathoz egy teljes körű termék létrehozásának keretében. Akkor még nem voltak befektetői kapcsolataink, így a fejlesztési standot saját, nem túl nagy pénzünkből kellett megvásárolnunk. Használt szerverek és switchek után keresve az Avito-n hozzáfogtunk a munkához.
A fő kezdeti feladatunk egy saját, ha egyszerű is, de saját fájlrendszer létrehozása volt, amely automatikusan és egyenletesen osztaná el az adatokat virtuális blokkok formájában a klaszter n számú csomópontja között, amelyek Ethernet kapcsolaton keresztül vannak összekötve. Ezenkívül a fájlrendszernek jól és könnyen skálázhatónak kell lennie, valamint függetlennek a szomszédos rendszerektől, azaz az vAIR-tól „csupán tároló” formájában.
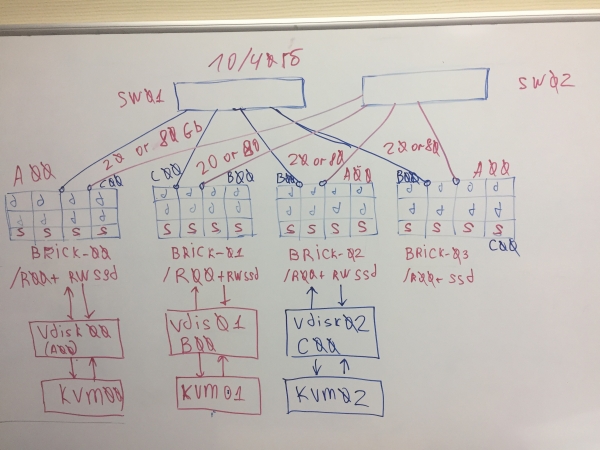
Az vAIR első koncepciója
Szándékosan lemondtunk a kész open source megoldások használatáról a kiterjedt tároló létrehozásához (ceph, gluster, lustre és hasonlók) a saját fejlesztésünk javára, mivel már sok projekt tapasztalatunk volt velük. Kétségtelen, hogy ezek a megoldások önállóan csodálatosak, és a légidiszk munkálatai előtt nem egy integrációs projektet valósítottunk meg velük. De egy dolog egy konkrét megrendelő feladatának megvalósítása, a személyzet képzése és esetleg egy nagy beszállító támogatásának megvétele, és teljesen más dolog olyan terméket létrehozni, amely könnyen reprodukálható és különböző feladatokhoz használható, amelyekről mint beszállító, talán még magunk sem tudunk. A második cél eléréséhez a meglévő open source termékek nem feleltek meg, ezért úgy döntöttünk, hogy saját magunknak fejlesztünk ki egy elosztott fájlrendszert.
Két év alatt néhány fejlesztő (akik az vAIR mellett a klasszikus tároló Engine-en is dolgoztak) elérték a megvalósítható eredményeket.
2018-ra megírtuk a legegyszerűbb fájlrendszert, és szükséges kiegészítésekkel láttuk el. A rendszer egy belső interkonektuson keresztül egyesítette a különböző szerverek helyi (fizikai) meghajtóit egy lapos tár területbe, és "virtuális blokkokra" osztotta őket, majd a virtuális blokkokból blokkeszközöket hoztunk létre az eltérő hibabiztossági fokkal, amelyeken KVM hypervisor segítségével virtuális gépeket hoztunk létre és futtattunk.
A fájlrendszer nevét nem bonyolítottuk túl, és egyszerűen ARDFS-nek neveztük el (kitaláljátok, mit jelent))
Ez a prototípus jól nézett ki (természetesen nem vizuálisan, akkor még nem volt vizuális megjelenés) és jó teljesítmény- és skálázhatósági eredményeket mutatott. Az első tényleges eredmények után elindítottuk a projektet, létrehozva egy teljes fejlesztési környezetet és egy külön csapatot, amely kizárólag a vAIR-ra összpontosított.
Pont ekkorra érett meg a megoldás általános architektúrája, amely azóta sem szenvedett komoly változásoktól.
Mélyedjünk el az ARDFS fájlrendszerben
Az ARDFS a vAIR alapját képezi, amely elosztott hibamentes adatmentést biztosít az egész klaszter számára. Az ARDFS egyik (de nem egyetlen) jellegzetes sajátossága, hogy nem használ semmiféle kiegészítőt dedikált szerverek az irányításhoz és a kezeléshez. Ezt eredetileg a megoldás konfigurálásának egyszerűsítésére és megbízhatóságának növelésére tervezték.
Tárolási struktúra
A klaszter minden node-ján belül az ARDFS egy logikai medencét szervez az összes elérhető lemezterületből. Fontos megérteni, hogy a medence még nem adatokból vagy formázott térből áll, hanem csak címkéből, azaz bármely node, ahol vAIR van telepítve, automatikusan hozzáadódik a klaszterhez és a lemezforrások automatikusan közösen elérhetővé válnak az egész klaszter számára (és jövőbeni adatok tárolására is). Ez a megközelítés lehetővé teszi, hogy könnyedén adjunk hozzá vagy távolítsunk el node-okat anélkül, hogy komolyan befolyásolnánk a már működő rendszert. Tehát a rendszert nagyon könnyen lehet skálázni „téglák” hozzáadásával vagy eltávolításával a klaszterben, amikor szükséges.
Az ARDFS medencére virtuális lemezek (tárolási objektumok virtuális gépekhez) kerülnek, amelyek 4 megabájtos virtuális blokkokból épülnek fel. A virtuális lemezeken közvetlenül tárolják az adatokat. A virtuális lemezek szintjén is beállítható a hibamentességi séma.
Ahogy azt már kitalálhattad, a lemezrendszer megbízhatósága érdekében nem a RAID (Redundant Array of Independent Disks) koncepciót alkalmazzuk, hanem a RAIN-t (Redundant Array of Independent Nodes). Azaz a megbízhatóságot a node-okon, nem pedig a lemezeken mérjük, automatizáljuk és kezeljük. A lemezek természetesen szintén tárgyak a tárolóban, ezek, akárcsak minden más, figyelve vannak, velem minden standard művelet, beleértve a helyi hardver RAID kialakítását, de a klaszter kifejezetten node-okon működik.
Olyan helyzetben, amikor nagyon szeretnénk RAID-ot (például olyan forgatókönyvben, amely támogatja a többszörös hibákat kis klaszterekben), semmi sem akadályozza meg, hogy helyi RAID-vezérlőket használjunk, és ezekre egy elosztott tárolót és RAIN-architektúrát építsünk. Ez a forgatókönyv teljesen életképes és támogatott a részünkről, ezért beszélni fogunk róla a vAIR alkalmazási forgatókönyveivel foglalkozó cikkben.
A tároló megbízhatósági sémái
A vAIR virtuális lemezek megbízhatósági sémái a következő kettő lehet:
1) Replikációs faktor vagy egyszerűen replikáció – ez a megbízhatósági módszer egyszerű, "mint egy bot és kötél". Szinkron replikációt hajt végre a node-ok között 2-es (2 másolat a klaszteren) vagy 3-as (3 másolat) faktornál. Az RF-2 lehetővé teszi, hogy egy virtuális lemez egy node meghibásodását elviselje a klaszterben, de "megeszi" a hasznos kapacitás felét, míg az RF-3 elviseli 2 node hibáját a klaszterben, de 2/3 hasznos kapacitást már rezervál saját igényeihez. Ez a séma nagyon hasonlít a RAID-1-re, azaz a RF-2-re konfigurált virtuális lemez ellenáll bármelyik egy node hibájának a klaszterben. Ebben az esetben az adatok rendben lesznek, és még a bemenet/kimenet sem áll meg. Amikor a hibás node újra online állapotba kerül, automatikus helyreállítás/szinkronizálás kezdődik.
Az alábbiakban a RF-2 és RF-3 adatelosztás példáit láthatod normál működés közben és hibahelyzetekben.
Van egy 8 MB-os, egyedi (hasznos) adatokat tartalmazó virtuális gépünk, amely 4 vAIR csomóponton működik. Nyilvánvaló, hogy a valóságban valószínűleg nem lesz ilyen kicsi az adatméret, de az ARDFS működési logikáját tükröző séma esetében ez a példa a legérthetőbb. Az AB virtuális blokkok 4 MB-ot tartalmaznak, amelyek egyedi adatokkal rendelkeznek. Az RF-2 esetén két másolat készül ezekből a blokkokból: A1 + A2 és B1 + B2. Ezeket a blokkokat „elhelyezik” a csomópontokon, elkerülve, hogy ugyanazok az adatok egyszerre egy csomóponton legyenek, tehát az A1 másolat nem lesz egy csomóponton az A2 másolattal. A B1 és B2 hasonlóképpen.
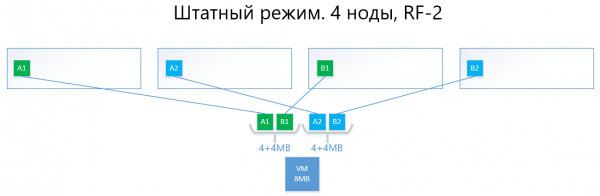
Ha az egyik csomópont (például a 3-as csomópont, ahol a B1 másolat található) meghibásodik, akkor ez a másolat automatikusan aktiválódik egy olyan csomóponton, ahol nincs a másolatának másolata (azaz a B2 másolat).
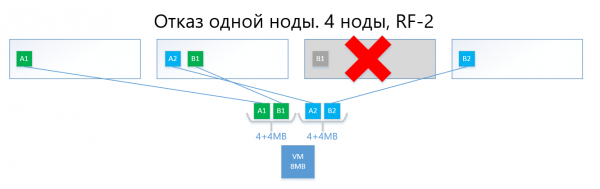
Így a virtuális lemez (és az VM ennek megfelelően) könnyen túlélik egy csomópont meghibásodását az RF-2 séma keretein belül.
A replikációs séma, a maga egyszerűsége és megbízhatósága ellenére, ugyanazzal a problémával küzd, mint a RAID1 – kevés hasznos terület.
2) A törlő kódolás vagy erasure coding (más néven „túlkódolás”, „törlő kódolás” vagy „túlkódolási kód”) éppen azért létezik, hogy megoldja a fenti problémát. Az EC a redundancia sémája, amely magas adatkapacitást biztosít kevesebb lemezterület-felhasználással szemben, mint a replikáció. Ennek a mechanizmusnak a működési elve hasonló a RAID 5, 6, 6P sémákéhoz.
A kódolás során az EC folyamat felosztja a virtuális blokkot (alapértelmezés szerint 4 MB) több kisebb „adatdarabra” az EC séma függvényében (például a 2+1 séma minden 4 MB-os blokkot 2 darabra oszt 2 MB-onként). Ezután a folyamat generál a „darabokhoz” legfeljebb egy, az előzőleg felosztott részek egyikéhez hasonló „paritásdarabot”. A dekódolás során az EC generálja a hiányzó darabokat az egész klaszterben fennmaradó adatok beolvasásával.
Például, egy EC 2 + 1 sémával rendelkező virtuális lemez, amely négy csomóponton valósul meg, nyugodtan elviseli egy csomópont meghibásodását a klaszterben, akárcsak az RF-2. E mellett az üzemeltetési költségek alacsonyabbak lesznek; különösen az RF-2 hasznos kapacitásának aránya 2, míg az EC 2+1 esetében 1,5.
Ha egyszerűbben szeretnénk leírni, a lényeg az, hogy a virtuális blokk 2-8 (miért 2-től 8-ig, arról lent talál információt) „darabra” van osztva, és ezekhez a darabokhoz hasonló méretű „paritásdarabok” kerülnek kiszámításra.
A végén az adatok és a paritás egyenletesen oszlik el a klaszter összes node-ján. A replikációhoz hasonlóan az ARDFS automatikusan osztja el az adatokat a node-okon oly módon, hogy megakadályozza az azonos adatok (adatok másolatainak és azok paritásának) egy node-on való tárolását, ezzel csökkentve az adatvesztés esélyét, ha az adatok és a paritás váratlanul egy olyan tároló node-on végzik, ami meghibásodik.
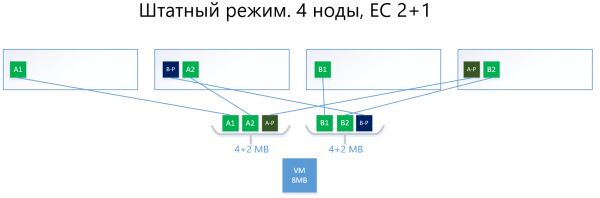
Alább egy példa található, ugyanazzal a virtuális géppel 8 MB és 4 node esetén, de már az EC 2+1 séma szerint.
Az A és B blokkok két 2 MB-os részre oszlanak (két részre, mert 2+1), tehát A1+A2 és B1+B2. A replikával ellentétben A1 nem A2 másolata, ez egy virtuális A blokk, két részre osztva, és ugyanez vonatkozik a B blokkra is. Így kapunk két 4MB-os halmazt, mindkettőben két kétmegabájtos résszel. Továbbá, ezekhez a halmazokhoz legfeljebb egy darab (tehát 2 MB) paritás számítható, így összesen + 2 paritásdarabot kapunk (A-P és B-P). Tehát összesen 4×2 adat + 2×2 paritás.
Ezután a darabok úgy "oszlanak el" a node-okon, hogy az adatok ne ütközzenek a paritásukkal. Tehát A1 és A2 nem lesznek egy node-on az A-P-vel.
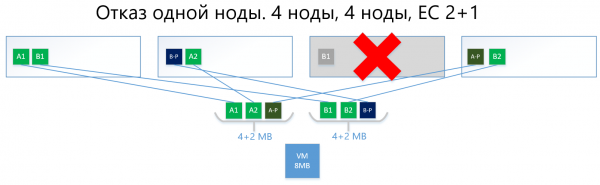
Ha az egyik node meghibásodik (mondjuk a harmadik), a sérült B1 blokk automatikusan helyreállításra kerül a B-P paritásból, amely a 2-es node-on található, és aktiválódik azon a node-on, ahol nincs B-paritás, azaz a B-P darab. Ebben a példában ez az 1-es node.
Biztos vagyok benne, hogy az olvasóknak felmerül a kérdés:
„Minden, amit leírt, már régóta megvalósult a versenytársaknál és az open source megoldásokban, miben más az önök ARDFS EC megvalósítása?”
A továbbiakban pedig az ARDFS működésének érdekes sajátosságai következnek.
Erasure coding, a rugalmasságra fókuszálva
Kezdetben egy meglehetősen rugalmas X+Y EC sémát terveztünk, ahol X a 2-től 8-ig terjedő számot, míg Y az 1-től 8-ig terjedő számot jelenti, de mindig kisebb vagy egyenlő X-nel. Ez a séma a rugalmasság érdekében készült. A virtuális blokkra osztott adatdarabok (X) számának növelése csökkenti a költségeket, ezzel növelve a hasznos teret.
A paritásdarabok (Y) számának növelése növeli a virtuális lemez megbízhatóságát. Minél nagyobb az Y értéke, annál több node a klaszterben hibásodhat meg. Természetesen a paritás mennyiségének növelése csökkenti a hasznos kapacitást, de ez az ár a megbízhatóságért.
A teljesítmény és az EC sémák közötti kapcsolat szinte egyenes: minél több "darab", annál alacsonyabb a teljesítmény, itt nyilvánvalóan egy kiegyensúlyozott megközelítés szükséges.
Ez a megközelítés lehetővé teszi az adminisztrátorok számára, hogy maximálisan rugalmasan konfigurálják a megosztott tárolót. Az ARDFS medencéjén belül bármilyen hibajavító sémát és azok kombinációit felhasználhatjuk, ami véleményünk szerint szintén nagyon hasznos.
Az alábbi táblázatban néhány (nem minden lehetséges) RF és EC séma összehasonlítása található.
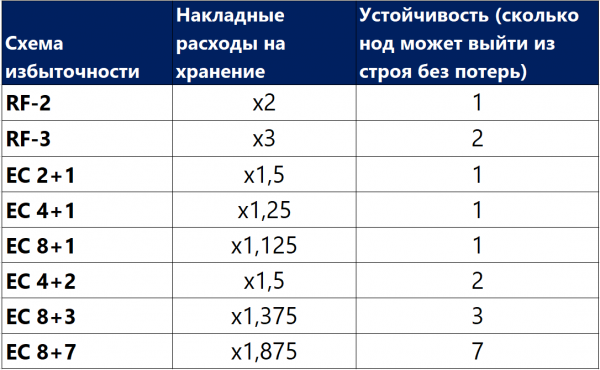
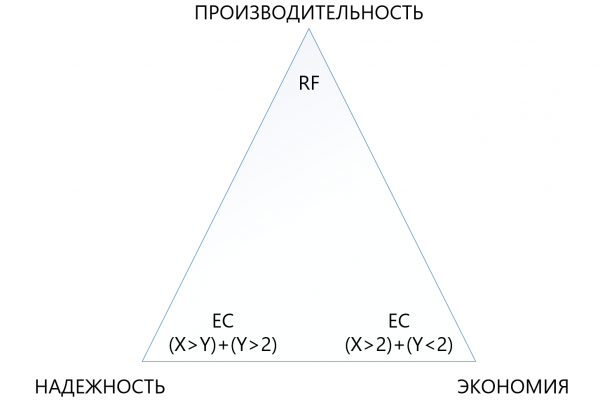
A táblázatból látható, hogy még a legbonyolultabb EC 8+7 kombináció is, amely lehetővé teszi, hogy akár 7 csomópontot is elveszítsünk a klaszterben, kevesebb hasznos helyet "igényel" (1,875 a 2-höz képest), mint a standard replikáció, miközben 7-szer jobban véd, ezért ez a védelmi mechanizmus, bár bonyolultabb, jelentősen vonzóbb olyan helyzetekben, amikor maximális megbízhatóságot kell biztosítani a lemezterület hiányos körülményei között. Ugyanakkor meg kell érteni, hogy minden "plusz" az X-hez vagy Y-hoz teljesítménybeli többletkiadást jelent, ezért a megbízhatóság, a költség és a teljesítmény közötti háromszögben nagyon óvatosan kell választani. Emiatt egy külön cikket szentelünk a törléses kódolás méretezésének.
A fájlrendszer megbízhatósága és autonómiája
Az ARDFS helyben fut minden klasztercsomóponton, és saját eszközeivel szinkronizálja őket külön Ethernet interfészeken keresztül. Fontos szempont, hogy az ARDFS nemcsak az adatokat, hanem a tárolásra vonatkozó metadatokat is önállóan szinkronizálja. Az ARDFS-en végzett munka során párhuzamosan tanulmányoztunk számos létező megoldást, és felfedeztük, hogy sokan külső elosztott DBMS segítségével szinkronizálják a fájlrendszer metaadatait, amit mi is használunk a konfigurációk szinkronizálásához, ám nem a fájlrendszer metaadataihoz (erről és más kapcsolódó alrendszerekről a következő cikkben írunk).
A fájlrendszer metaadatainak szinkronizálása egy külső DB-vel természetesen működő megoldás, azonban ebben az esetben a tárolt adatok konzisztenciája az ARDFS-en a külső DB-től és annak viselkedésétől függne (ami, finoman szólva, szeszélyes dámának mondható), ami a mi véleményünk szerint nem jó. Miért? Ha a fájlrendszer metaadatai megsérülnek, akkor a fájlok is búcsút inthetnek, ezért úgy döntöttünk, hogy bonyolultabb, de megbízhatóbb utat választunk.
Az ARDFS metaadat-szinkronizáló alrendszerét saját magunk fejlesztettük ki, és teljesen függetlenül működik a kapcsolódó alrendszerektől. Tehát egyetlen más alrendszer sem képes megsérteni az ARDFS adatait. Véleményünk szerint ez a legmegbízhatóbb és helyes út, de hogy ez valóban így van-e, az majd az idő megmondja. Ezenkívül e megközelítés további előnyökkel is jár. Az ARDFS függetlenül használható a vAIR-tól, egyszerűen mint kiterjesztett tároló, amire mi biztosan támaszkodni fogunk a jövőbeli termékeinkben.
Végül, az ARDFS kidolgozásával egy rugalmas és megbízható fájlrendszert kaptunk, amely lehetővé teszi, hogy válasszunk, hol lehet költséget megtakarítani, vagy mindent a teljesítményre bízzunk, vagy egy megbízható tárolót hozzunk létre mérsékelt költségek mellett, de csökkentett teljesítményigény mellett.
A egyszerű licencelési politikával és rugalmas szállítási modellel (előreugorva, a vAIR licencelése nodonként történik, és vagy szoftverként, vagy mint PAK kerül forgalmazásra) ez lehetővé teszi, hogy rendkívül precízen igazítsuk a megoldást a legkülönbözőbb ügyféligényekhez, és ezt a kiegyensúlyozást később is könnyen fenntartjuk.
Kinek szüksége van erre a csodára?
Egyrészt elmondható, hogy a piacon már vannak szereplők, akik komoly megoldásokkal rendelkeznek a hiper-konvergens területen, és hogy hová is próbálunk behatolni. Úgy tűnik, hogy ez az állítás igaz, DE…
Másrészt, amikor terepen járunk és kommunikálunk az ügyfelekkel, mi és partnereink azt látjuk, hogy ez egyáltalán nem így van. Számos feladat vár a hiper-konvergenciára, valahol az emberek csak nem tudták, hogy ilyen megoldások léteznek, valahol drágának tűnt, valahol alternatív megoldások tesztjei nem sikerültek, máshol pedig egyszerűen tiltanak a vásárlástól, mert szankciók vannak. Összességében a terület kiaknázatlan maradt, ezért nekiálltunk megművelni a szűzkertet))).
Mikor jobb a HDFS, mint a GKS?
A munka során gyakran megkérdezik tőlünk, mikor érdemes alkalmazni a klasszikus tárolórendszer (СХД) sémát, és mikor a hiper-konvergens megoldásokat? Sok cég, amely hiper-konvergens rendszereket gyárt (különösen azok, akiknek a portfóliójában nincs СХД), azt mondja: „A СХД lejárt, csak a hiperkonvergens!” Ez egy merész állítás, de nem teljesen tükrözi a valóságot.
Igazából a СХД piaca valóban a hiper-konvergens megoldások irányába halad, de mindig van egy „de”.
Először is, a klasszikus СХД séma szerint felépített adatközpontok (ЦОД) és IT-infrastruktúrák nem alakíthatók át egyszerűen, ezért ezen infrastruktúrák modernizálása és bővítése még 5-7 évnyi örökség.
Másodszor, azok az infrastruktúrák, amelyeket most építenek (ezalatt az Orosz Föderációt értjük), többségében klasszikus СХД sémát használnak, és nem azért, mert nem ismerik a hiperkonvergens megoldásokat, hanem mert a hiperkonvergens piac új, a megoldások és a standardok még nem stabilizálódtak, az IT-szakemberek még nem képzettek, kevés a tapasztalat, de az adatközpontokat itt és most meg kell építeni. Ez a tendencia még 3-5 évig fog tartani (és aztán még 1-2 év a megszülető örökség, lásd az 1. pontot).
Harmadszor, tiszta technikai korlátozás, hogy a további 2 milliszekundumos késlekedés íráskor (természetesen a helyi cache figyelembevételével) a díj a disztribúciós tárolásért.
Ne felejtsük el a nagy fizikai szerverek használatát sem, amelyek kedvelik a merevlemez-rendszer függőleges skálázását.
Sok olyan fontos és népszerű feladat van, ahol a СХД jobban teljesít, mint a hiper-konvergens megoldások. Ezzel természetesen nem fognak egyetérteni azok a gyártók, akiknek a termékportfóliójában nincs СХД, de mi készen állunk arra, hogy érveinket megvédjük. Természetesen mi, mint mindkét termék fejlesztői, a jövőbeli publikációk egyikében biztosan összehasonlítjuk a СХД-t és a hiper-konvergenst, és világosan bemutatjuk, hogy mely körülmények között mi működik jobban.
Hol fognak a hiper-konvergens megoldások jobban működni, mint a СХД?
A fenti pontok alapján három nyilvánvaló következtetést lehet levonni:
- Ott, ahol a további 2 milliszekundumos késlekedés íráskor, melyek tartósan felmerülnek bármely termelésben (jelenleg nem a szintetikusra gondolunk, a szintetikusokon akár nanoszekundumokat is lehet mutatni), nem kritikus, a hiper-konvergens megoldások alkalmasak lesznek.
- Ahol a nagy fizikai szerverek terhelése sok kis virtuálisra alakítható és elosztható a csomópontok között, ott a hiperkonvergens megoldások is jól működnek.
- Ahol a vízszintes skálázhatóság prioritást élvez a függőlegeshez képest, ott a GKS is tökéletesen helytáll.
Mik ezek a megoldások?
- Minden standard infrastruktúra szolgáltatás (könyvtárszolgáltatás, e-mail, dokumentumkezelő rendszerek, fájlszerverek, kis- vagy közepes ERP és BI rendszerek stb.). Ezt „közönséges számításoknak” nevezzük.
- A felhőszolgáltatók infrastruktúrája, ahol gyorsan és standardizált módon kell vízszintesen skálázni, és könnyen „felosztani” nagy számú virtuális gépet az ügyfelek számára.
- Infrastruktúra vagy azok képernyőre történő áthelyezésére az egérrel való húzással a drag&drop módban. Új funkcióként bevezetésre került a virtuális asztalok rögzítése, amely lehetővé teszi a szükséges számú asztal nyitva tartását, függetlenül attól, hogy üresek-e vagy sem. (VDI), ahol sok kis felhasználói virtuális gép indul el és úszik a homogén klaszterben.
- Fiókhálózatok, ahol minden fiókban szükséges egy standard, megbízható, de ugyanakkor olcsó infrastruktúra 15-20 virtuális gépből.
- Bármilyen elosztott számítás (big data szolgáltatások, például). Ahol a terhelés nem „mélyen”, hanem „szélesen” terjed.
- Tesztkörnyezetek, ahol megengedhetők a kisebb késések, de vannak költségvetési korlátok, mivel ezek tesztelések.
Jelenleg ezekre a feladatokra fejlesztettük ki az AERODISK vAIR-t, és ezekre összpontosítunk (jelenleg sikeresen). Lehetséges, hogy ez hamarosan megváltozik, mivel a világ nem áll meg.
Tehát...
Ezzel befejeződött a széles cikkciklus első része, a következő cikkben bemutatjuk a megoldás architektúráját és a használt komponenseket.
Örömmel várjuk kérdéseiket, javaslataikat és konstruktív vitáikat.
Forrás: habr.com
