

Ha időszakos (timeseries db) adatbázist használsz a statisztikai weboldal fő tárolójaként, akkor a probléma megoldása helyett rengeteg fejfájást szerezhetsz. Egy olyan projektben dolgozom, ahol ilyen adatbázist használunk, és néha az InfluxDB, amiről szó lesz, teljesen váratlan meglepetéseket okozott. : a felmerült problémák az InfluxDB 1.7.4 verzióra vonatkoznak.
MegjegyzésMiért időszakos adatbázis?
A projekt a blokkláncok különböző tranzakcióinak nyomon követésére és statisztikák megjelenítésére épül. Pontosabban, figyelemmel kísérjük a stabilcoinok kibocsátását és elégetését (
). Ezekre a tranzakciókra alapozva grafikonokat kell készíteni és összefoglaló táblázatokat mutatni.A tranzakciók elemzése során felmerült az ötlet: az InfluxDB időszakos adatbázist használni fő tárolóként. A tranzakciók időpontok, így jól illeszkednek az időszakos adatok modelljébe.
A gyűjtési funkciók is nagyon kényelmesen néztek ki — ideálisak hosszú időszakok grafikonjainak feldolgozásához. A felhasználónak egy évre szóló grafikonra van szüksége, de az adatbázisban öt perces időkerettel rendelkezik az adatsor. Haszontalan lenne az összes százezer pontot elküldeni — a hosszú feldolgozási időn kívül a képernyőre sem férne el. Írhatsz saját megoldást az időkeret növelésére, vagy használhatod az Influx által kínált beépített aggregáló funkciókat. Ezek segítségével az adatokat napi bontásban csoportosíthatod, és elküldheted a szükséges 365 pontot.
Kicsit zavaró volt, hogy általában az ilyen adatbázisokat metricák gyűjtésére használják. Szerverek monitorozása, IoT-eszközök, mindazok, amelyekből „millió” dátum-érték pár folyik: [<idő> — <metrika értéke>]. De ha az adatbázis jól működik nagy adatforgalom mellett, akkor miért kellene, hogy a kis mennyiség problémákat okozzon? Ezzel a gondolattal kezdtük el használni az InfluxDB-t.
Mi még kényelmes az InfluxDB-ben
A már említett aggregáló funkciókon kívül van egy csodálatos dolog is —
folyamatos lekérdezések doc (megőrzési politikák
Továbbá elérhető megőrzési irányelvek () — a beállítás, amely lehetővé teszi az adatok törlését egy bizonyos időszak után. Hasznos, ha például egy héten keresztül a CPU terhelését kell tárolni másodpercenkénti mérésekkel, míg néhány hónapos távolságban ilyen pontosságra nincs szükség. Ilyen helyzetben a következő lépéseket lehet tenni:
- hozni egy folyamatos lekérdezést az adatok egy másik táblába történő aggregálásához;
- az első táblához meg kell határozni a metrikák törlésének politikáját, amelyek idősebbek, mint a hét.
Így az Influx automatikusan csökkenti az adatok méretét és törli a felesleget.
A tárolt adatokkal kapcsolatban
Nem tárolunk sok adatot: körülbelül 70 ezer tranzakciót és még egy millió piaci információs pontot. Új bejegyzések hozzáadása — legfeljebb 3000 pont naponta. Vannak metrikák a webhelyről is, de azokból kevés van, és a retention policy szerint nem tárolják őket egy hónapnál tovább.
Problems
A szolgáltatás fejlesztése és tesztelése során egyre kritikusabb problémák merültek fel az InfluxDB használata során.
1. Adatok törlése
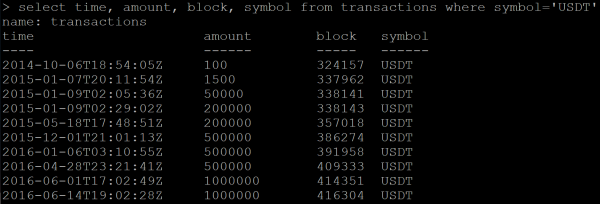
Van egy sor adat tranzakciókkal:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Eredmény:
Küldöm az adat törlési parancsot:
DELETE FROM transactions WHERE symbol='USDT'Ezután egy lekérdezést futtatok az már törölt adatok lekérésére. Az Influx ahelyett, hogy üres választ adna, visszaad egy részt azokról az adatokból, amelyeknek törlődnie kellett volna.
Megpróbálom törölni az egész táblát:
DROP MEASUREMENT transactionsEllenőrzöm a tábla törlését:
SHOW MEASUREMENTSA táblát nem látom a listában, de egy új adatigénylés még mindig ugyanazt a tranzakciós készletet adja vissza.
A probléma egyszer fordult elő velem, mivel az eset a törlésre — egyedi eset. De az adatbázis ilyen viselkedése egyértelműen nem felel meg a 'helyes' működés kereteinek. Később egy githubon találtam egy nyitott témájú problémát, ami majdnem egy éve volt.
Ennek eredményeként az egész adatbázis törlése és helyreállítása segített.
2. Lebegőpontos számok
A beépített InfluxDB funkciók használata közben végzett matematikai számítások pontossági hibákat adnak. Nem mintha ez valami szokatlan lenne, de kellemetlen.
Az én esetemben az adatok pénzügyi jellegűek, és ezeket szeretném magas pontossággal feldolgozni. Ezért tervezem elhagyni a folyamatos lekérdezéseket.
3. A folyamatos lekérdezések nem alkalmazhatók különböző időzónákhoz
A szolgáltatáson van egy táblázat a napi tranzakciós statisztikákról. Minden napra csoportosítani kell az összes tranzakciót az adott napon. Azonban a nap minden felhasználó számára más időpontban kezdődik, így a tranzakciókészlet is eltérő. UTC szerint van eltolásra, amelyeket aggregálni kell az adatok.
Az InfluxDB időalapú csoportosítás esetén további eltolás megadását is lehetővé teszi, például a moszkvai időhöz (UTC+3):
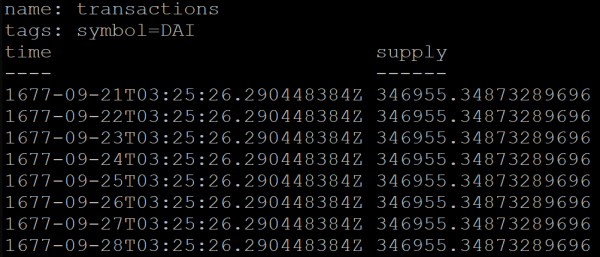
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)De a lekérdezés eredménye hibás lesz. Valamiért a napok szerint csoportosított adatok 1677-ben kezdődnek (az InfluxDB hivatalosan támogatja az ettől az évtől kezdődő időszakot):
A probléma megkerülése érdekében ideiglenesen átállítottuk a szolgáltatást UTC+0-ra.
4. Teljesítmény
Az interneten sok benchmark található az InfluxDB és más adatbázisok összehasonlításával. Első megismerkedésem során marketinganyagoknak tűntek, de most már úgy gondolom, van benne igazság.
Megosztom a saját esetemet.
A szolgáltatás egy API metódust biztosít, amely az előző nap statisztikáját adja vissza. A számítások során a metódus háromszor lekérdezi az adatbázist a következő lekérdezésekkel:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCMagyarázat:
- Az első lekérdezésben megkapjuk az utolsó adatpontokat minden érméhez a piaci adatokkal. Esetemben nyolc adatpont van nyolc érméhez.
- A második lekérdezés egy legújabb adatpontot ad vissza.
- A harmadik lekérdezés a legutolsó 24 órás tranzakciók listáját kérdezi le, amelyek több száz is lehetnek.
Megjegyzem, hogy InfluxDB-ben a címkék és az idő alapján automatikusan indexet épít, ami felgyorsítja a lekérdezéseket. Az első lekérdezésben symbol – ez egy címke.
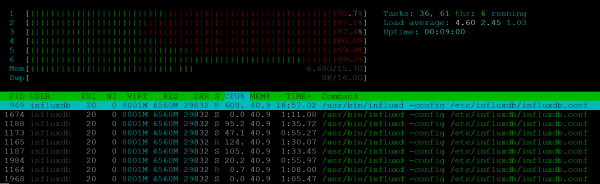
Stressztesztet végeztem ezen az API metóduson. 25 RPS esetén a szerver teljesen kihasználta a hat CPU-t:
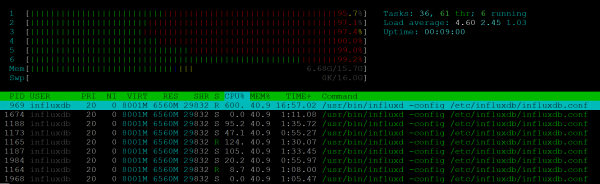
Ugyanakkor a NodeJs folyamat egyáltalán nem terhelte meg a rendszert.
A válaszok sebessége már 7-10 RPS-nél csökkent: ha egy kliens 200 ms alatt kaphatott választ, akkor 10 kliensnek másodperceket kellett várnia. A 25 RPS az a határ, ahol a stabilitás megsérült, a klienseknél 500-as hibák jelentkeztek.
Egy ilyen teljesítménnyel az Influx használata a projektünkben lehetetlen. Sőt, egy olyan projektben, ahol a monitorozást sok ügyfélnek be kell mutatni — hasonló problémák merülhetnek fel, és a metrikák szervere túlterhelődhet.
Következtetés
A legfontosabb következtetés a szerzett tapasztalatból az, hogy nem szabad ismeretlen technológiát bevonni a projektbe megfelelő elemzés nélkül. Egy egyszerű szűrés a GitHub nyilvános jegyzőkönyvein információt adhatott volna, hogy ne válasszunk InfluxDB-t mint fő adattárolót.
Az InfluxDB jól illeszkedett volna a projekt feladataihoz, de a gyakorlat azt mutatta, hogy ez az adatbázis nem felel meg az igényeknek és sok hibát vét.
A projekt tárolójában már megtalálható a 2.0.0-beta verzió, reméljük, hogy a második verzióban jelentős fejlesztések lesznek. Én pedig most átmegyek a TimescaleDB dokumentációjának tanulmányozására.
Forrás: habr.com
