

Üdvözlöm, Habr-blogger! Hagyományos módon folytatjuk az érdekes anyagok megosztását az új kurzusok kezdete előtt. Ma kifejezetten nektek fordítottuk le a Google Cloud Spanner-ről szóló cikket, amelyet a tanfolyam elindulásához időzítettünk. .
Eredetileg közzétéve itt: .
Mint olyan vállalat, amely számos felhőalapú POS megoldást kínál a kiskereskedőknek, vendéglátóknak és online kereskedőknek világszerte, a Lightspeed különféle adatbázis-platformokat használ sokféle tranzakciós, analitikai és keresési esetre. Minden adatbázis-platformnak megvannak a maga erősségei és gyengeségei. Következésképpen, amikor a Google bemutatta a Cloud Spanner-t a piacon - ígéretes funkciókkal, amelyek eddig ismeretlenek voltak a relációs adatbázisok világában, mint például a gyakorlatilag korlátlan horizontális skálázhatóság és a 99,999% -os szolgáltatási szint szerződés (SLA) - nem tudtuk kihagyni a lehetőséget, hogy a kezünkbe kerüljön!
Annak érdekében, hogy átfogó képet adjunk tapasztalatainkról a Cloud Spanner-rel kapcsolatban, valamint az értékelési kritériumokról, amelyeket használtunk, a következő témákat fogjuk áttekinteni:
- Értékelési kritériumaink
- Cloud Spanner dióhéjban
- Értékelésünk
- Következtetéseink
1. Értékelési kritériumaink
Mielőtt mélyebben belemerülnénk a Cloud Spanner jellemzőibe, azzal foglalkozva, hogy miben hasonlít és miben különbözik más piaci megoldásoktól, először beszéljünk az alapvető felhasználási esettípusokról, amelyeket figyelembe vettünk, amikor azt a kérdést vizsgáltuk, hogy hol telepítsük a Cloud Spanner-t az infrastruktúránkban:
- A hagyományos SQL adatbázis megoldás (domináló) helyettesítésére
- OLTP megoldásként, támogatva az OLAP-ot
Megjegyzés: A cikk a Cloud Spanner-t a GCP Cloud SQL és az Amazon AWS RDS megoldáscsalád MySQL változataival hasonlítja össze az egyszerűség és a kényelmes összehasonlíthatóság érdekében.
A Cloud Spanner hagyományos SQL adatbázis megoldásként való alkalmazása
A hagyományos adatbázisokban, amikor az adatbázis-kérés válaszideje megközelíti vagy akár meghaladja az előre meghatározott alkalmazási küszöbértékeket (többnyire a felhasználók és/vagy kérelmek növekedése miatt), számos mód áll rendelkezésre a válaszidő csökkentésére egy elfogadható szintre. Azonban a legtöbb megoldás kézi beavatkozást igényel.
Például az első lépés, amit meg kell tenni, hogy megnézzük a teljesítménnyel kapcsolatos különböző adatbázis-paramétereket, és beállítsuk őket, hogy a legjobban illeszkedjenek az alkalmazások használati mintáihoz. Ha ez nem bizonyul elegendőnek, választhatjuk az adatbázis vertikális vagy horizontális skálázását.
Az alkalmazás vertikális skálázása azt jelenti, hogy a szerver példányát frissítjük, általában több processzor/mag, nagyobb memóriakábrázolókapacitás vagy gyorsabb tároló hozzáadásával. További hardverforrások hozzáadása a teljesítmény növekedéséhez vezet, amelyet alapvetően tranzakciók másodpercenkénti számában és az OLTP rendszerek tranzakciós késleltetésében mérnek. A relációs adatbázis-rendszerek (amelyek több szálas megközelítést használnak), mint például a MySQL, jól skálázhatók vertikálisan.
Ennek a megközelítésnek több hátránya van, de a legnyilvánvalóbb a piacon elérhető legnagyobb szerver mérete. Amint elérjük a legnagyobb szerver példány határát, már csak egy út marad: a horizontális skálázás.
A horizontális skálázás olyan megközelítést jelent, amelyben a klaszterhez több szervert adunk hozzá, hogy ideálisan lineárisan növeljük a teljesítményt a szerverek számának növelésével. A legtöbb hagyományos adatbázis-rendszer rosszul skálázható vízszintesen vagy egyáltalán nem skálázható. Például a MySQL vízszintesen skálázható az olvasási műveletekhez, ha slave olvasókat adunk hozzá, de a írási műveletekhez nem képes vízszintesen skálázódni.
Másrészt a Cloud Spanner természeténél fogva könnyen vízszintesen skálázható, minimális beavatkozással.
Teljes körű adatbázis mint szolgáltatás több szempontból kell értékelni. Alapul vettük a felhő legnépszerűbb adatbázisát – a Google számára a GCP Cloud SQL-t és az Amazon számára az AWS RDS-t. Értékelésünk során a következő kategóriákra összpontosítottunk:
- A funkciók összehasonlítása: SQL kiterjedés, DDL, DML; csatlakozási könyvtárak/konektorok, tranzakciók támogatása stb.
- Fejlesztést támogató: a fejlesztés és tesztelés egyszerűsége.
- Adminisztrációs támogatás: például az instance-k kezelése - felfelé/hátrafelé skálázás és az instance-k frissítése; SLA, biztonsági mentés és visszaállítás; biztonság/hozzáférés-ellenőrzés.
A Cloud Spanner használata OLTP megoldásként, amely támogatja az OLAP-ot.
Bár a Google egyértelműen nem állítja, hogy a Cloud Spanner az analitikai feldolgozásra lett tervezve, bizonyos attribútumokat oszt meg más motorokkal, mint például az Apache Impala & Kudu és a YugaByte, amelyek OLAP munkaterhelésekre vannak optimalizálva.
Még ha csak csekély esély is lenne arra, hogy a Cloud Spanner egy konzisztens, vízszintesen skálázható HTAP (hibrid tranzakciós/analitikai feldolgozás) motort tartalmaz, egy (többé-kevésbé) használható OLAP funkciókészlettel, azt gondoljuk, hogy érdemes volna a figyelmünkre.
Ezt szem előtt tartva megvizsgáltuk a következő kategóriákat:
- Adatok betöltése, indexek és partícionálás támogatása
- Lekérdezési teljesítmény és DML
2. Cloud Spanner dióhéjban
A Google Spanner egy klaszter alapú relációs adatbázis-kezelő rendszer (RDBMS), amelyet a Google több saját szolgáltatásához használ. A Google 2017 elején tette elérhetővé a Google Cloud Platform felhasználói számára.
Íme néhány a Cloud Spanner attribútumai közül:
- Erősen konzisztens skálázható RDBMS klaszter: hardveres időszinkronizációt használ az adatok konzisztenciájának biztosítása érdekében.
- Támogatja a kereszt-táblás tranzakciókat: a tranzakciók több táblát is magukban foglalhatnak - nem korlátozódnak egyetlen táblára (ellentétben az Apache HBase-szel vagy az Apache Kudu-val).
- Elsődleges kulcs alapú táblák: minden táblának rendelkeznie kell egy nyilatkozott elsődleges kulccsal (PK), amely több oszlopból is állhat. A táblázati adatok a PK szerinti sorrendben kerülnek tárolásra, ami őket rendkívül hatékonnyá és gyorsan kereshetővé teszi a PK szerint. Mint más PK-alapú rendszerek, a megvalósítást előre megtervezett felhasználási esetek figyelembevételével kell modellezni a legjobb teljesítmény elérése érdekében. .
- Felváltva lévő táblák: a táblák fizikai kapcsolatban állhatnak egymással. A gyermek tábla sorai a szülő tábla soraihoz rendelhetők. Ez a megközelítés felgyorsítja a kapcsolatok keresését, amelyeket az adatmodellezés során meg lehet határozni, például az ügyfelek és számláik közötti közös elhelyezéskor.
- Indexek: a Cloud Spanner támogatja a másodlagos indexeket. Az index a kijelölt oszlopokból és az összes primér kulcs oszlopból áll. Szükség szerint az index tartalmazhat más, nem indexelt oszlopokat is. Az index felcserélheti a szülő táblát a lekérdezések felgyorsítása érdekében. Az indexekre számos korlátozás vonatkozik, például a maximális számú kiegészítő oszlop, amely az indexben tárolható. Továbbá az indexeken keresztüli lekérdezések nem mindig annyira egyértelműek, mint más RDBMS-ek esetében.
A Cloud Spanner ritkán automatikusan választ indexet. Különösen, ha a lekérdezés olyan oszlopokat kér, amelyek nincsenek megőrizve a ».
- Szolgáltatási szint megállapodás (SLA): egy régióban történő telepítés 99,99%-os SLA-val; több régióra kiterjedő telepítések 99,999%-os SLA-val. Bár a szolgáltatási szint megállapodás csupán megállapodás, nem pedig garancia, úgy vélem, a Google munkatársainak valóban vannak pontos adataik, hogy ilyen komoly állítást tegyenek. (Összehasonlításul, a 99,999% azt jelenti, hogy a szolgáltatás 26,3 másodpercig nem elérhető havonta.)
- Továbbiak:
Megjegyzés: Az Apache Tephra projekt bővített tranzakciós támogatást ad az Apache HBase-hez (most már az Apache Phoenix-ben is megvalósítva bétaverzióként).
3. Értékelésünk
Tehát mindannyian olvastuk a Google állításait a Cloud Spanner előnyeiről – gyakorlatilag korlátlan vízszintes skálázás magas konzisztenciával és nagyon magas SLA-val. Bár ezek a követelmények rendkívül nehezen elérhetők, célunk nem az volt, hogy megcáfoljuk őket. Ehelyett fókuszáljunk más dolgokra, amelyek a legtöbb adatbázis-használót foglalkoztatják: a tisztaságra és a használhatóságra.
A Cloud Spanner-t a Sharded MySQL alternatívájaként értékeltük.
A Google Cloud SQL és az Amazon AWS RDS, a legnépszerűbb OLTP adatbázisok a felhőpiacon, rendkívül széles funkcionalitással rendelkeznek. Azonban, ha az adatbázisokat egyetlen csomópont méretén túli skálázásra akarjuk használni, alkalmazásosztásra van szükség. Ez a megközelítés további bonyolultságot jelent mind az alkalmazások, mind az adminisztráció szempontjából. Megvizsgáltuk, hogyan illeszkedik a Spanner a több szegmens egy példányba történő egyesítésének forgatókönyvébe, és milyen funkciókkal (ha vannak) lehet, hogy le kell mondanunk.
SQL, DML és DDL támogatás, valamint csatlakozó és könyvtárak?
Először is, bármilyen adatbázissal való indításkor adatmodell létrehozására van szükség. Ha úgy gondolja, hogy a JDBC Spanner csatlakoztatása a kedvenc SQL eszközéhez lehetséges, azt tapasztalja, hogy tudja lekérdezni az adatokat, de nem tud táblázatot létrehozni vagy módosításokat (DDL) végezni, vagy bármilyen beszúrási / frissítési / törlési műveletet (DML) végrehajtani. A Google hivatalos JDBC-je nem támogatja sem az egyiket, sem a másikat.
„Jelenleg a driverek nem támogatják a DML vagy DDL utasításokat.”
Spanner dokumentáció
A GCP konzoljával a helyzet nem jobb — csak SELECT lekérdezéseket küldhet. Szerencsére van egy közösségi DML és DDL támogatással rendelkező JDBC driver, amely tranzakciókat is kezel. . Bár ez a driver rendkívül hasznos, a Google saját JDBC driverének hiánya meglepő. Szerencsére a Google meglehetősen széleskörű támogatást nyújt kliens könyvtárak számára (gRPC alapú): C#, Go, Java, node.js, PHP, Python, Ruby.
A Cloud Spanner egyedi API-jainak kötelező használata (a JDBC DDL és DML hiánya miatt) néhány korlátozást jelent a kapcsolódó kódtartományokra, például a kapcsolat medencék vagy az adatbáziskötő keretrendszerek (például Spring MVC) esetén. Általánosságban, ha JDBC-t használ, szabadon választhat kedvenc kapcsolat medencéjét (például HikariCP, DBCP, C3PO, stb.), amely tesztelt és jól működik. Az egyedi API Spanner esetében azonban az általunk létrehozott keretrendszerekre / medencékre / ülésekre kell támaszkodnunk.
A fő kulcsra orientált struktúra lehetővé teszi, hogy a Cloud Spanner rendkívül gyorsan hozzáférjen az adatokhoz a fő kulcsokon keresztül, de néhány problémát is okoz a lekérdezésekben.
- Nem frissítheti az elsődleges kulcs értékét; először el kell távolítania a nyilvántartást az eredeti PK-val, majd újra be kell illesztenie az új értékkel. (Ez hasonlít más, PK-oriéntált adatbázisokra/tárolási mechanizmusokra.)
- Bármely UPDATE és DELETE operátornak meg kell adnia a PK-t a WHERE klauzulában, ezért nem lehet üres DELETE all operátor — mindig szükséges egy al-lekérdezés, például: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Az automatikus növelés vagy hasonló lehetőség hiánya, amely a PK mező szekvenciáját határozza meg. Ehhez a megfelelő értéket az alkalmazás oldalán kell létrehozni.
Másodlagos indexek?
A Google Cloud Spanner beépített támogatást nyújt a másodlagos indexekhez. Ez egy nagyon kellemes funkció, amely nem mindig áll rendelkezésre más technológiákban. Az Apache Kudu jelenleg egyáltalán nem támogatja a másodlagos indexeket, míg az Apache HBase nem támogatja közvetlenül az indexeket, de az Apache Phoenix-en keresztül hozzáadhatók.
A Kudu és HBase indexek külön táblázatként modellezhetők eltérő elsődleges kulcs összetétellel, de a szülő táblázattal és a kapcsolódó index táblázatokkal végzett műveletek atomosságát az alkalmazás szintjén kell biztosítani, ami nem triviális a megfelelő végrehajtásban.
Ahogy a Cloud Spanner áttekintésében említést nyert, az indexei eltérhetnek a MySQL indexeitől. Ezért különös óvatosságra van szükség a lekérdezések felépítésénél és profilozásánál, hogy biztosítsuk a megfelelő index használatát, ahol szükséges.
Nézetek?
A nézetek nagyon népszerű és hasznos objektumok az adatbázisban. Számos felhasználási esethez hasznosak lehetnek; a két kedvencem a logikai absztrakció szintje és a biztonsági szint. Sajnos a Cloud Spanner NEM támogatja a nézeteket. Azonban ez csak részben korlátoz minket, mivel a hozzáférés engedélyezése nem részletezett oszlop szinten, ahol a nézetek elfogadható megoldásnak bizonyulhatnak.
A Cloud Spanner dokumentációjában, ahol a kvóták és korlátozások részletezve vannak (), van, többek között, van egy, amely problémás lehet egyes alkalmazások számára: a Cloud Spanner alapértelmezés szerint maximum 100 adatbázisra korlátozódik példányonként. Nyilvánvaló, hogy ez komoly akadályt jelenthet olyan adatbázis számára, amelyet több mint 100 adatbázis skálázására terveztek. Szerencsére, miután beszéltünk a Google technikai képviselőjével, megtudtuk, hogy ezt a korlátot szinte bármilyen értékre meg lehet emelni a Google ügyfélszolgálatán keresztül.
Fejlesztési támogatás?
A Cloud Spanner meglehetősen tiszteletreméltó programozási nyelvek támogatását kínál az API-jával való munkához. A hivatalosan támogatott könyvtárak a C#, Go, Java, node.js, PHP, Python és Ruby területein találhatók. A dokumentáció kellően részletes, de hasonlóan más fejlett technológiákhoz, a közösség viszonylag kicsi a legnépszerűbb adatbázistechnológiákhoz képest, ami megnövelheti a ritkább használati esetek vagy problémák megoldására fordított időt.
Akkor mi a helyzet a helyi fejlesztési támogatással?
Nem találtunk módot arra, hogy Cloud Spanner példányt hozzunk létre helyi környezetben. A legközelebbi, amit kaptunk, egy Docker-kép , ami elvileg hasonló, de a gyakorlatban nagyon eltérő. Például a CockroachDB használhat PostgreSQL JDBC-t. Mivel a fejlesztési környezetnek a lehető legközelebb kell állnia a működési környezethez, a Cloud Spanner nem ideális, mivel teljes Spanner példányra kell támaszkodni. Költségek csökkentése érdekében egyetlen régióra választhat példányt.
Adminisztrációs támogatás?
A Cloud Spanner példány létrehozása rendkívül egyszerű. Csak annyit kell tennie, hogy válasszon multirégiós vagy egy régiós példány létrehozása között, megadja a régió(k)et és a csomópontok számát. Kevesebb mint egy perc múlva a példány már működőképes lesz.
Néhány alapvető metrika közvetlenül elérhető a Spanner oldalán a Google konzolon. Részletesebb nézetek érhetők el a Stackdriver segítségével, ahol küszöbértékeket és értesítési irányelveket is beállíthat.
Hozzáférés az erőforrásokhoz?
A MySQL széleskörű és rendkívül részletes felhasználói jogosultságok/szerepkörök beállításait kínálja. Könnyen beállítható egy adott táblához való hozzáférés, vagy akár annak csak néhány oszlopához. A Cloud Spanner a Google Identity & Access Management (IAM) eszközét használja, amely lehetővé teszi, hogy politikákat és jogosultságokat csak nagyon magas szinten állítsunk be. A legnagyobb részletességű opció az adatbázis szintű jogosultság, ami nem illeszkedik a legtöbb termelési esethez. Ez a korlátozás arra kényszerít, hogy kiegészítő biztonsági intézkedéseket adjunk a kódunkhoz, az infrastruktúránkhoz, vagy mindkettőhöz, hogy megakadályozzuk a Spanner erőforrásainak jogosulatlan felhasználását.
Biztonsági mentések?
Egyszerűen fogalmazva, a Cloud Spannerben nincsenek biztonsági mentések. Bár a Google magas SLA követelményei biztosítani tudják, hogy ne veszítsünk el adatokat hardver- vagy adatbázis-megállások miatt, az emberi hibák, alkalmazási hibák stb. ellen védekezni kell. Mindannyian tudjuk a szabályt: a magas rendelkezésre állás nem helyettesíti a racionális biztonsági mentési stratégiát. Jelenleg az adatok biztonsági mentésének egyetlen módja, hogy a programmal folyamatosan átvitessük őket az adatbázisból egy külön tárolási környezetbe.
Lekérdezési teljesítmény?
Adatok betöltésére és lekérdezések tesztelésére a Yahoo! Cloud Serving Benchmarkot használtuk. Az alábbi táblázat a B YCSB munkaterhelést mutatja 95%-os olvasási arány mellett és 5%-os írási arány mellett.
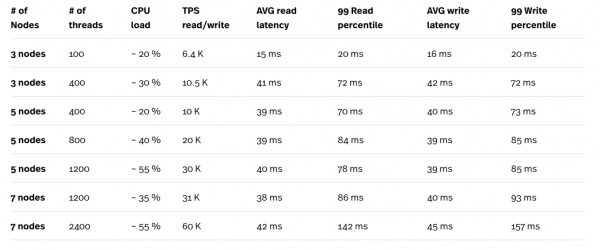
* A terheléses teszt a n1-standard-32 (32 vCPU, 120 GB memória) számítási motort használva készült, és a teszt példány sosem volt szűk keresztmetszet a tesztek során.
** Egy YCSB példány maximális szálainak száma 400. Összesen hat párhuzamos YCSB tesztpéldányt kellett futtatni, hogy összesen 2400 szálat kapjunk.
A teszteredmények alapján, különösen a processzor terhelésének és TPS-nek a kombinációját figyelembe véve, világosan látjuk, hogy a Cloud Spanner jól skálázható. A nagy terhelés, amelyet sok szál okoz, kompenzálódik a Cloud Spanner klaszterében lévő csomópontok magas számával. Bár a késleltetés viszonylag magasnak tűnik, különösen 2400 szál használata esetén, a pontosabb adatok megszerzéséhez szükséges lehet a számítási motor 6 kisebb példányán történő újbóli tesztelés. Minden példány egy YCSB tesztet futtat ahelyett, hogy egy nagy CE példányt használna 6 párhuzamos teszttel. Ezáltal könnyebb megkülönböztetni a Cloud Spanner lekérdezési késleltetéseit és a hálózati kapcsolatból eredő késleltetéseket a Cloud Spanner és a teszteket végző CE példány között.
Hogyan teljesít a Cloud Spanner OLAP-ként?
Particionálás?
Az adatok fizikai és/vagy logikai független szegmensekre, úgynevezett partíciókra való felosztása egy rendkívül népszerű fogalom, amely a legtöbb OLAP-rendszerre jellemző. A partíciók jelentősen javíthatják a lekérdezések teljesítményét és az adatbázis karbantarthatóságát. A partíciók részletesebb tárgyalása önálló cikket igényelne, ezért csak említést nyer a partíciós séma és a további al-partíciók fontossága. Az adatok partíciókra és akár al-partíciókra történő bontásának lehetősége kulcsfontosságú az analitikai lekérdezések teljesítménye szempontjából.
A Cloud Spanner nem támogatja a partíciókat mint olyanokat. Az adatokat a belső struktúrákon a úgynevezett metódus segítségével. Így egy tömböt kapunk, ahol az egyes tömbelemek, az 0-ás indexet kezdve, a dátum egy-egy elemével felelnek meg a szóköz előtt és után.-k alapján a primér kulcs intervallumok szerint osztja fel. A felosztás automatikusan történik, hogy kiegyenlítse a terhelést a Cloud Spanner klaszterében. A Cloud Spanner egyik hasznos funkciója a szülőtábla (olyan tábla, amely nem keveredik másokkal) alapvető terhelésének partícionálása. A Spanner automatikusan meghatározza, hogy metódus segítségével. Így egy tömböt kapunk, ahol az egyes tömbelemek, az 0-ás indexet kezdve, a dátum egy-egy elemével felelnek meg a szóköz előtt és után. azok az adatok, amelyeket gyakrabban olvasnak, mint mások a metódus segítségével. Így egy tömböt kapunk, ahol az egyes tömbelemek, az 0-ás indexet kezdve, a dátum egy-egy elemével felelnek meg a szóköz előtt és után.-kban, és döntést hozhat a további felosztásról. Így a lekérdezéshez több csomópont is bevonható, ami szintén hatékonyan növeli a teljesítményt.
Adatok betöltése?
A Cloud Spanner tömeges adatokhoz hasonló a hagyományos betöltéshez. A maximális teljesítmény eléréséhez néhány ajánlást be kell tartania, beleértve a következőket:
- Rendezze adatokat elsődleges kulcs szerint.
- Ossza őket 10*-re.csomópontok számának. külön szekciókra.
- Hozzon létre egy feladatcsomagot, amely párhuzamosan tölti be az adatokat.
Ezzel az adatbetöltéssel minden Cloud Spanner csomópont használatban van.
Az A YCSB munkaterhelést használtuk egy 10M soros adathalmoz létrehozásához.
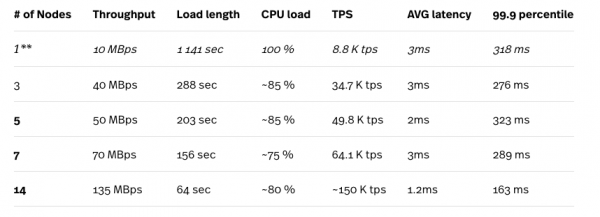
* A terheléses tesztet az n1-standard-32 számítási motornál (32 vCPU, 120 GB memória) hajtották végre, és a tesztpéldány soha nem volt szűk keresztmetszet a tesztek során.
** Egy csomópontos beállítás nem ajánlott bármilyen termelési terhelésre.
Ahogy korábban említettem, a Cloud Spanner automatikusan kezeli a split-eket a terhelésük alapján, ezért az eredmények javulnak a tesztek sorozatos megismétlése után. A itt bemutatott eredmények a legjobbak, amelyeket elértünk. A fenti számok alapján láthatjuk, hogy a Cloud Spanner (jól) méretezhető a klaszter csomópontjainak számának növekedésével. Azok a számok, amelyek kiemelkednek, rendkívül alacsony átlagos késleltetést jelentenek, amelyek ellentétben állnak a vegyes munkaterhelések (95% olvasás és 5% írás) eredményeivel, ahogy a fenti részben leírtuk.
Méretezés?
A Cloud Spanner csomópontok számának növelése és csökkentése egy kattintással végrehajtható feladat. Ha gyorsan szeretne adatokat betölteni, fontolja meg, hogy a maximálisra (esetünkben 25 csomópont az US-EAST régióban) gyorsítja az példányt, majd csökkentse a csomópontok számát, amelyek megfelelnek a szokásos terhelésének, miután az összes adat bekerült az adatbázisba, figyelembe véve a 2 TB/csomópont korlátját.
Ezt a korlátot emlékeztettek ránk egy sokkal kisebb adatbázissal is. Néhány terheléses tesztfuttatás után az adatbázisunk körülbelül 155 GB méretű volt, és amikor csökkentettük az egy csomópontos példányra, a következő hibát kaptuk:
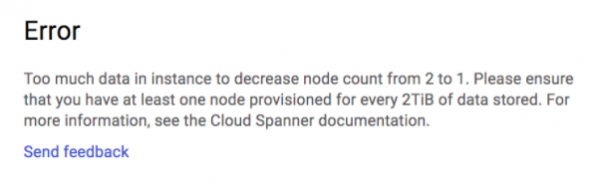
Sikerült csökkentenünk a méretet 25-ről 2 példányra, de megakadtunk a két csomópontnál.
A Cloud Spanner klaszter csomópontjainak számának növelését vagy csökkentését REST API segítségével lehet automatizálni. Ez különösen hasznos lehet a rendszer megnövekedett terhelésének csökkentésére a csúcsidőszakokban.
OLAP lekérdezések teljesítménye?
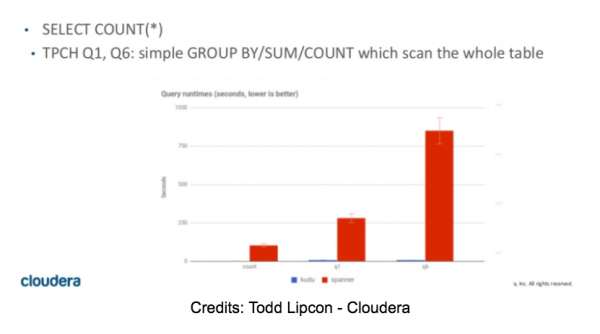
Kezdetben jelentős időt szerettünk volna szentelni a Spanner értékelésének ezen részének. Néhány SELECT COUNT után azonnal rájöttünk, hogy a tesztelés rövid lesz, és a Spanner NEM lesz alkalmas OLAP motornak. Függetlenül attól, hogy hány csomópont van a klaszterben, a 10M soros táblázatban az egyszerű sorok számának kiválasztása 55-60 másodpercet vett igénybe. Ezenkívül bármely lekérdezés, amely nagyobb mennyiségű memóriát igényelt az átmeneti eredmények tárolásához, OOM hibával végződött.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M különböző érték) -> SpoolingHashAggregateIterator elfogyott a memóriából az új sor során.
Néhány számadat a TPC-H lekérdezésekhez Todd Lipkon cikkében található. , 42. és 43. diák. Ezek a számok összhangban vannak a saját eredményeinkkel (sajnos).
4. Következtetéseink
A Cloud Spanner aktuális funkcióinak figyelembevételével nehéz elképzelni, hogy ez egyszerű helyettesítése legyen a meglévő OLTP megoldásoknak, különösen ha az igényeid meghaladják azt. Jelentős időt kellene eltölteni egy olyan megoldás kiépítésével, amely figyelembe veszi a Cloud Spanner hátrányait.
Amikor elkezdtük értékelni a Cloud Spanner-t, azt vártuk, hogy a kezelési funkciói legalább hasonló szintűek lesznek, mint más Google SQL megoldásoké. De meglepődtünk a teljes biztonsági másolatok hiányán és a nagyon korlátozott erőforrás-hozzáférési kontrollon. Arról nem is beszélve, hogy hiányoznak a nézetek, a helyi fejlesztői környezet, a nem támogatott szekvenciák, a JDBC, amely nem támogatja a DML-t és DDL-t, és így tovább.
Tehát hová mehet az, akinek skálázható tranzakciós adatbázisra van szüksége? Úgy tűnik, hogy egyelőre a piacon nincs egységes megoldás, amely minden felhasználási lehetőséghez illeszkedne. Számos zárt és nyílt forráskódú megoldás létezik (némelyiket említi ez a cikk), mindegyiknek megvannak a maga előnyei és hátrányai, de egyik sem kínál SaaS-t 99,999%-os SLA-val és magas fokú konzisztenciával. Ha a magas SLA szint a legfőbb célja, és nem hajlandó saját megoldást létrehozni több felhő környezethez, a Cloud Spanner lehet az a megoldás, amire szüksége van. De tudnia kell az összes korlátozásáról.
A tisztesség kedvéért meg kell jegyezni, hogy a Cloud Spanner 2017 tavaszán vált általánosan elérhetővé, így ésszerű elvárni, hogy a jelenlegi hiányosságai végül eltűnjenek (remélhetőleg), és ha ez megtörténik, az változást hozhat. Végső soron a Cloud Spanner nem csupán egy külső projekt a Google számára. A Google ezt használja más Google termékek alapjaként. És amikor a Google nemrégiben a Megastore-t a Google Cloud Storage-ban a Cloud Spanner-re cserélte, ez lehetővé tette, hogy a Google Cloud Storage szigorúan konzisztens legyen az objektumlistákra vonatkozóan világszerte (ami azonban továbbra sem vonatkozik a ).
Tehát van remény... reméljük.
Ezzel végeztünk. Ahogyan a cikk szerzője is, mi is folytatjuk a reménykedést, ön mit gondol erről? Írja meg kommentben!
Mindenkit szeretettel várunk a keretein belül, ahol részletesen bemutatjuk a tanfolyamot. az OTUS-tól.
Forrás: habr.com
