

A cikk ötlete véletlenül született egy kommentárban folyó vitából. .
A belső sajátossága szolgáltatásaink működésének, hogy hatalmas mennyiségű kicsi fájl tárolásával foglalkozunk. Jelenleg körülbelül több száz terabájt ilyen adatunk van. Ráakadtunk néhány nyilvánvaló és nem annyira nyilvánvaló nehézségre, de sikeresen megoldottuk azokat.
Ezért megosztom tapasztalatainkat, hátha valakinek hasznos lesz.
Első probléma: „Nincs elég hely az eszközön”
Mint a fent említett cikkben említettem, a probléma az, hogy a fájlrendszerben van szabad blokk, azonban az inode-k elfogytak.
Az használt és szabad inodok számát a következő paranccsal lehet ellenőrizni: df -ih:
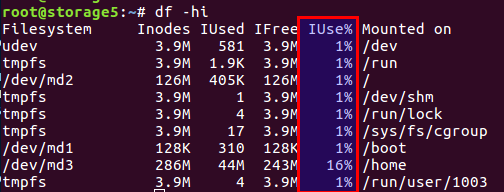
Nem fogom újra elmondani a cikket, ha röviden szeretném összefoglalni, a lemezen vannak blokkok közvetlenül az adatok számára, valamint blokkok a meta-információk számára, ezek az inode-ok (index csomópont). Számuk a fájlrendszer inicializálásakor van megadva (az ext2-ről és annak örököseiről van szó), és azután nem változik. Az adatok és az inode-ok közötti egyensúlyt statisztikai adatok alapján számolják ki, azonban a mi esetünkben, ahol sok kicsi fájl van, az egyensúlynak inkább az inode-ok számának irányába kell eltolódnia - ezekből több kell.
Linuxban már előre láttak különböző egyensúlyozási lehetőségeket, és ezek a kalkulált konfigurációk a /etc/mke2fs.conf.
fájlban találhatók.
Íme néhány példa a fájlból:
    small = {
        blocksize = 1024
        inode_size = 128
        inode_ratio = 4096
    }

    big = {
        inode_ratio = 32768
    }

    largefile = {
        inode_ratio = 1048576
        blocksize = -1
    }
A megfelelő felhasználási lehetőséget az „-T” opcióval választhatjuk ki a mke2fs hívásánál. Ezen kívül kézi paraméterezést is lehetőséges, ha nincs kész megoldás.
További részletek találhatók a mke2fs.conf és mke2fs.
A fent említett cikkben nem érintett sajátosság - megadható az adatok blokkjának mérete. Nyilvánvaló, hogy nagy fájlok esetén érdemesebb nagyobb blokkméretet választani, míg kisebb fájlok esetén a kisebb a megfelelő.
Ugyanakkor érdemes figyelembe venni egy érdekes sajátosságot, mint a processzor architektúrája.
Valamikor azt fontolgattam, hogy a nagyobb fényképekhez nagyobb blokk méret lenne szükséges. Ez még otthoni körülmények között történt, egy WD nevével ellátott házi tárolón, ARM architektúrán. Nem sokáig gondolkodtam, és a blokk méretet 8k-ra vagy 16k-ra állítottam a standard 4k helyett, miután először lemértem a megtakarítást. És minden csodálatosan működött, egészen addig, amíg magának a tárolónak nem lett volna hibája, miközben a lemez épen maradt. Amikor a lemezt egy klasszikus számítógépbe állítottam, amelyben egy hagyományos Intel processzor volt, meglepetés ért: nem támogatott blokk méret. Bajban voltunk. Az adatok megvoltak, minden rendben, de olvasni lehetetlen volt. Az i386 processzorok és hasonlók nem tudnak olyan blokk méretekkel dolgozni, amelyek nem felelnek meg a memóriaoldal méretének, ami pontosan 4k. Összességében az ügy végül felhasználói térből származó segédprogramokkal zárult, minden lassú és szomorú volt, de az adatokat megmentettük. Akinek érdekes – keressen rá a segédprogram nevére. fuseext2. Tanulság: vagy minden esetet előre átgondolni, vagy ne építsünk magunkból szuperhőst, és használjuk a háztartások számára szolgáló szabványos beállításokat.
UPD. Egy felhasználói megjegyzés alapján kijavítom, hogy az i386 esetében a blokk méret nem haladhatja meg a 4k-t, de nem szükséges, hogy pontosan 4k legyen, tehát 1k és 2k is megengedett.
Tehát, hogyan oldottuk meg a problémákat.
Először is, a problémával akkor szembesültünk, amikor a sok terabájtos lemez tele volt adatokkal, és a fájlrendszer konfigurációját nem tudtuk megváltoztatni.
Másodsorban sürgős megoldásra volt szükség.
Végül arra a következtetésre jutottunk, hogy változtatnunk kell az egyensúlyon, csökkentve a fájlok számát.
A fájlok számának csökkentésére úgy döntöttünk, hogy az összes fájlt egy közös archívumba helyezzük. Figyelembe véve a specifikációnkat, mindent egy archívumba gyűjtöttünk egy adott időszakon belül, és naponta éjszaka cron feladatot hajtottunk végre az archiválásra.
ZIP-archívum lett kiválasztva. A korábbi cikk megjegyzései között a tar javasolt volt, de ennek van egy nehézsége: nem rendelkezik táblázattal, és a fájlok következetesen helyezkednek el benne (nem véletlenül hívják «tar»-nak, ami a «Tape Archive» rövidítése, a szalagos tárolók öröksége), tehát ha a fájlt az archívum végén szeretnénk olvasni - az archívum teljes átolvasása szükséges, mivel nincs eltolás az egyes fájlokhoz képest az archívum elejéhez. Ezért ez egy hosszú művelet. A ZIP sokkal jobb: rendelkezik a keresett táblázattal és a fájlok eltolásával az archívum belsejében, és a hozzáférési idő minden fájlhoz nem függ a helyzetétől. A mi esetünkben a „0” tömörítési opciót is be lehetett állítani, mivel az összes fájl előre tömörítve volt gzip formátumban.
Az ügyfelek az nginx-en keresztül küldik le a fájlokat, és a régi API szerint csak a fájl nevét kell megadni, például az alábbiak szerint:
http://www.server.com/hydra/20170416/0453/3bd24ae7-1df4-4d76-9d28-5b7fcb7fd8e5
A fájlok futás közbeni kicsomagolásához megtaláltuk és csatlakoztattuk az nginx-unzip-module modult () és beállítottunk két upstream-et.
Ennek eredményeként ilyen konfiguráció jött létre:
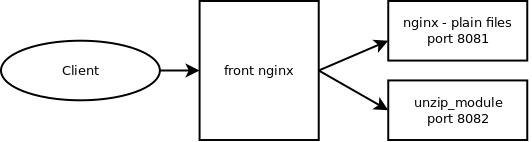
A két hoszt a beállításokban így nézett ki:
server {
  listen *:8081;

  location / {
    root      /home/filestorage;
  }
}
server {
listen *:8082;
location ~ ^/hydra/(d+)/(\d+)/(.*)$ {
root /home/filestorage;
file_in_unzip_archivefile "/home/filestorage/hydra/$1/$2.zip";
file_in_unzip_extract "$2/$3";
file_in_unzip;
}
}
És a upstream konfiguráció a magasabb szintű nginx-en:
upstream storage {
  server server.com:8081;
  server server.com:8082;
}
Hogy működik:
- Az ügyfél a front nginx-re megy
- A front nginx megpróbálja közvetlenül a fájlt kiszolgálni az első upstream-ből, azaz közvetlenül a fájlrendszerből
- Ha a fájl nem létezik, megpróbálja kiszolgálni a második upstream-ből, amely megpróbálja megtalálni a fájlt az archívumban
A második probléma: megint «No space left on device»
Ez a második probléma, amellyel akkor szembesültünk, amikor sok fájl található a könyvtárban.
Megpróbálunk létrehozni egy fájlt, a rendszer azt panaszolja, hogy nincs hely. Megváltoztatjuk a fájl nevét, és újra megpróbáljuk létrehozni.
Sikerül.
Körülbelül így néz ki:

Az inodes ellenőrzése nem tanúsított semmit - sok szabad van belőlük.
A hely ellenőrzése - ugyanaz.
Arra gondoltunk, hogy talán túl sok fájl van a könyvtárban, és erre van korlátozás, de ismét nem: A könyvtáron belüli fájlok maximális száma: ~1,3 × 10^20
És egy fájlt is létre lehet hozni, ha megváltoztatjuk a nevét.
Tehát a probléma a fájl nevében van.
A további keresgélés azt mutatta, hogy a probléma a könyvtári index építése során alkalmazott hash algoritmusban rejlik, sok fájl esetén ütközések lépnek fel, minden következménnyel együtt. Bővebben itt olvashatsz:
Ezt az opciót kikapcsolhatja, de a fájlnevek szerinti keresés előre kiszámíthatatlanul hosszú lehet, ha az összes fájlt végig kell járni.
tune2fs -O "^dir_index" /dev/sdb3
Általánosságban, mint ideiglenes megoldás, működhet.
Moral: sok fájl a könyvtárban általában rossz. Ezt nem szabad csinálni.
Ilyen esetekben általában fájlnevek kezdőbetűi vagy más paraméterek, például dátumok szerint belső könyvtárakat hoznak létre, ami a legtöbb esetben segít.
De a kis fájlok összesített száma továbbra is problémás, még ha könyvtárakba is soroljuk őket — akkor lásd az első problémát.
Harmadik probléma: hogyan nézhetjük meg a fájlok listáját, ha sok van belőlük?
A helyzetünkben, ahol sok fájlunk van, valahogy szembesültünk azzal a problémával, hogy hogyan nézhessük meg a könyvtár tartalmát.
A standard megoldás — a parancs ls.
Oké, nézzük meg, mi történik 4772098 fájl esetén:
$ time ls /home/app/express.repository/offercache/ >/dev/null

real	0m30.203s
user	0m28.327s
sys	0m1.876s
30 másodperc... ez soknak tűnik. Az idő legnagyobb része a felhasználói tér fájljainak feldolgozására megy el, nem pedig a mag (kernel) munkájára.
De van megoldás:
$ time find /home/app/express.repository/offercache/ >/dev/null

real	0m3.714s
user	0m1.998s
sys	0m1.717s
3 másodperc. 10-szer gyorsabb.
Hurrá!
UPD.
Még gyorsabb megoldás a felhasználótól — a rendezés kikapcsolása a ls
time ls -U /home/app/express.repository/offercache/ >/dev/null
real	0m2.985s
user	0m1.377s
sys	0m1.608s
Negyedik probléma: magas LA fájlok kezelésekor
Időről időre felmerül a helyzet, amikor rengeteg fájlt kell átmásolni egyik gépről a másikra. Eközben gyakran jelentősen megnő a LA, mivel minden a lemezek teljesítményébe ütközik.
A legértelmesebb, amit szeretnénk — SSD-t használni. Valóban menő. Csak a több terabájtos SSD ára a kérdés.
De ha a lemezek normálisak, a fájlokat át kell másolni, és ez ráadásul egy produkciós rendszer, ahol a túlterhelés elégedetlenséget okoz az ügyfelek részéről? Legalább két hasznos eszköz áll rendelkezésre: kellemes és ionice.
kellemes — csökkenti a folyamat prioritását, így a scheduler több időkvantumot oszt más, magasabb prioritású folyamatoknak.
Gyakorlatunkban segített a nice maximális (19 — a legalacsonyabb prioritás, -20 (mínusz 20) — a legmagasabb) beállítása.
ionice — így korrigálja a bemeneti/kimeneti (I/O scheduling) prioritást.
Ha RAID-t használ, és hirtelen szinkronizálnia kell (például egy sikertelen újraindítás után, vagy a RAID tömb helyreállítása után egy lemezcsere miatt), akkor bizonyos helyzetekben érdemes csökkenteni a szinkronizálás sebességét, hogy a többi folyamat viszonylag megfelelően működhessen. Ehhez segít a következő parancs:
echo 1000 > /proc/sys/dev/raid/speed_limit_max
Ötödik probléma: Hogyan szinkronizáljunk fájlokat valós időben
Ugyanazokkal a hatalmas mennyiségű fájlokkal rendelkezünk, amelyeket biztonsági mentésként el kell küldeni a második szerverre a lehetséges veszteségek elkerülése érdekében... A fájlok folyamatosan íródnak, ezért minimális veszteség elérése érdekében a lehető leggyorsabban kell másolni őket.
A standard megoldás: Rsync SSH-n keresztül.
Ez jó lehetőség, ha csak nem kell ezt több másodpercenként megtenni. Ráadásul sok fájl van. Még ha nem is másoljuk őket – akkor valahogy tudnunk kell, hogy mi változott, és több millió fájl összehasonlítása időt és terhelést jelent a lemezeken.
Vagyis azonnal tudnunk kell, hogy mit kell másolni anélkül, hogy minden alkalommal el kellene indítani az összehasonlítást.
A megoldás – lsyncd. Lsyncd — . Ez is az rsync-en keresztül működik, de emellett figyeli a fájlrendszert a változások szempontjából az inotify és fsevents használatával, és csak azokat a fájlokat másolja, amelyek megjelentek vagy megváltoztak.
Hatodik probléma: hogyan határozzuk meg, ki terheli a lemezeket
Valószínűleg mindenki tudja, de azért a teljesség kedvéért: a lemezes alrendszer megfigyelésére a következő parancs áll rendelkezésre: iotop — hasonló top, de megmutatja a legaktívabban használt folyamatokat a lemezeken.
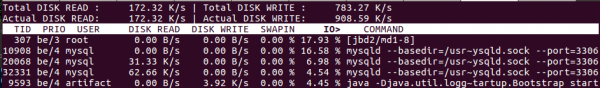
Egyébként a régi, jó öreg top is segít megérteni, hogy vannak-e problémák a lemezekkel. Ehhez két legmegfelelőbb paraméter van: Load Average és IOwait.
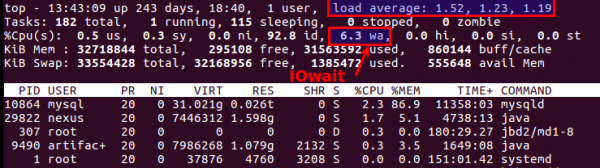
Az első mutatja, hány folyamat vár a kiszolgálásra, általában ha több mint 2 van, már valami nem stimmel. Aktív biztonsági mentés készítésekor a háttérszerverek számára 6-8-as érték elfogadható, ezen túl a helyzet rendellenesnek számít.
A második mutatja, mennyire van a processzor a lemezes műveletekkel elfoglalva. Az IOwait >10% aggodalomra ad okot, bár a speciális terhelésprofilú szervereink esetén gyakran 40-50%-os stabil terhelést tapasztalunk, ami tényleg normális.
Ezen be is fejezem, bár biztosan sok olyan szempont van, amivel még nem találkoztunk, örömmel várom a kommentárokat és érdekes, valós esetek leírásait.
Forrás: habr.com
