

Mindenki beszél a fejlesztési és tesztelési folyamatokról, a személyzet képzéséről, a motiváció növeléséről, de ezek a folyamatok nem elegendőek, amikor egy perc leállás elképesztő összegeket jelent. Mi a teendő, amikor pénzügyi tranzakciókat hajt végre szigorú SLA mellett? Hogyan növelheti rendszerei megbízhatóságát és hibamentességét, ha figyelmen kívül hagyja a fejlesztést és a tesztelést?
A következő HighLoad++ konferencia 2020. április 6-7-én kerül megrendezésre Szentpéterváron. Részletek és jegyek: . November 9-én, 18:00-kor. HighLoad++ Moszkva 2018, «Delhi + Kalkutta» teremben. Előadások és .
Evgeny Kuzovlev (továbbiakban – EK): – Barátok, üdvözlöm! Kuzovlev Evgeny vagyok az EcommPay cégtől, a konkrét részleg – EcommPay IT, a cégcsoport IT részlege. Ma arról fogunk beszélni, hogyan kerülhetjük el a leállásokat, hogyan minimalizálhatjuk következményeiket, ha elkerülni nem tudjuk. A téma: „Mi a teendő, ha egy perc leállás 100 000 dollárt ér?” Az előrehaladva a számok hasonlók.
Mivel foglalkozik az EcommPay IT?
Kik vagyunk? Miért állok itt önök előtt? Miért van jogom valamivel kapcsolatban beszélni Önöknek? És miről fogunk részletesebben beszélni itt?
Az EcommPay cégcsoport egy nemzetközi akvizíciós vállalat. Világszerte, Oroszországban, Európában, Délkelet-Ázsiában feldolgozzuk a tranzakciókat (Mindenhol a világon). Kilenc irodánk van, összesen 500 alkalmazottal, közülük körülbelül kevesebb mint a fele IT szakember. Minden, amit teszünk, minden, amiből profitálunk, az saját munkánk.
Minden termékünket (amiből bőven van – a nagy IT termékek vonalán körülbelül 16 különböző komponens) magunk írtuk; mi magunk írjuk, mi magunk fejlesztjük. Jelenleg körülbelül egymillió tranzakciót bonyolítunk naponta (valószínűleg jobb így mondani). A cégünk meglehetősen fiatal – csak körülbelül hat éves.
Hat évvel ezelőtt ez egy startup volt, amikor a srácok jöttek az üzlettel. Összekapcsolta őket egy ötlet (nem volt más, csak az ötlet), és mi elindultunk. Mint minden startup, gyorsabban futottunk... Számunkra a sebesség fontosabb volt, mint a minőség.
Egy bizonyos pillanatban megálltunk: rájöttünk, hogy már nem tudunk olyan sebességgel és olyan minőséggel élni, és először is a minőségre van szükségünk. Ekkor úgy döntöttünk, hogy írunk egy új platformot, amely helyes, skálázható és megbízható lesz. Ezt a platformot elkezdtük írni (befektettünk, fejlesztettük a fejlesztést, tesztelést), de egy bizonyos pillanatban rájöttünk, hogy a fejlesztés és a tesztelés nem engedi meg, hogy új minőségi szintre lépjünk.
Új terméket készítesz, élesben indítod, de valahol mindig közbe jöhet valami hiba. Ma arról beszélünk, hogyan lehet új minőségi szintre lépni (mi hogyan tettük ezt, a tapasztalatunkról), a fejlesztést és tesztelést háttérbe helyezve; arról fogunk beszélni, ami az üzemeltetés számára elérhető – hogy az üzemeltetés mit tehet saját magáért, mit tud ajánlani a tesztelésnek, hogy befolyásolja a minőséget.
Downtime. Az üzemeltetés parancsolatai.
Mindig a fő alapkérdés, amiről ma beszélni fogunk – a downtime. Szörnyű szó. Ha downtime történik – akkor minden rosszul megy. Futunk, hogy helyreállítsuk, az adminisztrátorok tartják a szervert – adja Isten, hogy ne essen le, ahogy abban a dalban éneklik. Erről fogunk ma beszélni.
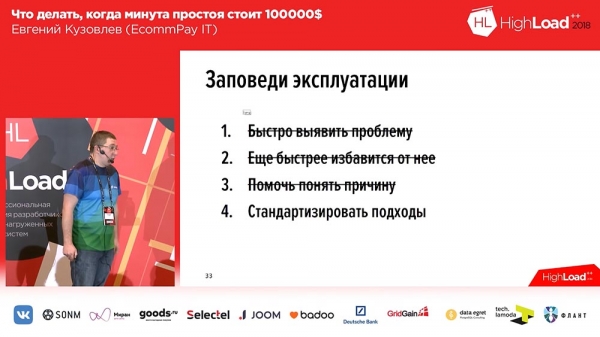
Amikor elkezdtük megváltoztatni a megközelítéseinket, négy parancsolatot fogalmaztunk meg. Ezeket az előadásokon bemutatom.
Ezek a parancsolatok meglehetősen egyszerűek:
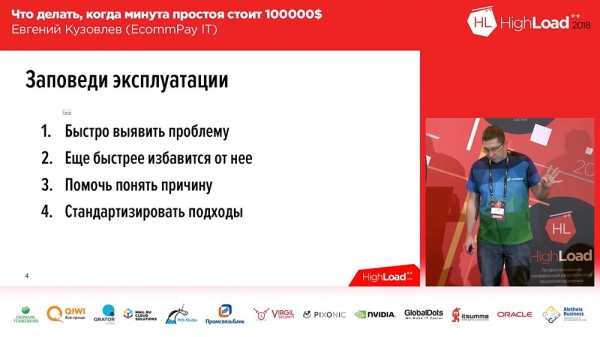
- Gyorsan azonosítani a problémát.
- Még gyorsabban megszabadulni tőle.
- Segíteni megérteni az okot (később, a fejlesztőknek).
- És standardizálni a megközelítéseket.
Felhívom a figyelmet a 2. pontra. Megszabadulunk a problémától, nem megoldjuk azt. Megoldani – ez másodlagos. Számunkra elsődleges, hogy a felhasználó védve legyen ettől a problémától. Ez egy elkülönített környezetben fog létezni, de ez a környezet semmilyen módon nem fog vele kapcsolatba lépni. Lényegében végigmegyünk ezeken a négy probléma csoporton (valamelyikről részletesebben, valamelyikről kevésbé részletesen), elmondom, mit használunk, milyen tapasztalataink vannak a megoldásokról.
Problémák felszámolása: mikor történnek, és mit tegyünk velük?
De kezdjük nem a megszokott sorrendben, hanem a 2. ponttal – hogyan szabadulhatunk meg gyorsan a problémától? Van egy problémánk – azt meg kell szüntetni. A fő kérdés: „Mit tehetünk ezzel?” És amikor elkezdtünk gondolkodni a probléma megoldásán, kidolgoztunk néhány követelményt, amelyeket a problémák megszüntetésének követnie kell.
Ezeket a követelményeket úgy fogalmaztuk meg, hogy feltettük magunknak a kérdést: „Mikor fordulnak elő nálunk problémák?” és kiderült, hogy a problémák négy esetben merülnek fel:
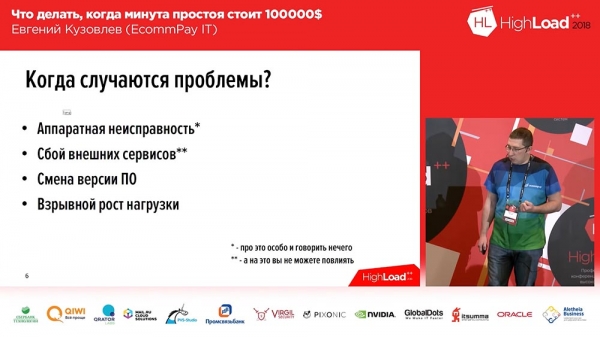
- Hardware hibák.
- Külső szolgáltatások leállása.
- Szoftververzió váltás (azaz telepítés).
- Robbanásszerű terhelésnövekedés.
Az első két esetről nem szeretnénk beszélni. A hardver hibák elég egyszerűen megoldhatók: mindennek duplikálva kell lennie. Ha a lemezek, akkor a lemezeknek RAID-ben kell lenniük, ha a szerver, akkor a szervernek is duplikálva kell lennie, ha a hálózati infrastruktúra, akkor egy második példányt kell telepíteni, tehát csak duplikáljatok. Ha valami hibásodik, akkor átváltotok a tartalék erőforrásokra. Itt többet mondani nehéz.
A második az külső szolgáltatások leállása. A legtöbb rendszer számára ez egyáltalán nem probléma, de nem számunkra. Mivel kezeljük a kifizetéseket, olyan aggregátor vagyunk, ami a felhasználó (aki megadja a bankkártya adatait) és a bankok, a fizetési rendszerek (pl. „Visa”, „MasterCard”, „Mir”) között helyezkedik el. Külső szolgáltatásaink (fizetési rendszerek, bankok) hajlamosak hibázni. Ezen mi sem tudunk változtatni, ahogyan ti sem (ha ilyen szolgáltatásaitok vannak).
Mit tegyünk ilyenkor? Két lehetőség van. Először is, ha lehet, valamilyen módon duplikálni kell ezt a szolgáltatást. Például mi, ha tudunk, átirányítjuk a forgalmat az egyik szolgáltatásról a másikra: ha például a „Sberbank”-on keresztül dolgozunk, és a „Sberbank”-nak problémái vannak – akkor feltételezve átkapcsoljuk a forgalmat „Raiffeisen”-re. A második, amit tehetünk – hogy nagyon gyorsan észleljük a külső szolgáltatások leállását, ezért a következő részben beszélni fogunk a reagálási sebességről.
Valójában ezek közül a négy problémából háromra konkrétan hatással lehetünk szoftverfrissítések révén – olyan intézkedéseket tehetünk, amelyek javítják a helyzetet a telepítések és az igények robbanásszerű növekedése szempontjából. Ezt egyébként meg is tettük. Itt ismét egy kis megjegyzés…
E négy problémából néhány azonnal megoldható, ha van felhőalapú megoldásunk. Ha az „Microsoft Azure”, az „Ozon”, a „Yandex” vagy a „Mail” felhőit használja, akkor legalább a hardver meghibásodása az ő problémájukká válik, és azonnal javul a helyzet a hardverhibák szempontjából.
Egy kissé szokatlan cég vagyunk. Itt mindenki a „Kubernetes”-ről és a felhőkről beszél – nekünk nincsen sem „Kubernetes”-ünk, sem felhőink. Viszont van sok szerverünk számos adatközpontban, és ezen a hardveren muszáj élnünk, felelősséget vállalnunk ezért az egészért. Tehát ebben a kontextusban fogunk beszélni. És most a problémákról. Az első kettőt figyelmen kívül hagytuk.
Szoftververzió váltás. Alapok
Nálunk a fejlesztők nem férnek hozzá a produkciós környezethez. Miért van ez így? Azért, mert PCI DSS tanúsítvánnyal rendelkezünk, és a fejlesztőknek egyszerűen nincs joguk belenyúlni a „prod”-ba. Ennyi, pont. Egyáltalán. Ezért a fejlesztés felelőssége pontosan abban a pillanatban megszűnik, amikor a fejlesztés átadja a buildet a kiadásra.
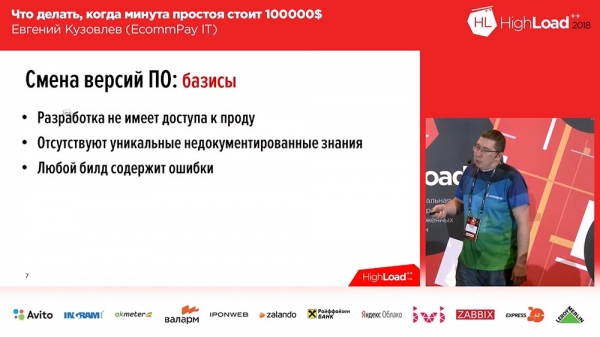
A második alap, amivel rendelkezünk, ami szintén sokat segít – az egyedi, nem dokumentált ismeretek hiánya. Remélem, önöknél is így van. Mert ha nem, problémákra számíthatnak. A problémák akkor merülnek fel, ha ezek az egyedi, nem dokumentált ismeretek nincsenek jelen a megfelelő időben és helyen. Tegyük fel, hogy csak egy ember tudja, hogyan kell egy adott komponenst telepíteni – ha az a személy nincs ott, szabadságon van, vagy beteg – minden, probléma.
És a harmadik alap, amelyhez eljutottunk. Ezen a fájdalmon, véráldozaton és könnyeken keresztül jutottunk el oda, hogy bármely buildünk tartalmaz hibákat, még akkor is, ha kijelenthetjük, hogy hibátlan. Mi ezt úgy határoztuk meg: amikor valamit telepítünk, amikor valamit beviszünk a produkcióba – a buildünk hibás. Megfogalmaztuk az elvárásokat, amelyeket a rendszerünknek teljesítenie kell.
Elvárások a szoftververzió váltásához
Ezek az elvárások hármasak:
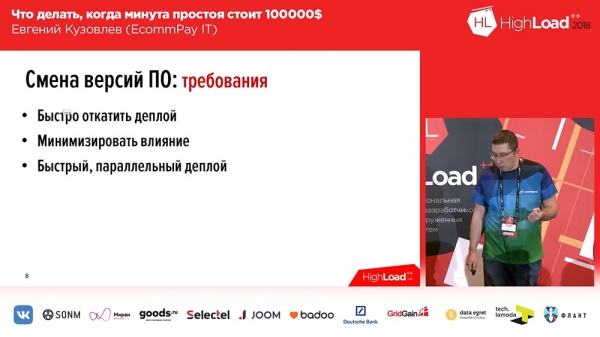
- Gyorsan vissza kell tudnunk vonni a telepítést.
- Minimalizálnunk kell a sikertelen telepítés hatását.
- És gyorsan párhuzamosan kell tudnunk telepíteni.
Pontosan így! Miért? Mert a legfontosabb, hogy amikor új verziót telepítünk, nem a sebesség a lényeg, de fontos, ha valami rosszul sül el, hogy gyorsan vissza tudjunk állni és minimális hatással legyünk. De ha van egy sor verzió a termelésben, amelyről kiderült, hogy hiba van benne (hirtelen, nem volt telepítés, de hiba van benne) – akkor a következő telepítés sebessége fontos. Mit tettünk, hogy megfeleljünk ezeknek az igényeknek? Egy olyan metodológiához folyamodtunk:
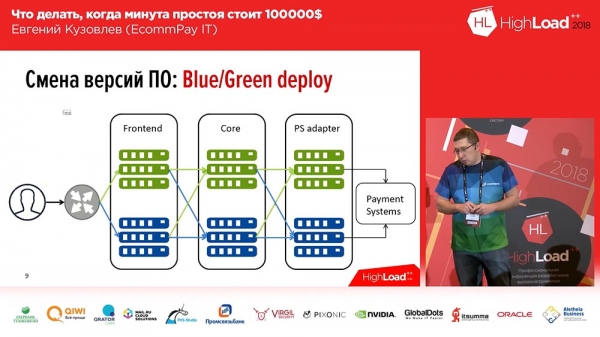
Ez eléggé ismert, sosem találtuk fel – ez a Blue/Green telepítés. Mi ez? Minden egyes szervercsoport, amelyen az alkalmazásaink futnak, rendelkeznie kell egy másolattal. A másolat „meleg”: nincs forgalma, de bármikor átirányíthatjuk erre a másolatra a forgalmat. Ez a másolat tartalmazza az előző verziót. A telepítés pillanatában a kódot egy inaktív másolatra telepíted. Ezután a forgalom egy részét (vagy az egészet) az új verzióra irányítod. Így ahhoz, hogy a forgalmat a régi verzióról az újra váltogasd, csak egy lépést kell tenned: az upstream balancert kell cserélned, meg kell változtatnod az irányt – egyik upstreamről a másikra. Ez nagyon kényelmes, és megoldja a gyors váltakozás, gyors visszaváltás problémáját.Ezen a ponton a második kérdés megoldása is benne van – minimalizálás: csak a forgalmad egy részét (például, mondjuk, 2%-át) irányíthatod az új vonalra, az új kóddal. És ez a 2% nem 100%! Ha a telepítés során a forgalmad 100%-a eltűnt – az szörnyű, ha a forgalmad 2%-a eltűnt – az kellemetlen, de nem tragikus. Ráadásul a felhasználók valószínűleg észre sem veszik, mert bizonyos esetekben (nem mindben) ugyanaz a felhasználó, ha megnyomja az F5-öt, egy másik, működő verzióra fog kerülni.
Blue/Green telepítés. Útválasztás
Ezzel együtt nem minden olyan egyszerű a „Blue/Green telepítéssel”... Minden komponensünket három csoportra oszthatjuk:
- ez a frontend (a fizetési oldalak, amelyeket az ügyfeleink látnak);
- a feldolgozó mag;
- adapter a fizetési rendszerekkel való együttműködéshez (bankok, „MasterCard”, „Visa”, stb.).
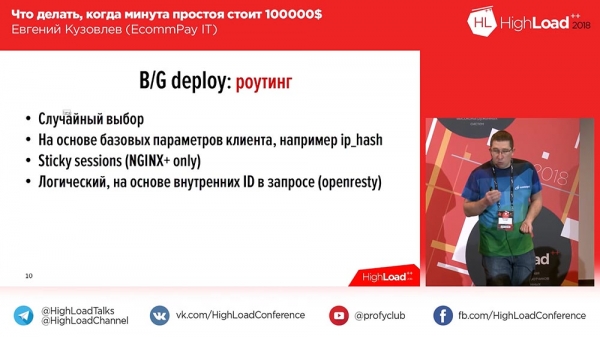
És itt van egy apróság – az apróság a vonalak közötti irányításban rejlik. Ha egyszerűen 100%-ot váltogatsz a forgalomból, akkor ezekkel a problémákkal nem lesz dolgod. De ha 2%-ot akarsz váltani, akkor elkezdődnek a kérdések: „Hogyan is lehet ezt megtenni?” A legegyszerűbb, a fejjel előre: véletlenszerűen, Round Robin-ban az nginx-ben beállíthatod, és akkor 2% – balra, 98% – jobbra. De ez nem mindig megfelelő.
Nálunk például a felhasználó nem egyszeri kérdéssel lép kapcsolatba a rendszerrel. Ez normális: 2, 3, 4, 5 kérdés – a rendszereid is lehetnek ilyenek. Ha fontos számodra, hogy a felhasználó összes kérdése ugyanarra a vonalra érkezzen, ahova az első kérdés érkezett, vagy (a második pont) hogy a felhasználó összes kérdése egy új vonalra érkezzen a váltás után (lehet, hogy korábban már dolgozott a rendszerrel, a váltás előtt) – akkor ez a véletlenszerű eloszlás nem megfelelő számodra. Akkor van néhány lehetőség:
Az első lehetőség, a legegyszerűbb – a kliens alapparaméterei alapján (IP Hash). Van IP-d, és az IP-cím alapján osztod szét jobbra-balra. Ekkor működni fog az általam már leírt második eset, amikor történt egy telepítés, a felhasználó már elkezdheti használni a rendszeredet, és a telepítés pillanatától kezdve minden kérdés az új vonalra (ugyanarra, mondjuk) fog érkezni.Ha valamilyen okból ez nem megfelelő számodra, és feltétlenül a kérdéseket arra a vonalra kell irányítani, amerre az első, kezdeti felhasználói kérdés érkezett, akkor két lehetőséged van…
Az első lehetőség: vehetsz egy fizetős nginx+-t. Ott van egy Sticky sessions mechanizmus, amely a felhasználó kezdeti kérdésekor létrehoz egy munkamenetet, és azt egy adott upstreamhez köti. Az összes további felhasználói kérdés a munkamenet élettartamán belül arra az upstreamre kerül, ahova a munkamenetet létrehozták.Ez nem volt megfelelő számunkra, mert már volt egy szokványos nginx-ünk. Átállni az nginx+-ra – nem mintha ez drága lenne, de ez nekünk kissé fájdalmas volt, és nem volt túl helyes. A „Sticky sessions” például nem működött számunkra az egyszerű ok miatt, hogy a „Sticky sessions” nem ad lehetőséget az „Vagy-vagy” jellegű irányításra. Ott megadható, hogy a „Sticky sessions”-t például IP-cím vagy IP-cím és cookie vagy POST paraméter alapján végezzük, de az „Vagy-vagy” már bonyolultabb.
Ezért jutottunk el a negyedik lehetőséghez. Az Nginx-t „szteroidokkal” vettük (ez az openresty) – ez egy olyan Nginx, amely további támogatást nyújt a last-scriptek beillesztésére. Írhatsz egy last-skriptet, beadhatod ezt az „operny”-nek, és ez a last-skript teljesülni fog, amikor a felhasználói kérés beérkezik.
Írtunk egy ilyen kis scriptet, telepítettük az „operny”-t, és ebben a scriptben 6 különböző paramétert iterálunk az „Vagy” összefűzésével. A meglévő paraméterek alapján tudjuk, hogy a felhasználó egy bizonyos oldalra, vagy egy másikra érkezett, egy sorra vagy egy másikra.
Blue/Green telepítés. Előnyök és hátrányok
Természetesen lehetett volna valószínűleg kicsit egyszerűbben is (például a „Sticky Sessions”-t használva), de van egy olyan részlet is, hogy nemcsak a felhasználóval interakciózunk egy tranzakció feldolgozása során... A fizetési rendszerek is interakcióba lépnek velünk: miután feldolgoztuk a tranzakciót (miután lekérdeztük a fizetési rendszert), visszacsatolást kapunk.
És ha mondjuk a kontúrunkon belül át tudjuk vinni a felhasználó IP-címét minden kérésben, és az IP-címek alapján tudunk különbséget tenni, akkor nem mondhatjuk a „Visa”-nak: „Hölgyeim, mi egy olyan retro cég vagyunk, látszólag nemzetközi (a weboldalon és Oroszországban)... Kérlek, küldjétek el nekünk a felhasználó IP-címét egy plusz mezőben, a szabványos protokollotokkal”! Nyilvánvaló, hogy nem fognak egyetérteni.
Ezért nekünk ez nem volt megfelelő – openrestyt csináltunk. Tehát a routing nálunk így alakult ki:A „Blue/Green telepítésnek” vannak, az általam említett előnyei és hátrányai.
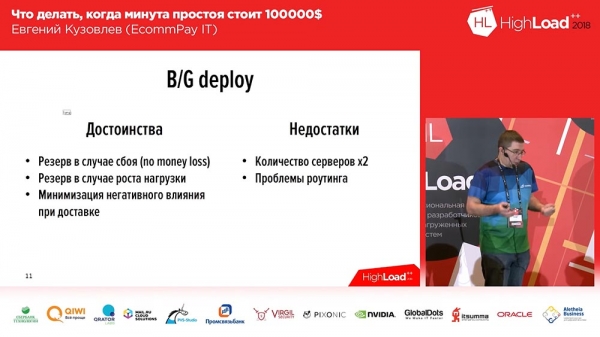
Két hátrány:
- foglalkoznod kell a routinggal;
- a második fő hátrány – a költségek.
Kétszer annyi szerverre van szükséged, kétszer annyi operatív erőforrásra, és kétszer annyi energiát kell fordítanod az egész állatkert fenntartására.
Egyébként, a jótékony hatások között van még egy dolog, amelyet eddig nem emeltem ki: van tartalékod a terhelés növekedésére. Ha robbanásszerű terhelés növekedése van, és hirtelen rengeteg felhasználó érkezik, akkor egyszerűen aktiválod a második vonalat az 50-50 elosztásban – és hirtelen kétszer annyi szervered van a klaszteredben, amíg meg nem oldod a szerverek hiányát.
Hogyan végezzünk gyors telepítést?
Beszéltünk a minimalizálás és a gyors visszagurítás problémájának megoldásáról, de a kérdés megmarad: "Hogyan lehet gyorsan telepíteni"?
Itt röviden és minden egyszerű.- Neked szükséged van folyamatos szállítási (CD) rendszerre – nélküle nem tudsz mit kezdeni. Ha csak egy szervered van, akkor manuálisan is telepíthetsz. Nálunk körülbelül ezerötszáz szerver van, és a manuális telepítések száma is ennyi, nyilvánvaló, hogy létrehozhatnánk egy részleget, amely akkora, mint ez a terem, csak a telepítésekhez.
- A telepítéseknek párhuzamosnak kell lenniük. Ha a telepítésed sorozatos, akkor minden rosszul áll. Egy szerver – rendben, de ezerötszáz szervert egész nap telepítenél.
- Megint, a gyorsítás érdekében, ez valószínűleg már nem kötelező. Telepítéskor általában a projekt összeállítása történik. Van egy webprojekted, van egy frontend részed (ott csinálsz web csomagot, npm-vel gyűjtesz – valami ilyesmi), és ez a folyamat alapjában véve nem sokáig tart – körülbelül 5 perc, de ezek az 5 perc kritikusak lehetnek. Ezért mi például nem így csináljuk: eltávolítottuk ezeket az 5 percet, mi az artefaktumokat telepítjük.
Mi az az artefaktum? Az artefaktum egy összegyűjtött build, amelyben már végrehajtották az összes építési részt. Ezt az artefaktumot az artefaktumtárolóban tároljuk. Korábban két ilyen tárolót használtunk – ezek a Nexus és jelenleg a jFrog Artifactory. A "Nexus"-t eredetileg azért használtuk, mert ezt a megközelítést Java alkalmazásokban kezdtük alkalmazni (ez jól illeszkedett ehhez a megközelítéshez). Aztán oda került néhány PHP-ben írt alkalmazás is; a "Nexus" már nem volt megfelelő, ezért választottuk a jFrog Artifactory-t, ami szinte mindent tud kezelni. Arra is eljutottunk, hogy az artefaktumtárolóban tároljuk a saját, szerverek számára készített bináris csomagjainkat.
Robbanásszerű terhelésnövekedés
Beszéltünk a szoftververzió váltásáról. A következő, amivel foglalkozunk, az robbanásszerű terhelésnövekedés. Itt valószínűleg nem a legjobb értelemben értem a robbanásszerű terhelésnövekedést…
Írtunk egy új rendszert – szolgáltatásorientált, modern és szép, mindenütt munkások, mindenütt sorok, mindenütt aszinkronitás. Ezekben a rendszerekben az adatok különböző folyamatokon keresztül áramolhatnak. Az első tranzakciónál az 1., 3., 10. munkás lehet aktív, a második tranzakciónál pedig a 2., 4., 5. munkás. És ma reggel, mondjuk, van egy adatfolyam, ami az első három munkást használja, de este hirtelen megváltozik, és már másik három munkást aktivál.
Ezért úgy alakul a helyzet, hogy valahogy méreteznie kell a munkásokat, valahogy a szolgáltatásait is méretezni kell, de úgy, hogy ne keletkezzenek felesleges erőforrások.
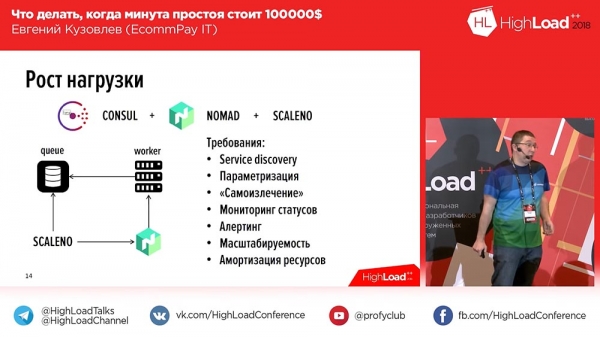
Megállapítottuk, hogy mik a követelmények. Ezek a követelmények eléggé egyszerűek: legyen benne szolgáltatásfelfedezés, paraméterezés – minden standard a skálázható rendszerek építéséhez, kivéve egy pontot – az erőforrások amortizációját. Megmondtuk, hogy nem vagyunk hajlandók amortizálni az erőforrásokat, hogy a szerverek csak fűtsenek. Használtuk a "Consul"-t, és a "Nomad"-ot, amely kezeli a munkásainkat.Miért probléma ez számunkra? Engedjék meg, hogy egy kicsit visszább lépjünk. Jelenleg körülbelül 70 fizetési rendszer áll mögöttünk. Reggel a forgalom a "Sberbank"-on keresztül megy, aztán például a "Sberbank" leáll, és átállítjuk egy másik fizetési rendszerre. 100 munkás működött a "Sberbank" előtt, de ezután hirtelen 100 munkást kellene aktiválnunk egy másik fizetési rendszerhez. Ezt pedig előnyösen emberi beavatkozás nélkül kellene megtennünk. Mert ha emberi beavatkozás szükséges, akkor 24/7 ott kell ülnie egy mérnöknek, aki csak ezzel foglalkozik, mert ilyen leállások, amikor 70 rendszer áll mögötted, rendszeresen előfordulnak.
Ezért néztük meg a "Nomad"-ot, amely nyitott IP-vel rendelkezik, és írtunk egy saját megoldást, a Scale-Nomad – ScaleNo-t, ami körülbelül ezt csinálja: figyeli a sor növekedését, és a sor dinamikája szerint csökkenti vagy növeli a munkások számát. Amikor elkészült, arra gondoltunk: "Talán nyílt forráskódúvá tegyük?" Aztán megnéztük – olyan egyszerű, mint a két fillér.
Még mindig nem tettük nyílt forráskódúvá, de ha a beszámoló után, azzal a felismeréssel, hogy szüksége van egy ilyen dologra, megjelenik az igény benne, az utolsó dián megtalálja a kapcsolataimat – légyszi, írjon nekem. Ha összegyűlik legalább 3-5 ember – nyílt forráskódúvá tesszük.
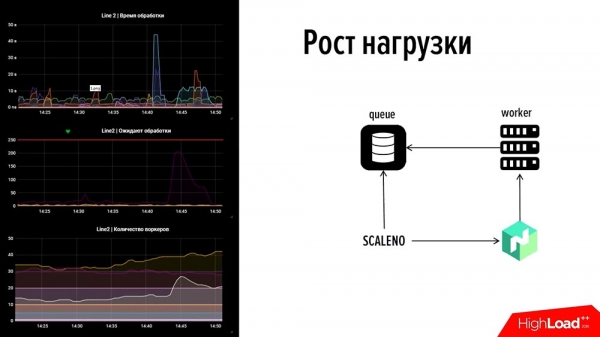
Hogyan működik? Nézzük meg! Előreugrunk: bal oldalon van egy rész a megfigyelésünkből: ez egy vonal, fent – az események feldolgozási ideje, középen – a tranzakciók száma, lent – a munkások száma.Ha megnézzük, ezen a képen van egy hiba. A felső grafikonon az egyik vonal 45 másodperc alatt megszakadt – az egyik kifizetési rendszer leállt. Azonnal megmutatta a forgalmat 2 perc alatt és növekedett a sor a másik kifizetési rendszerben, ahol nem voltak munkások (nem használtuk ki a forrást – éppen ellenkezőleg, helyesen használtuk fel a forrást). Nem akartuk felmelegíteni – ott minimális szám volt, körülbelül 5-10 munkás, de ők nem bírkóztak meg.
Az utolsó grafikonon látható a „domb”, ami azt jelzi, hogy a „Skaleno” megduplázta ezt a számot. És amikor a grafikon egy kicsit lejjebb ment, kicsit csökkent – a munkások száma automatikusan módosult. Így működik ez a dolog. Beszéltünk a 2. pontról – „Hogyan szabaduljunk meg gyorsan az okoktól”.
Megfigyelés. Hogyan ismerjük fel gyorsan a problémát?
Most az első pont – „Hogyan ismerjük fel gyorsan a problémát?” Megfigyelés! Gyorsan meg kell értenünk bizonyos dolgokat. Milyen dolgokat kell gyorsan megértenünk?
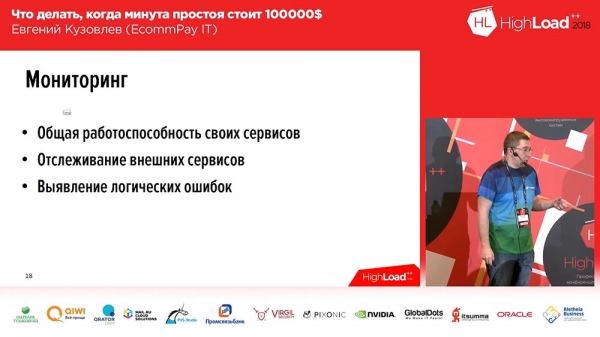
Három dolog!- Gyorsan meg kell értenünk és gyorsan kell felmérnünk a saját erőforrásaink működőképességét.
- Gyorsan meg kell értenünk a leállásokat, figyelemmel kell kísérnünk a számunkra külső rendszerek működőképességét.
- A harmadik pont – logikai hibák azonosítása. Ez az, amikor a rendszer működik, minden mutató normális, de valami nem stimmel.
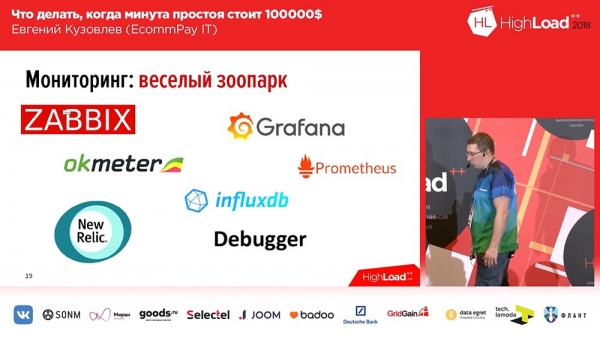
Itt valószínűleg nem mondok sok újdonságot. Kapitányként leszek a nyilvánvaló dolgokban. Keresgettük, mi van a piacon. Összejött egy „vidám állatkert”. Ilyen állatkertünk alakult most ki:
A „Zabbix”-et használjuk a „hardver” megfigyelésére, a szerverek fő mutatóinak figyelésére. Az „Okmeter”-t az adatbázisokhoz használjuk. A „Grafana”-t és a „Prometheus”-t használjuk minden egyéb mutatóhoz, ami nem felelt meg az első kettőnek, ráadásul egy részét a „Grafana” és a „Prometheus”, más részét a „Grafana” az „Influx”-szal és a Telegraf-fal.Egy évvel ezelőtt szerettük volna használni a New Relic-et. Klassz dolog, mindent tud. De amennyire sokat tud, annyira drága is. Amikor elértük az 1500 szerveres léptéket, a szolgáltató jött, és azt mondta: „Tegyük meg a szerződést a következő évre.” Megnéztük az árat, és azt mondtuk, hogy ezt nem fogjuk tenni. Jelenleg a New Relic-től elbúcsúzunk, körülbelül 15 szerverünk maradt a New Relic megfigyelés alatt. Az ár elképesztően magasnak bizonyult.
Van egy eszköz, amit mi valósítottunk meg – ez a Debugger. Eleinte „Bagger”-nek neveztük, de aztán jött egyangol tanárunk, és nagyon nevetett, ezért átneveztük „Debugger”-re. Mi ez valójában? Ez egy eszköz, amely 15-30 másodperc alatt minden komponensen, mint egy rendszer „fekete doboza”, teszteket futtat az alkatrész általános működőképességéről.
Például, ha egy külső oldal (például a fizetési oldal) – egyszerűen megnyitja, és megnézi, hogyan kell kinéznie. Ha ez a feldolgozás, akkor szimulál egy teszt tranzakciót – nézi, hogy ez a tranzakció elérkezik-e. Ha a kapcsolat a fizetési rendszerekkel – akkor megfelelően elindítunk egy tesztkérést, ahol lehet, és nézzük, hogy minden rendben van-e.
Milyen mutatók fontosak a megfigyeléshez?
Mit figyelünk meg a legfőképpen? Milyen mutatók számítanak nekünk fontosnak?
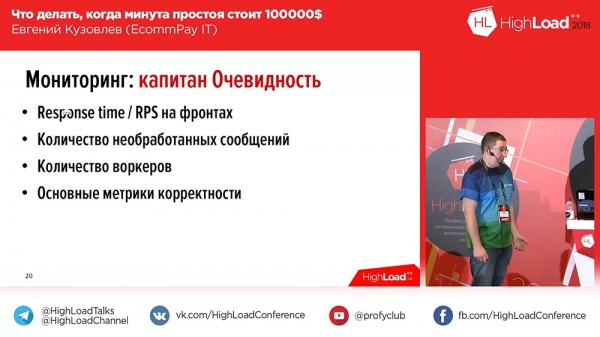
- Válaszidő / RPS a frontokon – nagyon fontos mutató. Azonnal jelzi, hogy valami nincs rendben.
- A feldolgozott üzenetek száma minden sorban.
- A munkások száma.
- A fő mérési pontosság mutatói.
Az utolsó pont – „biznisz”, „üzleti” mutató. Ha ugyanazt szeretné jól figyelni, meg kell határoznia egy-két mutatót, amelyek az Ön számára alapvető indikátorok. Nálunk egy ilyen mutató a teljesítmény (ez a sikeres tranzakciók számának aránya a tranzakciók összes folyama között). Ha ebben valami változik 5-10-15 perces időintervallumban – az azt jelenti, hogy problémáink vannak (ha drámaian változik).
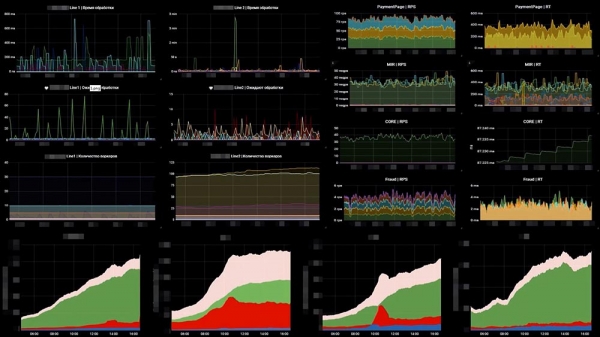
Hogy ez nálunk hogyan néz ki – az egyik táblázatunk példája:
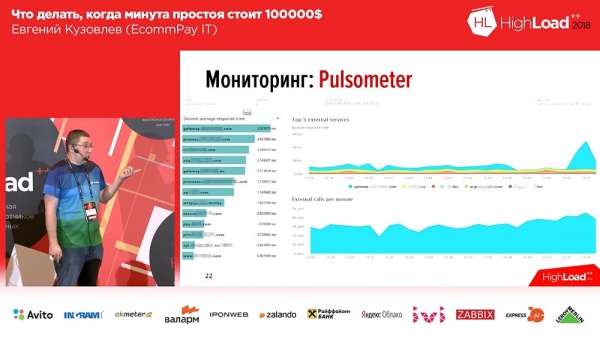
A bal oldalán 6 grafikon van, ami a vonalak szerint az alkalmazottak számát és a sorokban lévő üzenetek számát mutatja. A jobb oldalon az RPS és RTC látható. Alul pedig az a bizonyos „üzleti” metrika. Az „üzleti” metrikán azonnal látjuk, hogy valami nem stimmel a kettős középső grafikonon… Ez éppen azt jelzi, hogy megint leállt egy rendszer, ami mögöttünk áll.Másodszor, amit tennünk kellett, az a külső fizetési rendszerek leállásának figyelése volt. Itt az OpenTracing-ot használtuk – egy mechanizmust, sztandardot, paradigmát, amely lehetővé teszi a elosztott rendszerek nyomkövetését; és ezt egy kicsit módosítottuk. A sztandard OpenTracing paradigma azt mondja, hogy minden egyes kérés nyomkövetését építjük fel. Nekünk erre nem volt szükségünk, ezért ezt összesítve, aggregálva csomagoltuk. Készítettünk egy eszközt, amely lehetővé teszi számunkra a rendszerek sebességének nyomon követését, amelyek mögöttünk állnak.
A grafikon azt mutatja, hogy az egyik fizetési rendszer 3 másodperc alatt válaszolt – ezzel problémáink akadtak. Emellett ez a dolog reagálni fog, amikor a problémák elkezdődnek, 20-30 másodperces intervallumon belül.A harmadik típusú hibák monitoringja, amelyek léteznek – a logikai monitoring.
Őszintén szólva, nem tudtam, mit rajzoljak erre a diára, mert sokáig kerestük a piacon azt, ami nekünk megfelelő. Nem találtunk semmit, ezért magunknak kellett elkészítenünk.
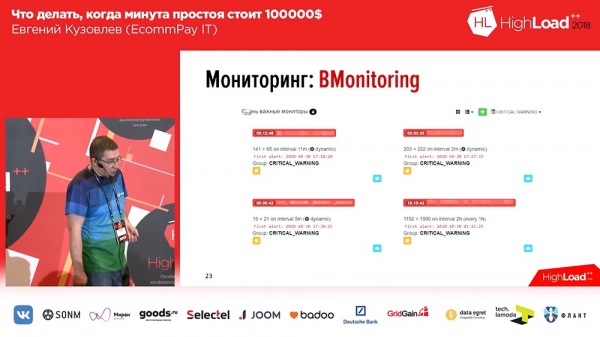
Mit értek logikai monitoring alatt? Képzeljen el egy rendszert (például egy „Tinder” klónt); elkészítette, elindította. A sikeres menedzser, Vasya Pupkin felrakja a telefonjára, lát egy lányt, tetszik neki… de a tetszés nem a lánynak megy – hanem Mihály, a biztonsági őrnek megy el az üzleti központból. A menedzser lemegy, majd meglepődik: „Miért mosolyog úgy az a biztonsági őr, Mihály?”Ilyen helyzetekben... Számunkra ez a helyzet kicsit másképp hangzik, mert (ahogy írtam) ez egy olyan hírnév-veszteség, ami közvetve pénzügyi veszteségekhez vezet. Mi éppen a fordított helyzetben vagyunk: közvetlen pénzügyi veszteséget szenvedhetünk el – például, ha egy tranzakciót sikeresnek jelöltünk, de az nem volt az (vagy fordítva). Készítenünk kellett egy saját eszközt, ami nyomon követi az üzleti mutatók alapján a sikeres tranzakciók számát dinamikusan egy időintervallumban. Nem találtunk semmit a piacon! Ezt a gondolatot szerettem volna átadni. Ilyen típusú problémák megoldására nincs semmi a piacon.
Ez a kérdés arra vonatkozott, hogy hogyan lehet gyorsan azonosítani a problémát.
Hogyan lehet meghatározni a telepítés okait
A harmadik csoport feladatai, amelyeket megoldunk – miután azonosítottuk a problémát, és megszüntettük azt, jó lenne megérteni az okokat a fejlesztéshez, a teszteléshez, és tenni valamit ezzel kapcsolatban. Ennek megfelelően kutatnunk kell, be kell gyűjtenünk a naplókat.
Ha a naplókról beszélünk (a fő ok – naplók), a naplóink fő része az ELK Stack-ben van – gyakorlatilag mindenkinek így van. Néhányan, lehet, nem az ELK-ban, de ha gigabájt számú naplókat írsz, előbb-utóbb eljutsz az ELK-hoz. Mi terabájt számú naplókat írunk.
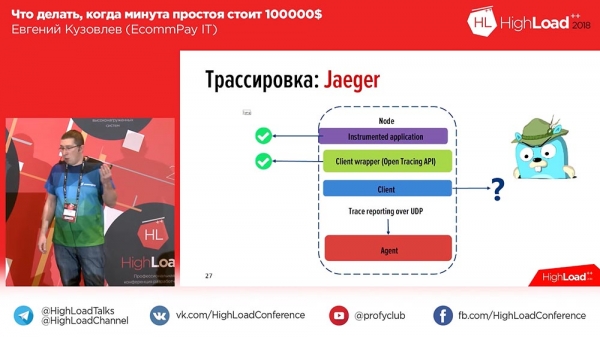
Itt van egy probléma. Javítottuk, orvosoltuk a felhasználó hibaét, elkezdtük ásni, hogy mi volt az, belemásztunk a Kibanába, megadtuk a tranzakció azonosítót, és így kaptunk egy ilyen hosszú listát (sok mindent mutat). És ebben a hosszú listában egyáltalán nem érthető semmi. Miért? Mert nem világos, melyik rész vonatkozik melyik munkásra, melyik rész vonatkozik melyik komponensre. És ebben a pillanatban rájöttünk, hogy szükségünk van nyomozásra – azaz az OpenTracing-ra, amiről beszéltem.Ezt egy éve átbeszéltük, és a piac felé fordítottuk a figyelmünket, ahol két eszköz akadt – a Zipkin és a Jaeger. A Jaeger valójában egyfajta ideológiai örököse, ideológiai folytatója a Zipkin-nak. A Zipkinban minden jó, a kivétel az, hogy nem tud aggregálni, nem tudja a naplókat a nyomozásba beemelni, csak az idő nyomozását. A Jaeger ezt támogatta.
Megnéztük az „Eger”-t: lehetséges alkalmazásokat eszközölni, lehet írni az API-ba (az API szabvány PHP számára akkor még nem volt jóváhagyva – ez egy éve történt, és most már jóváhagyva van), de egy ügyfél sem volt. „Rendben”, gondoltuk, és megírtuk a saját ügyfelünket. Íme, hogy néz ki:
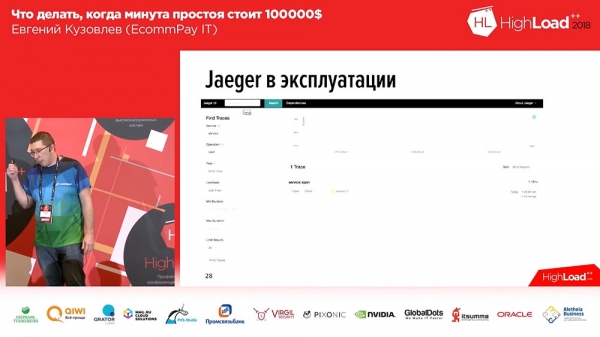
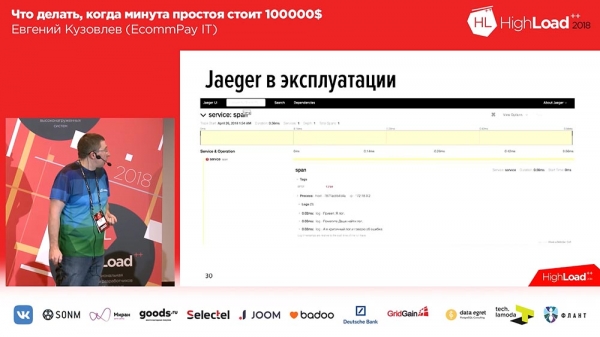
Az „Eger”-ben minden üzenethez span-ek készülnek. Tehát amikor a felhasználó megnyitja a rendszert, egy vagy két blokkot lát minden bejövő kéréshez (1-2-3 – annyi bejövő kérés volt a felhasználótól, ahány blokk van). A felhasználók könnyebb navigálása érdekében a naplókhoz és az időbeli nyomozáshoz tageket adtunk hozzá. Így, ha hiba történik, alkalmazásunk megfelelő tagekkel jelöli a naplót, Error címkével. Szűrhetjük az Error címke szerint, és csak azok a span-ek jelennek meg, amelyek tartalmazzák a hibás blokkot. Íme, hogyan néz ki, ha kibővítjük a span-t:
A span belsejében egy sor nyomkövetési információ található. Ebben az esetben három tesztelt nyomkövetés szerepel, és a harmadik nyomkövetés azt jelzi számunkra, hogy hiba történt. Ugyanitt látjuk az időbeli nyomozást: fölül van az idővonal, és láthatjuk, hogy adott log mikor lett rögzítve.Így remekül ment. Megírtuk a saját kiegészítőnket, és open source-á tettük. Ha dolgozni szeretne a nyomozással, ha a PHP nyelven szeretne az „Eger”-rel dolgozni – van a mi kiegészítőnk, welcome to use, ahogy mondani szokták:
Ez a kiegészítőnk – kliens az OpenTracing API használatára, php-extention formájában készült, tehát meg kell építenie, és a rendszerbe be kell illesztenie. Egy éve nem volt más. Most más kliensek is megjelentek, amelyek komponensekként működnek. Ön dönt: vagy kompozícióval tölti le a komponenseket, vagy használja a kiegészítőt, az ön döntése.Vállalati szabványok
Beszéltünk a három parancsolatról. A negyedik parancsolat – a megközelítések standardizálása. Miről van szó? Körülbelül erről:
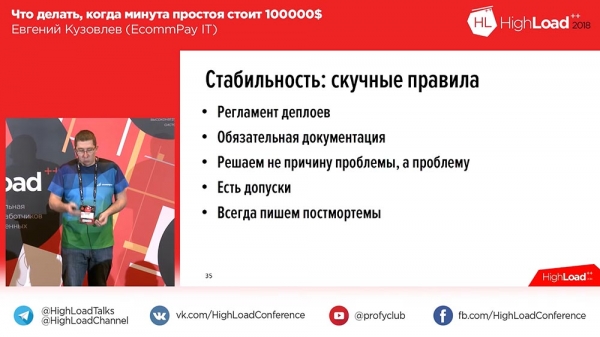
Miért szerepel itt a „vállalati” szó? Nem azért, mert nagy vagy bürokratikus cég vagyunk, nem! A „vállalati” szót itt arra akartam használni, hogy minden cégnek, minden terméknek megvannak a saját szabványai, és önnek is így kell lennie. Milyen szabványok léteznek nálunk?- Van egy telepítési szabályzatunk. Nélküle nem tudunk előre haladni, nem működik a rendszerünk. Hetente körülbelül 60 alkalommal telepítünk, tehát gyakorlatilag folyamatosan zajlanak a telepítések. Ezen kívül például a telepítési szabályzatunkban tabu a pénteki telepítés – alapvetően nem telepítünk.
- Kötelező a dokumentáció. Egyetlen új komponens sem jut el a termelési környezetbe, ha nincs dokumentációja, még akkor sem, ha azt a kutatás-fejlesztés munkatársaink írták. Elvárjuk tőlük, hogy készítsenek telepítési útmutatót, figyelő térképet és egy körülbelüli leírást (hogy a programozók hogyan tudják megfogalmazni), hogy hogyan működik a komponens, és hogyan lehet hibaelhárítani.
- Nem a probléma okát, hanem magát a problémát kezeljük – erről már korábban beszéltem. Számunkra fontos, hogy megkíméljük a felhasználót a problémáktól.
- Van egy toleranciaszintünk. Például nem számítunk leállásnak, ha két perc alatt 2% -os forgalomvesztést tapasztalunk. Ez alapvetően nem kerül be a statisztikáinkba. Ha a százalékos arány vagy az időtartam magasabb, akkor már számít.
- Mindig készítünk utólagos elemzéseket. Bármilyen, a termelési környezetben előforduló rendellenes helyzetet rögzítünk az utólagos elemzésben. Az utólagos elemzés egy dokumentum, amelyben leírjuk, mi történt, részletes időzítéssel, mit tettünk a hiba kijavításáért, és (ez kötelező rész!) mit fogunk tenni annak érdekében, hogy a jövőben elkerüljük az ilyen helyzeteket. Ez kötelező, fontos a további elemzéshez.
Mit számítunk leállásnak?
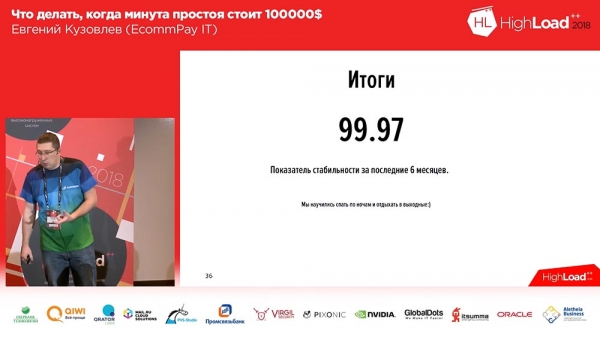
Mihez vezetett ez az egész?Ez ahhoz vezetett, hogy (bizonyos stabilitási problémáink voltak, ami egyik ügyfelünk számára sem volt kielégítő) az elmúlt 6 hónapban a stabilitási mutatónk 99,97%-ot tett ki. Mondhatni, hogy ez nem túl magas. Igen, van hová fejlődnünk. Ebből a mutatóból körülbelül a fele nem a mi stabilitásunk, hanem a rajtunk álló webalkalmazás tűzfalának stabilitása, amely szolgáltatásként működik, de az ügyfeleknek ez mindegy.
Megtanultunk éjjel aludni. Végre! Fél évvel ezelőtt ezt nem tudtuk. És ezen a megjegyzésen szeretném megemlíteni, hogy tegnap este nagyszerű előadás volt egy nukleáris reaktor irányító rendszeréről. Ha hallják az emberek, akik ezt a rendszert írták – kérlek, felejtsétek el, amit mondtam a "2% -os forgalomvesztés nem számít leállásnak". Számotokra a 2% leállás, még ha csak két percre is!
Ennyi volt! Kérdéseid?
A terheléselosztókról és az adatbázisok migrációjáról
Kérdés a közönségtől (a továbbiakban: K): – Jó estét kívánok! Nagyon köszönöm a nagyszerű admin előadást! A kérdés rövid, a terheléselosztókkal kapcsolatban. Említette, hogy van WAF-juk, ami azt jelenti, hogy a terheléselosztóként valamilyen külső…
EK: – Nem, terheléselosztóként saját szolgáltatásainkat használjuk. Ebben az esetben a WAF számunkra kizárólag a DDoS elleni védekezés eszköze.
K: – Mondana pár szót a terheléselosztókról?
EK: – Ahogy már említettem, ezek openresty-ből álló szervercsoportok. Jelenleg 5 tartalék csoportunk van, amelyek kizárólag… tehát a szerver, amelyen kizárólag openresty fut, csak a forgalmat proxizza. Azért, hogy megértsék, mennyit tartunk: jelenleg a szokásos forgalom néhány száz megabit. Ezek jól kezelik, nem is erőltetik meg magukat.
K: – Szintén egy egyszerű kérdés. Van a Blue/Green kiadás. Mit tesznek például az adatbázis-migrációkkal?
EK: – Jó kérdés! Nézzék, a Blue/Green kiadásunkban minden vonalra külön sorok vannak. Tehát, ha az események sorairól beszélünk, amelyek a munkásról a másik munkásra kerülnek, külön sorok vannak a kék és a zöld vonalon. Ha magáról az adatbázisról beszélünk, akkor azt szándékosan szűkítettük, ahogy tudtuk, az összeset szinte sorokba helyeztük, az adatbázisunkban csak a tranzakciós verem található. A tranzakciós verem egységes minden vonalon. Az adatbázissal ebben a kontextusban: a kék és zöld vonalon nem osztjuk meg, mert mindkét kódvariációnak tudnia kell, mi történik a tranzakcióval.
Barátaim, van még egy kis ajándékom, hogy ösztönözzelek titeket – egy könyv. Ezt a legjobb kérdésért szeretném átadni.
K: – Üdvözlöm. Köszönöm az előadást. Egy kérdés van. Nyomon követik a tranzakciókat, nyomon követik a szolgáltatásokat, amelyeket használnak… De hogyan követik nyomon azt, hogy valaki valamilyen módon eljutott a fizetési oldalra, teljesítette a fizetést, és a projektje jóváírta a pénzt? Tehát hogyan követik nyomon, hogy a kereskedő elérhető és elfogadta a callbackjét?
EK: – A "kereskedő" számunkra ebben az esetben pontosan olyan külső szolgáltatás, mint a fizetési rendszer. Nyomon követjük a kereskedő válaszidejét.
Az adatbázis titkosításáról
K: – Helló. Van egy kérdésem. Önöknek vannak érzékeny adatai a PCI DSS szerint. Szeretném megtudni, hogy hogyan tárolják a PAN számokat a sorokban, amelyeket át kell küldeniük? Használnak-e valamilyen titkosítást? És ezzel összefüggésben egy második kérdés: a PCI DSS szerint időközönként újra kell titkosítani az adatbázist, ha változások történnek (mint például adminisztrátorok elbocsátása) – hogyan biztosítják ekkor a hozzáférhetőséget?
EK: – Kiváló kérdés! Először is, a sorokban nem tárolunk PAN számokat. Alapvetően nem is tárolhatunk PAN számokat nyílt formában, ezért egy külön szolgáltatást használunk (ami nálunk a „Keydemon” nevet viseli) – ez a szolgáltatás csak egy dolgot csinál: megkap egy üzenetet, és visszaadja titkosítva. Ezzel a titkosított üzenettel mindent tárolunk. Így a kulcs hossza körülbelül egy kilobájt, hogy komoly és megbízható legyen.K: – Most már 2 kilobájt szükséges?
EK: – Úgy tűnik, hogy még tegnap is 256 volt… Hová lehetne még ezt növelni?!
Ez tehát az első. Másodszor, a meglévő megoldás támogatja az újra-titkosítási eljárást – két pár „keksz” (kulcs) van, amelyek „dek” (adat titkosító) generálnak (a key – ez a kulcsok, a dek – ezek a kulcsokból származó titkosítók). Ha elindítjuk az eljárást (ez rendszeresen történik, általában 3 havonta ± néhány), új pár „keksz” tölthetjük fel, és végbemegy az adatok újra-titkosítása. Van egy külön szolgáltatásunk, amely az összes adatot kiemeli, újra titkosítja; az adatok mellett tárolva van az a kulcsazonosító, amellyel titkosították őket. Amint az adatokat az új kulcsokkal titkosítjuk, eltávolítjuk a régi kulcsokat.
Néha a fizetéseket manuálisan kell lebonyolítani...
K: – Tehát, ha beérkezik egy visszatérítés valamilyen tranzakcióra, akkor régi kulccsal dekódolják?
EK: – Igen.
K: – Akkor még egy kis kérdés. Amikor valamilyen hiba, leállás, incidens történik, a tranzakciót manuálisan kell végrehajtani. Előfordulhat ilyen helyzet.
EK: – Igen, előfordul.
K: – Honnan szerzik ezeket az adatokat? Vagy saját kezűleg lépnek be ebbe a tárolóba?
EK: – Nem, nyilvánvaló, hogy van egy háttérrendszerünk, ami tartalmaz egy felületet a támogatásunk számára. Ha nem tudjuk, mi a tranzakció státusza (például amíg a fizetési rendszer nem válaszolt időtúllépéssel) – akkor nem tudjuk, tehát a végső státuszt csak teljes bizonyosság esetén hozzuk meg. Ebben az esetben a tranzakciót egy különleges státuszba helyezzük a manuális feldolgozásra. Reggel, másnap, amint a támogatás megkapja az információt, hogy a fizetési rendszerben ilyen tranzakciók maradtak, manuálisan feldolgozzák őket ezen a felületen.
K: – Van pár kérdésem. Az egyik a PCI DSS zónája: hogyan mentitek ki a naplókat a keretéből? Azért kérdezem ezt, mert a fejlesztő bármilyen adatot bevihetett a naplókba! A második kérdés: hogyan adtok ki hotfixeket? Kézzel az adatbázisban – ez egy lehetőség, de lehetnek ingyenes hotfixek – mi ennek a folyamata? És a harmadik kérdés, valószínűleg az RTO, RPO-hoz kapcsolódik. Nálatok a rendelkezésre állás 99,97, majdnem négy kilences, de úgy értem, hogy van második adatközpontotok, harmadik adatközpontotok, és ötödik adatközpontotok… Hogyan szinkronizáljátok őket, replikáljátok, és végzitek a többi feladatot?EK: – Kezdjük az első kérdéssel. Az első kérdés a naplókról szólt? Nálunk, amikor a naplók íródnak, van egy réteg, ami az összes érzékeny adatot maszkálja. Az maszk alapján nézi és kiegészítő mezők alapján. Ennek megfelelően a naplók már maszkált adatokkal és a PCI DSS keretával kerülnek ki. Ez egy olyan rendszeres feladat, amit a tesztelési részlegnek adtak. Nekik kötelességük minden feladatot ellenőrizni többek között azokra a naplókra, amiket írnak, és ez az egyik rendszeres feladat a kódellenőrzés során, annak érdekében, hogy kontrollálják, hogy a fejlesztő ne jegyezzen fel olyasmit. A következő ellenőrzést a biztonsági informatikai részleg végzi körülbelül hetente egyszer: véletlenszerűen kiválasztják az elmúlt nap naplóit, és speciális szkenner-analizátoron futtatják őket teszt szerverekről, hogy mindezt ellenőrizzék.
A hot-fixről. Ez benne van a telepítési szabályzatunkban. Külön ki van emelve a hot-fixek pontja. Úgy véljük, hogy hot-fixeket üzemeltetünk éjjel-nappal, amikor csak szükség van rá. Amint a verzió összeáll, és elvégeztük a tesztelést, valamint van egy anyagunk – az ügyeletes rendszergazda a támogatás hívására aktiválódik, és akkor telepíti, amikor szükséges.A "négy kilences"-ről. Az a szám, ami most nálunk van, valójában elérte a célt, és az egy másik adatközpontban is törekedtünk rá. Most van egy második adatközpontunk, és elkezdjük az adatforgalmat közötte, és a keresztkapcsolat kérdése az adatközpontok replikálásánál valóban nem trivialis. Korábban megpróbáltuk megoldani ezt különféle eszközökkel: a "Taranta"-t használtuk – nem működött, azonnal mondom. Ezért arra jutottunk, hogy a „senza”-t manuálisan rendelünk meg. Minden alkalmazásunk valójában aszimmetrikus összesítést végez "change – done" üzemmódban az adatközpontok között.
K: – Ha volt második, akkor miért nem lett harmadik? Mert a Split-brain még senkinek…
EK: – De nekünk nincs „Split-brain”. Mivel minden alkalmazásunk multimaster üzemmódban működik, nem érdekes, hogy melyik központba érkezik a kérés. Felkészültünk arra, hogy, ha az egyik adatközpontunk meghal (ezt számításba vesszük), és a felhasználói kérdés közben átváltunk a második központra, akkor készen állunk elveszíteni azt a felhasználót, valójában; de ezek az esetek tényleg egyediek lesznek, abszolút egyediek.
K: – Jó estét. Köszönöm a beszámolót. Meséltél a hibakeresőd programról, ami a gyártásban futtat bizonyos teszt tranzakciókat. Mesélj a teszt tranzakciókról! Milyen mélyen megy ez?
EK: – Teljes cikluson megy végig az egész komponens. A komponens számára nincs különbség a teszt és a valós tranzakció között. Logikai szempontból ez egy külön projekt a rendszerben, ahol csak teszt tranzakciókat futtatunk.
K: – Hol szűritek ezt? Itt a Core elküldte…
EK: – Mi a „Cor”-t követjük ebben az esetben a teszt tranzakciókhoz… Van egy fogalmunk a routerről: a "Core" tudja, hogy melyik fizetési rendszerhez kell küldeni – egy hamis fizetési rendszerbe küldünk, amely egyszerűen http-visszajelzést ad, és ennyi.
K: Kérem, mondja el, hogy az önök alkalmazása egy nagy monolitikus rendszer, vagy valamilyen szolgáltatásokra, esetleg mikroszolgáltatásokra van bontva?
EK: Nálunk nem monolit van, természetesen, hanem szolgáltatásorientált alkalmazásunk van. Viccelődünk azzal, hogy nálunk szolgáltatások léteznek monolitokból – valóban elég nagyok. Mikroszolgáltatásoknak nevezni ezt aligha lehet, de ezek valóban szolgáltatások, amelyekben elosztott gépek munkásai működnek.
Ha a szolgáltatás a szerveren kompromittálva van...
K: Akkor a következő kérdésem van. Még ha monolit is lenne, akkor is azt mondta, hogy sok ilyen instant-szervere van, amelyek alapvetően adatokat kezelnek, és a kérdés az, hogy: "Ha az egyik instant-szerver vagy alkalmazás, valamelyik külön elem kompromittálva van, van-e hozzájuk valamilyen hozzáférési szint? Ki mit tehet? Kihez lehet fordulni, milyen adatokért?"
EK: Igen, kétségtelenül. A biztonsági követelmények eléggé szigorúak. Először is, nyitott adathalmozásaink vannak, és csak azok a portok nyitottak, amelyeken előre feltételezzük a forgalom mozgását. Ha egy komponens egy adatbázissal (mondjuk, a 'MySQL'-lel) 5-4-3-2-n keresztül kommunikál, akkor csak a 5-4-3-2 lesz megnyitva, és más portok, más forgalmi irányok nem lesznek elérhetők. Ezen kívül fontos megérteni, hogy a termelésünkben körülbelül 10 különböző biztonsági kontúr létezik. És még ha valamilyen módon kompromittálva is lett az alkalmazás, Isten ments, akkor a támadó nem tud hozzáférni a szerver vezérlő konzoljához, mert ez egy másik biztonsági hálózati zóna.K: Ami engem ebben a kontextusban jobban érdekel, hogy önöknek vannak bizonyos szerződéseik a szolgáltatásokkal – hogy mit tehetnek, milyen 'akciókon' keresztül férhetnek hozzá egymáshoz… A normális folyamatban bizonyos szolgáltatások kérnek egy sor 'akciót' a másikon. A többihez normál esetben nem fordulnak, és más felelősségi körük van. Ha azonban az egyikük kompromittálva van, meg tudja-e hívni a másik szolgáltatás 'akcióit'?
EK: – Értem. Ha normál körülmények között egy másik szerverrel a kommunikáció engedélyezett volt, akkor – igen. Az SLA-szerződés értelmében nem figyelemmel kísérjük, hogy csak az első 3 „action” engedélyezett számodra, míg a 4. „action” nem. Ez talán felesleges lenne számunkra, mivel nekünk alapvetően négy szintű védelmi rendszerünk van a keretek számára. Mi inkább a keretek védelmére törekszünk, nem pedig a belső szint védelmére.
Hogyan működnek a Visa, a Mastercard és a „Sberbank”?
K: – Szeretném tisztázni a kérdést a felhasználó átkapcsolásával kapcsolatban egy adatközpontból a másikba. Amennyire tudom, a „Visa” és a „Mastercard” a 8583-as bináris szinkron protokollt használják, ahol mikszek találhatók. És szeretném megtudni, hogy a váltás most a „Visa” és a „Mastercard”, vagy a fizetési rendszerek, a feldolgozók számára történik-e?
EK: – Ez a mikszek előtt van. A mikszek nálunk egy adatközpontban találhatók.
K: – Tehát nagyjából egy csatlakozási pontotok van?
EK: – A „Visa” és a „Mastercard” esetében – igen. Csak azért, mert a „Visa” és a „Mastercard” elég komoly befektetéseket igényelnek az infrastruktúrába külön szerződések megkötéséhez a második pár miksz beszerzéséhez, mondjuk. Ezek egy adatközpont keretein belül vannak fenntartva, de ha véletlenül meghalna az adatközpont, ahol a mikszek a „Visa” és a „Mastercard” csatlakozásához vannak, akkor a kapcsolatunk a „Visa”-val és a „Mastercard”-dal meg fog szűnni...
K: – Hogyan lehetnek ezek fenntartva? Azt tudom, hogy a „Visa” alapvetően csak egy csatlakozást engedélyez!
EK: – Ők maguk biztosítják a berendezést. Legalábbis nekünk olyan berendezés jött, ami belsőleg biztosítva van.
K: – Tehát a rack az ő Connects Orange-juktól van?
EK: – Igen.
K: – De mi a helyzet abban az esetben, ha az adatközpont eltűnik, hogyan lehet továbbra is használni? Vagy egyszerűen megáll a forgalom?
EK: – Nem. Ekkor egyszerűen átirányítjuk a forgalmat egy másik csatornára, ami természetesen drágább lesz számunkra és az ügyfelek számára is. De a forgalom nem a közvetlen „Visa”, „Mastercard” csatlakozásunkon keresztül fog menni, hanem egy feltételezett „Sberbank”-on keresztül (nagyon leegyszerűsítve).
Elnézést kérek, ha megsértettem a „Sberbank” munkatársait. De a mi statisztikáink szerint az orosz bankok közül a „Sberbank” gyakran összeomlik. Egy hónap sem telik el anélkül, hogy a „Sberbank”-nak ne lenne valami problémája.

Egy kis reklám 🙂
Köszönjük, hogy velünk maradtál. Tetszenek a cikkeink? Szeretnél több érdekes anyagot látni? Támogass minket, és rendelés leadásával vagy ismerősöknek ajánlással segíts nekünk. , Egyedülálló alternatívája az entry-level szervereknek, amelyet Önnek találtunk ki: (elérhetők RAID1 és RAID10 opciók, akár 24 magig és 40GB DDR4-ig).
Dell R730xd kétszer olcsóbban a Tier IV Equinix adatközpontban Amszterdamban? Csak nálunk Hollandiában! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — 99 dollártól! Olvasd el ezt
Forrás: habr.com
