

Február 26-án rendeztük meg az Apache Ignite GreenSource meet-upot, ahol az open source projekt hozzájárulói beszéltek. . A közösség életében fontos esemény volt a komponens átalakítása. , amely lehetővé teszi felhasználói mikroszolgáltatások telepítését közvetlenül az Ignite klaszterbe. Erről a bonyolult folyamatról beszélt a meet-upon , szoftverfejlesztő és már több mint két éve az Apache Ignite hozzájárulója.
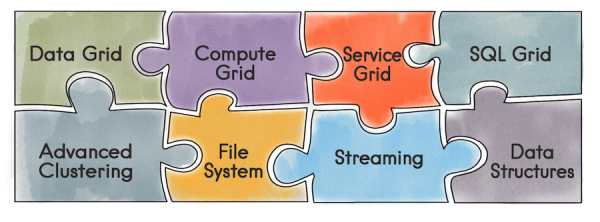
Kezdjük azzal, hogy mi is az az Apache Ignite. Ez egy adatbázis, amely egy elosztott kulcs/érték tároló, támogatja az SQL-t, tranzakciókat és gyorsítótárazást. Ezen kívül az Ignite lehetővé teszi felhasználói szolgáltatások telepítését közvetlenül az Ignite klaszterbe. A fejlesztők hozzáférhetnek minden eszközhöz, amelyet az Ignite biztosít — elosztott adatszerkezetek, üzenetküldés, streaming, számítási és adat rács. Például a Data Grid használatakor megszűnik az adatraktárhoz külön infrastruktúra kezelési problémája, és ebből következően a ráfordítási költségek.
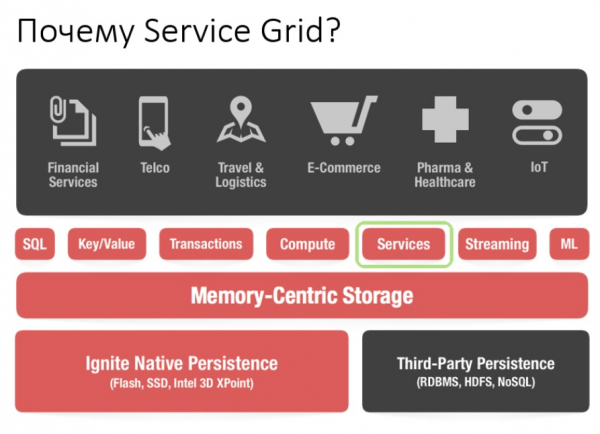
A Szolgáltatási Rács API-ját használva a felhasználó össze tudja állítani a szolgáltatást, csupán a telepítési séma és magának a szolgáltatásnak a megadásával a konfigurációban.
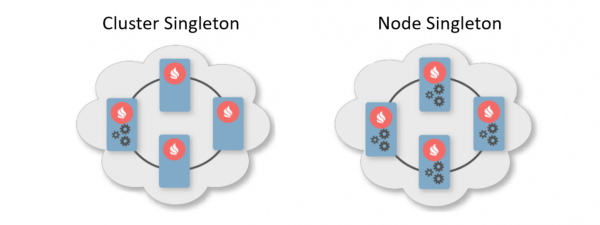
Általában a telepítési séma az, hogy megadják az instanciák számát, amelyet a klaszter csomópontjain kell telepíteni. Két tipikus telepítési séma létezik. Az első a Klaszter Singleton: bármikor garantáltan egy példány áll rendelkezésre a klaszterben a felhasználói szolgáltatásból. A második a Csomópont Singleton: minden klasztercsomóponton egy példány van telepítve a szolgáltatásból.
A felhasználó azt is megadhatja, hogy mennyi szolgáltatás instanciát szeretne az egész klaszterben, és definálhatja a megfelelő csomópontok szűrésére szolgáló predikátumot. Ilyen forgatókönyv esetén a Szolgáltatási Rács automatikusan kiszámítja az optimális elosztást a szolgáltatások telepítéséhez.
Ezen kívül létezik egy funkció, az Affinity Service. Az Affinity egy olyan funkció, amely meghatározza a kulcsok és partíciók, valamint a partíciók és csomópontok közötti kapcsolatot a topológiában. A kulcs alapján meg lehet határozni azt az elsődleges csomópontot, ahol az adatok tárolódnak. Így a saját szolgáltatásodat egy kulcshoz és az affinity-funkció cache-éhez tudod társítani. Ha az affinity-funkció változik, automatikus redeploy történik. Így a szolgáltatás mindig az adatok mellett lesz, amelyekkel manipulálnia kell, és ennek következtében csökkenthetők az információkhoz való hozzáférés költségei. Ezt a sémát valamilyen értelemben összefonódott számításoknak nevezhetjük.
Most, hogy áttekintettük a Service Grid előnyeit, beszéljünk a fejlődéséről.
Mi történt korábban
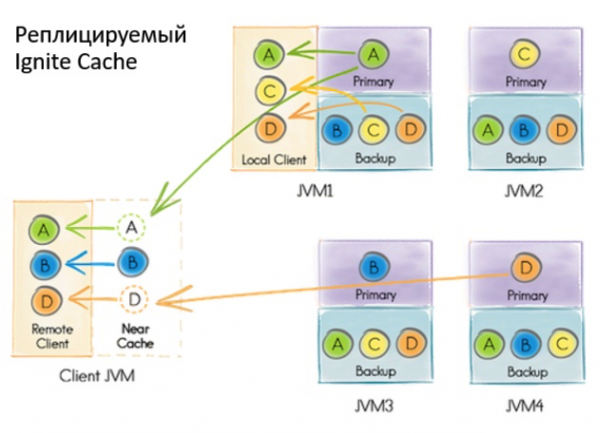
A Service Grid korábbi megvalósítása a tranzakcionális replikált Ignite rendszer cache-jén alapult. Az Ignite-ban a 'cache' alatt tárolót értünk. Vagyis ez nem egy ideiglenes dolog, ahogy azt gondolhatnánk. Annak ellenére, hogy a cache replikálva van, és minden csomópont tartalmazza az összes adatot, a cache belül particionált nézetet mutat. Ez a tárolók optimalizációjával áll összefüggésben.
Mi történt, amikor a felhasználó egy szolgáltatást akart telepíteni?
- Az összes csomópont a klaszterben feliratkozott az adatfrissítésekre a tárolóban a beépített Continuous Query mechanizmus segítségével.
- A kezdeményező csomópont egy read-committed tranzakció keretében írt a bázisba, amely tartalmazta a szolgáltatás konfigurációját, beleértve a sorosított példányt.
- Amikor értesítést kapott az új bejegyzésről, a koordinátor a konfiguráció alapján számította ki a elosztást. A kapott objektumot visszaírták az adatbázisba.
- Ha a csomópont bekerült az elosztásba, a koordinátornak telepítenie kellett.
Ami nem tetszett nekünk
Valamikor arra a következtetésre jutottunk, hogy így nem lehet dolgozni a szolgáltatásokkal. több oka is volt ennek.
Ha a telepítés során bármilyen hiba történt, arról csak annak a csomópontnak a naplóiból lehetett értesülni, ahol az esemény történt. Csak aszinkron telepítés létezett, így a felhasználó kezelésének visszaadása után a telepítési metódustól némi extra időre volt szükség a szolgáltatás indításához — és ez idő alatt a felhasználó semmivel sem tudott foglalkozni. Ahhoz, hogy a Service Grid tovább fejlődjön, új funkciókat fejlesszünk ki, új felhasználókat vonzzunk, és mindenkinek egyszerűbbé tegyük az életét, változásra volt szükség.
Az új Service Grid tervezésekor elsősorban azt akartuk biztosítani, hogy a szinkron telepítés garanciát jelentsen: amint a felhasználónak visszaadjuk az irányítást az API-tól, azonnal használhatja a szolgáltatásokat. Ezenkívül lehetőséget szerettünk volna adni a kezdeményezőnek a telepítési hibák kezelésére.
Továbbá meg akartuk könnyíteni a megvalósítást, nevezetesen el akartunk térni a tranzakcióktól és az újra egyensúlyozástól. Annak ellenére, hogy a cache másolható és nincsenek egyensúlyozások, nagy telepítéskor, számos csomópont esetén, problémák merültek fel. A topológia változása miatt a csomópontoknak információt kell cserélniük, és nagy telepítéskor ezek az adatok nagyon sokat nyomhatnak.
Amikor a topológia instabil volt, a koordinátornak újra kellett számolnia a szolgáltatások eloszlását. Ráadásul, amikor tranzakciókkal kell dolgozni egy instabil topológián, az nehezen előre jelezhető hibákhoz vezethet.
Problems
Milyen globális változások lennének a kapcsolódó problémák nélkül? Az első a topológia megváltozása. Meg kell érteni, hogy bármikor, még a szolgáltatás telepítésekor is, egy csomópont beléphet a klaszterbe vagy kiléphet belőle. Továbbá, ha telepítés közben egy csomópont belép a klaszterbe, konzisztensen kell átadni az összes szolgáltatásra vonatkozó információt az új csomópontnak. És itt nem csak azokról van szó, amik már telepítve voltak, hanem a jelenlegi és jövőbeli telepítésekről is.
Ez csak egy a problémák közül, amit külön listába lehet gyűjteni:
- Hogyan telepíthetjük a statikusan konfigurált szolgáltatásokat a csomópont indításakor?
- A csomópont kilépése a klaszterből – mit kell tenni, ha a csomópont szolgáltatásokat hosztolt?
- Mi a teendő, ha a koordinátor megváltozott?
- Mit tegyünk, ha az ügyfél újra csatlakozik a klaszterhez?
- Kell-e feldolgozni az aktiválási/deaktiválási kéréseket, és hogyan?
- Mi van, ha egy cache megszüntetést hívtak meg, miközben affinitás-szolgáltatások kapcsolódnak hozzá?
És ez messze nem minden.
Megoldás
Célként az Event Driven megközelítést választottuk, amely a folyamatok közötti kommunikációt üzenetekkel valósítja meg. Az Ignite már megvalósított két komponenst, amelyek lehetővé teszik a csomópontok számára, hogy üzeneteket küldjenek egymásnak – communication-spi és discovery-spi.
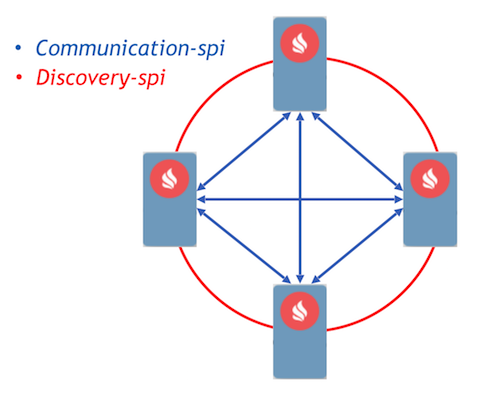
A Communication-spi lehetővé teszi a csomópontok közvetlen kapcsolatát és üzenetek küldését. Kiválóan alkalmas nagy mennyiségű adat továbbítására. A Discovery-spi lehetővé teszi, hogy üzenetet küldjünk az összes csomópontnak a klaszterben. A szabványos implementáció ezt a "gyűrű" topológián keresztül valósítja meg. Emellett van egy integrálás a Zookeeper-rel, ebben az esetben a "csillag" topológia használatos. Fontos megjegyezni, hogy a discovery-spi garantálja, hogy az üzenet pontosan a megfelelő sorrendben érkezik meg az összes csomóponthoz.
Nézzük meg a telepítési protokollt. Minden felhasználói telepítési és eltávolítási kérés a discovery-spi-n keresztül kerül kiküldésre. Ez a következőket biztosítja: garanciák:
- A kérés minden csomópont által meg lesz kapva a klaszterben. Ez lehetővé teszi a kérés feldolgozásának folytatását a koordinátor cseréjekor. Ezen kívül azt is jelenti, hogy egy üzenet esetén minden csomópont számára rendelkezésre állnak az összes szükséges metainformáció, például a szolgáltatás konfigurációja és a sorozatolt példánya.
- A szigorú üzenetátviteli sorrend lehetővé teszi a konfigurációs ütközések és a versengő kérések megoldását.
- Mivel a csomópont topológiába való belépését szintén a discovery-spi kezeli, az új csomópontra az összes szükséges adat eljut a szolgáltatásokkal való munkához.
A kérés fogadásakor a klaszterben lévő csomópontok érvényesítik azt, és feldolgozási feladatokat alakítanak ki. Ezeket a feladatokat sorba állítják, majd egy másik szálon, külön munkás által dolgozzák fel. Ez úgy valósul meg, mert a telepítés jelentős időt vehet igénybe, és a drága discovery áramlás késlekedését nem lehet megengedni.
Minden kérés a sorból a telepítési menedzser által kerül feldolgozásra. Van egy külön munkás, aki kiveszi a feladatot a sorból, és inicializálja azt, hogy elkezdhesse a telepítést. Ezt követően a következő lépések történnek:
- Minden csomópont önállóan számítja ki az eloszlást az új determinisztikus assignment funkció segítségével.
- A csomópontok üzenetet alkotnak a telepítés eredményeivel, és elküldik azt a koordinátornak.
- A koordinátor aggregálja az összes üzenetet, és összegzi a telepítési folyamat eredményét, amelyet a discovery-spi-n keresztül elküld minden csomópontnak a klaszterben.
- A result fogadásakor a telepítési folyamat befejeződik, majd a feladat eltávolításra kerül a sorból.
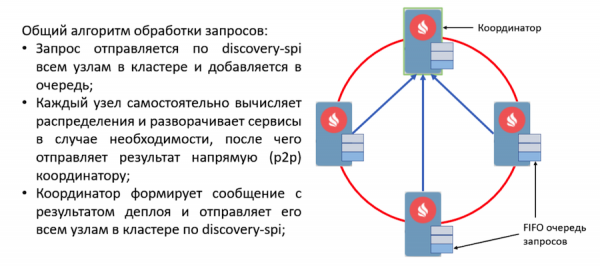
Új eseményalapú dizájn: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Ha a telepítés során hiba lép fel, a csomópont azonnal belefoglalja ezt a hibát a koordinátornak küldött üzenetbe. Az üzenetek összegyűjtése után a koordinátor információval fog rendelkezni az összes telepítési hibáról, és ezt az üzenetet a discovery-spi-n keresztül küldi el. A hiba információk bármely csomóponton elérhetők lesznek a klaszterben.
Ezt az algoritmust követve minden fontos esemény feldolgozásra kerül a Szolgáltatás Rácsban. Például, a topológia változása szintén egy üzenet a discovery-spi-n. Összességében, ha az előző verzióval hasonlítjuk össze, a protokoll meglehetősen könnyű és megbízható lett. Olyan mértékben, hogy kezelni tudja a telepítés alatt előforduló bármilyen helyzetet.
Mi következik
Most a tervek következnek. Minden jelentős fejlesztés az Ignite projektben egy megújítási kezdeményezésként valósul meg, amit IEP-nek hívunk. A Szolgáltatás Rács újratervezésének is van IEP-je — a „Szerelés a Szolgáltatás Rácsban” vicces nevű projekt. De valójában nem csak az olajat cseréltük az engine-ben, hanem magát a motort.
Az IEP feladatait két szakaszra osztottuk. Az első egy nagyobb fázis, amely magában foglalja a telepítési protokoll átdolgozását. Ez már be lett olvasztva a fő ágba, így kipróbálhatja az új Szolgáltatás Rácsot, ami a 2.8-as verzióban fog megjelenni. A második fázis számos más feladatot foglal magában:
- Forró redeploy
- Szolgáltatások verziózása
- Hibamentesség növelése
- Vékony kliens
- Különböző metrikák megfigyelésére és számítására szolgáló eszközök
Végül javasoljuk a Szolgáltatás Rács használatát a magas rendelkezésre állású hibamentes rendszerek építéséhez. Továbbá, invitálunk, hogy csatlakozzon hozzánk a és tapasztalata megosztására. Az Ön tapasztalata valójában fontos a közösség számára, segít megérteni, merre tovább, hogyan fejleszthetjük a jövőben az komponenst.
Forrás: habr.com
