

Találtam egy feladatot, amely a következő jellegű. Meg kell valósítanom egy adatot tároló tárolót, amely biztosítja a következő funkciókat:
- új elem beszúrása
- elem törlése sorszám alapján
- elem lekérdezése sorszám alapján
- az adatok rendezett formában vannak tárolva
Az adatok folyamatosan bővülnek és törlődnek, a struktúrának biztosítania kell a gyors működést. Először megpróbáltam megvalósítani ezt a dolgot a std. Ez az út nem vezetett sikerre, és beláttam, hogy valami újra van szükség. Az egyetlen ötlet, ami eszembe jutott, az egy bináris keresőfa használata volt. Mivel ez megfelel a gyors beszúrás, törlés és az adatok rendezett formában való tárolás követelményeinek. Csak ki kellett találni, hogyan indexeljük az összes elemet és számítsuk újra az indexeket, amikor a fa megváltozik.
struct node_s {
    data_t data;

    uint64_t weight; // a csomópont súlya

    node_t *left;
    node_t *right;

    node_t *parent;
};
A cikkben több kép és elmélet lesz, mint kód. A kódot az alábbi linken lehet megtekinteni.
Tömeg
Ehhez a fához egy kis módosítást végeztem, további információt adtam hozzá a súlyról A csomópont súlya ez a csomópont gyermekei számát jelenti + 1 (az egységes elem súlya).
A csomópont súlyának lekérése:
uint64_t bntree::get_child_weight(node_t *node) {
    if (node) {
        return node->weight;
    }

    return 0;
}
A levél súlya tehát 0.
Térjünk át egy ilyen fa szemléltető példájára. Fekete színnel a csomópont kulcsát ábrázoljuk (az értéket nem mutatjuk meg, mivel erre nincs szükség), piros — a csomópont súlya, zöld — a csomópont indexe.
Amikor a fa üres, akkor a súlya 0. Adjunk hozzá egy gyökér elemet:
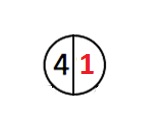
A fa súlya 1-re nő, a gyökér elem súlya 1. A gyökér elem súlya a fa súlyát is jelenti.
Adjunk hozzá még néhány elemet:
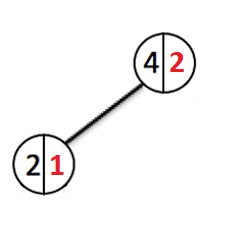
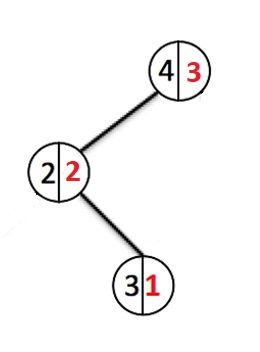
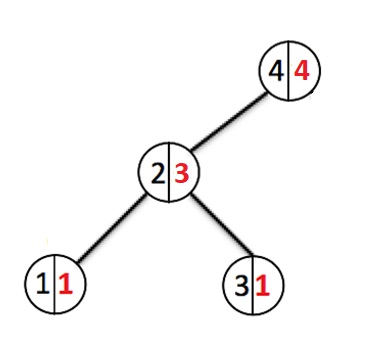
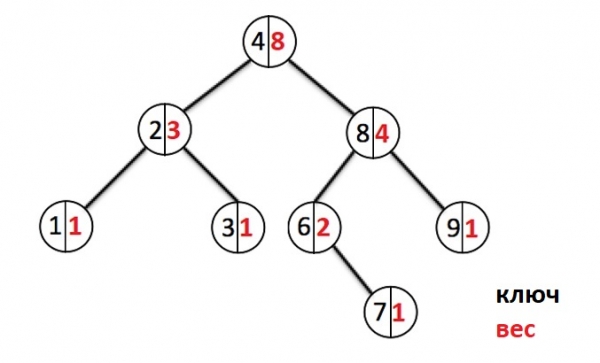
Minden alkalommal, amikor egy új elemet adunk hozzá, a csomópontokon lefelé haladunk és növeljük a súly számlálóját minden áthaladott csomópont esetében. Amikor új csomópontot hozunk létre, a súlyát 1állítjuk be. Ha olyan csomópont létezik már ezzel a kulccsal, akkor felülírjuk az értéket és visszafelé megyünk a gyökér felé, visszavonva a súlyok módosítását minden áthaladott csomópontban.
Ha csomópontot törlünk, akkor lefelé haladunk és csökkentjük az áthaladott csomópontok súlyát.
Indexek
Most már áttérhetünk arra, hogyan indexeljük a csomópontokat. A csomópontok egyértelműen nem tárolják az indexüket, azt a csomópontok súlyának alapján számítják ki. Ha tárolnák az indexüket, akkor az összes csomópont indexének frissítése minden fa módosítása után sok időt venne igénybe. O(n) a fák módosítása után.
Nézzük meg a szemléletes ábrázolást. A fánk üres, adjunk hozzá egy csomópontot:
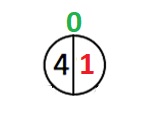
Az első csomópont indexe 0, és most két eset lehetséges. Az első esetben a gyökér elem indexe megváltozik, a második esetben nem változik meg.
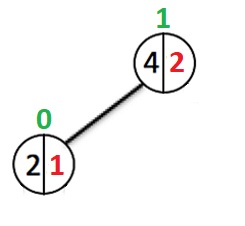
A gyökér bal alsó fája 1 súlyt képvisel.
Második eset:
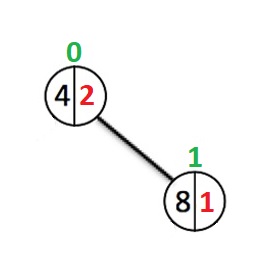
A gyökér indexe nem változott, mivel a bal alsó fa súlya 0 maradt.
A csomópont indexének kiszámítása a bal alsó fa súlyának összege + a szülőtől kapott szám. Mi ez a szám? Ez az indexek számlálója, kezdetben 0, mivel a gyökérnek nincs szülője. Innentől függ, hogy balra vagy jobbra lépünk. Ha balra, akkor a számlálóhoz nem adunk semmit. Ha jobbra lépünk, akkor hozzáadjuk az aktuális csomópont indexét. 0Például, hogyan számíthatjuk ki a 8-as kulcsú elem indexét (a gyökér jobb gyermeke). Ez a "gyökér index" + a "bal alsó fa súlya a 8-as kulcsú csomópontban" + "1" == 3 + 2 + 1 ==
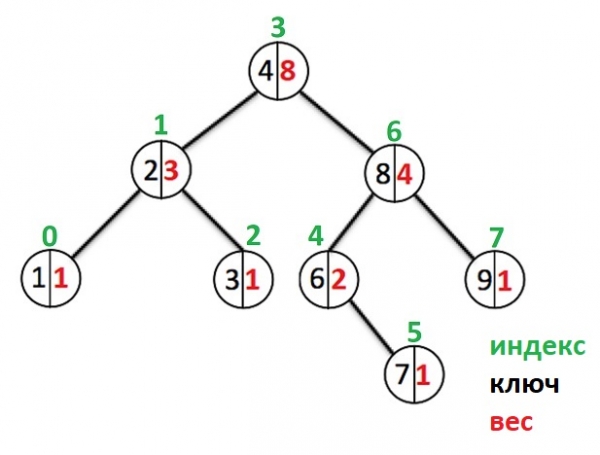
A 6-os kulcsú elem indexe a következőképpen alakul: "gyökér index" + 1 == 3 + 1 == 6
Ennek megfelelően az elem index alapján történő lekéréséhez eltelt idő 4
O(log n) , mivel a megfelelő elem megtalálásához először a gyökértől kell indulnunk e csomóponthoz.Mélység
A súly alapján a fa mélysége is meghatározható. Ez szükséges a kiegyensúlyozáshoz.
Ehhez a jelenlegi csomópont súlyát az első 2-es hatványra kell kerekíteni, amely nagyobb vagy egyenlő a megfelelő súlynál, és a logaritmusát kell venni. Így kapjuk meg a fa mélységét, feltéve, hogy az kiegyensúlyozott. A fa kiegyensúlyozása új elem beszúrása után történik. A fák kiegyensúlyozásának elméletét nem részletezem. A forráskódokban megtalálhatók a kiegyensúlyozó függvények.
A súly mélységgé alakításának kódja.
Új elem beszúrása
/*
 * Возвращает первое число в степени 2, которое больше или ровно x
 */
uint64_t bntree::cpl2(uint64_t x) {
    x = x - 1;
    x = x | (x >> 1);
    x = x | (x >> 2);
    x = x | (x >> 4);
    x = x | (x >> 8);
    x = x | (x >> 16);
    x = x | (x >> 32);

    return x + 1;
}

/*
 * Двоичный логарифм от числа
 */
long bntree::ilog2(long d) {
    int result;
    std::frexp(d, &result);
    return result - 1;
}

/*
 * Вес к глубине
 */
uint64_t bntree::weight_to_depth(node_t *p) {
    if (p == NULL) {
        return 0;
    }

    if (p->weight == 1) {
        return 1;
    } else if (p->weight == 2) {
        return 2;
    }

    return this->ilog2(this->cpl2(p->weight));
}
Összegzés
- sorozatszám alapján történik , mivel a megfelelő elem megtalálásához először a gyökértől kell indulnunk e csomóponthoz.
- elem törlése a sorrendi szám alapján , mivel a megfelelő elem megtalálásához először a gyökértől kell indulnunk e csomóponthoz.
- sorozatszám alapján történik , mivel a megfelelő elem megtalálásához először a gyökértől kell indulnunk e csomóponthoz.
Sebességgel , mivel a megfelelő elem megtalálásához először a gyökértől kell indulnunk e csomóponthoz. fizetünk azért, hogy minden adat rendezett formában legyen tárolva.
Nem tudom, hol lehet egy ilyen struktúrára szükség. Csak egy feladat, hogy még egyszer átgondoljam, hogyan működnek a fák. Köszönöm a figyelmet.
Hivatkozások
A projekt tesztadatokat tartalmaz a teljesítmény ellenőrzéséhez. A fa feltöltése 1000000 elemekkel történik. Ezután folyamatban van az elemek eltávolítása, beszúrása és megnyerése. 1000000 alkalommal. Azaz 3000000 műveletek. Az eredmény meglehetősen jónak bizonyult ~ 8 másodperc.
Forrás: habr.com
