

Helló, Habr!
Szeretsz repülni? Imádom, de az önizoláció alatt még jobban megszerettem elemezni az egy neves forrás, az Aviasales légijegyeivel kapcsolatos adatokat.
Ma megvizsgáljuk az Amazon Kinesis működését, felépítünk egy streaming rendszert valós idejű elemzéssel, beállítunk egy NoSQL adatbázist, az Amazon DynamoDB-t mint fő adattárolót, és SMS értesítést állítunk be az érdekes jegyekről.
Minden részlet a hajtás alatt! Kezdjünk hozzá!
Bevezetés
Például szükségünk lesz hozzáférésre . A hozzáférés ingyenes és korlátozások nélküli, csak regisztrálnunk kell a 'Fejlesztőknek' részben, hogy megkapjuk a saját API tokent az adatokhoz való hozzáféréshez.
A cikk fő célja, hogy általános betekintést nyújtson az információs streaming használatába az AWS-en belül, figyelmen kívül hagyva azt, hogy az igénybe vett API által visszaadott adatok nem feltétlenül aktuálisak, és a felhasználók keresései alapján generált cache-ből származnak, amely az Aviasales.ru és a Jetradar.com webhelyeken történt keresések alapján a legutolsó 48 órán belül keletkezett.
Az API-n keresztül kapott légijegyek adatait a Kinesis-ügynök, amely az előállító gépen van telepítve, automatikusan fogja elemezni és átadni a szükséges folyamba a Kinesis Data Analytics-on keresztül. A nyers adatfolyam közvetlenül a tárolóba fog kerülni. A DynamoDB-ben létrehozott „nyers” adatok tárolója lehetővé teszi a mélyebb repülőjegy-elemzést BI eszközökkel, például az AWS Quick Sight-tal.
Kétféle módon telepítjük az egész infrastruktúrát:
- Kézi — az AWS Management Console-on keresztül;
- Infrastruktúra kódja Terraform — a lusta automatizálók számára;
A kidolgozott rendszer architektúrája
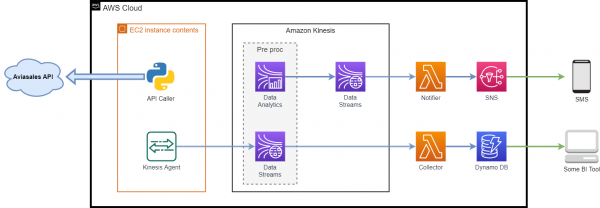
A használt összetevők:
- — azok az adatok, amelyeket ez az API visszaad, felhasználásra kerülnek a további munkákhoz;
- — egy normál virtuális gép a felhőben, amelyen az adatok bejövő folyamát generálják:
- — ez egy Java-alkalmazás, amelyet helyben telepítenek, és egyszerű módszert biztosít az adatok gyűjtésére és Kinesisbe (Kinesis Data Streams vagy Kinesis Firehose) történő továbbítására. Az ügynök folyamatosan nyomon követi a megadott könyvtárak fáját, és új adatokat küld a Kinesisbe;
- — Python-szkript, amely lekérdezéseket végez az API-n és a választ egy olyan mappába menti, amelyet a Kinesis Agent figyel;
- — valós idejű adatstreaming szolgáltatás széleskörű skálázási lehetőségekkel;
- — egy szerver nélküli szolgáltatás, amely egyszerűsíti a valós idejű adatfolyamok elemzését. Az Amazon Kinesis Data Analytics beállítja az alkalmazások működéséhez szükséges erőforrásokat, és automatikusan skálázódik, hogy kezelni tudja a bejövő adatok bármilyen mennyiségét;
- — egy szolgáltatás, amely lehetővé teszi a kód futtatását szerverek fenntartása és beállítása nélkül. Minden számítási kapacitás automatikusan skálázódik minden egyes hívás esetén;
- — egy kulcs-érték és dokumentum adatbázis, amely 10 milliszekundumnál kevesebb késleltetést biztosít bármilyen méretű működés során. A DynamoDB használatakor nem szükséges szervereket elosztani, javítást végezni rajtuk vagy kezelni őket. A DynamoDB automatikusan skálázza a táblákat, beállítva a rendelkezésre álló erőforrások mennyiségét, így megőrzi a magas teljesítményt. Nincsenek szükséges rendszeradminisztrációs lépések;
- — egy teljesen felügyelt üzenetküldő szolgáltatás, amely a „kiadó — előfizető” (Pub/Sub) modellt követi, lehetővé téve mikroszolgáltatások, elosztott rendszerek és szerver nélküli alkalmazások elszigetelését. Az SNS használható végfelhasználók számára üzenetek küldésére mobil push értesítések, SMS-ek és e-mailek formájában.
Kezdő előkészítés
Adatfolyam emulálásához az Aviasales API-ból nyert repülőjegyinformációkat szeretném felhasználni. A meglehetősen széles lista különböző metódusokról közül az egyiket – az „Ár- naptár a hónapra” – vesszük, amely az adott hónap minden napjára vonatkozó árakat ad vissza, a megállók számának csoportosításával. Ha a keresési hónapot nem adjuk meg a kérelemben, akkor a következő hónapra vonatkozó információt kapunk vissza.
Tehát regisztrálunk, megkapjuk a tokenünket.
Az alábbi példa kérelem:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIA fent leírt módszer API-adatok megszerzésére a kérésben szereplő token megadásával működni fog, de én jobban szeretem a hozzáférési tokent a fejlécekben megadni, ezért az api_caller.py nevű szkriptben ezt a módszert fogjuk használni.
Példa válasz:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
A fenti API válaszpéldában egy jegy látható Szentpétervárról Phuketre… Óh, minek álmodozni…
Mivel Kazanyból származom, és Phuket most „csak álom számunkra”, keressünk jegyeket Szentpétervár és Kazany között.
Feltételezhető, hogy már van AWS-fiókja. Azonnal szeretném felhívni a figyelmet, hogy a Kinesis és az SMS-értesítések küldése nem tartozik az éves . De még így is, ha fejben tartunk néhány dollárt, könnyen felépíthetjük a javasolt rendszert, és játszhatunk vele. Természetesen nem szabad elfelejtenünk törölni az összes erőforrást, miután már nincs rá szükség.
Szerencsére a DynamoDB és a lambda-funkciók számunkra feltételesen ingyenesek lesznek, ha beleférünk a havi ingyenes korlátokba. Például a DynamoDB esetében: 25 GB tároló, 25 WCU/RCU és 100 millió lekérdezés. Valamint egy millió lambda funkció meghívása havonta.
A rendszer manuális telepítése
A Kinesis Data Streams beállítása
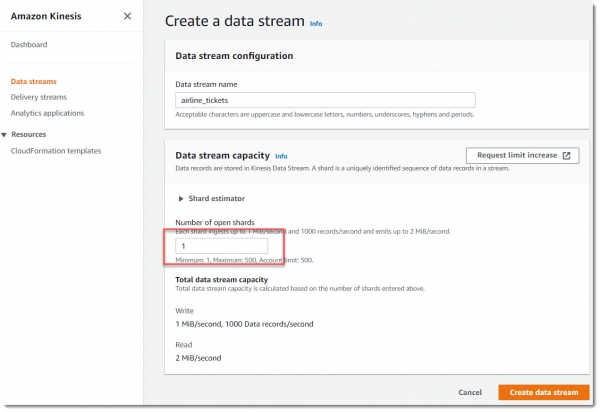
Lépjünk be a Kinesis Data Streams szolgáltatásba, és hozzunk létre két új adatfolyamot, egy-egy partícióval mindegyikhez.
Mi az a partíció?
A partíció az Amazon Kinesis adatfolyamának alapvető adategysége. Egy szegmens 1 MB/s sebességgel biztosítja a bemeneti adatok továbbítását és 2 MB/s sebességgel a kimeneti adatok továbbítását. Egy szegmens legfeljebb 1000 PUT rekordot kezel másodpercenként. Az adatfolyam létrehozásakor meg kell adni a szükséges szegmensek számát. Például létrehozhatunk egy adatfolyamot két szegmenssel. Ez az adatfolyam 2 MB/s sebességgel biztosítja a bemeneti adatok továbbítását és 4 MB/s sebességgel a kimeneti adatok továbbítását, legfeljebb 2000 PUT rekord támogatásával másodpercenként.
Minél több partíció van az adatfolyamban, annál nagyobb a kapacitása. Alapvetően így skálázhatók az adatfolyamok — partíciók hozzáadásával. De minél több partíció áll rendelkezésére, annál drágább. Minden partíció óránként 1,5 centbe kerül, és további 1,4 cent minden egyes millió bemeneti műveletért (PUT payload unit).
Hozzunk létre egy új adatfolyamot a következő néven airline_tickets, amit elegendő lesz 1 partícióval ellátni:
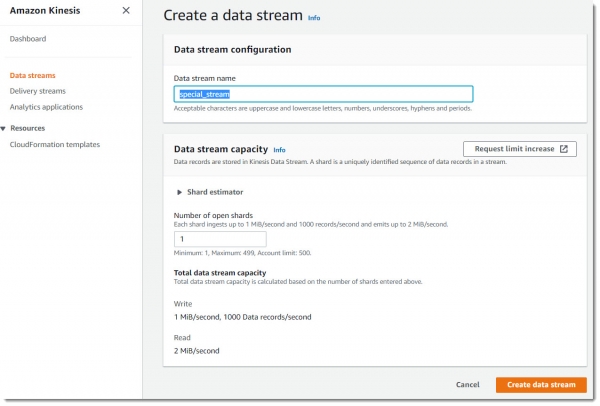
Most hozzunk létre egy másik adatfolyamat a következő néven special_stream:
A producer beállítása
Adatforrásként a feladat elemzéséhez elegendő egy szokványos EC2 példány használata. Nem szükséges, hogy ez egy erőteljes, drága virtuális gép legyen, teljesen megfelelő egy spot t2.micro.
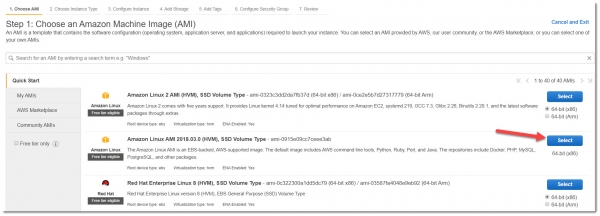
Fontos megjegyzés: példaként az Amazon Linux AMI 2018.03.0 képet célszerű használni, mivel ezzel kevesebb beállítás szükséges a Kinesis Agent gyors indításához.
Lépjünk az EC2 szolgáltatásra, hozzunk létre egy új virtuális gépet, válasszuk ki a szükséges AMI-t, amely t2.micro típusú és a Free Tier-be tartozik:
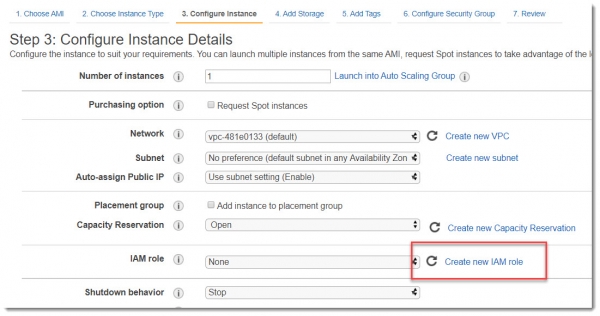
Ahhoz, hogy az újonnan létrehozott virtuális gép kapcsolatba tudjon lépni a Kinesis szolgáltatással, engedélyeket kell adni neki. A legjobb módja ennek a hozzárendelés IAM szerep. Tehát a 3. lépés: Példány részletek konfigurálása képernyőn válaszd ki Új IAM szerep létrehozása:
IAM szerep létrehozása az EC2 számára
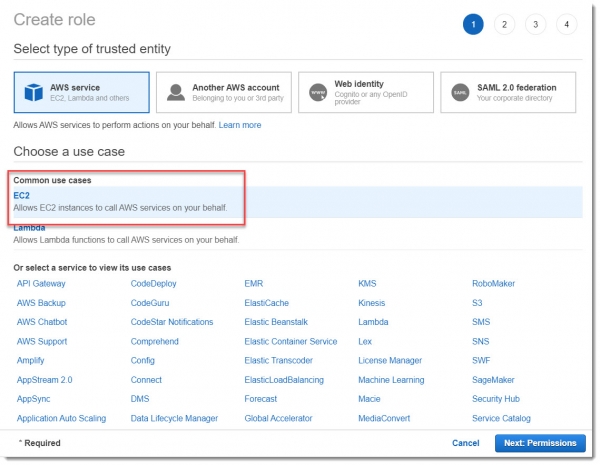
A megnyíló ablakban válasszuk ki, hogy az új szerepet az EC2 számára hozzuk létre, és lépjünk a Jogosultságok fülre:
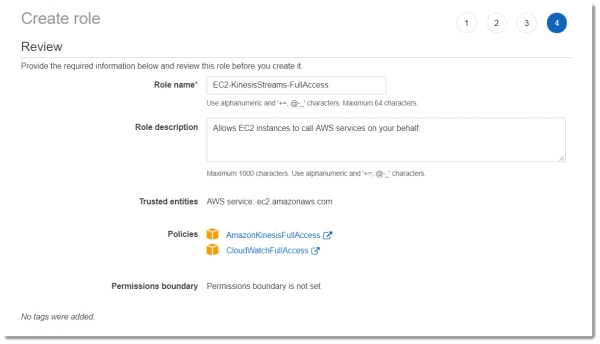
A tanulmányi példában nem kell belemenni az erőforrások granularitású jogosultságainak részleteibe, így válasszuk ki az Amazon által előre beállított irányelveket: AmazonKinesisFullAccess és CloudWatchFullAccess.
Adjunk ennek a szerepnek egy értelmes nevet, például: EC2-KinesisStreams-FullAccess. Ennek eredményeként ugyanazt kell látnunk, mint az alábbi képen:
A új szerep létrehozása után ne felejtsük el hozzárendelni azt a létrehozott virtuális gép példányhoz:
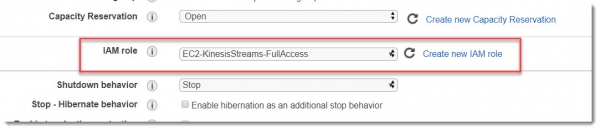
Több változtatást nem végzünk ezen a képernyőn, és folytatjuk a következő ablakokkal.
A merevlemez paramétereit hagyhatjuk az alapértelmezett beállításokon, a címkéket is (bár jó gyakorlat a címkék használata, legalábbis adjunk nevet a példánynak és jelezzük a környezetet).
Most a 6. lépés: Biztonsági csoport konfigurálása fülön vagy új, vagy meglévő Sеcurity csoportot kell létrehoznunk, amely lehetővé teszi a ssh kapcsolatot (22-es port) a példányra. Válaszd ki ott a Forrás -> A saját IP címemet, és elindíthatod a példányt.
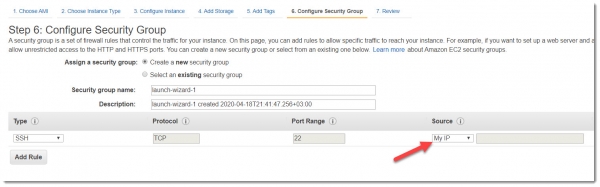
Amint az állapota running lesz, próbálj meg csatlakozni hozzá ssh-n keresztül.
A Kinesis Agent használatához, a gépre való sikeres bejelentkezés után be kell írni a következő parancsokat a terminálba:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Hozzunk létre egy mappát az API válaszainak tárolására:
sudo mkdir /var/log/airline_ticketsAz ügynök elindítása előtt be kell állítani a konfigurációját:
sudo vim /etc/aws-kinesis/agent.jsonAz agent.json fájl tartalmának a következőképpen kell kinéznie:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
A konfigurációs fájl alapján az ügynök a /var/log/airline_tickets/ könyvtárban figyelni fogja a .log kiterjesztésű fájlokat, összegyűjtve azokat és továbbítva az airline_tickets adatfolyamba.
Újraindítjuk a szolgáltatást, és meggyőződünk arról, hogy elindult és működik:
sudo service aws-kinesis-agent restartMost letöltjük a Python-skriptet, amely adatokat kér le az API-tól:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
Az api_caller.py script adatokat kér le az Aviasales-től, és a kapott választ elmenti abba a könyvtárba, amelyet a Kinesis ügynök figyel. A script megvalósítása meglehetősen standard, van egy TicketsApi osztály, amely lehetővé teszi az API aszinkron hívását. Ennek az osztálynak át kell adni a tokent tartalmazó fejlécet és a kérés paramétereit:
class TicketsApi:
    """API hívó osztály."""

    def __init__(self, headers):
        """Init metódus."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Adatok lekérése az API hívásból."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Válasz státusz %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Hoppá! HTTP hiba történt: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Hoppá! Hiba történt: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Visszaadja a fejlécet és a lekérdezést az API kéréshez."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Futtassa a kódot."""
    if len(sys.argv) != 2:
        print('Használat: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('Az API %s tételt adott vissza', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s sor került mentésre a(z) %s fájlba',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Hoppá! A kérés eredménye nem került mentésre a fájlba. %s',
                         str(e))
    else:
        LOGGER.error('Hoppá! Az API kérés nem volt sikeres %s!', response)
A beállítások helyességének és az ügynök működőképességének tesztelésére végezzünk egy tesztfuttatást az api_caller.py script segítségével:
sudo ./api_caller.py TOKEN 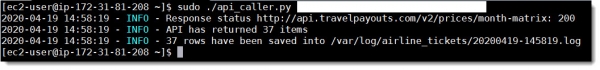
És nézzük meg az ügynök logjaiban, valamint az airline_tickets adatfolyam Monitoring fülén a működés eredményét:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 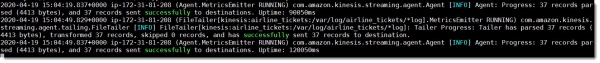
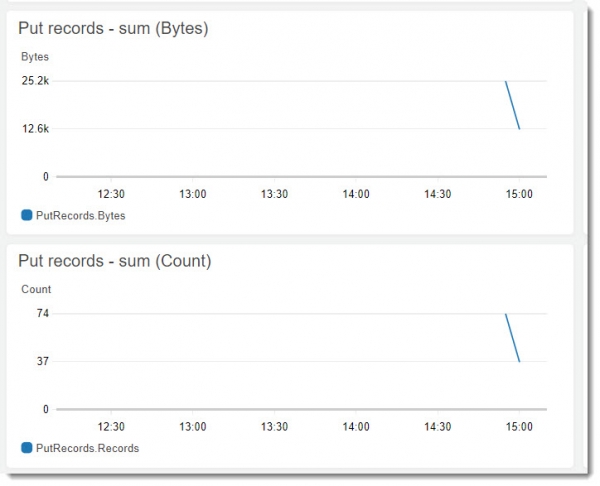
Ahogy látható, minden működik, és a Kinesis Agent sikeresen küldi az adatokat az áramlatba. Most állítsuk be a fogyasztót.
Kinesis Data Analytics beállítása
Lépjünk a rendszer központi eleméhez — hozzunk létre egy új alkalmazást a Kinesis Data Analytics szolgáltatásban kinesis_analytics_airlines_app néven:
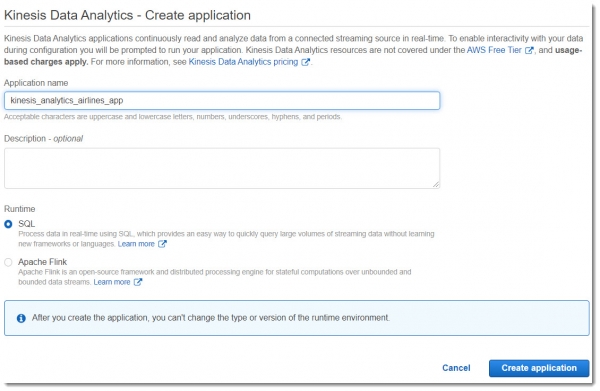
A Kinesis Data Analytics lehetővé teszi, hogy valós idejű adatanalitikát végezzünk a Kinesis Streams-ből SQL nyelven. Ez egy teljesen automatikusan skálázódó szolgáltatás (ellentétben a Kinesis Streams-szel), amely:
- lehetővé teszi új áramlatok (Output Stream) létrehozását a forrásadatokkal kapcsolatos lekérdezések alapján;
- hibákat szolgáltató áramlattal rendelkezik, amelyek a programok futása során jelentkeztek (Error Stream);
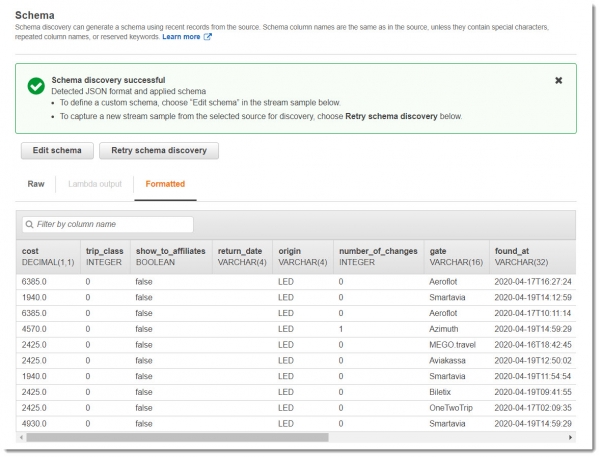
- képes automatikusan meghatározni a belépő adatok sémáját (ez szükség esetén manuálisan felülbírálható).
Ez nem egy olcsó szolgáltatás — 0,11 USD óránként, ezért érdemes óvatosan használni, és a munka befejezésekor törölni.
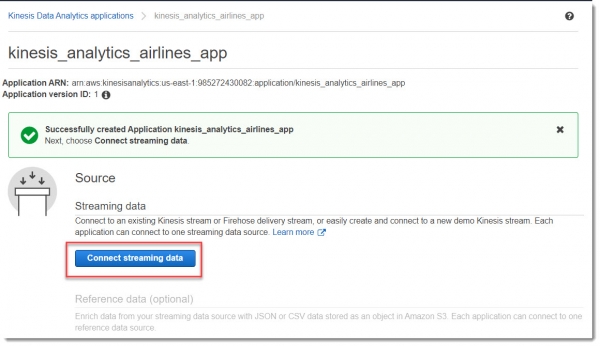
Csatlakoztassuk az alkalmazást az adatforráshoz:
Válasszuk ki az áramlatot, amelyhez csatlakozni szeretnénk (airline_tickets):
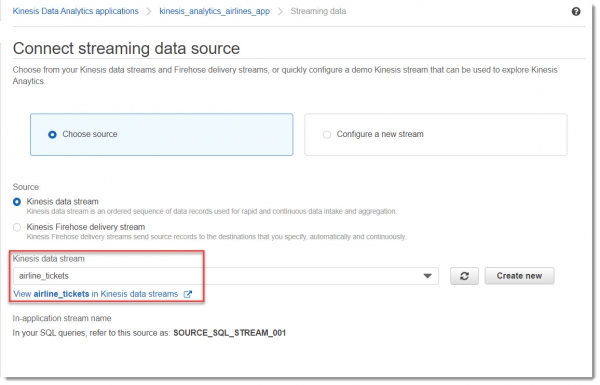
Ezután szükséges új IAM szerepkört csatolni, hogy az alkalmazás olvasni tudjon az áramlatból és írni az áramlatba. Ehhez elég, ha nem változtatunk semmit az Access permissions blokkban:
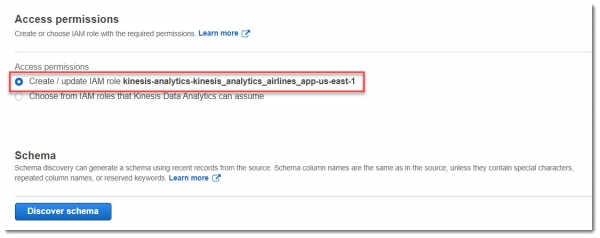
Most kérjük az áramlat adatainak sémájának felfedezését, ehhez kattintsunk a „Discover schema” gombra. Ennek eredményeképpen frissül (új szerepkör jön létre) az IAM szerepkör, és elindul a sémafelfedezés a már az áramlatba érkezett adatokból:
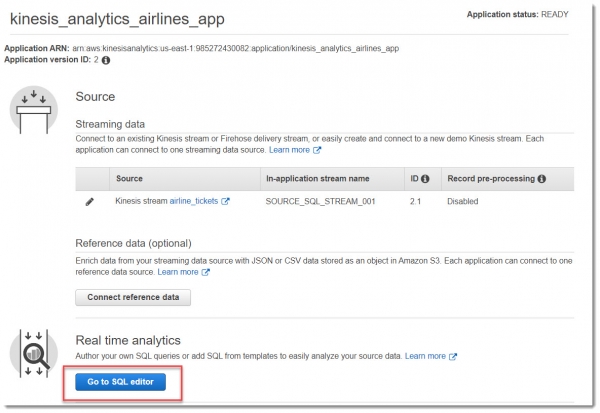
Most lépjünk át az SQL szerkesztőbe. Amikor rákattintunk erre a gombra, felugrik egy ablak, amely megkérdezi az alkalmazás indítását — válasszuk ki, mit akarunk indítani:
Az SQL szerkesztő ablakába illesszük be ezt az egyszerű lekérdezést, majd kattintsunk a Save and Run SQL gombra:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
Relációs adatbázisokban táblákkal dolgozik, INSERT operátorokat használva a rekordok hozzáadásához és SELECT operátorokat az adatok lekérdezéséhez. Az Amazon Kinesis Data Analytics-ben áramlatokkal (STREAM) és „pumpákkal” (PUMP) dolgozik — folyamatos felhasználási lekérdezések, amelyek adatokat helyeznek át az egyik áramlatból a másikba.
A fenti SQL lekérdezés az Aeroflot jegyeit keresi, amelyek ára ötezer rubel alatt van. Minden olyan rekord, ami megfelel ezeknek a feltételeknek, a DESTINATION_SQL_STREAM áramlatba kerül.
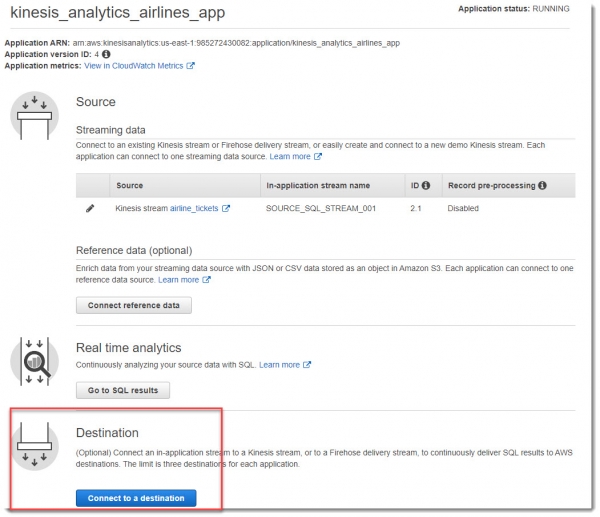
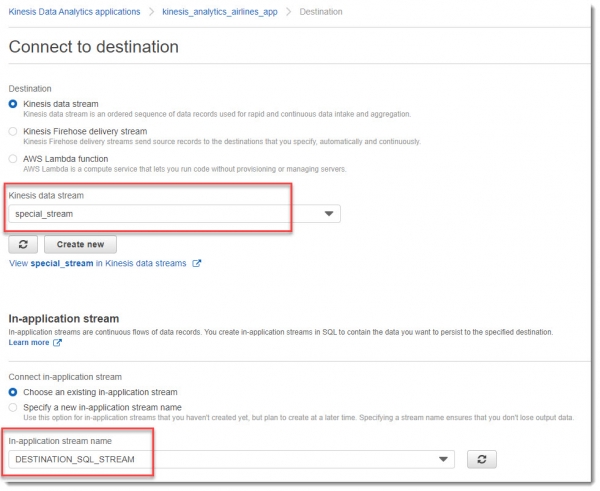
A Destination blokkban válasszuk a special_stream folyamatot, az In-application stream name legördülő lista alatt pedig a DESTINATION_SQL_STREAM-et:
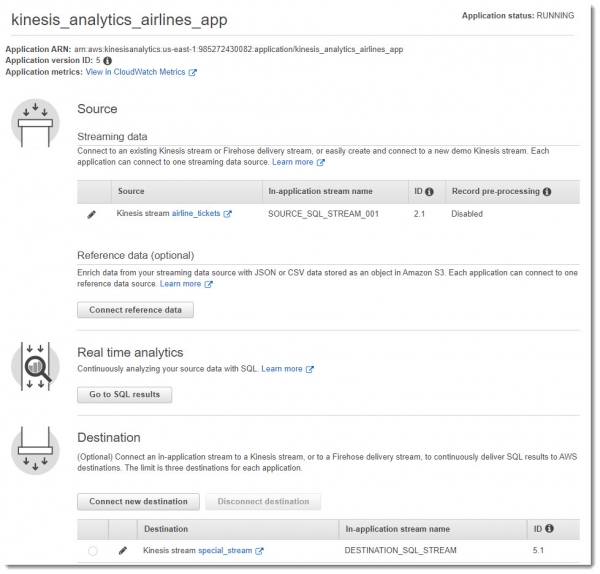
A sok tevékenység eredményeként valami ilyesminek kell kinéznie az alábbi képen:
SNS téma létrehozása és feliratkozás
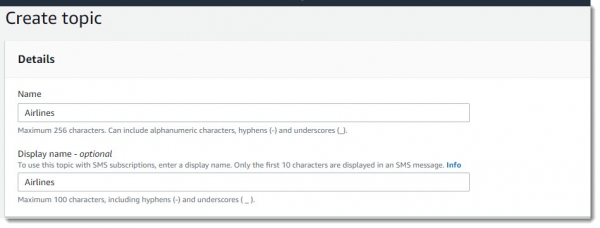
Lépjünk a Simple Notification Service szolgáltatásba, és hozzunk létre ott egy új témát az Airlines néven:
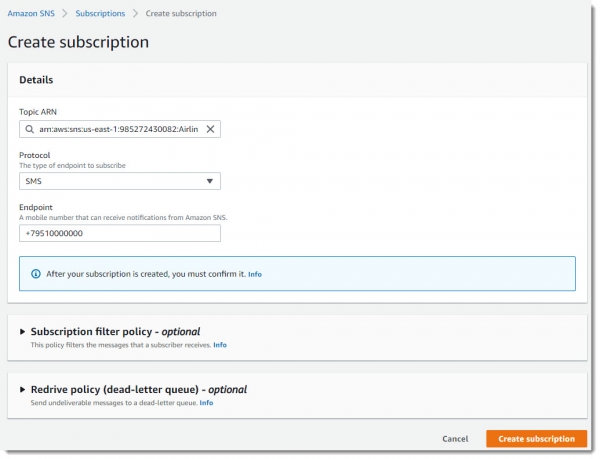
Feliratkozunk erre a témára, megadva azt a mobilszámot, amelyre az SMS értesítések fogják érkezni:
Tábla létrehozása a DynamoDB-ben
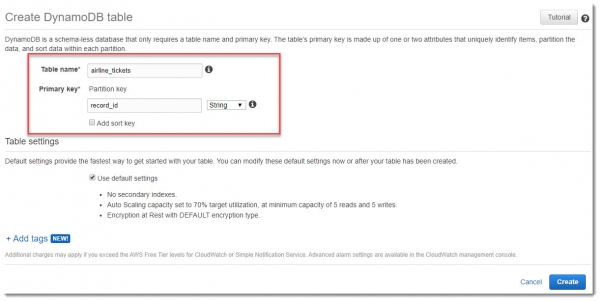
Az airline_tickets adatfolyamának nyers adatainak tárolására hozzunk létre egy táblát a DynamoDB-ben ugyanazzal a névvel. Az elsődleges kulcsnak a record_id-ot fogjuk használni:
Collector lambdafunkció létrehozása
Hozzuk létre a Collector nevű lambdafunkciót, amelynek feladata az airline_tickets adatfolyam lekérdezése, és új bejegyzések esetén azok beszúrása a DynamoDB táblába. Nyilvánvaló, hogy az alapértelmezett jogosultságokon kívül ennek a lambdának hozzáféréssel kell rendelkeznie a Kinesis adatfolyam olvasásához és a DynamoDB-ba íráshoz.
IAM szerepkör létrehozása a collector lambdafunkcióhoz
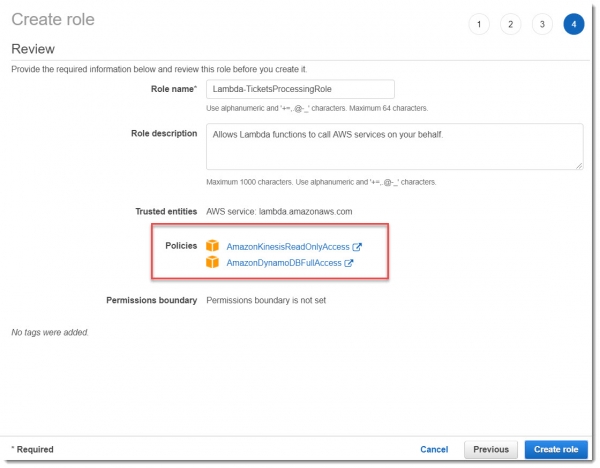
Először létrehozunk egy új IAM szerepkört a lambdához, a Lambda-TicketsProcessingRole néven:
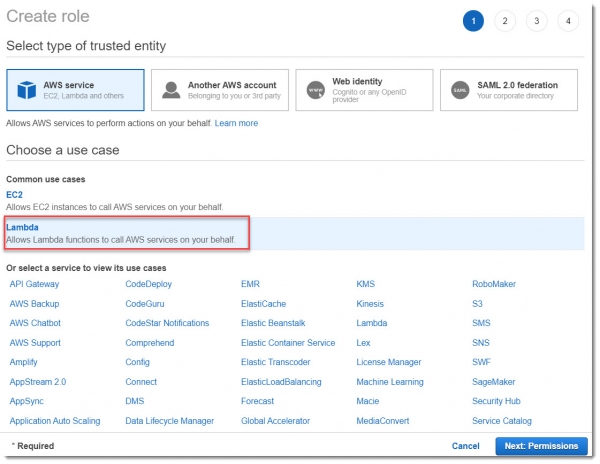
A tesztpéldához bőven elegendő az AmazonKinesisReadOnlyAccess és az AmazonDynamoDBFullAccess előre beállított jogosultság, ahogy az az alábbi képen látható:
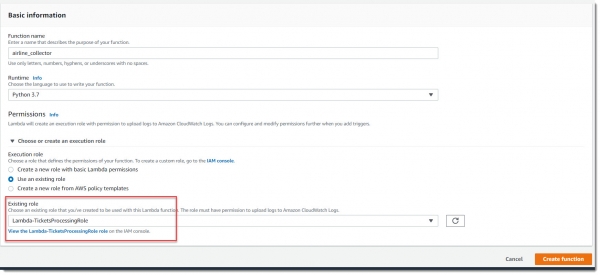
Ez a lambdafunkció a Kinesis által triggerelve kell, hogy fusson, amikor új bejegyzések érkeznek az airline_stream adatfolyamba, ezért hozzá kell adni egy új triggert:
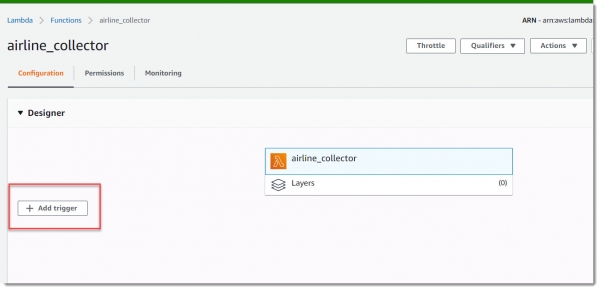
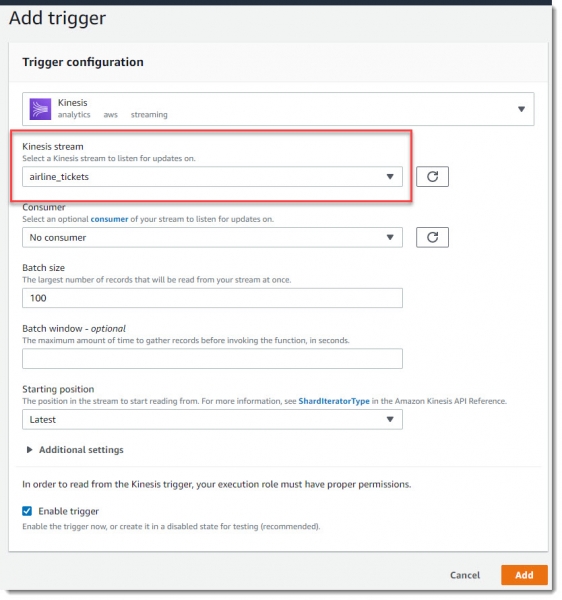
Csak bele kell illeszteni a kódot, és elmenteni a lambdát.
"""A stream feldolgozása és beillesztés a DynamoDB táblába."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Információk feldolgozása a streamből."""

    def __init__(self, table_name, records):
        """Inicializáló metódus."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Visszaadja a deszerializált adatokat a streamből."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Előfeldolgozza a json adatokat."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Tömeges beillesztés a táblába."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Hozzáadva ', len(self.json_data), 'elem')

def lambda_handler(event, context):
    """A stream feldolgozása és beillesztés a DynamoDB táblába."""
    print('Esemény érkezett:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Notifier lágfréda létrehozása
A második lágfréda, amely a special_stream második adatfolyamát figyeli és értesítést küld az SNS-nek, hasonlóan készül. Ezért ennek a lágfrédának hozzáféréssel kell rendelkeznie az olvasáshoz a Kinesis-ből és üzenetek küldésére a megadott SNS-topikba, amelyet az SNS szolgáltatás tovább eljuttat az összes előfizetőhöz (email, SMS stb.).
IAM szerep létrehozása
Először létrehozzuk az IAM szerepkört, Lambda-KinesisAlarm, ennek a lágfrédának, majd ezt a szerepkört hozzárendeljük a létrehozott lágfrédához, az alarm_notifier-hez:
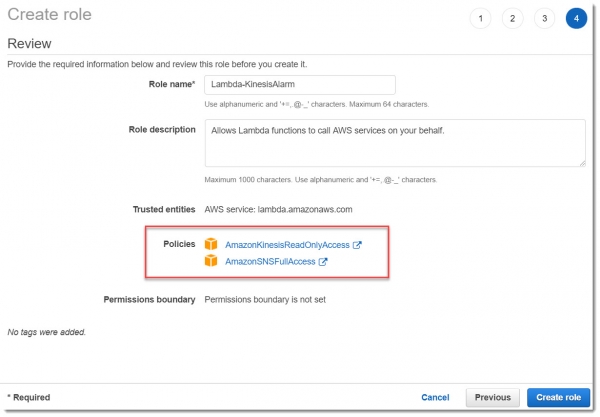
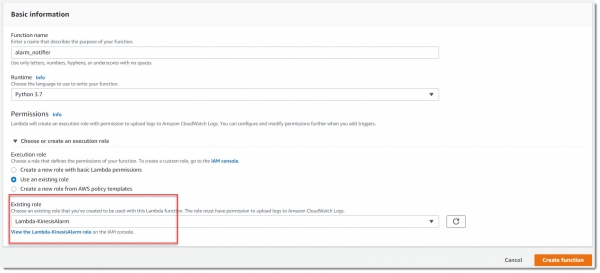
Ennek a lágfrédának a triggerét a special_stream-be új rekordok érkezésekor kell beállítani, ezért a triggereket hasonlóan kell beállítani, mint ahogyan azt a Collector lágfrédánál tettük.
A lágfréda beállításának megkönnyítése érdekében bevezetünk egy új környezeti változót — TOPIC_ARN, ahová az Airlines ANR-t (Amazon Resource Names) helyezzük:
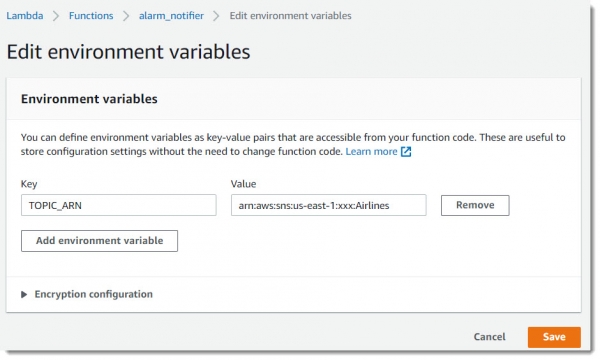
És beillesztjük a lágfréda kódját, ami nem túl bonyolult:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Szia! Találtam egy érdekes dolgot!',
                           Subject='Repülőjegyek riasztás')
        print('A riasztás üzenetet sikeresen küldte el')
    except Exception as err:
        print('Küldési hiba', str(err))
Úgy tűnik, hogy ezen a ponton a rendszer kézi beállítása befejeződött. Csak annyit kell tennünk, hogy teszteljük, és megbizonyosodjunk róla, hogy mindent helyesen állítottunk be.
Telepítés Terraform kódból
Szükséges előkészületek
— nagyon kényelmes open-source eszköz az infrastruktúra kódból való telepítéséhez. Megvan a saját szintaxisa, amely könnyen elsajátítható, és rengeteg példa, hogyan és mit telepítsünk. Az Atom vagy a Visual Studio Code szerkesztőben sok hasznos bővítmény található, amelyek megkönnyítik a Terraform használatát.
A disztribúció letölthető . A Terraform összes lehetőségének részletes áttekintése meghaladja ennek a cikknek a kereteit, ezért csak a legfontosabb pontokat említjük meg.
Hogyan indítsuk el
A projekt teljes kódja itt található . Klónozzuk a tárolót. A futtatás előtt győződjön meg arról, hogy az AWS CLI telepítve és beállítva van, mivel a Terraform a hitelesítő adatokat a ~/.aws/credentials fájlban keresi.
Jó gyakorlat az, hogy az egész infrastruktúra telepítése előtt futtassuk a plan parancsot, hogy lássuk, mit fog létrehozni most a Terraform a felhőben:
terraform.exe planFelajánlja, hogy megadja a telefonszámot, amelyre értesítéseket szeretne küldeni. Ezen a ponton annak megadása nem kötelező.
A program munkatervének elemzése után elindíthatjuk az erőforrások létrehozását:
terraform.exe applyMiután ezt a parancsot elküldtük, ismét megjelenik egy kérdés a telefonszám megadására, írja be a 'yes'-t, amikor a kérdést felteszik a tényleges végrehajtásról. Ez lehetővé teszi az egész infrastruktúra felemelését, az összes szükséges EC2 beállítás végrehajtását, a lambda-funkciók telepítését stb.
Miután minden erőforrás sikeresen létrejött a Terraform kódján keresztül, be kell lépni az Kinesis Analytics alkalmazás részleteibe (sajnos nem találtam módot arra, hogy ezt közvetlenül a kódból tegyem).
Futtassuk az alkalmazást:
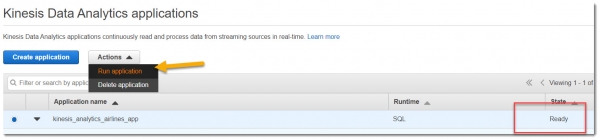
Ezután egyértelműen meg kell adni az in-application stream nevet, választva a legördülő listából:
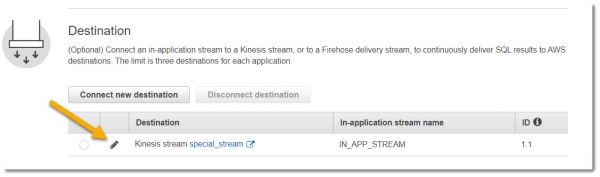
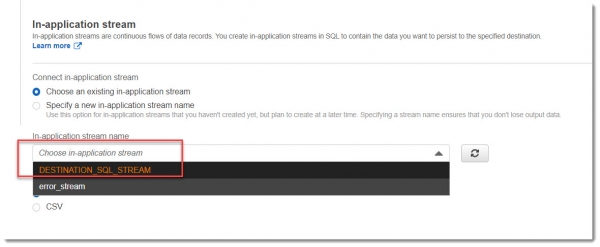
Most minden készen áll a működésre.
Az alkalmazás tesztelése
Függetlenül attól, hogyan telepítette a rendszert, manuálisan vagy Terraform kódon keresztül, ugyanúgy fog működni.
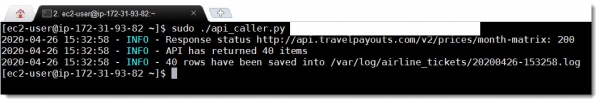
Kapcsolódjunk SSH-n keresztül az EC2 virtuális géphez, ahol a Kinesis Agent telepítve van, és futtassuk az api_caller.py scriptet
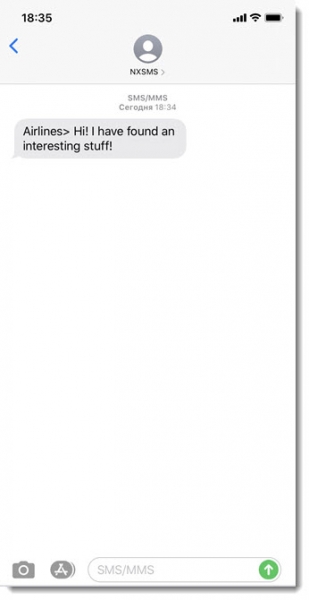
sudo ./api_caller.py TOKENMost várjuk az SMS-t a telefonszámára:
Az SMS – az üzenet szinte egy perc múlva érkezik a telefonra:
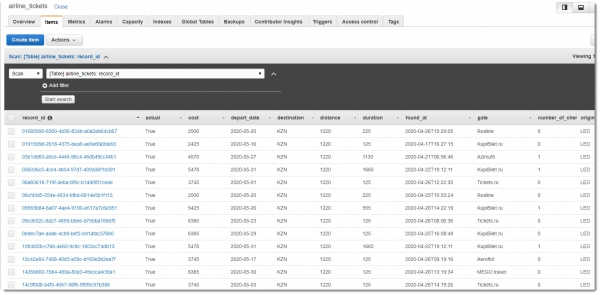
Most ellenőrizzük, hogy a DynamoDB adatbázisban megmaradtak-e a rekordok a további, részletesebb elemzéshez. Az airline_tickets táblázat körülbelül ilyen adatokat tartalmaz:
Zárás
A végzett munka során egy online adatfeldolgozó rendszert építettünk az Amazon Kinesis alapjaira. Megvizsgáltuk a Kinesis Agent használati lehetőségeit a Kinesis Data Streams-szel és valós idejű elemzéssel a Kinesis Analytics segítségével SQL parancsokkal, valamint az Amazon Kinesis más AWS szolgáltatásokkal való kölcsönhatását.
A fent leírt rendszert két módszerrel hoztuk létre: egy viszonylag lassú kézi módszerrel és egy gyors Terraform kódon keresztüli megoldással.
A projekt teljes forráskódja elérhető , javaslom, hogy ismerkedj meg vele.
Örömmel várom a cikk megbeszélését, várom a megjegyzéseit. Remélem, lesz konstruktív kritika.
Sok sikert kívánok!
Forrás: habr.com
