

Az adatalapú algoritmusok, mint például a neurális hálózatok, meghódították a világot. Fejlődésüket több ok is indokolja, többek között a megfizethető és erős hardverek, valamint az óriási adathalmazok. A neurális hálózatok jelenleg az élvonalban állnak a 'kognitív' feladatokban, például a képfelismerés, a természetes nyelv megértése és hasonlók területén. De nem szabad, hogy ezekre a feladatokra korlátozódjanak. Ebben a cikkben a képek neurális hálózattal történő tömörítésének módjáról olvashatunk, amely a maradék tanulás segítségével valósul meg. A cikkben bemutatott megközelítés gyorsabban és jobban működik, mint a standard kodekek. Diagramok, egyenletek, és természetesen egy tesztlista várakozik a cikk végén.
Ez a cikk egy munkán alapul. Feltételezzük, hogy ismeri a neurális hálózatokat és azok fogalmait. konvolúció és veszteségfüggvény.
Mi a képek tömörítése és milyen típusai léteznek?
A képek tömörítése azt a folyamatot jelenti, amelynek során a képet úgy alakítják át, hogy kevesebb helyet foglaljon el. A képek egyszerű tárolása sok helyet foglalna, ezért léteznek kodekek, mint például a JPEG és a PNG, amelyek arra törekednek, hogy csökkentsék az eredeti kép méretét.
Ismert, hogy a képek tömörítésének két típusa van: veszteségmentes és veszteséges. Ahogy a nevéből is adódik, a veszteségmentes tömörítés során az eredeti kép adatai visszanyerhetők, míg a veszteséges tömörítés során a tömörítés során bizonyos adatok elvesznek. Például a JPG veszteséges algoritmusokat használ [megj. ford. - legjobb, ha nem feledkezünk meg a veszteségmentes JPEG-ről sem], míg a PNG veszteségmentes algoritmus.
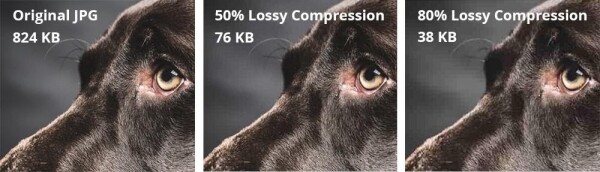
A veszteségmentes és veszteséges tömörítés összehasonlítása
Kérjük, vegye figyelembe, hogy a jobboldali képen sok blokkartifaktum található. Ez elveszett információt jelent. A hasonló színű szomszédos pixelek összepréselődnek egy területként a helymegtakarítás érdekében, de ezzel együtt elveszik a tényleges pixelekre vonatkozó információ. Természetesen a JPEG, PNG stb. kodekekben alkalmazott algoritmusok sokkal bonyolultabbak, de ez egy jó intuitív példa a veszteséges tömörítésre. A veszteségmentes tömörítés jó, de a veszteségmentes tömörített fájlok sok helyet foglalnak a lemezen. Léteznek hatékonyabb módszerek a képek tömörítésére anélkül, hogy túl sok információt veszítsenek, de ezek meglehetősen lassúak, és sokan iteratív megközelítéseket alkalmaznak. Ez azt jelenti, hogy több központi vagy grafikus processzor magon párhuzamosan nem futtathatók. Ez a korlátozás teljesen gyakorlatlanná teszi őket a mindennapi használatban.
A konvolúciós neurális hálózat bemenete
Ha valamit ki kell számítani, és a számítások közelítőek lehetnek, adjon hozzá . A szerzők egy meglehetősen standard konvolúciós neurális hálózatot használtak a képek tömörítésének javítására. Az általuk bemutatott módszer nemcsak a legjobb megoldásokkal versenyez (ha nem jobb), hanem párhuzamos számítások végzésére is képes, ami drasztikus sebességnövekedést eredményez. Ennek oka, hogy a konvolúciós neurális hálózatok (CNN) nagyon jók a képekből származó térbeli információk kiemelésében, amelyek ezután kompaktabb formában jelennek meg (például csak a képek „fontos” biteit mentik el). A szerzők ki akarták használni a CNN ezen képességét a képek jobb reprezentálásához.
Architektúra
A szerzők egy kettős hálózatot javasoltak. Az első hálózat fogadja a képet bemenetként, és létrehoz egy tömörített reprezentációt (ComCNN). Ennek a hálózatnak a kimenete ezután egy standard kodeken (például JPEG) keresztül feldolgozásra kerül. A kodek általi feldolgozás után a kép továbbítódik a második hálózatba, amely „javítja” a kodekből származó képet, megpróbálva visszaállítani az eredeti képet. A szerzők ezt a hálózatot rekonstrukciós CNN-nek (RecCNN) nevezték el. A GAN-hoz hasonlóan mindkét hálózat iteratívan tanul.
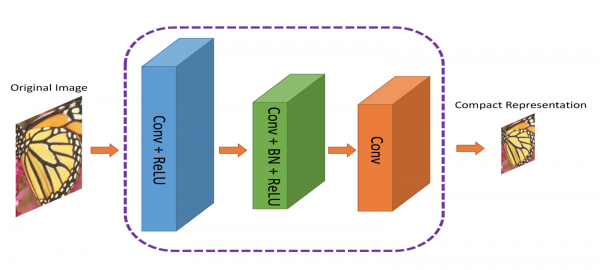
A ComCNN tömörített reprezentációja átkerül a standard kodekhez
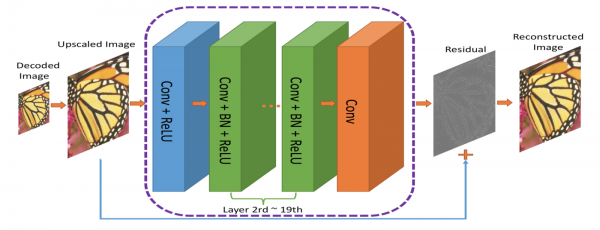
RecCNN. A ComCNN kimenetei felnagyításra kerülnek, és átkerülnek a RecCNN-be, amely megpróbálja megtanulni a maradékot
A dekódoló kimenete skálázódik, majd átkerül a RecCNN-be. A RecCNN megpróbál olyan képet előállítani, amely a lehető legjobban hasonlít az eredetire.
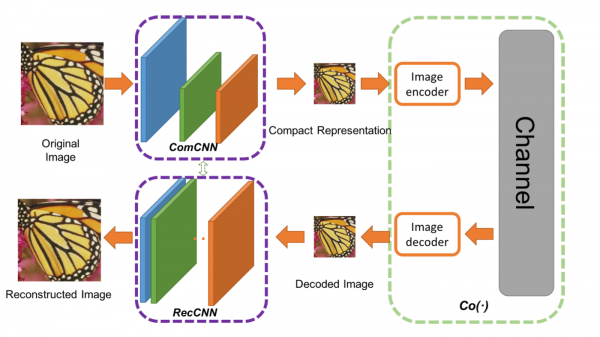
Átfogó képkódolási keretrendszer. A Co(.) egy képkódoló algoritmus. A szerzők JPEG, JPEG2000 és BPG formátumot alkalmaztak.
Mi a maradvány?
A maradvány úgy tekinthető, mint egy utófeldolgozási lépés a dekódoló által előállított kép "javítására". A nagyobb mennyiségű világinformációval rendelkező neurális hálózat kognitív döntéseket hozhat arról, mit kell javítani. Ez az ötlet alapja , a részleteket itt olvashatja el .
Veszteségfüggvények
Két veszteségfüggvény van, mert két neurális hálózatunk van. Az első, a ComCNN, L1-ként van megjelölve, és így van definiálva:
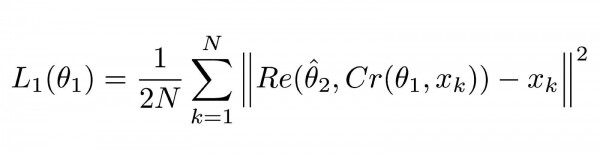
Veszteségfüggvény a ComCNN számára
Magyarázat
Ez az egyenlet bonyolultnak tűnhet, de valójában ez egy standard (négyzetes hiba) forma. MSE. ||² a vektornorma, amelyet összefoglalnak.
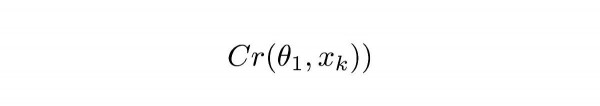
Egyenlet 1.1
A Cr a ComCNN kimenetét jelöli. A θ a ComCNN tanulható paramétereit jelöli, az XK pedig a bemeneti kép.
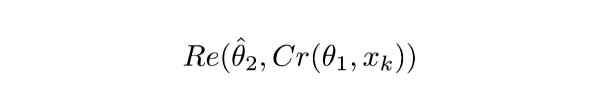
Egyenlet 1.2
Re() a RecCNN-t jelenti. Ez az egyenlet egyszerűen átadja az 1.1 egyenlet értékét a RecCNN-nek. A θ a RecCNN tanulható paramétereit jelöli (a kalap felső része azt jelenti, hogy a paraméterek rögzítettek).
Intuitív meghatározás
Az 1.0 egyenlet arra készteti a ComCNN-t, hogy a súlyait úgy módosítsa, hogy a RecCNN-en keresztül történő újraalkotás után a végső kép a lehető legjobban hasonlítson a bemeneti képre. A második veszteségfüggvény, a RecCNN, így van definiálva:
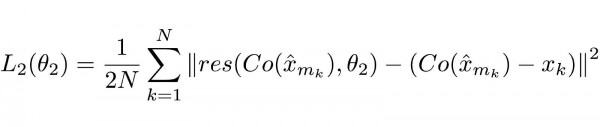
Egyenlet 2.0
Magyarázat
Újra, a függvény bonyolultnak tűnhet, de túlnyomórészt egy standard neurális hálózati veszteségfüggvény (MSE).
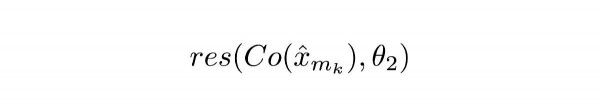
Egyenlet 2.1
Co() a dekódoló kimenetét jelenti, az x kalappal a ComCNN kimenetét jelöli. A θ2 a RecCNN tanulható paramétereit jelöli. res() egyszerűen a RecCNN maradványkimenetét jelenti. Érdemes megjegyezni, hogy a RecCNN a Co() és a bemeneti kép közötti eltérés alapján tanul, de nem a bemeneti képből.
Intuitív meghatározás
A 2.0 egyenlet arra készteti a RecCNN-t, hogy módosítsa a súlyait, hogy a kimenet a lehető legjobban hasonlítson a bemeneti képre.
Tanulási séma
A modellek iteratívan tanulnak, hasonlóan Az első modell súlyai rögzítve vannak, miközben a második modell súlyai frissülnek, majd a második modell súlyai rögzítve vannak, míg az első modell tanul.
Tesztelés
A szerzők összehasonlították módszerüket a meglévő módszerekkel, beleértve az egyszerű kodekeket is. Az ő módszerük jobban teljesít a többinél, miközben fenntartja a magas sebességet a megfelelő hardveren. Ezenkívül a szerzők megpróbálták használni csak az egyik kettő hálózatot, és teljesítménycsökkenést tapasztaltak.
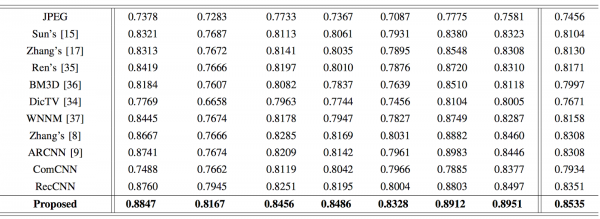
A strukturális hasonlósági index (SSIM) összehasonlítása. A magas értékek a jobb hasonlóságot jelzik az eredetivel. A szerzők eredménye dőlt betűvel kiemelve.
Zárás
Egy új módszert vizsgáltunk a mélytanulás alkalmazására a képek tömörítésében, beszéltünk a neurális hálózatok más, nem általános feladatokhoz, mint például a képkategorizálás és a nyelvfeldolgozás alkalmazásáról. Ez a módszer nemcsak hogy nem marad el a modern követelményektől, hanem lehetővé teszi a képek sokkal gyorsabb feldolgozását is.
Könnyebb lett a neurális hálózatok tanulmányozása, hiszen kifejezetten a Habr olvasói számára készítettünk egy promóciós kódot HABR, amely 10% kedvezményt ad a banneren feltüntetett kedvezményhez képest.
További kurzusok
Ajánlott cikkek
Forrás: habr.com
